低并发场景(例如一个用户同时只有一两个会话的智能体应用)下,单个请求每步要算的数据很少,延迟主要花在内核启动、内核之间的等待和多卡通信上。SGLang、NVIDIA 和 AMD 团队在这篇 LMSYS 博客里介绍 SGLang 低延迟模式:用一个插件框架,把厂商为特定模型和硬件写的高度融合内核接进 SGLang,而不把这些代码合进 SGLang 主仓库。测试模型是 DeepSeek-V4.1-Flash 加 DSpark 投机解码,在 AgentX 智能体轨迹回放上,4 张 NVIDIA GB300、1 个并发会话时,每用户 P90 生成速度从 671.2 提到 928.4 token/s(1.38 倍);4 张 AMD MI355X、4 个并发会话时,从 331.6 提到 516.0 token/s(1.56 倍)。对照组都是同一硬件上的标准 SGLang。
1. 问题:小批量时时间花在哪里
在 1 个请求时,DSpark 每步只验证 6 行 token,每个内核的计算量很小,前后依赖和跨 GPU 通信占了大头。为特定模型、硬件和并发规模做深度融合能显著降延迟,但每种组合都要单独一套实现,全部放进 SGLang 主仓库会让代码和评审负担不断增大。
2. 方法
2.1 NVIDIA:让相互依赖的内核和通信重叠(sgl-nvidia-mega)
作者先在预热后的 CUDA graph 下剖析了一个解码层(1 个请求,各区段中位数):
| 解码层中的区段 | SGLang | 加插件 |
|---|---|---|
| 注意力(从上一个 MoE 输出到输出投影) | 33.4 µs | 18.3 µs |
| 注意力输出投影和张量并行归约 | 10.9 µs | 9.4 µs |
| MoE(从路由到归约后的输出) | 44.4 µs | 36.5 µs |
| 整层 | 96.8 µs | 68.4 µs |
内核总数只从 1,205 减到 1,189,延迟下降主要来自减少等待和让工作重叠,而不是减少内核数量。具体做了四件事:
- 下一个内核提前启动。 利用 PDL(programmatic dependent launch,允许后一个内核在前一个还在运行时就开始),把"可以开始"的信号发得更早,让后一个内核先准备屏障、加载权重。注意力在等 query 之前先开始收集 KV;RoPE 在加载 query 时顺便做掉,省掉一个单独内核。
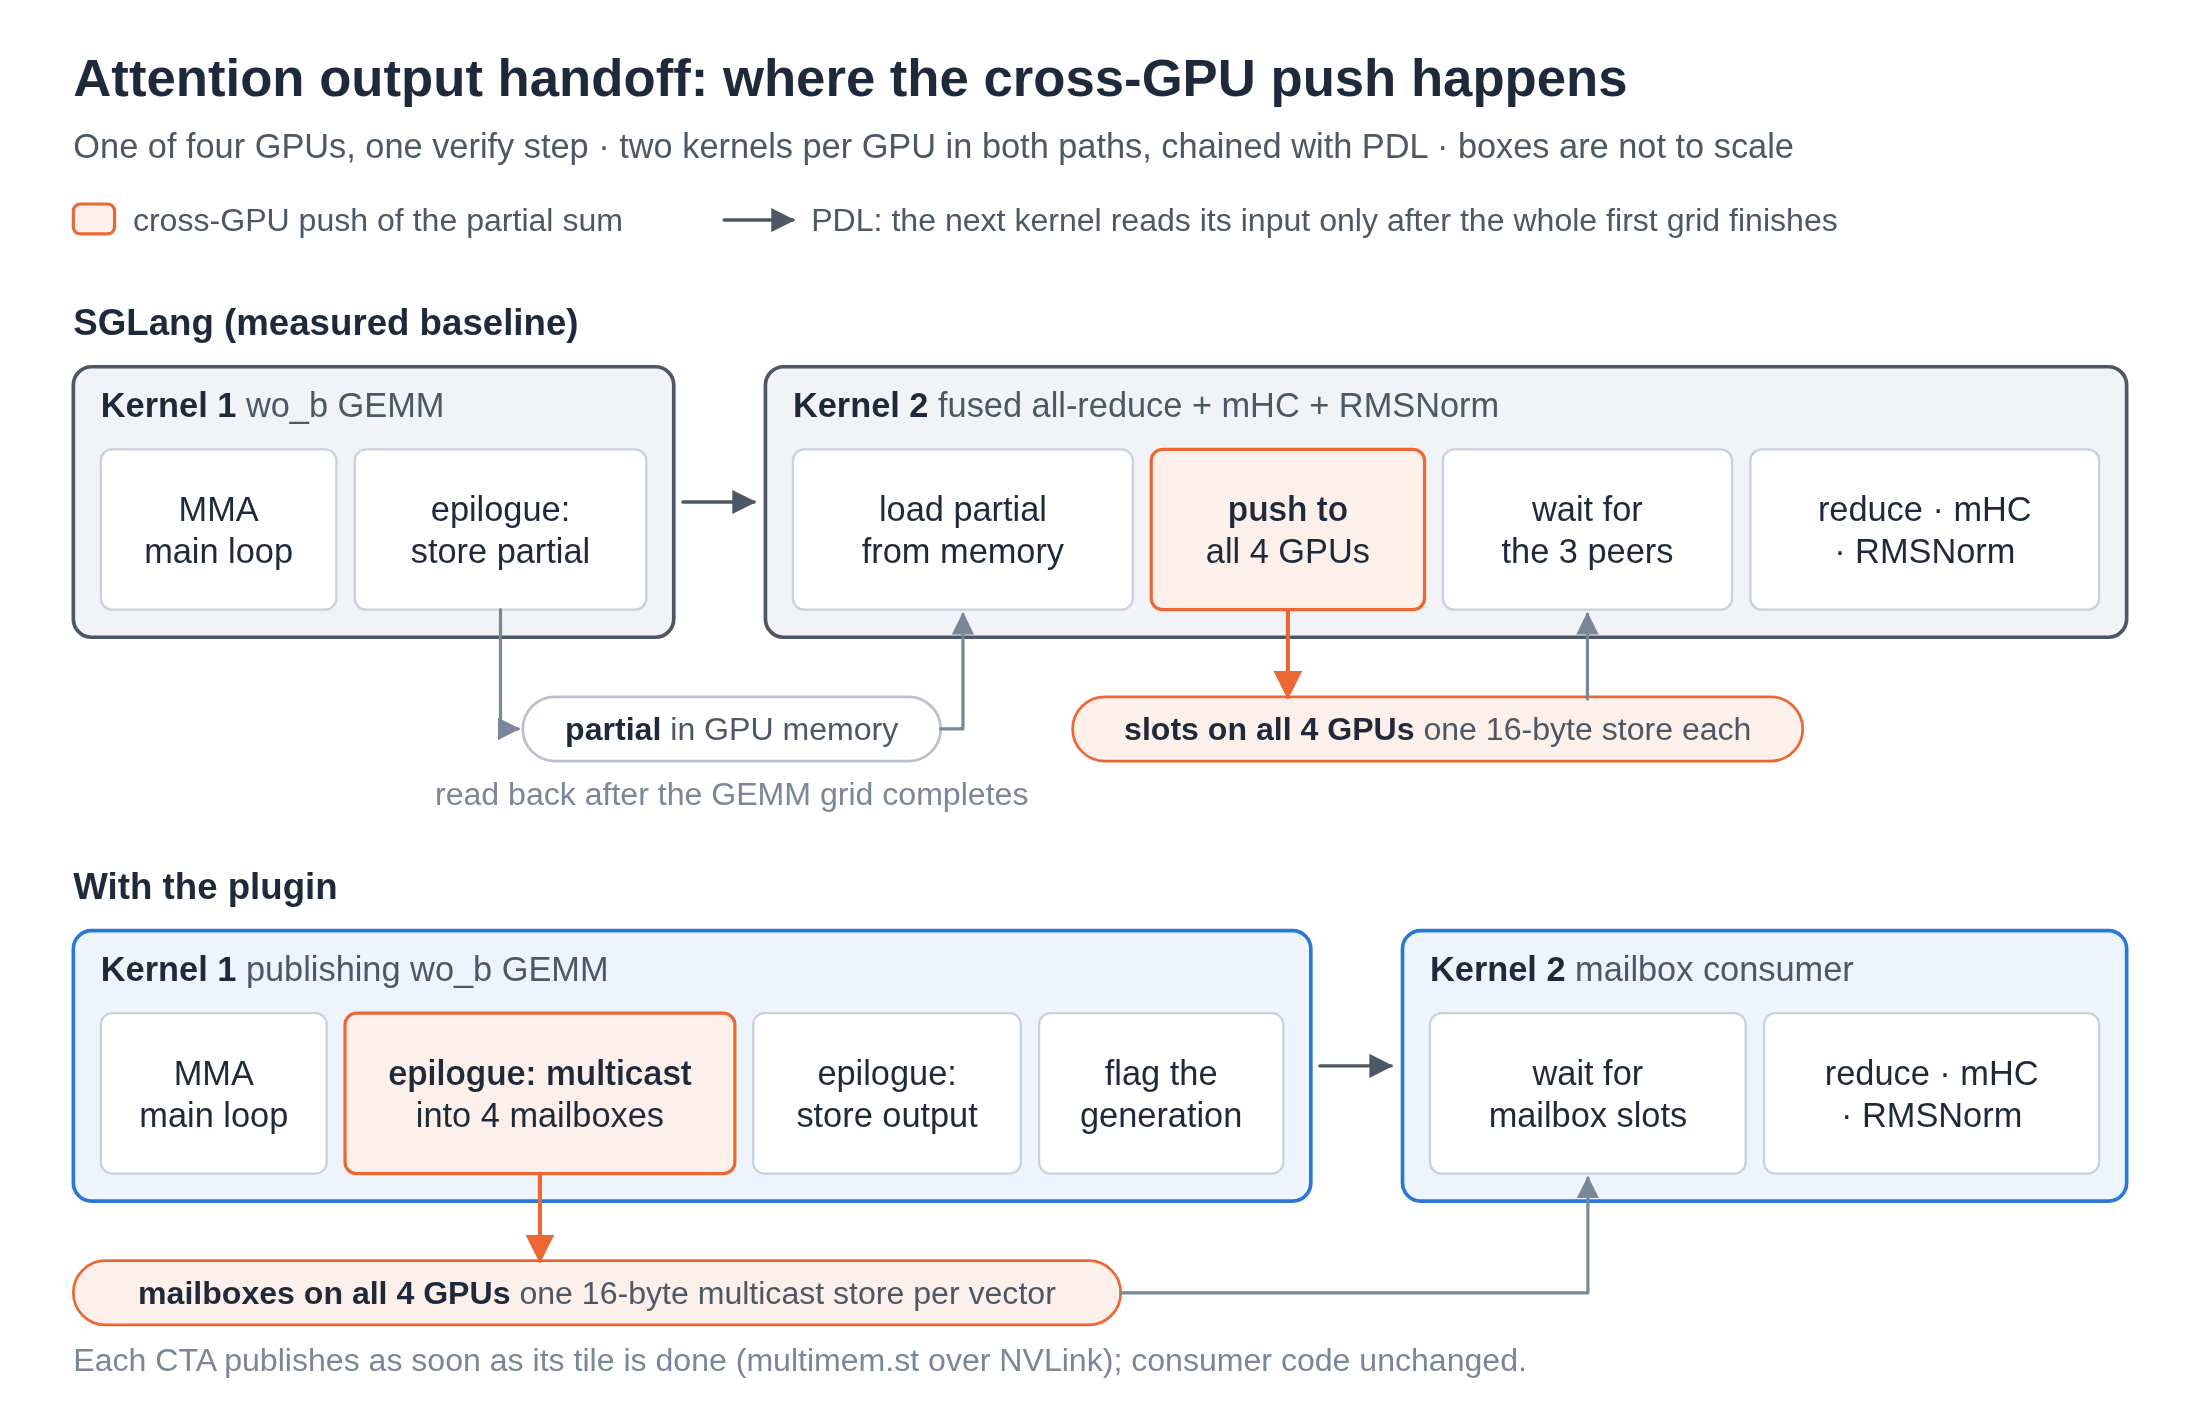
- 在矩阵乘法的收尾阶段直接发送结果。 注意力输出投影之后,每张卡只有部分和,需要跨卡归约。原来是矩阵乘法写回显存、再由下一个内核读出来发给其他卡;插件让每个线程块算完自己那块就通过 NVLink 多播直接写到其他卡,不必等整个矩阵乘法结束。
- 路由没结束就开始专家矩阵乘法。 最多 8 行时,每个专家选中的 token 能放进一个 8 行的块,插件用位图和计数直接定位,不需要扫描或排序,并提前启动第一个专家矩阵乘法。MoE 区段中位数从 44.4 µs 降到 36.5 µs。
- 投机解码的草稿采样放进一个内核。 DSpark 的草稿头按顺序提出 5 个 token,插件在每张卡上用一次内核启动完成,草稿阶段耗时从 85.1 µs 降到 34.2 µs,验收逻辑不变。
2.2 AMD:每层合并成两个常驻内核(sgl-amd-mono)
在 AMD 上,作者认为三项开销最大:即使用 HIP graph,每个小内核在 GPU 上仍要 2–4 µs;内核之间有空转;每层两次跨卡 all-reduce 期间没有计算。插件用 FlyDSL 写了两个常驻内核覆盖一层的大部分工作:K1 做 mHC 更新、Q/KV 投影和写 KV cache;K2 做注意力、输出投影、MoE 和两次 all-reduce。阶段之间用"带解码步编号的值"传递,编号对上就可以开始算,不需要另外的标志位。all-reduce 放进内核内部:每算完一块输出就推到所有卡上,其他工作组同时继续算。每次跨卡等待都设了比 SGLang 看门狗更短的超时,超时则所有卡一起终止这次启动,而不是让服务挂住。
2.3 插件框架
外部内核库通过四步接入:注册(声明支持哪些模型结构)、检查(加载权重前检查硬件、精度、并行方式是否兼容,不兼容就尽早报错)、构建(初始化时准备好权重和资源,在确定 KV cache 大小之前构建,所以显存占用会被计入)、运行时分派(插件只覆盖部分步骤类型和 token 数,不覆盖的步骤回到 SGLang 原有的前向)。
3. 实验
3.1 AgentX 轨迹回放
这组实验检验插件在接近真实的智能体负载下能提速多少。设置:DeepSeek-V4.1-Flash + DSpark,TP4,每用户 P90 生成速度,只切换插件开关。
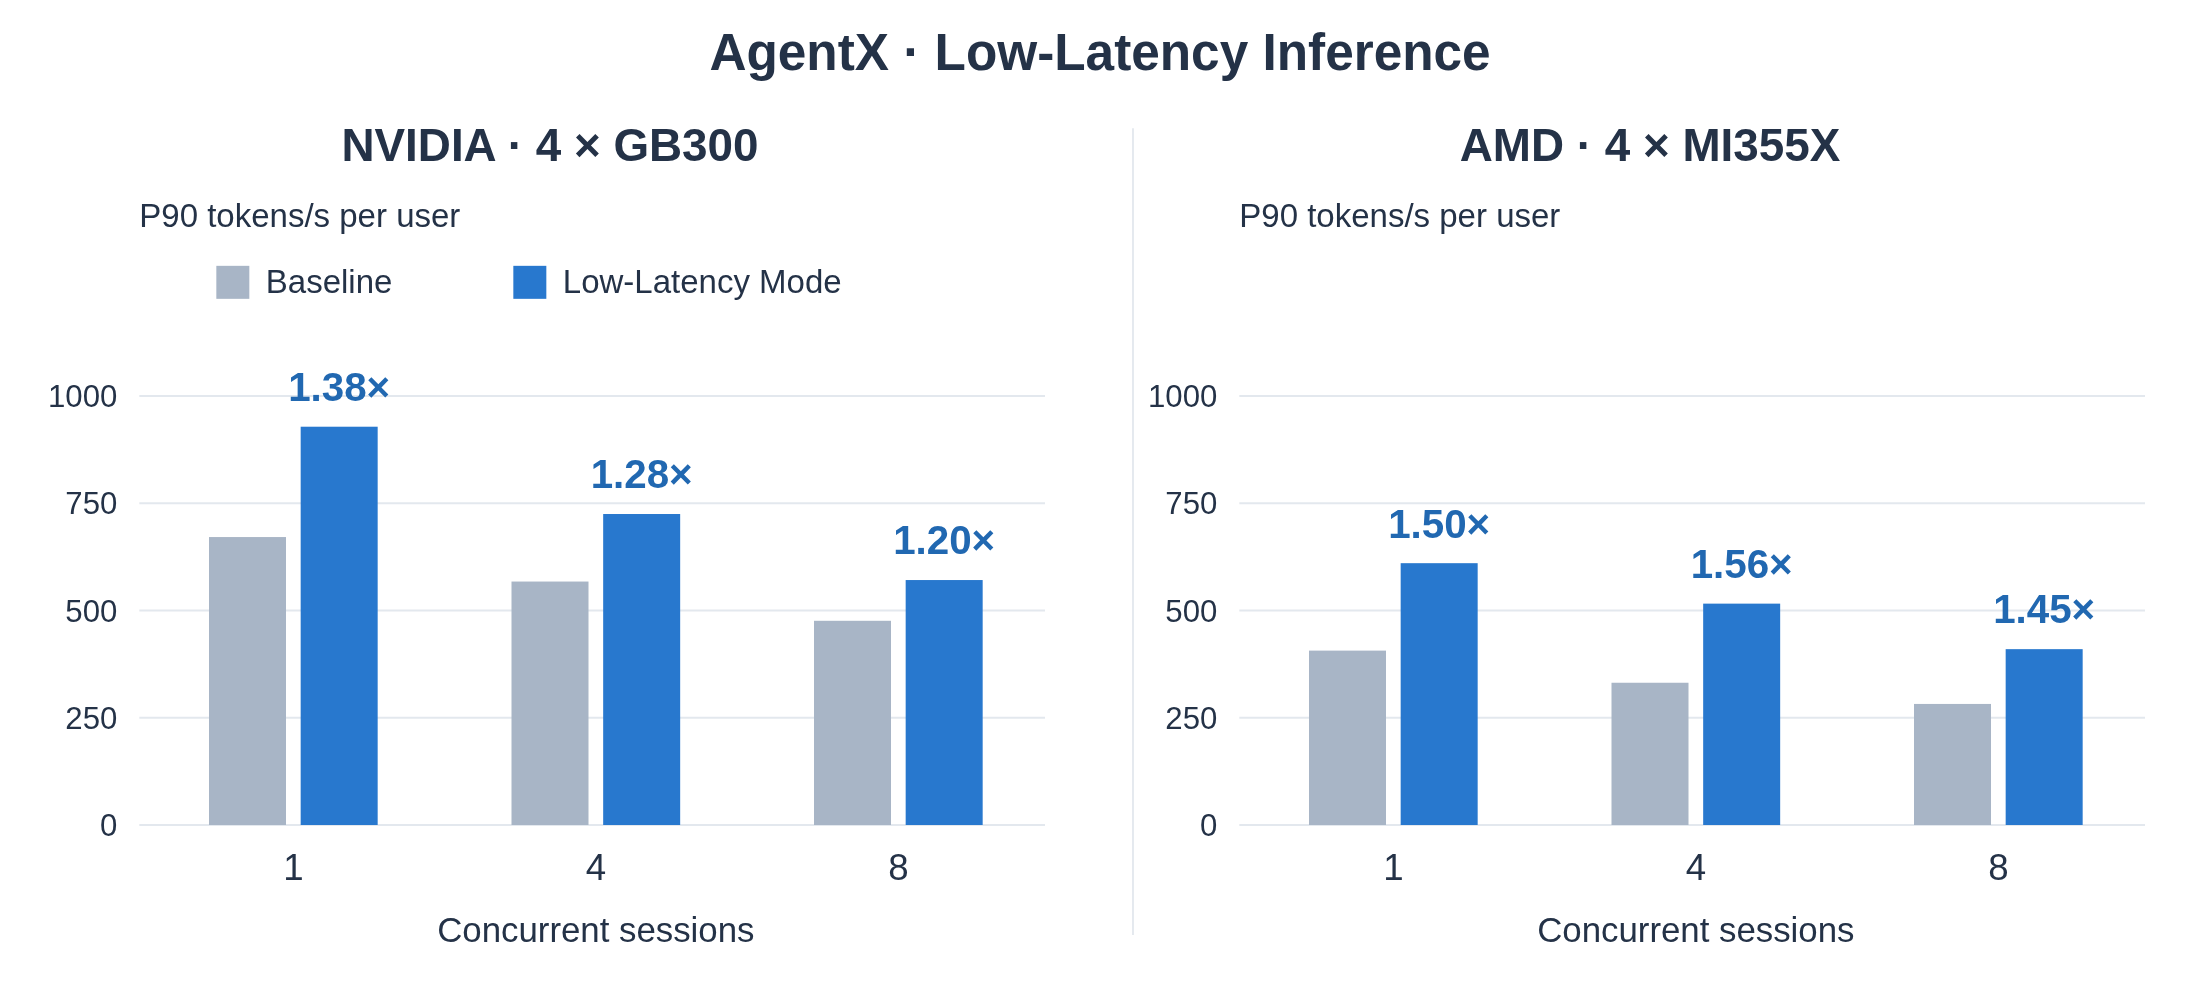
| 硬件 | 1 个会话 | 4 个会话 | 8 个会话 |
|---|---|---|---|
| 4 × GB300 | 1.38× | 1.28× | 1.20× |
| 4 × MI355X | 1.50× | 1.56× | 1.45× |
NVIDIA 上并发越高,提速越小;AMD 上三档都在 1.45 倍以上。
3.2 NVIDIA 固定长度负载
输入 8K、输出 1K,模拟的平均接受长度为 3.51。在 1–8 个并发请求下,NVIDIA 插件把每用户解码速度提高 12%–38%。
4. 局限
目前只支持 DeepSeek-V4.1-Flash + DSpark 这一组合,GLM-5.3、K3、MiniMax M3 等还在开发中。博客说明剖析本身会影响计时,分区段数字用于解释机制,不代表服务性能。外部内核不经过 SGLang 常规代码评审,插件接口的 CI 和性能回归测试还在计划中;接口本身也还在早期,会继续调整。博客没有给出精度对比,只说明不改变投机解码的验收逻辑。
5. 实践意义
如果你的负载是低并发、对单用户延迟敏感(例如编码或智能体会话),并且正好用 DeepSeek-V4.1-Flash 在 GB300 或 MI355X 上部署,可以试这个模式。对其他模型,更有参考价值的是方法:在小批量下先剖析等待和通信时间,再决定融合哪些内核;以及用插件方式把专用内核隔离在主框架之外。