向量检索里,短查询常常表达不全,常见的补救办法是先拿到一些"反馈"文本,比如第一轮检索排在前面的文档,或者让大模型写一段假想答案(HyDE),再用它们修改查询向量。现有做法大多把反馈向量取平均,或者和原查询线性插值,相当于把每条反馈都当成"新查询应该长成的样子",把查询往它整体拉过去。清华这篇 DIFF 认为这样会互相干扰:一条反馈往往只支持查询在某一个方向上的修正,其他方向它没给信息,却也被它往回拉。DIFF 先算出每条反馈相对原查询多出来的那部分方向,只要求修正后的查询在这个方向上和反馈一致,其他方向不管;再按反馈质量给每条约束加权,并用一个"别离原查询太远"的约束兜底,最后有闭式解,不需要训练任何模型。在 BEIR 14 个子集、3 个检索模型、4 种反馈来源上,DIFF 的平均 NDCG@10 在 12 组设置里都是最高或并列最高,但在第一轮检索文档做反馈时,相对不加反馈的原查询基本没有提升。
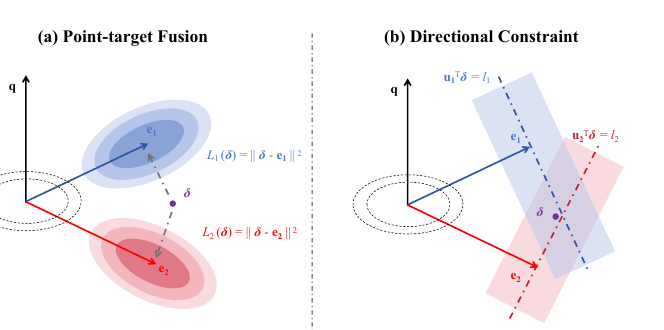
1. 问题:把反馈当目标点会丢掉互补信息
设原查询向量为 ,第 条反馈相对 提出的修正是 ,其中 是方向(单位向量), 是幅度。逐点拟合的目标是让修正 接近 ,即最小化 。作者把它拆成两项:
第一项要求 在 方向上的分量等于 ,这是想要的。第二项惩罚 在所有其他方向上的分量,可这些方向可能正是别的反馈支持的修正。举个例子:查询是"苹果 发布会",一条反馈文档讲新手机,另一条讲新电脑,逐点拟合会把查询拉到两者中间,两个方向都只走了一半。
作者证明了:在同样的权重下,方向约束得到的修正幅度总是不小于逐点拟合,只有所有反馈方向共线时两者相等;反馈方向两两正交时,逐点拟合在每个方向上的修正量都会被其他反馈的权重稀释。
2. 方法:四步
第一步,算每条反馈的新增方向。 所有向量都做 L2 归一化,位于单位球面上。对反馈向量 ,先算它和查询的相似度 ,再减掉和查询平行的部分,得到 。 的方向 就是这条反馈想把查询往哪边转,长度 等于两者夹角的正弦值,衡量这条反馈带来了多少原查询里没有的东西。
第二步,给每条反馈打可信度。 可信度 由两层组成。单条质量 :把同一查询下所有反馈的 用中位数和中位数绝对偏差标准化,再过 sigmoid,所以和查询更接近的反馈权重更大,而且不依赖不同模型的相似度绝对数值。整组可信度 :先算所有修正向量的平均 ,再比较平均方向的强度 和各条修正相对平均的离散程度;反馈方向一致时 高,各说各话时 低,最后再乘上整组的平均单条质量。
第三步,联合求修正量。 目标函数只保留每条反馈在自己方向上的约束,外加一项惩罚修正幅度:
这个问题有闭式解,只需要解一个 的线性方程组( 是反馈条数,主实验取 5),计算量是 , 是向量维度。
第四步,转回球面。 最终旋转角度取 和" × 最大允许角度"中较小的一个,然后 。整组反馈不可信时 小,查询几乎不动。
3. 实验
设置:BEIR 的 14 个子集(ArguAna、FEVER、HotpotQA、MSMARCO、NQ、SciFact、TREC-COVID 等),三个检索模型 bge-base-en-v1.5、e5-base-v2、Qwen3-Embedding-0.6B。反馈有两类:第一轮检索的前 篇文档(PRF),以及 Qwen3.8-27B 生成的三种文本(HyDE 假想文档、Q2D 查询扩写、CoT 推理过程)。所有方法共用同一个编码器、同一份反馈和同一个索引,只比较融合方式。对比方法包括向量平均(VPRF)、拼接后重新编码(Concat-P/L)、只取正交分量的 OR-PRF、按维度加权的 DIME 和 Eclipse,以及需要额外检索来估权重的 AnchorQE。
3.1 主结果
这组实验检验 DIFF 是否在不同检索模型和反馈来源上都比其他融合方式好。下表是 14 个子集的平均 NDCG@10,括号里是不用反馈的原查询分数:
| 检索模型(原查询) | 反馈 | VPRF | OR-PRF | AnchorQE | DIFF |
|---|---|---|---|---|---|
| BGE(0.5492) | PRF | 0.5045 | 0.5392 | 0.5466 | 0.5522 |
| HyDE | 0.5410 | 0.5606 | 0.5700 | 0.5717 | |
| Q2D | 0.5564 | 0.5632 | 0.5698 | 0.5723 | |
| E5(0.5231) | PRF | 0.4775 | 0.5103 | 0.5225 | 0.5252 |
| HyDE | 0.5088 | 0.5189 | 0.5487 | 0.5489 | |
| Qwen(0.5492) | PRF | 0.5066 | 0.5388 | 0.5459 | 0.5491 |
| HyDE | 0.5607 | 0.5702 | 0.5720 | 0.5777 |
主表里有两点结果。第一,用检索文档做反馈时,简单平均(VPRF)会把分数拉到原查询以下,BGE 上从 0.5492 掉到 0.5045;DIFF 在这一栏只是没掉分,BGE 上 0.5522,E5 上 0.5252,Qwen 上 0.5491,相对原查询的变化很小。第二,用大模型生成的反馈时各方法都有提升,DIFF 在 BGE 上把 HyDE 反馈的结果做到 0.5717,Qwen 上做到 0.5777。和 AnchorQE 很接近(BGE + HyDE 上 0.5717 对 0.5700),但 AnchorQE 要额外做检索来估权重,DIFF 不需要。
3.2 消融
这组实验检验"方向约束"和"可信度加权"两部分各自是否必要。在 BGE 上每次去掉或替换一个部件:
| 变体 | PRF NDCG@10 | HyDE NDCG@10 |
|---|---|---|
| DIFF 完整 | 0.5522 | 0.5717 |
| 改回逐点拟合(直接加权求和修正向量) | 0.5439 | 0.5646 |
| 去掉全部可信度(τ=1) | 0.5454 | 0.5703 |
| 去掉单条质量(a=1) | 0.5462 | 0.5481 |
| 单条质量不做中位数标准化 | 0.5487 | 0.5684 |
| 去掉整组可信度(g=1) | 0.5483 | 0.5565 |
改回逐点拟合是降幅最大的几项之一,直接支持论文的核心论点:每条反馈只约束它自己方向上的修正,比把查询整体拉向反馈更好。HyDE 反馈下去掉单条质量从 0.5717 掉到 0.5481,说明生成的假想文档里质量参差,必须区别对待。
3.3 反馈条数
反馈条数 从 1 加到 20 时,VPRF 在检索文档反馈下掉得很快,因为排得越靠后的文档噪声越多。DIFF 在各个 下都比较平稳,作者把这归因于整组可信度会在反馈变杂时自动缩小修正幅度。
4. 局限
最主要的一点在主表里:用第一轮检索文档做反馈时,DIFF 相对不加反馈的原查询几乎没有收益,在 Qwen 上还略低(0.5491 对 0.5492)。它的价值主要是"不被噪声拖垮"和"用好生成的反馈"。另外实验只在 BEIR 上做,检索模型最大 0.6B,没有在生产规模的语料和更大的向量模型上验证。整组可信度和最大旋转角都有超参数,正文没有展开它们的敏感度。
5. 实践意义
如果系统里已经在用 HyDE 或查询扩写,把生成的文本编码后和原查询取平均,可以考虑换成 DIFF 这套融合方式:只依赖向量本身,不训练、不额外检索,每个查询多解一个 5×5 的线性方程组。如果反馈来自第一轮检索结果,这篇的结果提示收益有限,至少应该先确认现有的平均做法没有把指标拉低。