 已录用 RecSys 2026
Google Discover 广告团队的模型迭代分三步:离线比较新旧模型的损失,小流量 A/B 看广告主获得的价值,最后把通过的改动打包上大流量。过去的问题是这三步之间对不上:转化模型(pConvs)离线泊松损失的变化和线上价值的相关系数只有 0.1,大量离线变好的改动在小流量阶段失败;小流量和大流量结果的相关系数也只有 0.53。这篇论文(RecSys 2026 最佳工业论文)从两头修:离线损失按每次点击对广告主值多少钱加权,让损失下降对应到价值上升;实验流程上逐项消掉系统偏差和噪声。改完以后,离线到线上的相关系数升到 0.65,小流量到大流量升到 0.93,两类模型换用新目标后线上价值合计提升 4.7%,作者估计研发效率约翻倍。
1. 三个阶段、三类误差
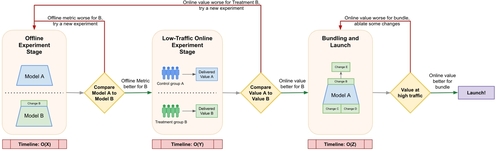
拍卖排序阶段有两个模型:pCTR 预测一次展示后的点击,pConvs 预测一次点击后的转化数,两者和广告主出价一起算出拍卖分,进行第二价格拍卖。上线决策看的业务指标是交付价值(Delivered Value,DV):
是广告主为一次转化愿意付的目标单价(tCPA), 是第 次点击带来的转化数。一次 1000 美元床垫的购买,价值超过一百次对商家网站的浏览,而普通的转化预测损失把两者当成同等的转化来算。
每个阶段的耗时依次是 O(X)、O(Y)、O(Z),X 远小于 Y、Y 远小于 Z,所以前面阶段每做错一次判断,都会浪费后面更贵的资源。作者把测量误差分成三类:目标不对齐(前一阶段测的东西不能预示后一阶段的结果)、系统误差(实验设置带来的偏差)、随机误差(系统噪声带来的方差)。
2. 让离线损失对齐交付价值
2.1 pConvs:泊松损失按 tCPA 加权
pConvs 原来按泊松分布做最大似然,损失是 , 是第 次点击的预测转化数。作者把预测目标从“点击后的转化数”换成“点击后的交付价值”,损失变成加权泊松损失(WPL):
为什么加权是对的,论文给了一个推导。设广告主真实获得的价值 ,出价 ,第二价格(广告主实际付的钱) 的密度为 $f(s)$,单次拍卖的期望收益是赢下拍卖时“价值减成本”的积分 。如果 ,积分结果是 加常数,最大化收益等价于最小化 ,把 、 代回去,去掉与参数无关的常数,就是 WPL。泊松回归在这里有效,不是因为转化数真服从泊松分布,而是因为 1/s 的成本分布近似成立。
2.2 pCTR:从“是否点击”改成“点击几次”
pCTR 原来预测一次展示至少被点一次的概率,用对数损失训练、用 AUCLoss(1 减 AUC)评估。轮播广告一次展示常有多次点击,每多一次点击都有价值,于是团队把目标改成一次展示的期望点击数,线上 DV 提升 1.2%。
这个改动离线几乎看不出来:
| 离线指标 | 变化 |
|---|---|
| Binary AUCLoss | -0.10% |
| Multi-class AUCLoss | -0.15% |
| LL | +0.08% |
| PL_CTR | -0.21% |
对数损失甚至变差了,只有按点击数计算的泊松损失 PL_CTR 下降最明显,和线上 1.2% 的提升方向一致。
pCTR 也要带上价值,但直接用转化价值当权重,有转化的点击太少,标签又稀疏一个数量级。作者改用期望交付价值 作代理,每次展示的权重是 ,得到 , 是第 次展示的点击数。附录用第二名有效千次展示出价服从 $1/r$ 分布的假设,给出和 2.1 同样形式的推导。
2.3 换目标后的结果
这组实验要证明两件事:WPL 作为离线指标更能预测线上价值,用 WPL 作为训练目标能直接提升价值。
| 模型 | PL 变化 | WPL 变化 | 线上 DV |
|---|---|---|---|
| pConvs 改用 WPL 训练 | +0.1% | -0.35% | +3% |
| pCTR 改用 WPL 训练 | +0.03% | -0.04% | +0.5% |
两个模型的 PL 都变差了,WPL 变好,线上 DV 上涨,说明 PL 测的东西和业务目标方向不一致。
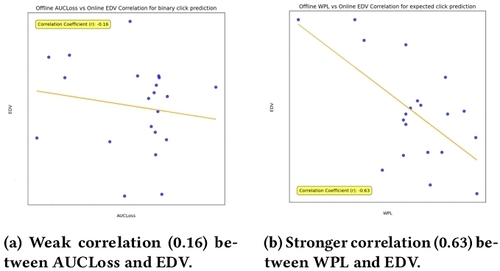
相关性的测法是:对同一批改动,计算离线指标变化和线上 DV 变化之间的皮尔逊相关系数(下文都报告绝对值)。pConvs 在约 40 个有线上数据的实验上,PL 的相关系数是 0.1,WPL 是 0.65(p<0.01);后来 25 个以上的新实验接近 0.69。pCTR 在“是否点击”阶段的 25 个实验上,AUCLoss 和 EDV 的相关系数是 0.16,对数损失是 0.09;换成期望点击后的 20 个实验上,多分类 AUCLoss 是 0.33, 是 0.63。如果直接对噪声更大的 DV 算,相关系数从 0.26 升到 0.44。
3. 离线阶段:系统误差和随机误差
模型都是连续在线训练,每条数据只过一遍,离线评估用渐进验证:每条数据先预测、记损失,再拿来训练。
系统误差有两个来源。一是标签成熟度偏差:转化标签会延迟到达,实验模型比对照模型启动得晚,追历史数据时看到的转化标签更全,同一时间段上的损失看起来更好,其实只是信息更多;解决办法是只在两个模型训练数据质量相同的时间段上比较。二是优化器带来的假象:二阶优化器和 DLRM 这类把特征分组做交互的结构,加一个常数特征就可能改变分组,把需要交互的重要特征分到不同组里。修掉这两类问题后,两个等价模型之间的离线差异稳定在 0.02% 以内,以前这种情况下经常测出显著差异。
随机误差靠统一测量方法来压。下表比较了在 25 个 pConvs 实验上,用不同时间窗口测离线指标时,离线和线上的相关系数,以及用离线结果判断线上好坏的 AUC-ROC。 是每个实验上线的时间。
| 离线测量窗口 | 相关系数 | AUC-ROC |
|---|---|---|
| [T−6 个月, T−3 个月] | 0.650 | 0.760 |
| [T−1 个月, T] | 0.577 | 0.690 |
| [T−1 周, T] | 0.01 | 0.489 |
| 所有实验固定同一 3 个月 | 0.640 | 0.755 |
| [T, T+线上实验时长] | 0.604 | 0.736 |
只看最近一周,相关系数接近 0,AUC-ROC 低于 0.5,比随机猜还差;用 3 个月窗口比 1 个月好。WPL 的权重从 0.01 美元到 1000 美元不等,噪声很大,测量时把权重上端截断到和 DV 截断相同的上限,置信区间缩小一半,没有引入偏差。
4. 线上阶段:小流量对照组要和实验组一样小
4.1 系统误差来自流量大小不同
常见做法是拿小流量的实验模型和大流量的线上模型比,这样一定有偏。原因有三:小流量模型在连续训练里看到的自己的流量少,没法修正自己的预测偏差,这是赢家诅咒;广告主预算是固定的,小流量下预算约束不明显,价值会被高估;大流量下的反馈控制会把预测偏差拉回目标约束,小流量没有这层修正。
作者的做法是定一个标准的小流量规模,把线上模型按这个流量重新训练一份,作为同规模所有实验共用的对照组。需要其他流量规模时,再单独训一个对应规模的对照。改完后,两个完全相同的重训模型之间的 DV 差异接近 0%,以前常超过 1%。
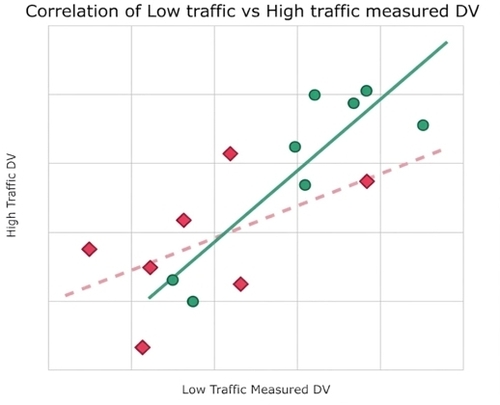
这组对比用 7 个历史实验(旧设置)和 8 个新实验(新设置),小流量到大流量的相关系数从 0.53 升到 0.93。样本少是因为大流量实验成本高,但每个大流量实验跑得久、流量大,单次测量本身很准。两组评估的是同一批模型,两者之间有约 0.75 的相关,作者用考虑这种相关的 Williams t 检验,得到 p<0.05。
4.2 随机误差:截断和期望值
DV 依赖稀疏的转化,置信区间很宽。对单次点击的大额价值做截断,置信区间宽度缩小 40%,偏差小于 3%;用期望 DV(用 pConvs 预测代替实际转化)代替实际 DV,宽度再缩小 70%,偏差约 5%。两者叠加约缩小 82%,2% 流量的实验现在能达到原来 30% 流量实验的精度,同样的流量可以并行跑更多实验。
5. 为什么相关系数决定效率
作者假设离线和线上的结果服从相关的二元正态分布,把离线判断和下一阶段方向一致的概率、小流量判断和大流量方向一致的概率相乘,就是两次判断都正确的概率:
是离线到小流量的相关系数, 是小流量到大流量的相关系数。改进前 0.1 和 0.53,概率约 0.36;改进后约 0.69 和 0.93,概率约 0.65。
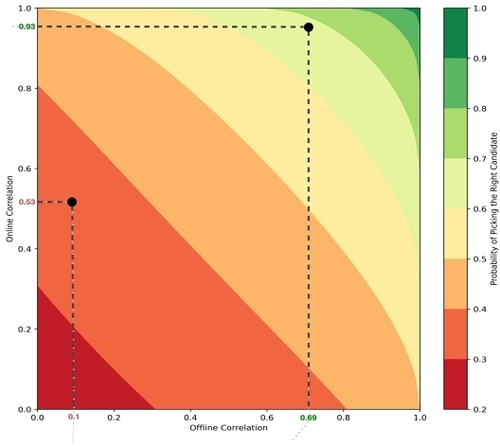
正文写的是改进后离线相关系数 0.65,图上标的是 0.69;按公式算,0.69 对应约 0.65 的概率,0.65 对应约 0.64。论文的效率证据是 3 年里 100 多个实验改动:pConvs 每次打包上线包含的成功改动数,以及每位贡献者的改动数,都持续上升,作者估计整体效率约翻倍,具体数字因保密没有公开。
6. 局限
作者承认,所有证据都来自 Google Discover 广告这一个连续训练的线上环境。WPL 的推导依赖成本服从 $1/s$ 分布,作者在附录里说明实际的第二名出价分布衰减更快、尾部更轻,更贴近实际的成本分布留作以后的工作。
另外,DV 本身是论文为了说明问题做的简化指标,实际上线还要看多个相互依赖的指标;小流量到大流量的相关系数只基于 7 个和 8 个实验。
7. 实践意义
- 如果你的模型服务于按出价排序的拍卖,离线评估损失可以先试着乘上每个样本的业务价值,再看它和线上结果的相关系数有没有提高;不需要改训练,就能判断现有离线指标是否在测错的东西。
- 小流量实验的对照组应该和实验组同样规模、同样重训方式。拿小流量实验组去比大流量线上模型,测出的差异里混着赢家诅咒、预算和反馈控制的偏差,A/A 实验就能先检查出来。