
不给机器人示范、不针对任务训练,让一个通用大模型自己写代码、直接指挥机械臂,能不能比专门用机器人示范数据训练出来的模型做得更好?Apple 这篇论文在真实机械臂上给了答案:同样 12 个任务、每个任务 9 次,共 108 次试验。VLA(视觉-语言-动作模型,看画面和指令直接输出动作)π0.5 成功 30 次,WAM(世界-动作模型,同时预测画面会怎么变和该做的动作)里的代表模型 FLUX 3 Action 成功 49 次。而让 Claude Opus 5.5 通过一套叫 AMP1 的接口直接控制机械臂,成功 104 次。差距最大的是“把所有柠檬和那个橙子放到盘子里”这类任务:两个专用模型 9 次全失败,AMP1 9 次全成功。这说明差距不只出现在作者自选的任务上:在公开基准 RoboLab-120 上(120 个任务,每种指令说法各 1,200 次),AMP1 配 Gemini 4 Argon 成功率 85.6%(配 Opus 5.5 为 82.8%),排行榜上最好的 VLA 和 WAM 是 49.2% 和 42.9%。而且 AMP1 没给模型任何现成的抓取、放置技能,怎么抓全靠模型自己算。代价是慢:真机上成功的试验里,AMP1 平均执行动作 69 秒,和两个基线(62 秒、44 秒)同一量级,但另外还要等模型思考 211 秒。
我的判断
这篇值得做机器人策略的人认真读,原因不在某个新模块,而在它把一条路线系统地验证了一遍:让通用大模型留在控制回路里,每一步看结果、再决定下一步,作者把这类做法叫 AMP。仿真、真机、四个基准都指向同一结论,而且作者做了控制变量实验,说清了收益主要来自哪里:在 AMP1 这套接口上做各种改动,影响都远小于换模型;但接口设计本身并非无关紧要,同用 Opus 5.5、在 RoboLab 里同一批 30 个任务上,另一套逐小步控制、不让模型写代码的接口 Astranomy 只有 25.3%,AMP1 是 84.7%。需要保留的疑问是速度和成本,以及真机实验里 AMP1 有“出错后恢复”而基线没有这一不对称(去掉后 AMP1 仍有 94/108,失败次数从 4 变成 14)。
以前的路为什么不够
机器人操作这几年的主流是专用策略:VLA 或 WAM 在大量机器人示范上训练,输入画面和指令、输出关节动作。它们快,但换个说法就容易失手:RoboLab-120 基准里,指令改成模糊说法后,FLUX 3 Action 从 42.9% 掉到 28.4%,π0.5 从 28.0% 掉到 15.2%。
用通用大模型做机器人此前主要有两种用法。一种是让模型挑选、排列现成技能(“抓取”“放置”),模型再聪明,也只能做到技能库允许的程度。另一种是让模型在执行前写好一整段控制程序(code-as-policies),程序可以读传感器,但执行时模型不在场,发现策略不对也没法改。AMP 要做的是第三种:模型一直在回路里,每执行完一段动作就看结果,再决定下一段怎么做(正在执行的这一段不能中途改)。过去这条路走不通,主要因为大模型的空间理解太弱;作者的判断是,前沿模型的空间推理已经进步到可以试一试了。
AMP1 怎么让模型直接控制机械臂
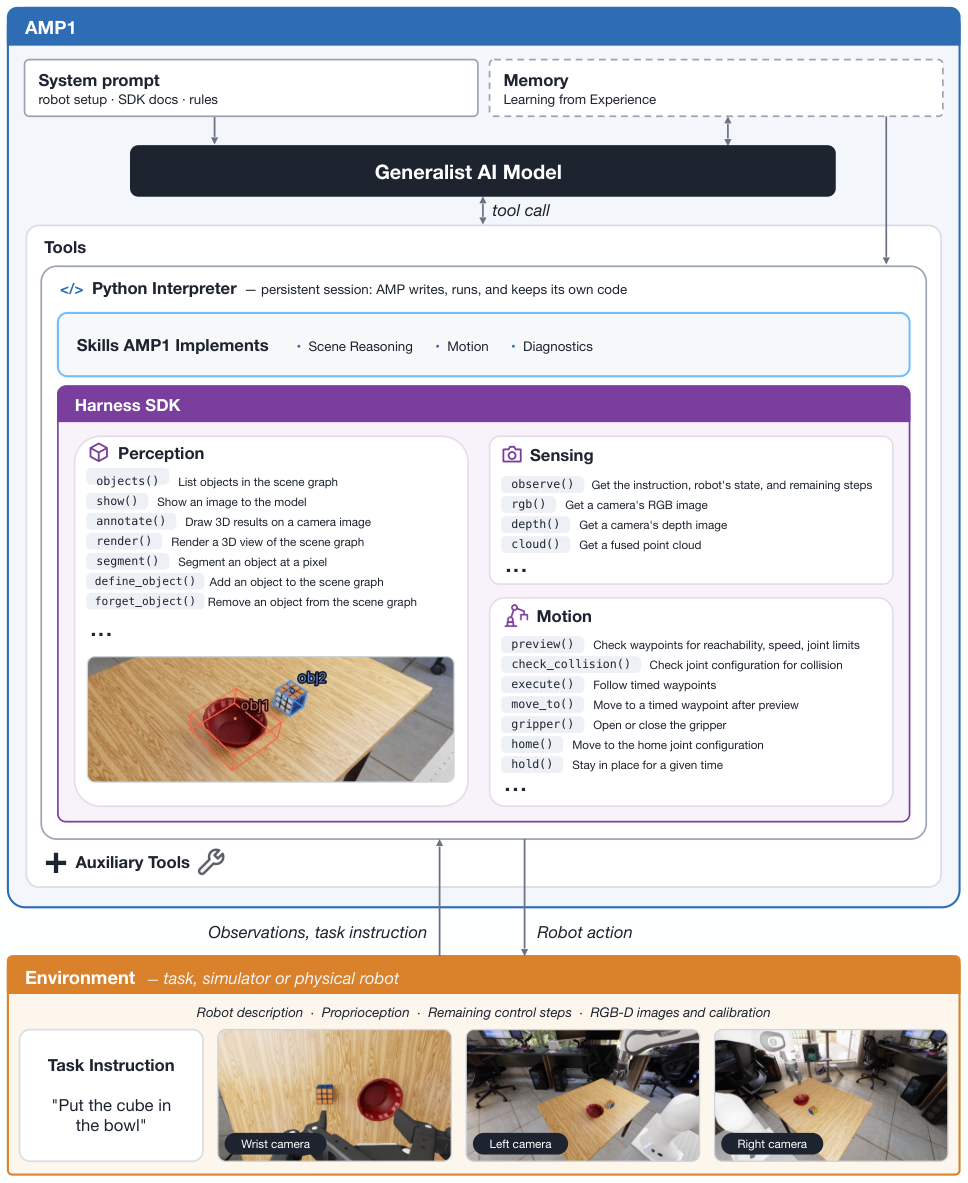
AMP1 是一套“harness”,不是一个新模型。一次任务里,模型反复做三件事: Hoot 说

抓方块和“下降段太快”是示意例子,论文没有给这一步一步的例子;分工规则(模型给带时刻的夹爪路径点,接口插值、求关节角、检查够不着和速度并返回原因,碰撞检查由模型调用,执行中不能改)取自正文。
出处
论文 §4A.3 运动接口与 §2D.2 基础接口:路径点 = 夹爪位姿、到达时刻、夹爪开合;插值 + 阻尼最小二乘逆运动学;误差超限或关节超速则拒绝并返回原因与时间步;碰撞检查由模型调用- 自己决定看什么。 模型调用函数读指令、取某个摄像头的彩色图和深度图、读相机标定参数、读机械臂当前位姿。接口还会把各摄像头的深度合成一份点云(相机标定告诉它每个摄像头在机器人坐标系里的位置和朝向),再切成一个个物体,给每个物体编号、标颜色和尺寸,并给出它在机器人坐标系里的中心和包围盒。所以模型从图像或物体上取到的点,都能换算成机器人坐标系下的 3D 位置。图像只有模型主动显示时才进入上下文。
- 写代码算动作。 模型输出的是一串带时间的路径点:每个点写明夹爪中心要在什么时刻到达机器人坐标系里的哪个位置、朝向如何,以及夹爪此时开还是合。接口在相邻点之间平滑插值,每个控制周期换算成各关节角度,发给机械臂执行。抓哪里、从哪个方向接近、放到哪里,全由模型自己算;接口里没有任何“帮你挑抓取点”的函数。
- 看结果再改。 接口会先检查这条路径:够不着、速度超限,就拒绝执行并告诉模型原因和出问题的时间步;碰撞检查则交给模型自己调用。执行后,模型再看图、读位姿,判断有没有做成。
所有代码跑在一个整轮任务都不重启的解释器里,前面写的函数、存下的图后面能接着用;但每个新任务都从空白开始,技能要重新写。论文统计了 Opus 5.5 在 1,200 次 RoboLab 仿真回合里反复自己写出的“技能”,下面的比例是出现该做法的回合占比:放东西前先量容器尺寸(66%)、让抓取方向对齐物体的轴(61%)、路径被拒绝后读原因并修改(40%)、动作失败后先诊断原因再重来(39%)。
它学会了哪些没人教的做法
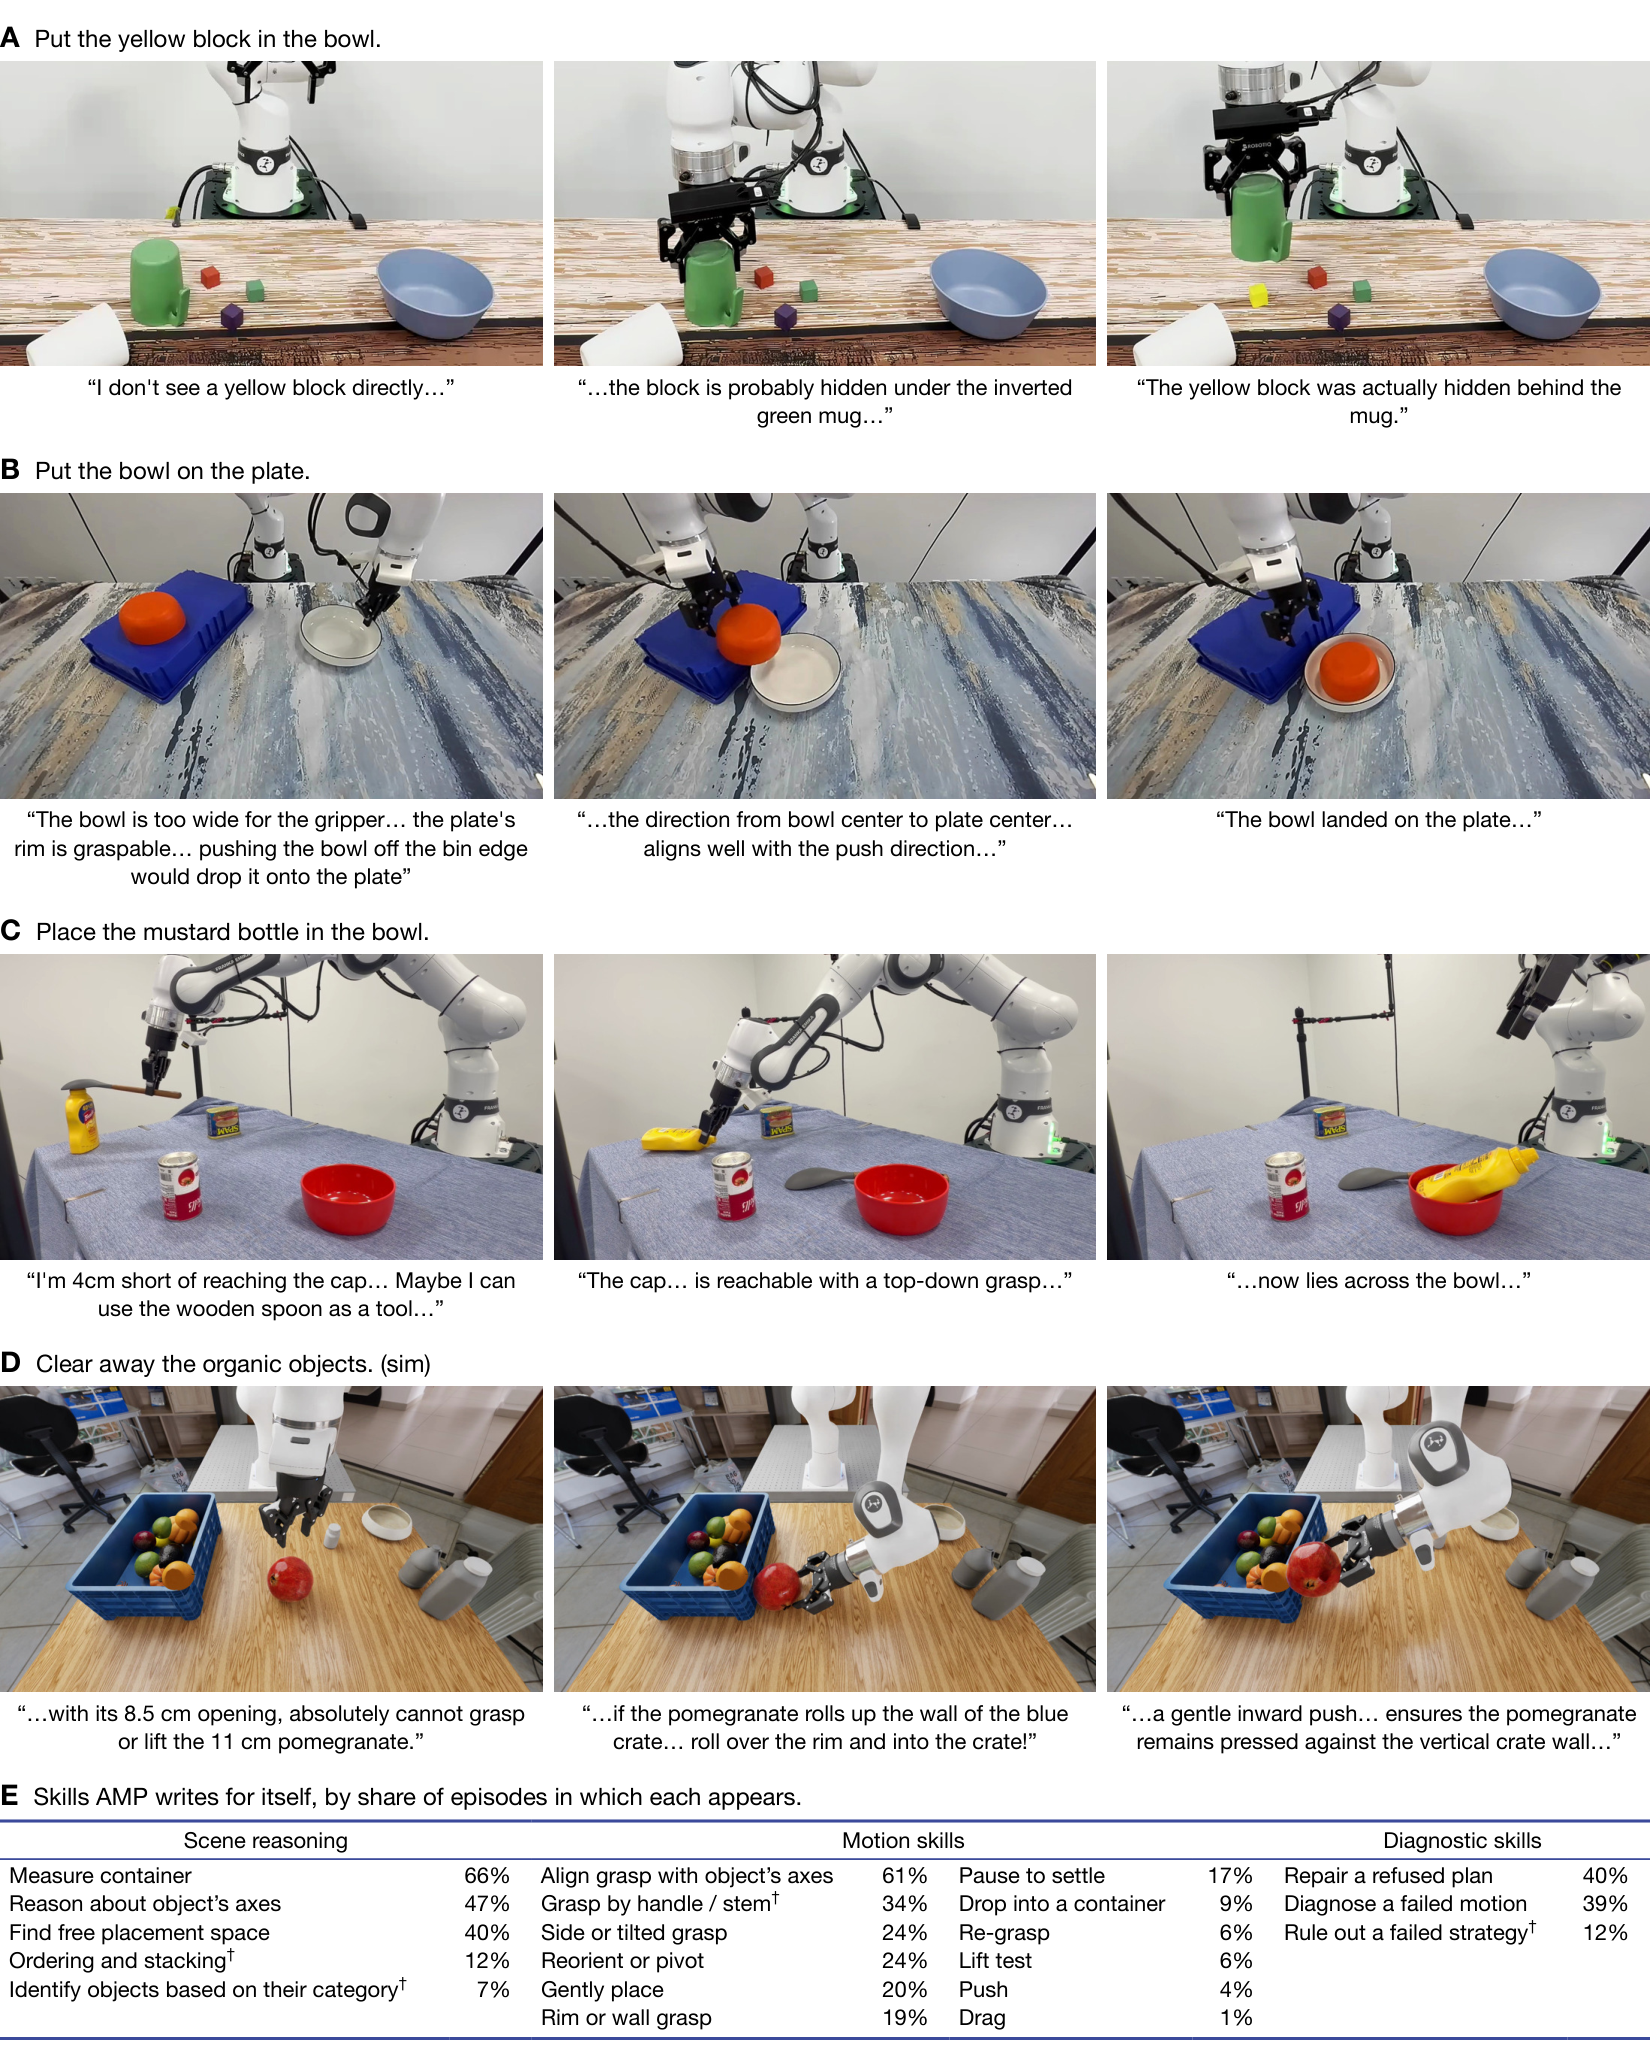
因为接口只给最底层的“看”和“动”,模型碰到抓不了、看不见的情况,只能自己想办法。论文里最好懂的例子是真机任务“把碗放到盘子上”:碗倒扣在一个箱子上,比夹爪张开的宽度还宽,也没有边缘可以伸手指进去。在其中一次试验里,AMP1 没有硬抓,而是抓住盘子边沿把盘子推到箱子侧面贴住,再用张开的夹爪把碗推过箱面,让它从边缘掉到盘子上,整个过程中碗一次都没被夹起来。另一些试验里它换了做法:先把碗推到箱子边、让一部分悬空,再从悬空处抓起。这个任务 AMP1 成功 7/9,π0.5 2/9,FLUX 3 Action 0/9。
类似的还有:目标藏在别的东西后面,就推开可能遮挡的物体逐个找;在仿真里,石榴比夹爪最大张开的 85 毫米还宽,就把它抵在更重的物体上,把夹爪从下面铲进去像叉车一样抬走,或抵着箱壁往上滚(图 3D);瓶子够不着,先用逆运动学算出差多远,再在桌上找够长的木勺把它拨过来。在真机上,一次动作没对准时,它比较“命令夹爪去的位置”和“画面里夹爪实际出现的位置”,推断出相机标定有偏差,并在后续动作里修正。这些都不在提示词里,也不是预置技能。
证据:真机和四个仿真基准
真机实验用 Franka 机械臂和两侧肩部加腕部共三个摄像头(深度由立体匹配模型从双目画面估出),在背景、标定和线缆各不相同的三套平台上各做 3 次。每种方法开始时物体摆放一致,执行时间上限 5 分钟(不算模型思考时间),抓放了指令外的物体算失败。π0.5 按它训练时的习惯只用左肩和腕部相机,FLUX 3 Action 和 AMP1 多用右肩相机。
| 任务(节选) | π0.5 | FLUX 3 Action | AMP1 |
|---|---|---|---|
| 把所有柠檬和那个橙子放到盘子里 | 0/9 | 0/9 | 9/9 |
| 除了锤子,把所有工具放进右边的箱子 | 3/9 | 2/9 | 9/9 |
| 用铲子把四个方块推成一条直线 | 0/9 | 0/9 | 9/9 |
| 用杯子盖住每个方块,再掀开黄色方块那只 | 0/9 | 0/9 | 9/9 |
| 12 个任务合计 | 30/108(27.8%) | 49/108(45.4%) | 104/108(96.3%) |
两个基线经常抓错东西,连指令里明确排除的锤子也会被抓起来;遇到抓不到的物体,它们会一直重复不可行的抓法直到超时。AMP1 失败的 4 次里,两次是倒方块时有方块落在盘外,两次是碗滚下了桌。它在真机上的主要麻烦是碰撞:运动规划依赖相机标定,机器人几何也做了简化。碰撞触发机械臂保护停机后,AMP1 可以调用函数请求恢复再继续;基线遇到这种错误则直接判失败。去掉恢复功能,AMP1 是 94/108(87.0%),仍远高于基线。
仿真上,RoboLab-120(120 个按语言描述的操作任务,每个 10 次)里,AMP1 配 Gemini 4 Argon 成功率 85.6%,配 Opus 5.5 为 82.8%;排行榜上最好的 VLA 和 WAM 分别是 49.2% 和 42.9%,排行榜上已有条目中最好的是另一个基于大模型的智能体,57.1%。指令改成模糊或更具体的说法,AMP1 的成功率只变化约 3 个百分点。CaP-Gym 的三组任务上,AMP1 都是一次尝试、不针对任务练习(LIBERO-PRO 和 robosuite 的数字配的是 Gemini 4 Argon):LIBERO-PRO 95.2%,robosuite 700 次全成功(含两个双臂任务),BEHAVIOR-1K 的两个移动操作任务 48/50。少数比它高的对手,都在被评测的任务上反复练习过程序或技能。AMP1 在 LIBERO-PRO 里 LIBERO-Goal 这部分任务上的失败几乎都是它自认为完成了;作者人工复看后认为,这些结果多半符合人对指令的理解,只是和基准的判定规则不一致(比如炉子哪一侧算“前面”)。
收益来自模型,还是来自接口
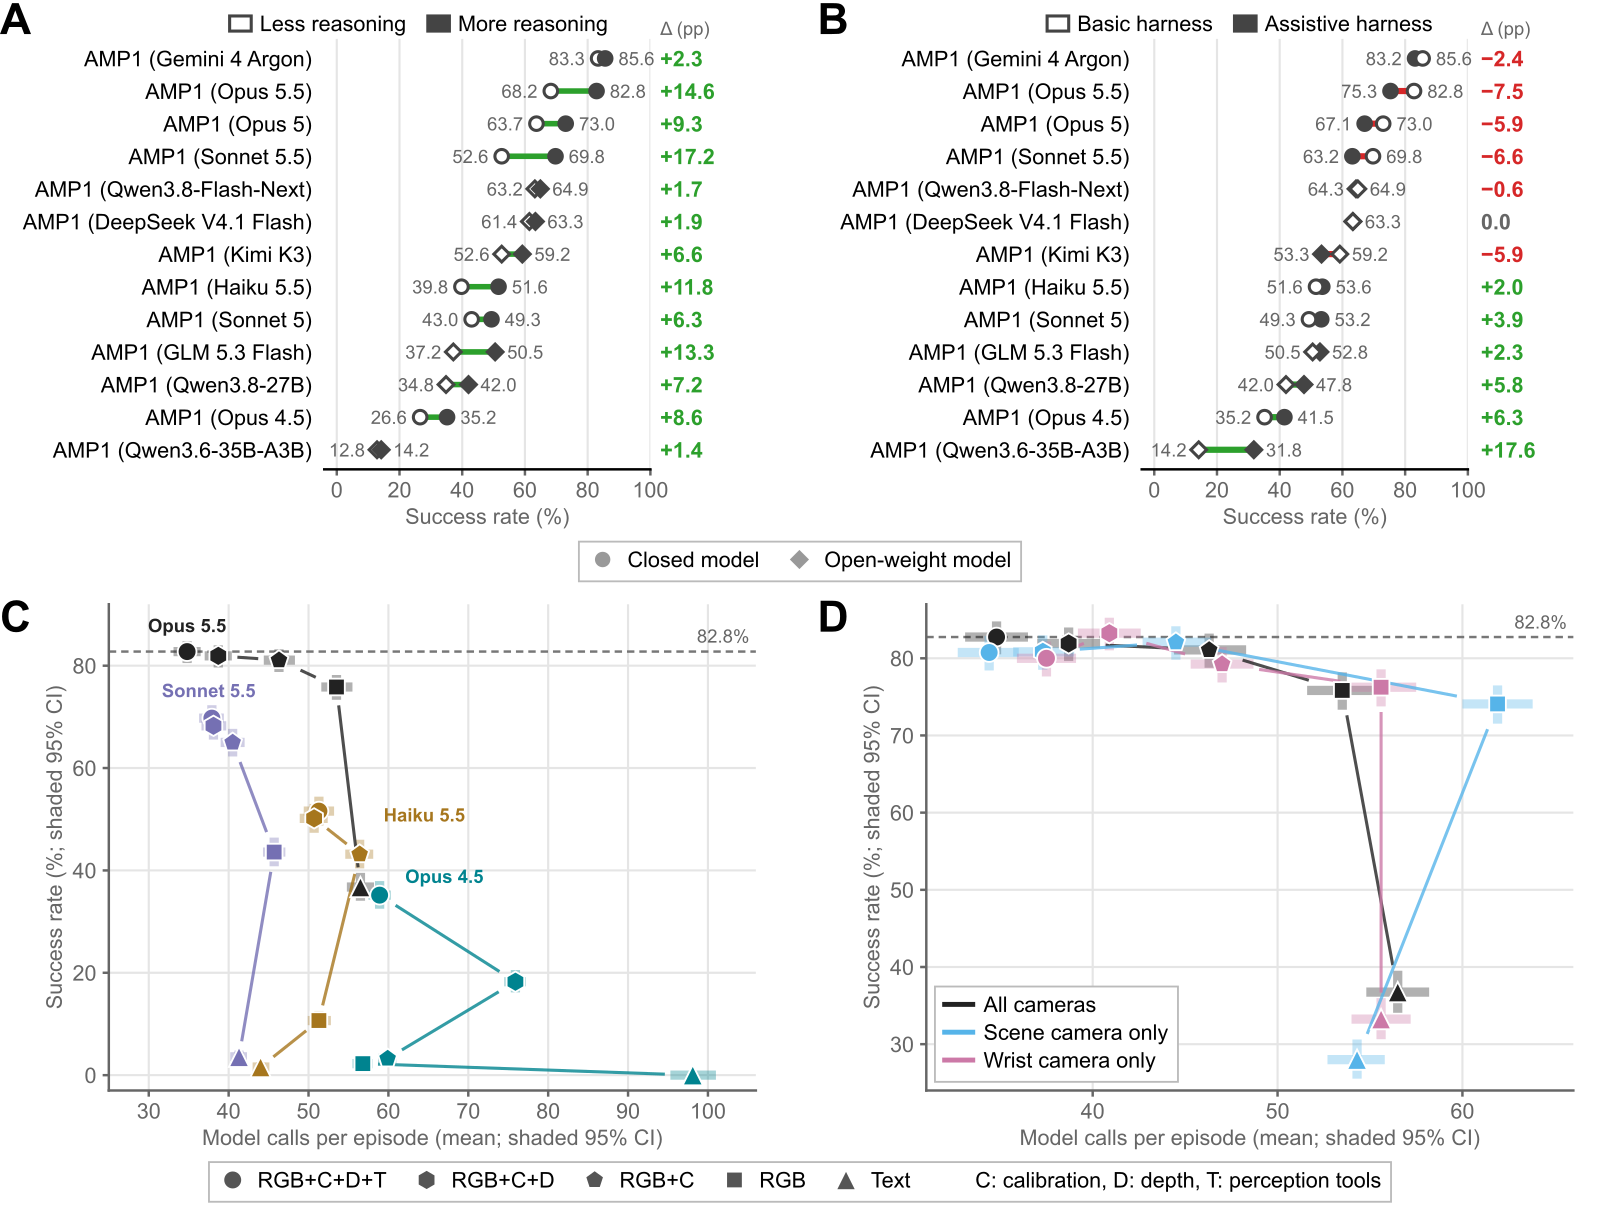
作者固定接口、只换模型,13 个模型在 RoboLab-120 上的成功率从 12.8%(Qwen3.6-35B-A3B)到 85.6%(Gemini 4 Argon),说明决定成败的首先是模型。同属 Claude 系列,Opus 5.5 是 82.8%,小一号的 Haiku 5.5 是 51.6%,老一代 Opus 4.5 是 35.2%。每个模型都跑了 reasoning effort 低、高两档,其他条件不变;调高后所有模型都有提升,Opus 5.5 提升 14.6 个百分点。在 AMP1 接口上的各种改动,影响都不及换模型。
接口上最有意思的一组对比,是另做了一个“辅助接口”:模型可以请求排好序的抓取和放置位姿,由运动规划器执行无碰撞的抓放,没抓住会自动换个抓法重试;模型仍可随时退回基础接口自己控制。结果,基础接口下最强的四个模型用了辅助接口都变差,Opus 5.5 从 82.8% 降到 75.3%;最弱的六个模型都变好,最弱的 Qwen3.6-35B-A3B 提升 17.6 个百分点。作者的解释是失败信息被藏起来了:辅助工具在内部重试,最后只报告“成功”或“失败”,不说哪里出了错。弱模型自己抓放的成功率比这些工具低,所以有工具更好;强模型本来能看到每一步的结果并及时纠正,工具反而挡住了它的视线。
感知上,作者逐步拿掉输入。Opus 5.5 的成功率和每次任务的模型调用次数依次是:全部输入(彩色图、深度、标定、物体分割工具)82.8%、34.8 次;去掉分割工具 81.9%、38.7 次;再去掉深度 81.1%、46.3 次;再去掉标定、只剩彩色图 75.8%、53.5 次。它是自己把缺的信息补回来的:没有深度时,它在不同摄像头的放大图里找同一个点,用已知标定做三角测量算出 3D 位置;连标定也没有时,它把腕部相机随机械臂移到几个已知的夹爪位姿拍照(夹爪位姿机器人自己知道),匹配特征点,用最小二乘拟合出焦距、主点和相机相对夹爪的位姿。弱模型做不到这一点:只剩彩色图时,Haiku 5.5 只有 10.7%。最后一组把图像换成文字描述(由同一模型的另一个实例看图后写),Opus 5.5 从只用彩色图时的 75.8% 掉到 36.8%,因为文字说不清“夹爪和物体有没有对齐”这类几何细节。
带上记忆,从经验里学
前面的结果都是每个任务从零开始。作者又给 AMP1 加了一个跨回合保留的记忆文件夹(称为 AMP1+),格式不限;模型通常存一份 Markdown 笔记(哪些做法成功、哪些坑、有用的参数)和一个 Python 代码库,后面的任务直接读笔记、调代码,模型权重始终不变。实验在 RoboDojo 上做:42 个双臂任务,只给彩色图,没有深度和标定;每个任务附带场景描述和评分细则。
第一组实验是每个任务单独练习、各得一份记忆。练习时,每轮并行跑 4 次,基准只告诉成功或失败;一轮结束后,其中一个实例回看到目前为止各轮的全部记录、成败结果和历次记忆,更新记忆,决定要不要继续练,最多 12 轮。论文举的例子是麻将任务:要从牌堆拿一张牌立在一排牌的右端;模型没被告知牌必须正着立,评分却要求这一点。第 2 轮一次成功一次失败,模型放大两次的最后画面,发现成功那次牌上红色图案在下方、和旁边的牌一致,失败那次在上方;再对照动作记录,发现两次从相反两端拿起了扣着的牌,于是记下哪一端是牌的上端。再练一轮学会伸手前先张开夹爪后,这个任务在没见过的摆放上从 10% 升到 100%。
整体上,练习把成功率(按排行榜口径,先在 5 类任务内平均、再平均各类)从 26.4% 提到 84.1%,高于排行榜第一的 68.9%(注意这已经不是零样本,是在这个基准上练过之后);到第 2 轮,42 个任务里有 39 个的记忆里已有代码库,成功回合的模型调用次数减半。需要说明的是,每个任务独立地完整练了 5 次(每次最多 12 轮,各得到一份记忆),挑在另一组摆放上成功率最高的那份记忆,再在第三组没见过的摆放上评测。
另一组实验不反复练同一个任务:记忆从空开始,按随机顺序把 42 个任务各做一次,每做完一个就根据成败更新记忆,并要求只记对所有任务都有用的通用经验。做完一遍后,用最终记忆在全部 42 个任务上评测,成功率从不带记忆的 26.4% 升到 57.6%(单次运行、单一顺序)。作者还在做完第 10、20、30 个任务时各评测一次:只做完前 10 个任务后,最后 12 个还没碰过的任务成功率就从 24% 升到 47%,说明记下的多是通用知识,比如这台机器人的坐标系、动作范围、没有深度时怎么估距离。
局限
- 慢。 真机上 AMP1 成功一次平均 280 秒,211 秒在等模型思考;π0.5 和 FLUX 3 Action 成功时平均 62 秒和 44 秒(这些平均只算各自成功的试验,任务构成并不相同)。仿真里模型思考时模拟暂停,时间上限只算执行时间。论文对自己的定位是:AMP 可靠但慢,VLA/WAM 快但不可靠。
- 评测主要是准静态场景。 一段路径执行时模型不能中途改,目标移动、物体打滑这类需要即时反应的情况仍是短板。
- 比较条件不完全对等。 真机上只有 AMP1 有出错后恢复;AMP1 还用了深度和标定,而典型 VLA 只用彩色图(不过只用彩色图时 Opus 5.5 仍有 75.8%)。作者把 RoboLab-120 上相当一部分失败归因于基准本身(物体形状或重量不适合平行夹爪、判定规则不稳),这是作者自己的分析。
作者给的出路是:模型能力的成本每年大约降一个数量级;记忆里的代码可以复用、少调模型;AMP 的执行记录也可以用来蒸馏更小更快的策略。
| 问题 | 结论 |
|---|---|
| 不训练、不给技能,通用大模型能直接控制机械臂吗 | 能,真机 104/108,仿真四个基准都领先或接近最好 |
| 收益主要来自哪 | 模型能力;在 AMP1 接口上的改动影响远小于换模型 |
| 现成抓放工具有用吗 | 帮弱模型,拖累强模型,因为它藏起了失败细节 |
| 能从经验里学吗 | 能,RoboDojo 上 26.4% → 84.1%,不改权重 |
| 现在能部署吗 | 作者认为还不行:成功一次要等模型思考约 3.5 分钟,评测也主要是准静态场景 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
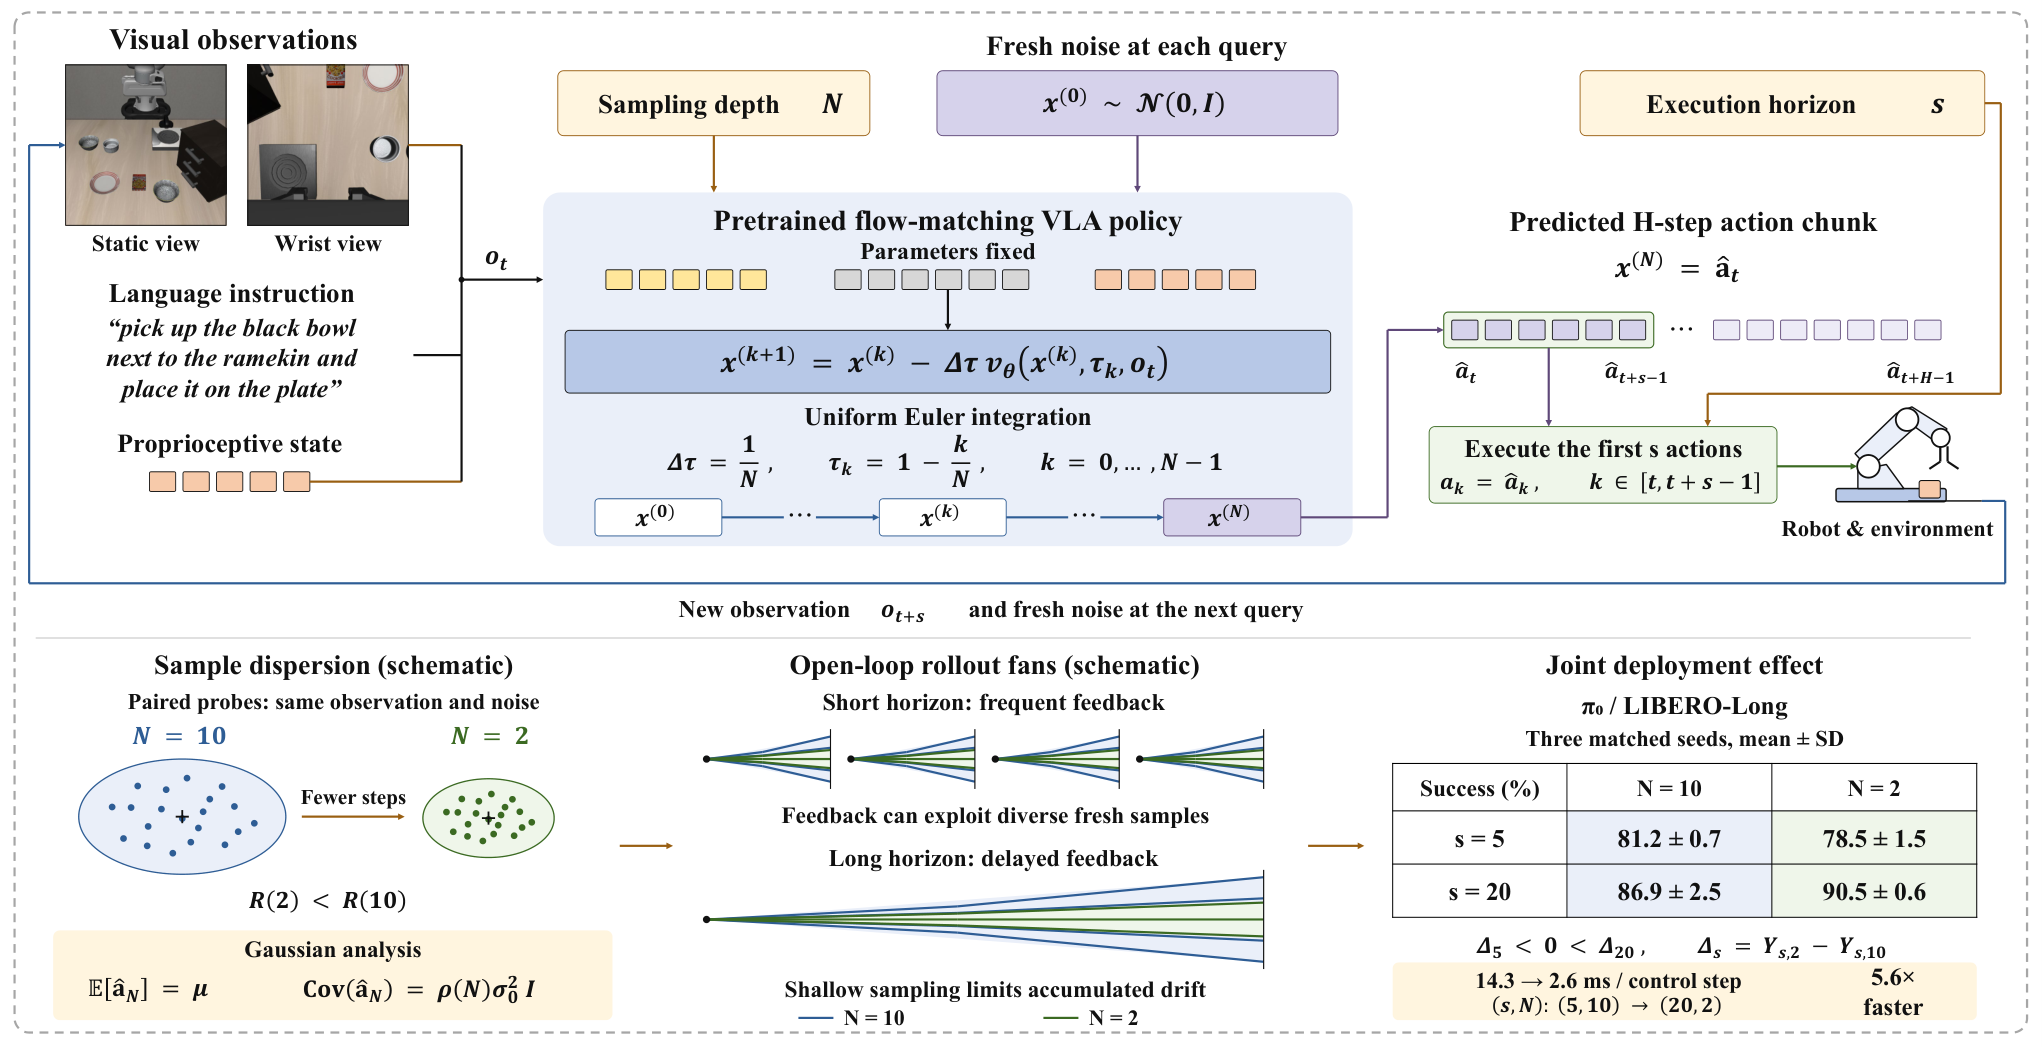 Embodied · 2026-10-27Coupling Execution Horizon and Sampling Depth in Flow-Matching VLA Policies这篇论文发现,基于流匹配的视觉语言动作模型里,求解动作的迭代步数和每次执行的动作步数是耦合的,最优选择还会反转。这类模型从一段随机噪声出发,用数值求解一步步把它推成一段平滑的动作。部署时通常把两者分开调:执行步数用来摊薄推理延迟,迭代步数则保持很高以求精确。频繁重新规划时,迭代步数少确实更差;一次执行很长一段动作时,迭代步数少反而更好,因为粗略求解让动作更集中在平均轨迹附近,减少了开环执行中误差的累积。每次只执行 5 步时,迭代 10 步更好。每次执行 20 步时,迭代 2 步反而更好。这个规律在多个基准和真机上都成立,不用训练就能降延迟、提成功率。
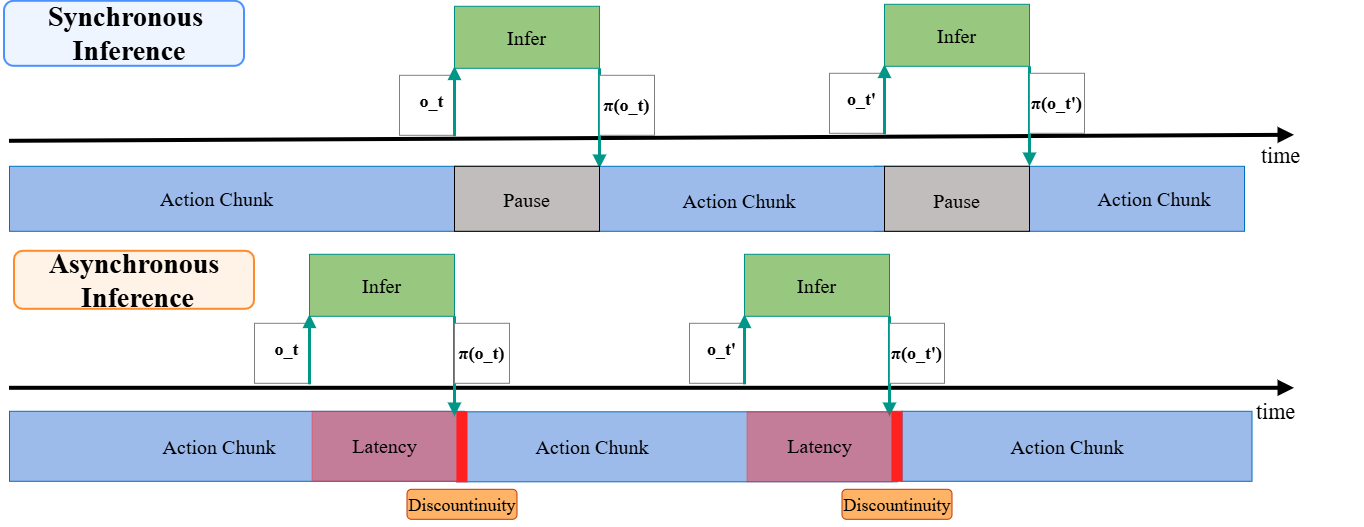 Embodied · 2026-11-16What Makes a VLA Reactive? A Study of Execution Strategies for Dynamic ManipulationVLA 模型一次预测未来一小段动作,可物体在动时,这段动作还没执行完就过时了。作者拿预训练的 π0.5 在两个动态仿真基准和三个真机任务上,系统地比较了预测多长、每次执行多少步、同步还是异步推理等执行方式。结论是预测大约一秒的动作最好;执行步数短时,异步推理帮得更多;让前后两段轨迹衔接连贯的方法,比只降延迟的方法更有效。最出乎意料的是传送带抓取任务。用强化学习微调策略能修好针对性的失败,但同一个模型什么都不训练,只把执行步数改成 5,成功率就达到 71%,和训练后一样好。机器人反应快不快,执行方式和策略本身一样重要,评测时要放在一起看。
 Embodied · 2026-11-05AIRoA-0: Long-Horizon, Precise, Cross-Embodiment Manipulation from Handheld Data机器人模仿学习一般要先在机器人上遥操作采数据,AIRoA-0 一条机器人数据都没采。它只用人拿着手持夹爪录下的 16,151 小时双手演示训练,机器人只在测试时才出场。在一个训练数据从没录过的场地,它只靠两只手腕上的相机,完成分拣零件、给扫地机器人换拖布和刷子、叠毛巾等十项任务,平均成功率 78%。同样用这些任务的演示做后训练,另外四个视觉语言动作模型(VLA)里最好的只有 27%。采数据不必绑在某一台机器人上,装同款夹爪的机器人都能直接用。
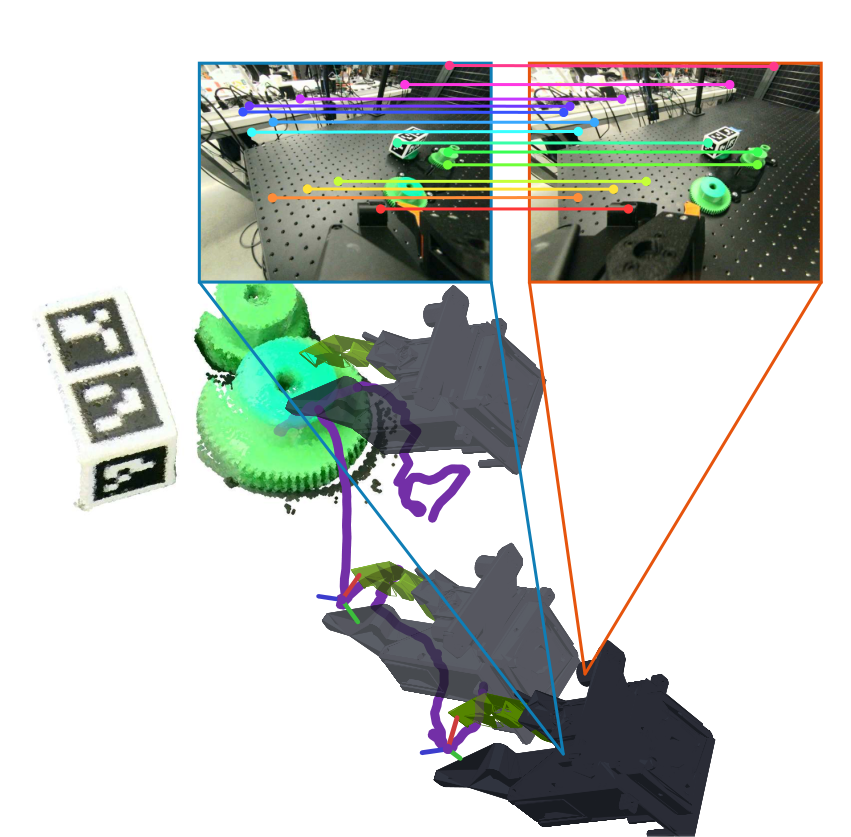 Embodied · 2026-10-29OpenJaws: An Open Hardware UMI Framework with Stereo Localization for Generalist Manipulation用手持夹爪(UMI)在野外采机器人示教数据已经很流行,但动作标签准不准,取决于从腕部相机视频里还原夹爪轨迹的那一步。原版 UMI 用单目相机加 IMU(惯性测量单元),单目看不出真实尺度,还要预先建图、贴标记物来稳住。OpenJaws 把相机换成一台百元级的双目相机,两只镜头的间距是标定好的,三角化直接给出真实尺度。在作者新做的带真值评测集上,只比两者都能跟住的片段,双目重建的轨迹误差约 2.9 毫米,原版方案是 18.4 毫米,而且原版平均只跟住 37% 的帧。整套夹爪约 400 美元,软硬件全部开源。
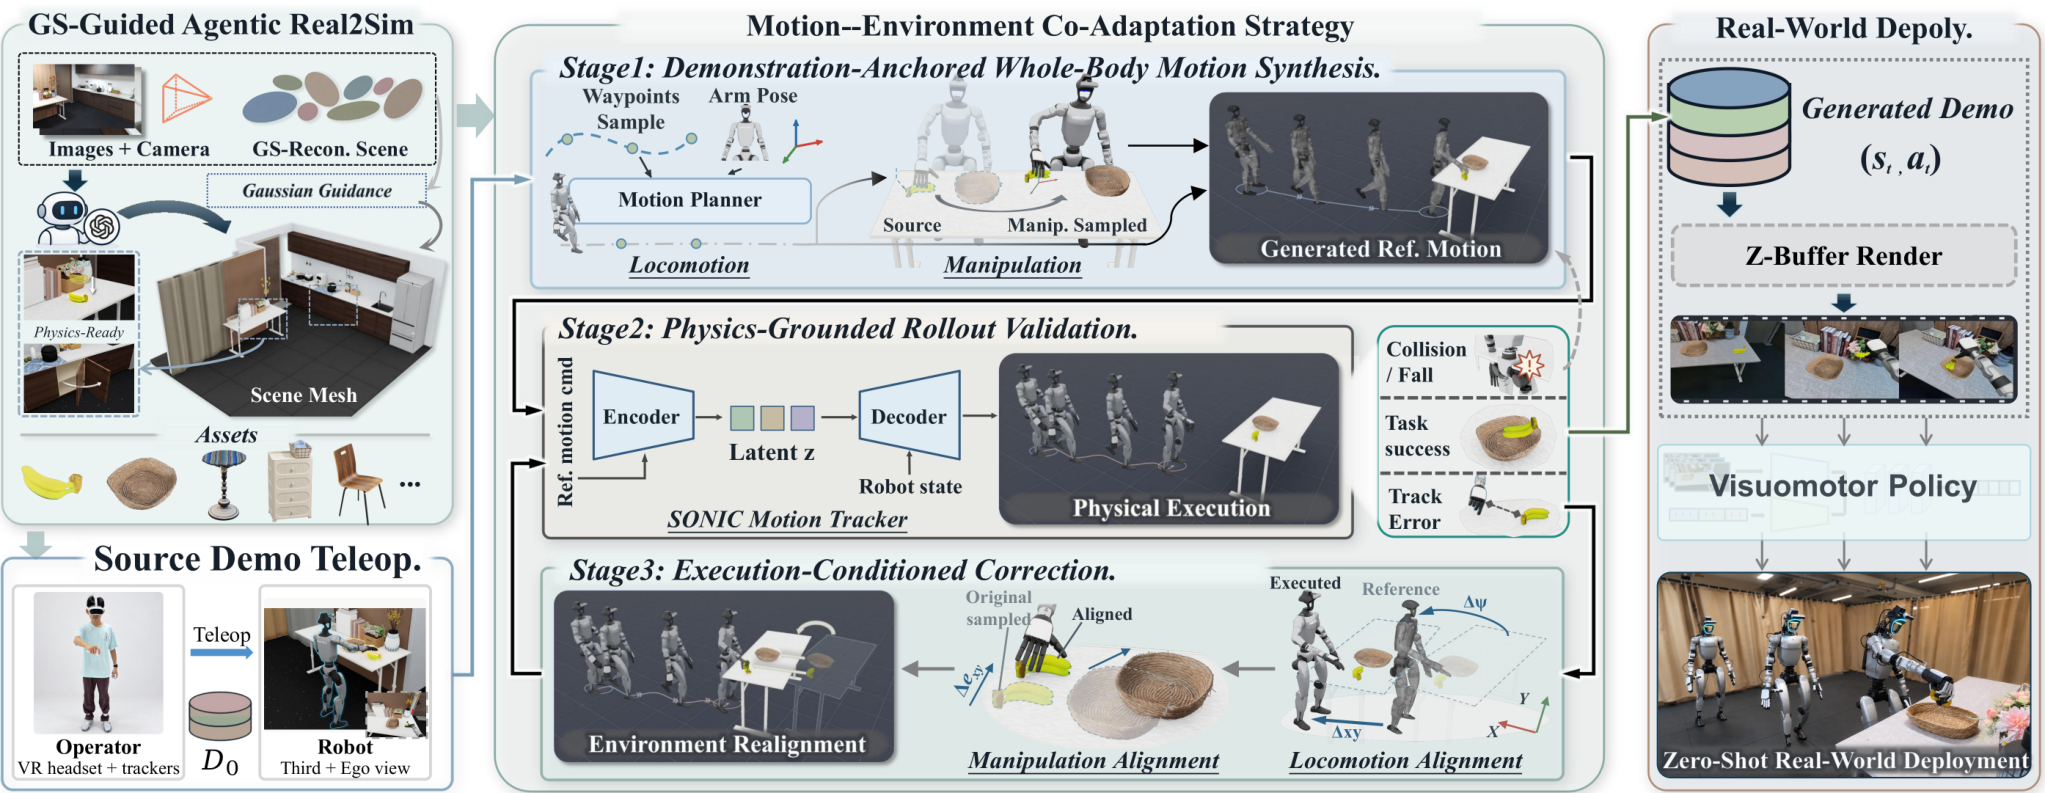 Embodied · 2026-10-28Zero-HLM: Generalizable Humanoid Loco-Manipulation without Real Robot Data人形机器人要学会走到桌前、拿起香蕉再放进篮子这类长任务,通常要靠人遥操作采上百条真机示范,桌子挪个位置往往就得重采。Zero-HLM 改为全部在仿真里造数据。它用手机拍一圈真实房间,重建成既像照片、又能做物理交互的仿真场景,再把少量遥操作示范自动改写成上千条新示范。每条新示范随机换一个机器人起点和物体、放置目标的位置,手的轨迹跟着目标一起移动,只留下在仿真里跑成功的。只用这些数据训练的策略直接上真机,三个任务平均成功率 66.7%,高于用真机示范训练的 46.7%。换到真机示范没覆盖的位置后,成功率从 23% 提到 69%。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…