目录 · 9 节
1它到底在解决什么问题?2整体流程:四个部分各管一件事3动作怎么表示:只看夹爪自己4怎么在看不到全局的情况下做长任务?5推理时怎么让动作又稳又快?6结果说明了什么7我认为它的局限8一个机器人团队可以怎么试9结论
做具身数据和机器人策略的团队值得细读:它回答的是一个更基础的问题,不采机器人数据,只靠人录的演示,能不能训出好用的双手操作模型。机器人模仿学习一般要先在机器人上遥操作采数据,AIRoA-0 一条机器人数据都没采。它只用人拿着手持夹爪录下的 16,151 小时双手演示训练,机器人只在测试时才出场。在一个训练数据从没录过的场地,它只靠两只手腕上的相机,完成分拣零件、给扫地机器人换拖布和刷子、叠毛巾等十项任务,平均成功率 78%。同样用这些任务的演示做后训练,另外四个视觉语言动作模型(VLA)里最好的只有 27%。采数据不必绑在某一台机器人上,装同款夹爪的机器人都能直接用。
它到底在解决什么问题?
遥操作数据的规模跟着机器人数量走:有几台机器人、几个操作员,就只能采这么多。手持夹爪把这件事反过来,论文用的是 YUBI(作者团队开源的手持夹爪):人两只手各拿一个夹爪,像平时一样干活,夹爪上有手腕相机,还会记录夹爪在空间里的位置和张开程度。之后同一款夹爪装到机械臂上当末端,机器人看到的画面、做出的动作,和人录数据时是同一套东西。
问题在于这种数据很难学。三个难点在数据里和部署时分别是什么样子(示意):
| 难点 | 在数据里是什么样子 | 部署时会怎样 |
|---|---|---|
| 只有人在做 | 没有一条数据是机器人失手后再补救 | 机器人碰到意外,数据里找不到参照 |
| 只有手腕相机 | 两个局部视角,看不到整张桌子 | 同一个画面可能对应任务里好几步 |
| 很多人在很多地方录 | 一百多种任务、背景五花八门 | 测试场地一定是没见过的 |
论文的思路是:每个难点在系统的哪一层出现,就在那一层解决。
整体流程:四个部分各管一件事
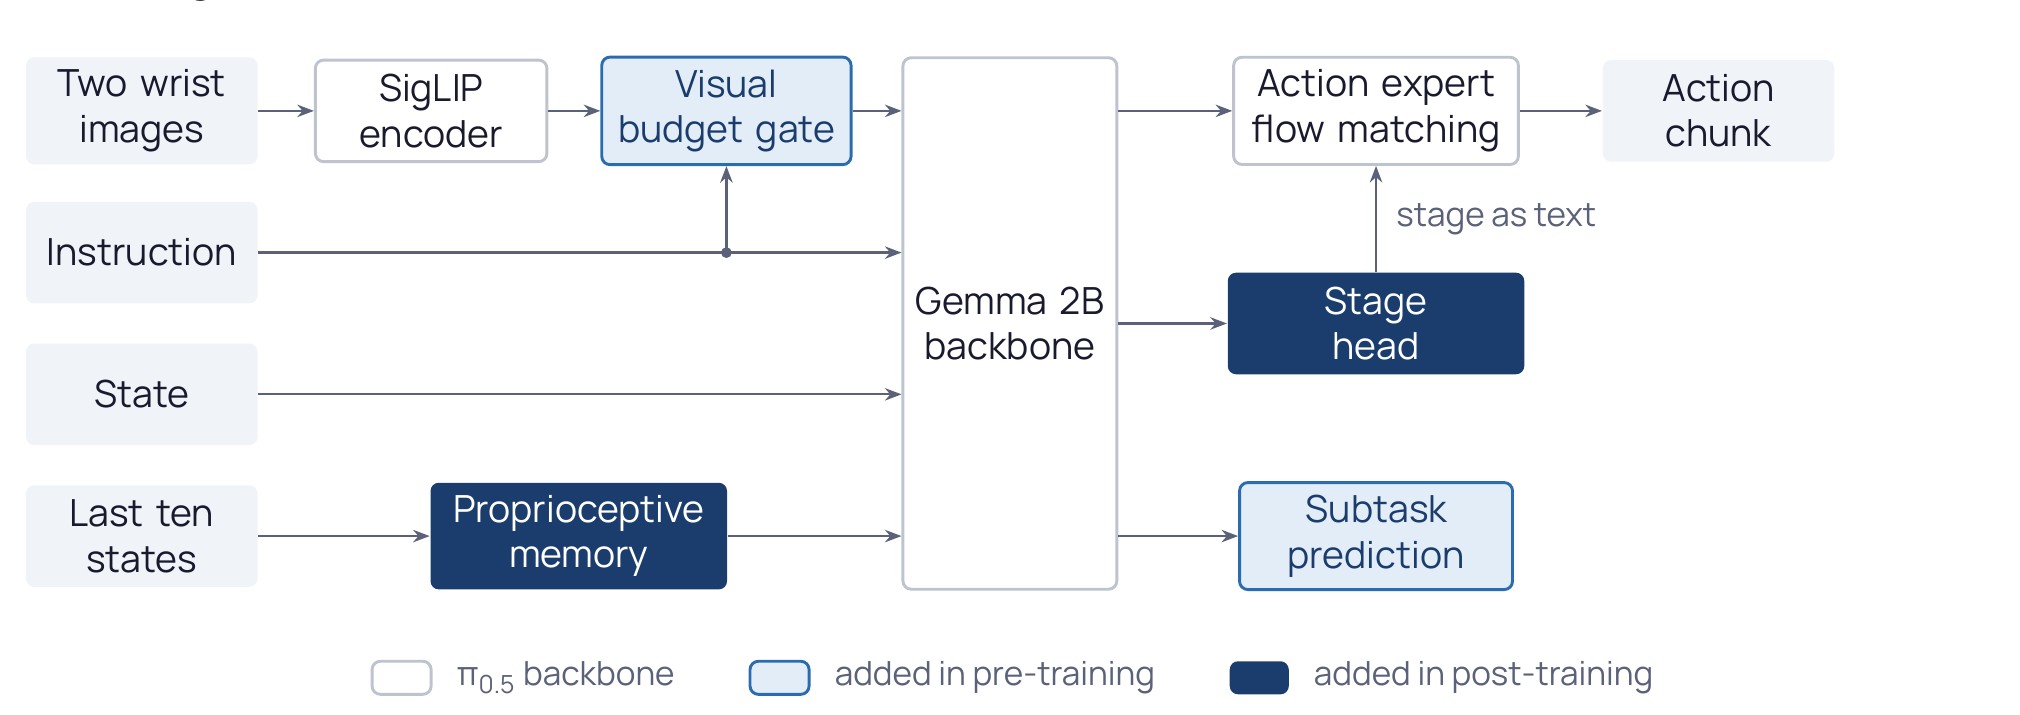
A-0 的模型骨架直接沿用 π0.5:一个 SigLIP 图像编码器、一个 Gemma 2B 的视觉语言主干,加一个用 flow matching 训练的 3 亿参数动作模块,从 π0.5 公开的预训练权重出发。在此基础上分四个部分:
| 部分 | 做什么 | 解决哪个难点 |
|---|---|---|
| 数据处理 | 过滤、异常检测等清洗 | 进训练前先清洗多人录的数据 |
| 预训练 | 视觉预算门控 + 预测当前子任务 | 背景干扰、看不到全局 |
| 后训练 | 阶段预测 + 最近动作的记忆 | 长任务里分不清在第几步 |
| 推理 | 平滑阶段预测 + 流式解码动作 | 动作要连贯、对变化要反应快 |
下面这张论文的模型图把这些部件放在一起,然后按数据流拆开讲。
动作怎么表示:只看夹爪自己
为什么要单独讲动作表示?因为人和机器人唯一共享的东西就是夹爪。人没有机器人底座,也没有关节角。A-0 的状态和动作都只用夹爪来描述:模型的输入除了两路手腕画面和指令,还有一个夹爪状态:一只夹爪相对另一只夹爪的位姿,加上两只夹爪的张开程度,共 11 个数。每个动作是夹爪接下来要到达的位姿,而且是相对于"拍下这一帧时夹爪所在位置"来写的。
举个例子(示意):拍照时左夹爪在某处,模型一次输出一串未来动作,第 1 个动作写成"在当前位置基础上往前 1 厘米",第 5 个写成"往前 4 厘米再转 10 度"。每个动作都是相对同一个起点的目标,而不是在上一个动作上再加一点,所以误差不会沿着这串动作越积越多。也因为没有用到底座或关节,同一个任务后训练出的权重,可以不改动地跑在 Franka、TX-G2 人形机器人、OpenArm 开源双臂和一对 UR(Universal Robots 公司)工业臂上。论文没说明在后面讲的流式解码里,下一次拍照时这串里还没执行的动作怎样转换成以最新位置为起点。
怎么在看不到全局的情况下做长任务?
视觉预算:让模型自己学会看哪里
手腕相机拍到的大部分东西和任务无关,而无关的部分恰恰是每个场地都不一样的部分。A-0 在每个图像 token 进入主干之前加了一个门控:一个小网络对照任务指令给这个 token 打分,输出一个保留概率,token 按这个概率缩放后再送进去。另有一个预算损失,要求一张图里所有 token 的平均保留概率接近一个目标值,后训练时这个目标是 0.9。
预算只限制平均值,至于哪些区域多保留,完全由动作损失来教,没有人工标注该看哪里。论文在 25 个子任务上画出了门控的权重:夹爪和正在操作的物体被保留,桌面、背景和房间其他地方被淡化。可以把预算理解成一笔总量固定的额度,花在画面的哪些地方,由动作做得好不好来决定。
后训练里门控还用了第二次。动作模块算 attention 时,会在它给每个图像 token 的打分上加一个偏置,偏置由这个 token 的保留概率换算而来。保留概率为 1 时偏置是 0,打分不变;保留概率接近 0 时偏置接近 −4,这个 token 经过 softmax 后分到的权重就小得多。部署时这两处都开着。

两层语言和阶段预测
数据里每段演示都有两层文字:任务指令说整件事(例如"更换扫地机器人的零件"),子任务指令说当前这几秒在做什么("取下第一块旧拖布放进盒子")。全库一共 1065 万段子任务,平均每段 5.5 秒。
预训练时,每个样本配任务指令或子任务指令之一,模型既能听一句话做完整件事,也能一步步听指挥。给的是任务指令时,主干还要额外预测当前子任务的文字。这个预测只在训练时用,不会喂给动作模块。它的作用是逼主干在表示里编码"任务进行到哪了",动作模块读的正是同一份表示。
后训练更进一步。一个长任务被切成几个阶段,每个阶段是几步连续的子任务。每个阶段都有一句写好的说明。例如零件分拣分成三个阶段,第一个阶段的说明是“把手指件、翻板件和齿轮放进 1、2、3 号格”。后训练加了一个阶段分类头。它读主干对当前画面的表示,预测任务处在哪个阶段。预测出哪个阶段,就把这个阶段的说明作为文字交给动作模块。这和预训练时动作模块学着照做的子任务指令是同一种形式。论文模型图里,这条连线标作“stage as text”。论文没说明阶段文字从哪里接进动作模块。它只说每次查询时画面编码一次。训练标签直接来自演示里已有的子任务标注,不用额外标。为什么需要它?因为两个手腕画面常常同时符合任务里的好几步,不显式说清在哪一步,动作模块只能在动作分布里硬猜。 Hoot 说

预训练
- 动作模块听到
- 数据里写好的任务指令或子任务指令
- 谁给出这句话
- 数据标注
- 主干额外做的事
- 给任务指令时,预测当前子任务的文字,只在训练时用
目的:逼主干在表示里记住任务进行到哪了。
后训练
- 动作模块听到
- 预测出的那个阶段的说明
- 谁给出这句话
- 阶段分类头,读主干对当前画面的表示
- 训练标签
- 演示里已有的子任务标注,不用额外标
目的:两个手腕画面分不清在哪一步时,明确告诉动作模块。
左边是预训练,右边是后训练。动作模块照做的一直是一句文字说明。区别在于这句话是谁给的。后训练时由阶段分类头自己判断,所以长任务里不用人一步步提示。
出处
论文 §5.1 和图 7(stage as text)后训练还加了一段最近动作的记忆。记忆里放最近 10 个夹爪状态,也就是上面那 11 个数。录数据时它们来自手持夹爪的追踪,部署时是机器人实际测得的值。每个状态都带上距今多久。4 个可学习的查询向量参考指令和当前状态,对这 10 个状态做 attention,把整段历史压成 4 个 token 放进输入。为什么记时间而不是记第几步?因为不同机器人查询策略的频率不同。训练时按 5 到 15 Hz 随机抽取历史,同一个策略就能在这个范围内的任意频率下用。训练时有四分之一的时间故意不给这段记忆,让模型没有它也能工作。
推理时怎么让动作又稳又快?
阶段是每次查询重新预测的,偶尔判错一次,动作模块就会去做另一个步骤。所以推理时对各阶段的预测概率做指数滑动平均,取平均后最可能的阶段。偶然的一次误判几乎拉不动平均值,真正换阶段时又能跟上。
动作解码用的是流式解码,这个做法来自 FlashVLA。标准的 flow matching 每一串动作都要从纯噪声出发,动作模块算 10 遍。流式解码维护一个缓冲区,里面放着几串噪声程度不同的动作,每次查询时,动作模块根据最新画面给缓冲区里的每串动作都去掉一部分噪声。最前面那串去完最后一点噪声后交给机器人的控制器,控制器按自己的节奏跟着这串动作走,后面补进一串新噪声。论文没说明缓冲区里的动作具体怎样换算到最新夹爪位置,只说这件事由运行框架负责。
FlashVLA 里各串动作的噪声等级是均匀排开的,每次去掉多少噪声由槽位数决定。槽位少时,执行前最后一步要去掉的噪声太多,相邻两串动作之间会出现接缝。槽位多时,每串动作都基于很早的画面定型,场景一变反应就慢。
A-0 的改进是让步长不均匀:离执行越近,修正越小。它只用两个槽位,噪声等级是 0.1 和 1。新进来的一串动作先从纯噪声一大步降到 0.1,执行前再根据最新画面从 0.1 修到 0。
每次查询也更便宜。按论文的计算,稳态下每次查询画面只编码一次,动作模块算 2 遍,而标准解码是 10 遍。一次查询在 H200 上约 60 毫秒。
结果说明了什么
主实验在 Franka 双臂平台上做,场地里没有任何一条训练数据。表里是每个任务多次测试的平均成功率(%)。四个对比模型都从各自公开权重出发,用同样的任务演示后训练,而且每个任务都在多组设置里取最好成绩;A-0 十个任务只用一套配方。
| 任务 | 后训练数据(小时) | A-0 | π0.5 | XR-1 | GR00T N1.7 | MolmoAct2 |
|---|---|---|---|---|---|---|
| 叠毛巾 | 3.3 | 73 | 22 | 21 | 0 | 8 |
| 字母积木 | 3.4 | 84 | 13 | 0 | 24 | 0 |
| 橙子金字塔 | 3.4 | 90 | 2 | 52 | 13 | 28 |
| 零件分拣 | 4.0 | 83 | 30 | 13 | 7 | 12 |
| 颜色分拣 | 4.1 | 97 | 45 | 39 | 20 | 19 |
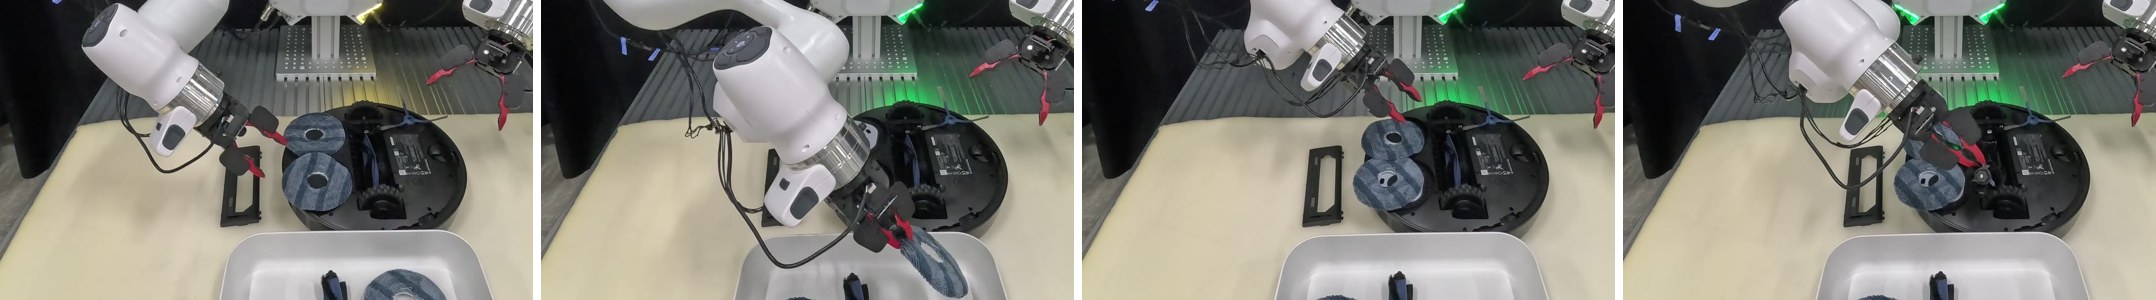
| 扫地机器人换件 | 5.3 | 73 | 1 | 14 | 1 | 3 |
| 燃油支架 | 6.3 | 93 | 34 | 33 | 47 | 11 |
| 拉开笔袋 | 8.8 | 73 | 36 | 31 | 15 | 23 |
| 叠杯子金字塔 | 17.9 | 80 | 71 | 11 | 23 | 36 |
| 耳机 | 25.8 | 30 | 13 | 18 | 10 | 3 |
| 十项平均 | 78 | 27 | 23 | 16 | 14 |
A-0 在每个任务上都最高。好几分钟的长任务上差距尤其明显:扫地机器人换件,最好的基线只有 14%,A-0 是 73%。这是整套系统的结果,表里没有把各个部件拆开单独测。
每个任务的后训练数据也不多,十个里有六个只用了 3 到 6 小时。这意味着有了预训练好的模型,加一个新任务只要录几个小时的手持演示。
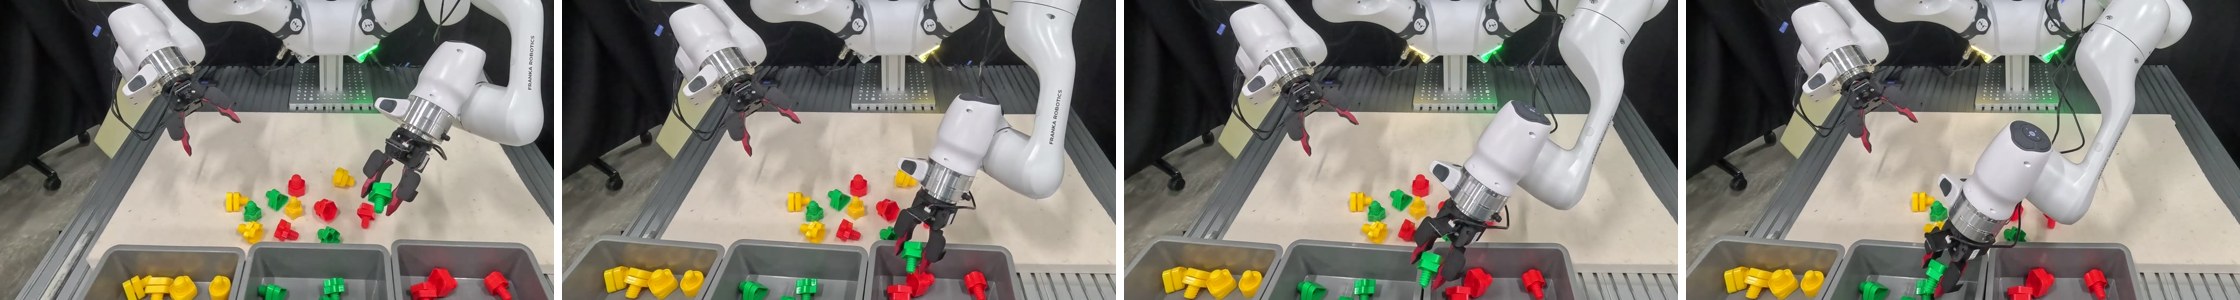
训练数据里没有一条机器人遇到干扰时的演示,但 A-0 会按眼前看到的东西行动。颜色分拣时,有人在机械臂把绿色零件送过去的途中把一排盒子推开,夹爪下方变成了红盒子。机械臂没有停下重来,而是一个连贯动作移到绿盒子上方放下。这说明它是按画面里盒子的位置放零件,而不是记住盒子原来在哪;非均匀流式解码则让动作在每次查询拿到新画面时保持连贯。
要判断手持数据能不能靠规模取胜,最直接的证据是预训练数据量的实验。作者用全量、一半、四分之一、八分之一、十六分之一的数据各预训练一次,每个都取第 10 万步的检查点,再在同样 16 组任务上后训练。这 16 组任务的演示没有进过任何一次预训练,几个模型的后训练设置完全相同。数据多的模型在后训练后损失始终更低,差距不会被后训练追平。损失和预训练数据小时数大致服从幂律,从约 1000 到 16000 小时,数据每翻一倍,后训练后的损失降低约 2.4%。手持数据越录越多,模型就越好,这是这条路线能不能走下去的关键。
我认为它的局限
第一,比较不完全公平。基线是按各自的最佳设置调过的,这一点对 A-0 不利;但 A-0 的预训练数据就是同一批手持数据,基线的预训练数据来自别处,所以 78% 对 27% 里有多少来自数据本身、多少来自方法,表格分不出来。成功率表也只比较了完整系统,没有去掉单个模块的对照。
第二,扩展规律看的是损失,不是成功率。2.4% 的降幅是在留出演示上的动作损失,扩展实验没有报告对应的真机成功率,损失降低多少能换来多少成功率还不清楚。
第三,跨机器人只有展示,没有数字。TX-G2 上展示了 4 项任务,OpenArm 3 项,UR 2 项,但成功率只在 Franka 上测过。换到这三台机器人后成功率会掉多少,现在不知道。
一个机器人团队可以怎么试
- 先在自己的机械臂上装好 YUBI 夹爪和手腕相机当末端,因为 A-0 只能驱动这样的机器人。然后拿公开权重和配方,用手持夹爪在自己场地录一个 3 到 6 小时的任务做后训练,看成功率能否接近论文里的同类任务,这一步只要一台八卡 H200 机器,不到四小时。
- 把同一任务再录一份遥操作数据做对照,看手持数据在自己的机械臂上差多少。
- 长任务单独试阶段预测:按演示里的子任务切出阶段,对比有无阶段头时卡在哪一步。
结论
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。数据采集是具身智能最大的瓶颈,这篇证明了不用机器人也能采到可用的数据 |
| 方法创新性 | 中。各部件多来自已有工作,贡献在于把它们组成一套能跑长任务的系统 |
| 实验证据 | 中高。十项真机任务有成功率,但只在 Franka 上测;另三台机器人只有展示,也缺模块消融 |
| 工程成本 | 中。数据和权重开源,后训练一台八卡机器四小时 |
| 是否值得尝试 | 值得。已有手持夹爪的团队可以直接拿配方试 |
最关键的启发是:只要状态和动作都定义在人和机器人共用的那个工具上,人录的数据就能直接变成机器人的训练数据,规模跟着录数据的人走,而不是跟着机器人走。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
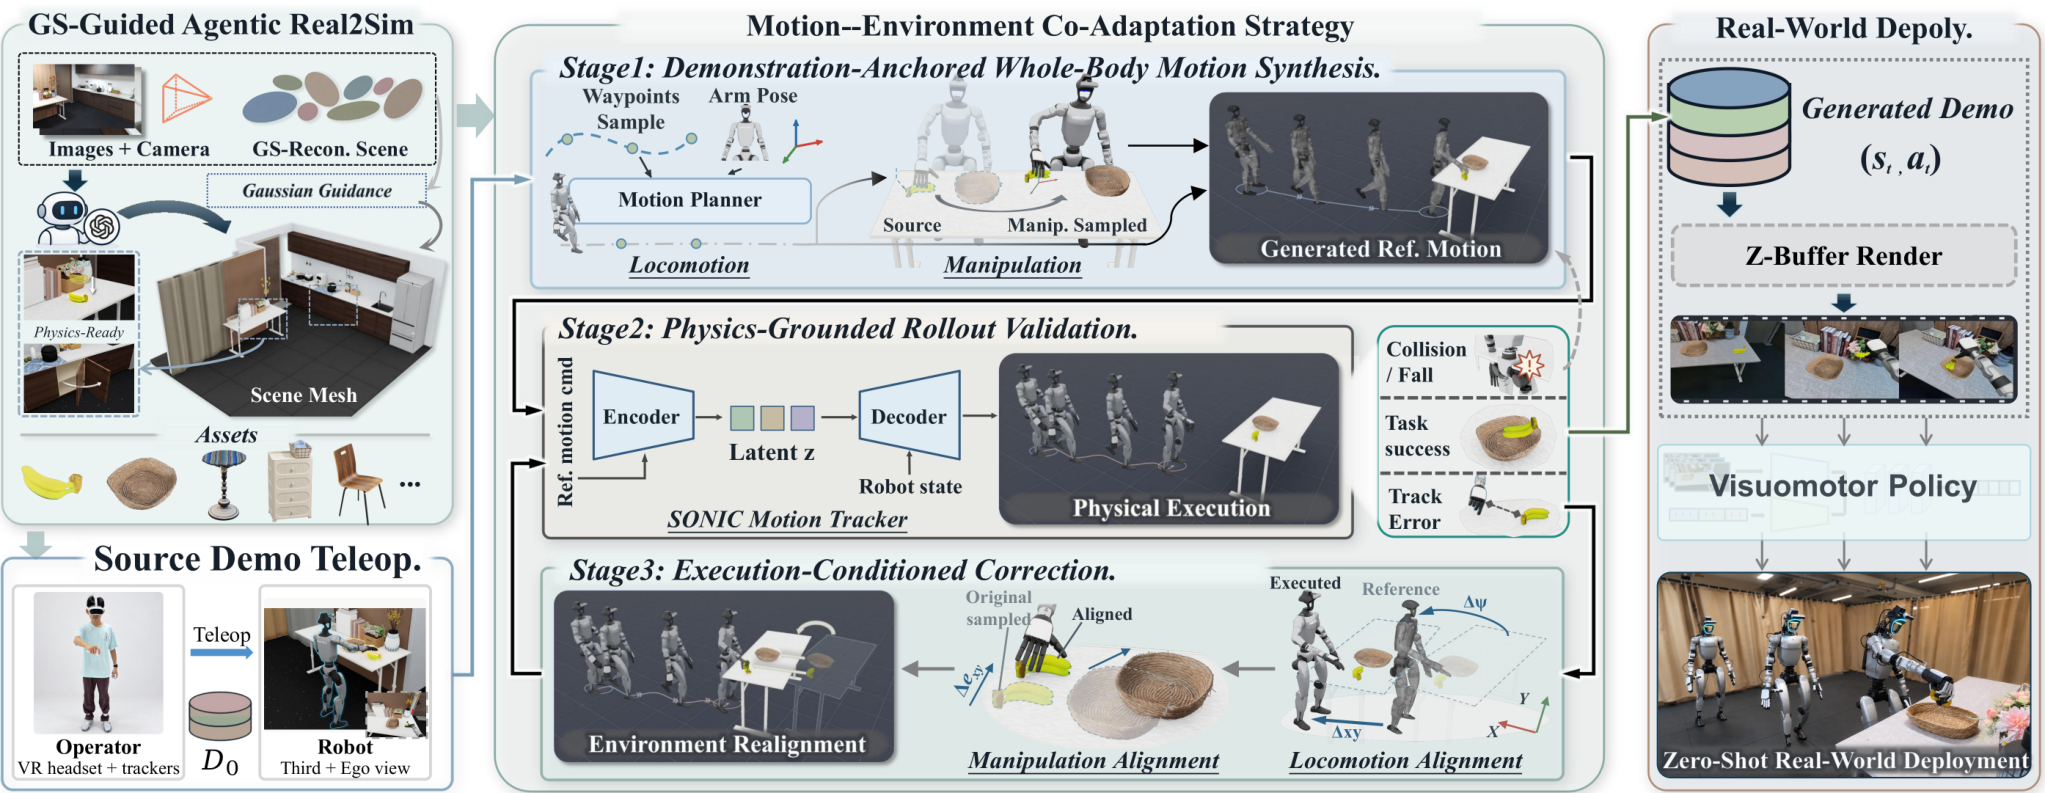 Embodied · 2026-10-28Zero-HLM: Generalizable Humanoid Loco-Manipulation without Real Robot Data人形机器人要学会走到桌前、拿起香蕉再放进篮子这类长任务,通常要靠人遥操作采上百条真机示范,桌子挪个位置往往就得重采。Zero-HLM 改为全部在仿真里造数据。它用手机拍一圈真实房间,重建成既像照片、又能做物理交互的仿真场景,再把少量遥操作示范自动改写成上千条新示范。每条新示范随机换一个机器人起点和物体、放置目标的位置,手的轨迹跟着目标一起移动,只留下在仿真里跑成功的。只用这些数据训练的策略直接上真机,三个任务平均成功率 66.7%,高于用真机示范训练的 46.7%。换到真机示范没覆盖的位置后,成功率从 23% 提到 69%。
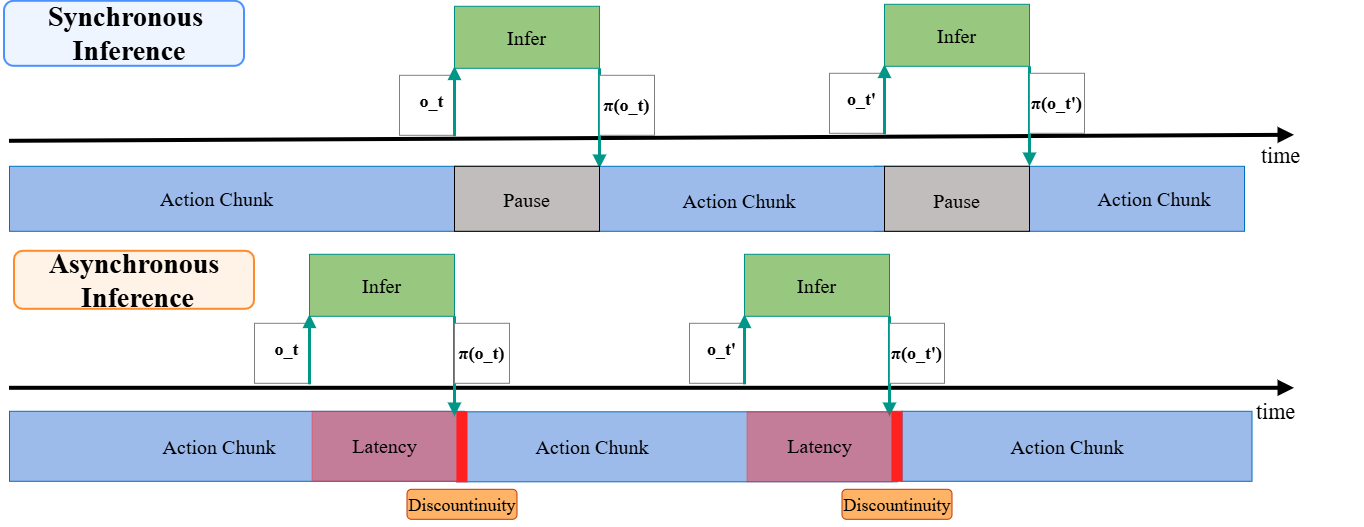 Embodied · 2026-11-16What Makes a VLA Reactive? A Study of Execution Strategies for Dynamic ManipulationVLA 模型一次预测未来一小段动作,可物体在动时,这段动作还没执行完就过时了。作者拿预训练的 π0.5 在两个动态仿真基准和三个真机任务上,系统地比较了预测多长、每次执行多少步、同步还是异步推理等执行方式。结论是预测大约一秒的动作最好;执行步数短时,异步推理帮得更多;让前后两段轨迹衔接连贯的方法,比只降延迟的方法更有效。最出乎意料的是传送带抓取任务。用强化学习微调策略能修好针对性的失败,但同一个模型什么都不训练,只把执行步数改成 5,成功率就达到 71%,和训练后一样好。机器人反应快不快,执行方式和策略本身一样重要,评测时要放在一起看。
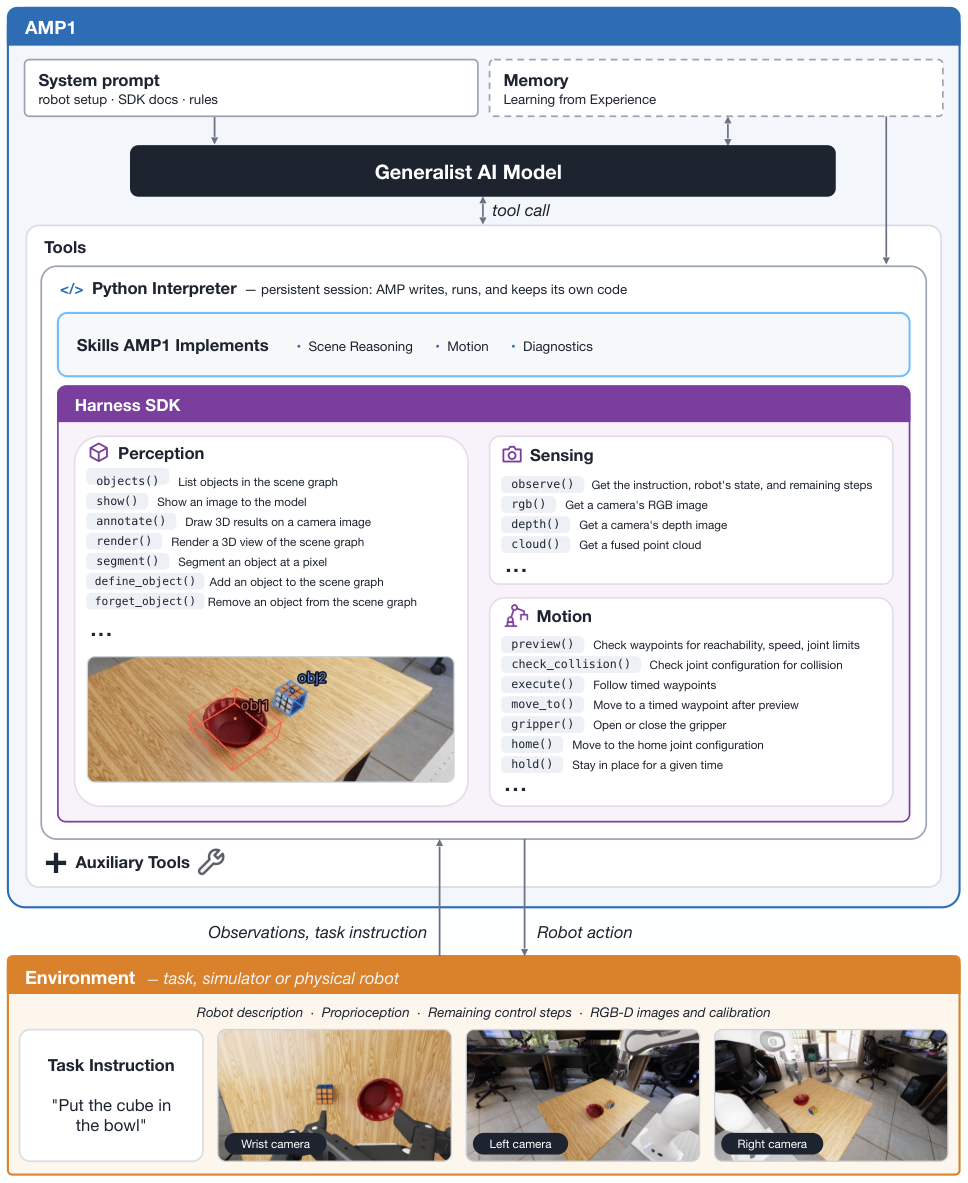 Embodied · 2026-11-10On Agentic Manipulation Policies机器人操作不一定非要靠大量演示数据训练专用策略。这篇论文让一个通用大模型当 agent,直接给机械臂下指令,边做边看情况调整,不用任何演示,也不做针对任务的训练,成功率反而远高于专门训练的 VLA 策略。作者的参考实现 AMP1 在 RoboLab-120 基准上零样本成功率达到 85.6%,领先的 VLA 策略只有 49.2%;在三台真机、十二个任务上也几乎全部成功。系统没给它抓、推、放这类现成技能,它自己摸索出寻找藏起来的物体、拿物体当工具、校准相机等办法。通用模型直接当控制器,可能比专门训练的策略更通用、更稳。
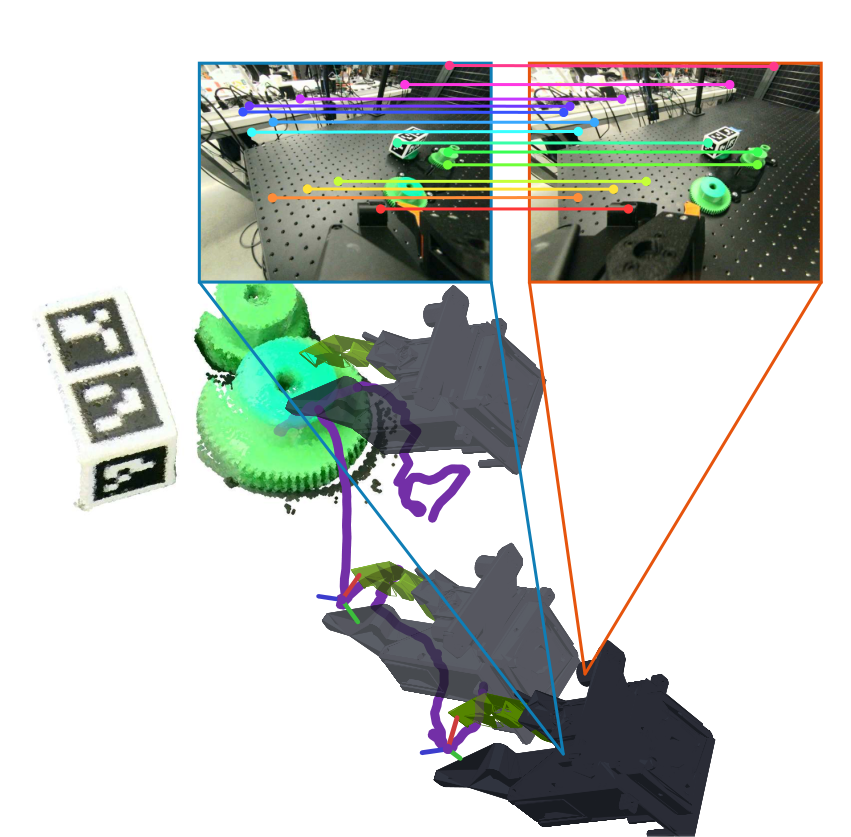 Embodied · 2026-10-29OpenJaws: An Open Hardware UMI Framework with Stereo Localization for Generalist Manipulation用手持夹爪(UMI)在野外采机器人示教数据已经很流行,但动作标签准不准,取决于从腕部相机视频里还原夹爪轨迹的那一步。原版 UMI 用单目相机加 IMU(惯性测量单元),单目看不出真实尺度,还要预先建图、贴标记物来稳住。OpenJaws 把相机换成一台百元级的双目相机,两只镜头的间距是标定好的,三角化直接给出真实尺度。在作者新做的带真值评测集上,只比两者都能跟住的片段,双目重建的轨迹误差约 2.9 毫米,原版方案是 18.4 毫米,而且原版平均只跟住 37% 的帧。整套夹爪约 400 美元,软硬件全部开源。
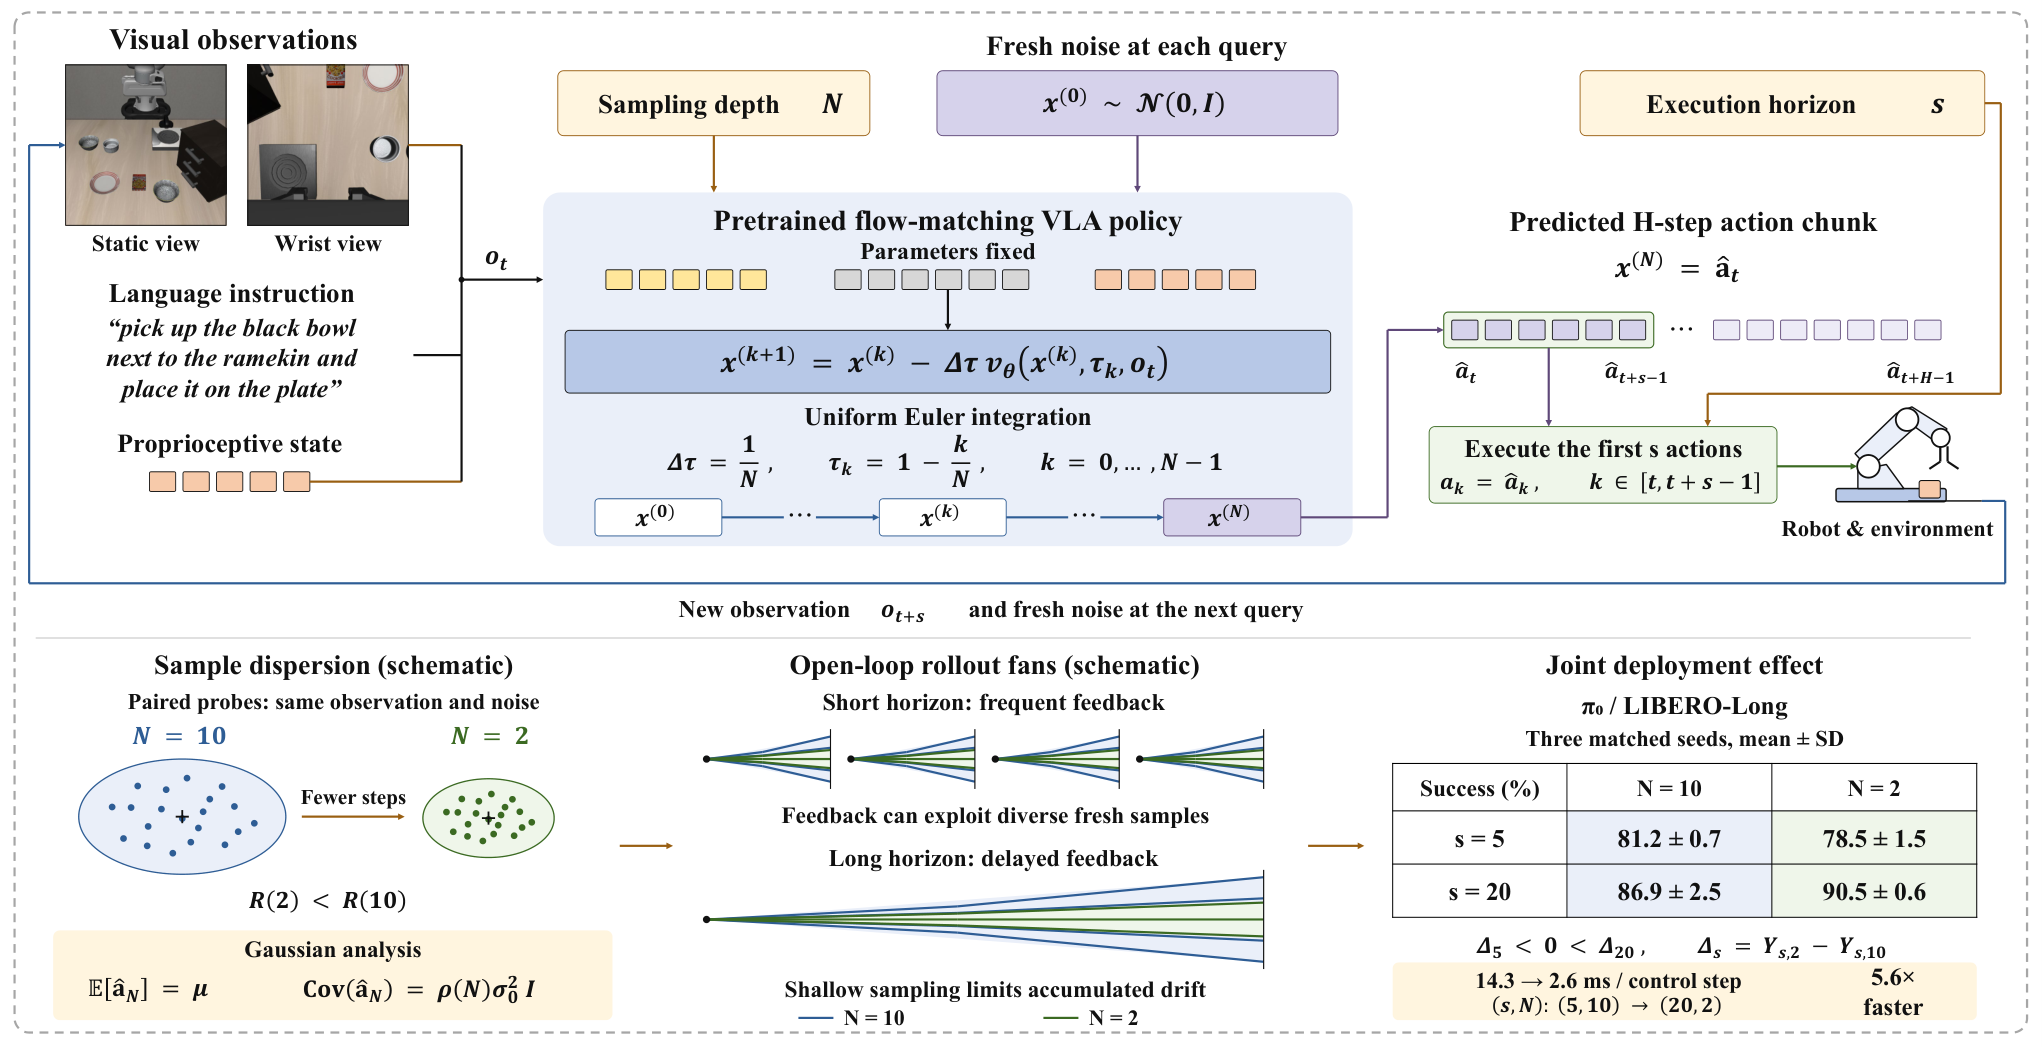 Embodied · 2026-10-27Coupling Execution Horizon and Sampling Depth in Flow-Matching VLA Policies这篇论文发现,基于流匹配的视觉语言动作模型里,求解动作的迭代步数和每次执行的动作步数是耦合的,最优选择还会反转。这类模型从一段随机噪声出发,用数值求解一步步把它推成一段平滑的动作。部署时通常把两者分开调:执行步数用来摊薄推理延迟,迭代步数则保持很高以求精确。频繁重新规划时,迭代步数少确实更差;一次执行很长一段动作时,迭代步数少反而更好,因为粗略求解让动作更集中在平均轨迹附近,减少了开环执行中误差的累积。每次只执行 5 步时,迭代 10 步更好。每次执行 20 步时,迭代 2 步反而更好。这个规律在多个基准和真机上都成立,不用训练就能降延迟、提成功率。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…