目录 · 7 节
1留四分之一的 token,LIBERO 上快 1.57 倍2一次训练和一次部署各走哪几步3Top-k 不能求导,所以训练时改用软门控4动作对上了,还要能推出 8 步后的画面5成功率不比旧方法高,赢在同样成功率下更快6未来画面监督加了约 1 个点,打乱配对后动作误差更高7真机上快 1.47 倍,成功率基本持平
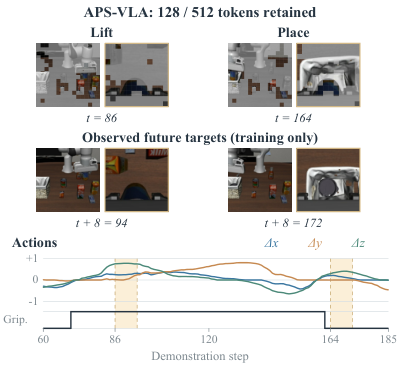
APS-VLA 的剪枝器不看当下的注意力挑 token,而是从示范里学两件事:这一步做了什么动作,8 步之后画面变成了什么。
VLA(视觉-语言-动作模型,看画面和指令直接输出机械臂动作)每个控制步都要看一遍相机画面。画面先被切成小方块(patch),每块变成一个视觉 token,再和指令、机械臂状态一起送进大模型,最后输出动作。OpenVLA-OFT 用两个相机,每一步要处理 512 个视觉 token。可下一步动作往往只取决于画面里很小的一块,剩下的 token 只是在拖慢推理。
下面用一个示意例子贯穿全文:指令是「把橙汁拿起来放进篮子」。难点在于,该留哪些 patch 一直在变。提起罐子时,要盯罐子和夹爪之间的相对位置;放下时,要找篮子口在哪里。指令从头到尾是同一句话,画面里真正决定动作的区域却换了地方。
现有的剪枝方法多依赖静态的空间冗余(例如合并彼此相似的背景块)、即时的指令相关性(留下和指令文字相关的块),或者启发式的重要性打分。这些准则没有直接针对任务推进中不断变化的控制关键线索。放回橙汁例子里,从提起到放下,该留的区域从罐子和夹爪换成了篮子口,而上面这些准则本身并不以跟上这种变化为目标。另一条路是把整个 VLA 主干一起微调,让它学会在少量 token 上工作,但训练和显存代价都很大。
留四分之一的 token,LIBERO 上快 1.57 倍
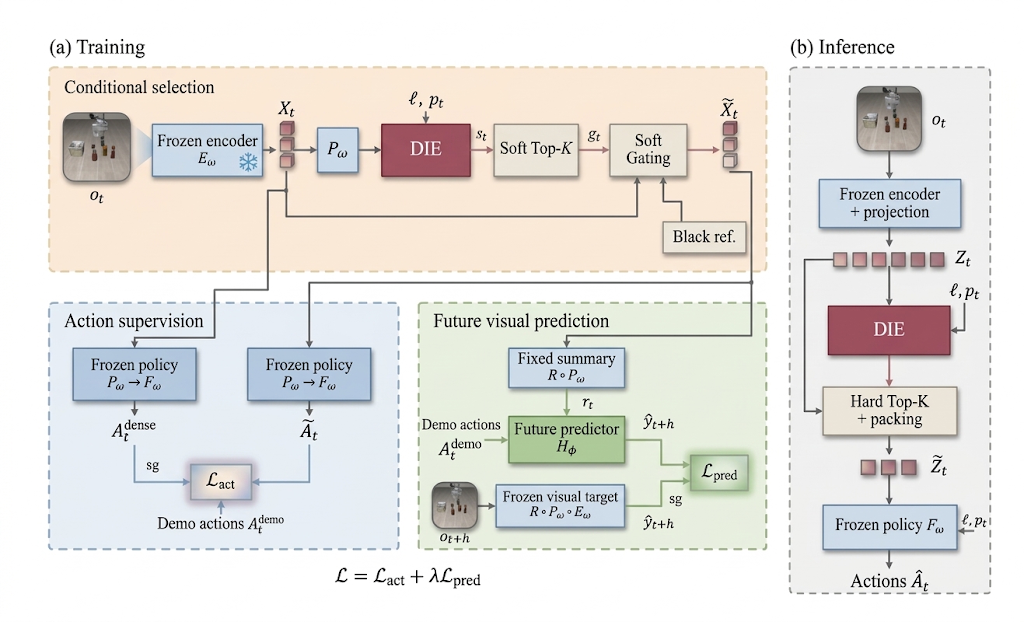
APS-VLA 把主干完全冻结,只训练一个 256 维的小打分器。论文把它叫 DIE(Decision Influence Estimator),它给每个视觉 token 打一个「这块对下一步决策有多重要」的分。部署时每一步按分数在每个相机里留前 k 个,打包后交给原来的策略照常生成动作。
在 LIBERO(四组桌面操作任务)上,OpenVLA-OFT 从 512 个 token 剪到 128 个,快 1.57 倍,平均成功率从 97.00% 降到 95.75%。真机上快 1.47 倍,成功率 60.0% 对 61.0%。这说明扔掉四分之三的视觉 token 之后,冻结的策略大体还能照常干活,省下的主要是延迟。
一次训练和一次部署各走哪几步
打分器只在训练时接触示范数据。部署时它只看当前画面、指令和机械臂状态(本体感受,例如关节位置和夹爪开合)。
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 1 打分 | 当前所有视觉 token、指令、本体感受 | DIE 给每个 token 打分 | 512 个分数 | 否 |
| 2 软门控 | 分数、每个相机的预算 | 把分数换成 0 到 1 的权重,每个相机权重之和等于预算 | 带权重的完整 token 序列 | 是 |
| 3 动作监督 | 加权后的 token | 过冻结策略,和两个动作目标比 | 动作损失 | 是 |
| 4 未来画面监督 | 加权后的画面摘要、示范动作 | 小预测头预测 8 步后的画面摘要 | 预测损失(权重 0.1) | 是 |
| 5 硬选择 | 分数 | 每个相机取前 k 个,按原顺序打包 | 128 个 token 的短序列 | 否(只在部署时用) |
示意:在橙汁例子里,DIE 在某一步产出的中间结果大致是这样一份清单。外部相机 256 个 patch 各有一个分数,留 64 个;手腕相机同样留 64 个。提起阶段,手腕相机留下的多是罐身和夹爪指尖附近的块;放下阶段,留下的多换成篮子边沿和开口的块。两份清单拼起来按原位置排好,就是交给策略的 128 个 token,其余 384 个直接扔掉。
Top-k 不能求导,所以训练时改用软门控
硬 Top-k 是「要么留、要么扔」,梯度传不回打分器。所以训练时用软门控:每个 token 拿到一个 0 到 1 的权重,乘在它的特征上。权重由分数减去一个阈值、再过 Laplace 分布的累积函数得到,阈值按相机单独求,使这个相机的权重之和正好等于预算。
示意:一个相机只有 4 个 patch,预算是 2。打分后权重可能是 0.9、0.8、0.2、0.1,加起来正好是 2。分数高的两块几乎全保留,另外两块只剩一点。训练中温度逐渐降低,权重会越来越接近 1 和 0,也就越来越像部署时的硬选择。训练时 512 个位置都还在,只是被加权;部署时才真的把 384 个扔掉、把剩下的打包。 Hoot 说

训练:软门控
- 序列长度(示意)
- 4 个位置全在
- 每块怎么处理
- 特征乘上自己的权重
- 权重之和
- 0.9+0.8+0.2+0.1 = 2,等于预算
- 梯度
- 经权重传回打分器
温度降低后权重逼近 1 和 0,越来越像右边
部署:硬 Top-k + 打包
- 序列长度(示意)
- 只剩 A、B 两个位置
- 每块怎么处理
- 留下的原样保留,C、D 直接扔掉
- 真实规模
- 512 个里扔掉 384 个,剩 128 个
- 梯度
- 不需要:只做推理
省延迟的是这一步:序列真的变短了
示意:一个相机只有 4 个 patch(A–D),预算 2,权重沿用正文的 0.9、0.8、0.2、0.1。真实场景是 512 个 token 留 128 个。
出处
论文 §3.1(训练保留完整 token 布局以便求导,部署才选出并打包);§3.3(Laplace CDF 门控、按预算解阈值、温度退火);§3.4(部署时每个相机硬 Top-k 并打包)动作对上了,还要能推出 8 步后的画面
第一个信号是动作。加权后的 token 送进冻结策略,输出的动作要同时贴近两个目标:一是同一策略看满 512 个 token 时给出的动作(下文叫教师动作),二是示范里记录的动作,两者等权。只对齐示范动作,剪枝后的策略可能偏离它原本学到的行为;只对齐教师动作,又没有锚定到真实操作。梯度穿过冻结策略,只更新打分器。
只靠动作信号还不够。作者的理由是,长任务或没见过的任务组合里,不同交互状态常常需要相似的动作。示意:罐子刚离开桌面时,和罐子已经悬在篮子上方时,机械臂可能都在缓慢上抬。动作目标几乎一样,它分不出打分器这时有没有留住篮子口的那几块。
所以有第二个信号:用示范里接下来 8 步的动作,加上当前被选中的画面,去预测 8 步之后的画面长什么样。预测头拿到的视觉信息只能来自被选中的当前摘要,预测未来摘要的误差会把梯度传回打分器。作者希望借此让打分器保留对后续画面变化有用的区域。示意:如果打分器扔掉了篮子口那几块,预测头手里虽然还有示范动作,但要猜准罐子 8 步后落在哪儿会更难。
预测目标不是整张图,而是一个固定的小摘要。每个相机经投影后的视觉 token(不是像素)按位置分进 2×2 的 4 格,每格内取平均,再用一个固定的高斯随机投影压到 64 维,并做不带可学参数的 LayerNorm。当前摘要和未来目标用的是同一个固定的摘要算子,不参与训练。两个相机就是 2 × 4 × 64 = 512 维的一个向量。示意:橙汁例子里,8 步后的摘要大致记录了「左下格里罐子已经在篮子上方」这类粗粒度布局,不需要还原像素。
这里有一个关键约束。预测头拿到的画面信息,只来自被门控过的当前摘要;未来画面只当目标,不回传梯度。如果预测头能直接看完整画面,预测得好坏就和打分器选了什么无关,这个信号也就教不了打分器。总损失是两者相加,预测项权重 0.1:
部署时,预测头整个去掉,也不需要在线预测未来画面。每一步只多出 DIE 打分、每个相机一次 Top-k 和打包。 Hoot 说
实际设计:只看选中的当前摘要
- 画面输入
- 被门控的当前 token,经固定摘要算子压成 512 维
- 其他输入
- 示范里接下来 8 步的动作
- 预测目标
- 8 步后画面的同一种摘要,截断梯度
- 扔掉篮子口那几块(示意)
- 要猜准罐子落点更难,误差变大
- 梯度去哪
- 预测头 → 摘要算子 → 门控权重 → 打分器
预测误差随选择变化,所以能把梯度传回打分器(权重 0.1)
反设想:预测头直接看完整画面
- 画面输入
- 全部 512 个 token,不经门控
- 其他输入
- 示范里接下来 8 步的动作
- 预测目标
- 同上
- 扔掉篮子口那几块(示意)
- 预测头照样看得到,误差不变
- 梯度去哪
- 只训练预测头,打分器拿不到这条信号
预测得再准,也和打分器选了什么无关
左边是 APS-VLA 的实际设计,右边是一个反设想(不是论文里的方法)。两条信号的梯度都只更新打分器和预测头:冻结策略不更新参数,但梯度能穿过它;固定摘要算子不训练,但同样能让梯度穿过;未来目标被截断梯度,只当答案用。
出处
论文 §3.2(动作监督:梯度穿过冻结策略只更新选择器;视觉转移监督:固定摘要算子 R,视觉信息只经门控后的当前摘要进入预测头,未来观测是截断梯度的目标);§4.1(h=8,辅助权重 0.1)成功率不比旧方法高,赢在同样成功率下更快
下表是 LIBERO 上的主要对比。延迟在单张 A800、batch 1 下测量,包含视觉编码、DIE、Top-k、打包和完整的动作生成。
| 方法 | 平均成功率 | 延迟(ms) | 加速 |
|---|---|---|---|
| OpenVLA-OFT 未剪枝 | 97.00 | 107.95 | 1.00× |
| VLA-Cache | 96.63 | 92.60 | 1.17× |
| SAFE-Pruner | 96.40 | 73.30 | 1.47× |
| SpecPrune-VLA | 96.10 | 73.94 | 1.46× |
| VLA-ACL | 95.83 | 71.49 | 1.51× |
| VLA-ADP | 95.75 | 94.17 | 1.15× |
| APS-VLA 留 256 | 96.58 | 81.39 | 1.33× |
| APS-VLA 留 128 | 95.75 | 68.75 | 1.57× |
| APS-VLA 留 64 | 93.92 | 66.21 | 1.63× |
留 128 个 token 时,APS-VLA 的成功率低于 VLA-Cache、SAFE-Pruner、SpecPrune-VLA 和 VLA-ACL,和 VLA-ADP 持平。这说明它在 LIBERO 上的优势不在成功率,而在相近成功率下延迟最低。比较条件也不完全对齐:APS-VLA 和未剪枝基线在作者的开发评测集上跑,其他方法的数字取自原文献,延迟里有估算值。
再往下剪到 64 个,延迟只从 68.75 ms 降到 66.21 ms,成功率却掉到 93.92%。作者的解释是,剪掉超过 75% 之后,精细接触和多阶段协调需要的空间线索开始丢失。放回橙汁例子(示意):每个相机只剩 32 块,提起时罐子和指尖之间那几块可能就挤不进来。
RoboCasa365 是一个更长、带任务组合的厨房仿真基准,分三类:见过的单步任务(A-S)、见过的组合任务(C-S)、没见过的组合任务(C-U)。在 XR-1 策略上,APS-VLA 平均快 1.52 倍,两类组合任务上比最强的剪枝基线 VLA-ACL 高 3.00 和 1.64 个点。这说明在 XR-1 的两类组合任务上,剪枝后 APS-VLA 丢掉的成功率比 VLA-ACL 少。π0.5 在两类组合任务上本身只有 7.10% 和 1.20%,所以它那几格的差异很难解读。
未来画面监督加了约 1 个点,打乱配对后动作误差更高
消融里,A 是只用动作信号,B 是再加未来画面监督。留 256、128、64 个 token 时,B 比 A 分别高 1.41、1.17、1.17 个点。这说明未来画面监督有稳定但不大的增益,三个预算下方向一致。
作者还检验了未来目标是否必须和示范正确配对,做法是一个对照:把未来画面目标在同一任务的不同示范之间打乱,动作和当前画面不变。在 LIBERO-Long、留 128 个 token、训练 2,000 次时,对齐目标下教师动作的 L1 误差是 0.011973,打乱后是 0.019251,低 37.8%。这说明未来目标和示范正确配对时,剪枝后的教师动作误差更低。打乱同时换掉了目标所属的轨迹和场景,所以这组对照不能单独归到时间对应上;它也只比了动作误差。
预测项权重在 0.03 到 0.3 之间变化时,平均成功率最多差 1.67 个点,0.1 最好。这说明权重在这个范围里不太敏感,不需要细调。
真机上快 1.47 倍,成功率基本持平
真机实验用两台双臂平台,各带三个相机,跑 5 个任务:关抽屉、关微波炉、红块放进碗、叠衣服、收玩具再擦桌子。APS-VLA 和未剪枝基线用同一个任务微调过的 π0.5 检查点,每个任务各跑 40 次。
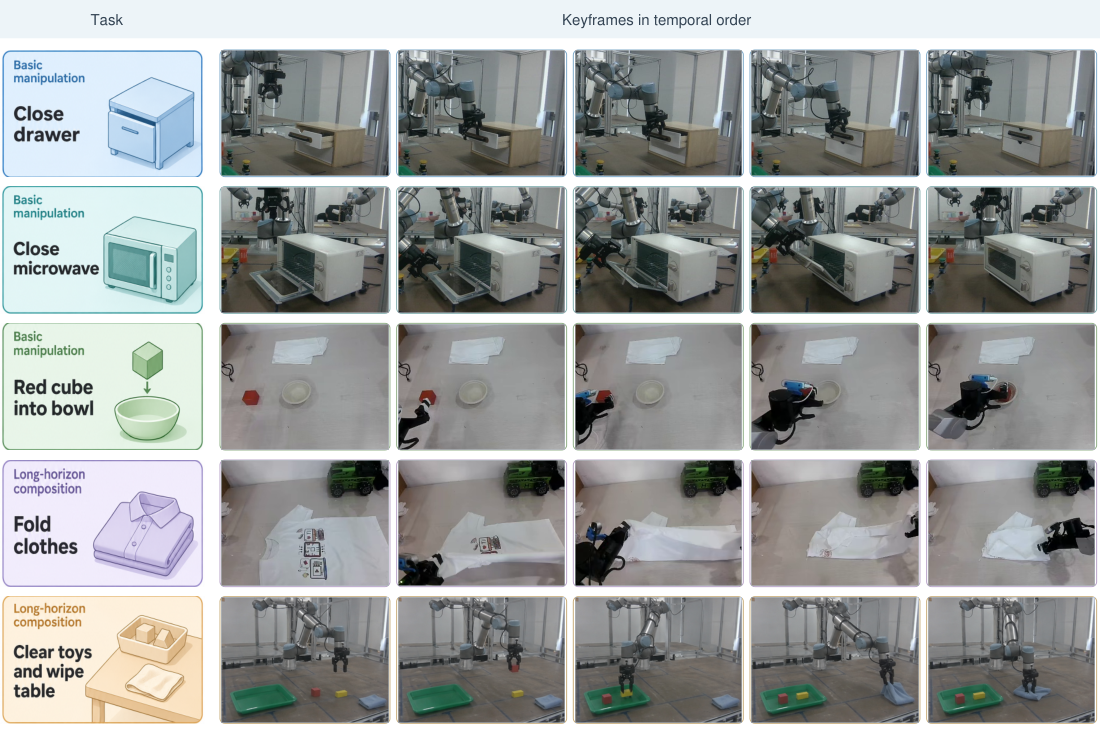
五个任务的延迟都降了,加速在 1.44 到 1.51 倍之间。单任务成功率有升有降:关抽屉 80.0 到 82.5,关微波炉 75.0 到 72.5,收玩具擦桌子 35.0 到 40.0,另外两个不变。每个任务 40 次,2.5 个点就是 1 次试验的差别,这些小幅波动都在采样误差范围内。这说明剪枝没有让真机任务明显变差,但还不能据此说它提高了成功率。
回到开头的橙汁罐子。APS-VLA 不去猜这一帧模型在看哪里,而是让示范告诉打分器:提起时留下的那些块要足以复现动作,同样这些块还要用来预测 8 步后的画面摘要。在 LIBERO 上,这套训练换来的是同等成功率下最快的那一档,真机上是快约一半、成功率持平。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Embodied · 2026-11-16Scaling VLA Serving Under Robotic Execution Constraints作者的公司有几百台 VLA 机器人在真实环境里干活,要共享 GPU 才能压低推理成本。难点在于,机器人等新动作时还在执行旧动作,同样大小的请求,有的机器人手上动作快用完了,必须马上回复,有的还能等。GPU 上同时多塞一个请求,又会拖慢正在算的请求,动作队列一空,机器人就得停下来等。XInfer 把 VLA 各阶段的计算拆开,依赖满足就往前算,调度时按每台机器人当下的紧急程度决定先算谁、什么时候允许新请求挤进来。在三个 VLA 模型和来自生产的负载上,一张 GPU 在满足实时要求下能服务的机器人数,是几种对比系统的 1.26 到 3.75 倍。服务机器人集群时,请求的紧急程度取决于机器人手上还剩多少动作。
 Embodied · 2026-11-16What Makes a VLA Reactive? A Study of Execution Strategies for Dynamic ManipulationVLA 模型一次预测未来一小段动作,可物体在动时,这段动作还没执行完就过时了。作者拿预训练的 π0.5 在两个动态仿真基准和三个真机任务上,系统地比较了预测多长、每次执行多少步、同步还是异步推理等执行方式。结论是预测大约一秒的动作最好;执行步数短时,异步推理帮得更多;让前后两段轨迹衔接连贯的方法,比只降延迟的方法更有效。最出乎意料的是传送带抓取任务。用强化学习微调策略能修好针对性的失败,但同一个模型什么都不训练,只把执行步数改成 5,成功率就达到 71%,和训练后一样好。机器人反应快不快,执行方式和策略本身一样重要,评测时要放在一起看。
 Embodied · 2026-10-27Coupling Execution Horizon and Sampling Depth in Flow-Matching VLA Policies这篇论文发现,基于流匹配的视觉语言动作模型里,求解动作的迭代步数和每次执行的动作步数是耦合的,最优选择还会反转。这类模型从一段随机噪声出发,用数值求解一步步把它推成一段平滑的动作。部署时通常把两者分开调:执行步数用来摊薄推理延迟,迭代步数则保持很高以求精确。频繁重新规划时,迭代步数少确实更差;一次执行很长一段动作时,迭代步数少反而更好,因为粗略求解让动作更集中在平均轨迹附近,减少了开环执行中误差的累积。每次只执行 5 步时,迭代 10 步更好。每次执行 20 步时,迭代 2 步反而更好。这个规律在多个基准和真机上都成立,不用训练就能降延迟、提成功率。
 Embodied · 2026-11-12From Video Frames to Robot Meta-Frames: A Unified Latent Interface for World Action Models用视频扩散模型做机器人的世界动作模型时,要把关节状态、动作、价值这些低维信号放进一个只见过自然视频的隐空间。常见做法是每种信号单独占一帧,序列变长,注意力计算的开销跟着涨。作者先用一个冻结的去噪器做测试:把信号直接平铺在画面上,去噪器要做很大的修正,说明它离视频的分布很远;先在频域里排好、再用逆 DCT 变回画面,需要的修正最少。MetaWAM 据此把所有机器人信号按频段分开,放进同一帧,不加新模块。在 RoboCasa 上成功率达到 68.9%,推理延迟降低 39%。信号怎么排进隐空间,比它占几个位置更要紧。把用户行为、ID 这类结构化信号塞进大模型的 token 序列时,也是同一个问题。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…