目录 · 5 节
1用冻结去噪器量一量「像不像画面」2把数字写进频段,再逆 DCT 变回一帧3一帧同时当策略、世界模型和价值函数的接口411 帧缩到 8 帧,成功率还略升5背景一换、初始姿态一变,它反而不如 Cosmos Policy
MetaWAM 这篇论文说明:往预训练视频扩散模型里塞机器人信号,要紧的不是这些信号占几帧,而是它们在去噪器眼里像不像一张正常的画面。
World Action Model(下文简称 WAM,一类拿预训练视频扩散模型同时预测机器人动作和未来画面的模型)的做法是:把相机画面编码成 latent 视频,让视频扩散模型(VDM)去噪出未来几帧,同时顺带去噪出下一段动作、未来的关节状态,以及这一步大概能拿多少回报(价值)。VDM 本来是看自然视频训练的,它的去噪器只认识「画面长什么样」。
难点在于,关节状态、动作、价值都是很短的一串数字,而 latent 空间里的每一帧是一个通道 × 高 × 宽的张量。示意:一台 7 自由度的 Franka 机械臂在做「把杯子对准杯垫」,当前关节状态就是 7 个数,比如 (0.1, −0.4, 0.0, −2.1, 0.0, 1.6, 0.8)。这 7 个数得先变成一张「帧」,去噪器才肯处理它。
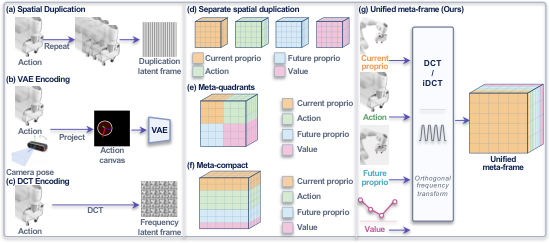
最接近的现有做法是 Cosmos Policy:每个信号单独占一帧,把原始数值在空间上原样复制铺满。于是这 7 个数在 latent 里被常数平铺成一张重复的图案(示意)。作者的诊断是,视频去噪器恰好会把这种平铺图案往「正常画面」那边使劲改,写进去的数字也就跟着被改动。
这种做法的另一个代价在序列长度上:输入关节、动作、未来关节、价值各占一帧,加上 6 帧相机画面和一个空白首帧,一共 11 帧,而注意力的计算量随帧数平方增长。还有一类做法(如 DreamZero)给动作单独加编码器和解码器,那又要改动预训练骨干。
MetaWAM 的回答是把所有机器人数字写进一帧的 DCT(离散余弦变换,把一张图拆成一组余弦波的叠加)系数里,再做逆 DCT 变回空间上的一帧。在 RoboCasa 厨房任务上,序列从 11 帧缩到 8 帧,单次推理快了约 39%,成功率还从 67.1% 升到 68.9%。这意味着少用的帧没有拿精度去换。
用冻结去噪器量一量「像不像画面」
要比较各种塞法,得先有一把尺子。作者拿一个冻结的 Cosmos-Predict2 去噪器(MetaWAM 所用骨干视频模型的去噪部分)当探针:把注入了信号的 latent 加上噪声,让去噪器还原,看它改了多少。改动量除以干净 latent 的幅度,就是相对重建误差。示意:干净 latent 的幅度是 10,去噪器的输出和它差了 6,误差就是 0.6。去噪器觉得眼熟的 latent 只需要小修小补;它改得越多,说明这张图离它见过的画面越远。
先只塞一个信号(30 个动作块),比三种写法。噪声水平 σ=1.0 时,空间复制的误差是 0.6459,渲染成图像再过 VAE 是 0.6379,写进 DCT 系数是 0.5922。σ 从 0.01 到 5.0 的五档里,DCT 都是最低。这说明「能顺利通过 VAE」不等于「去噪器认它」:VAE 编码出来的 latent 照样被去噪器当成异类。
再塞三个信号(动作块、关节状态、价值),比四种排法。为了下文能对上名字,先说清楚它们各是什么:
- Separate Spatial Dup.:三个信号各占一帧,每帧空间复制,也就是 Cosmos Policy 的做法。
- Meta-Quadrants:三个信号挤进一帧,每个信号分一块同样大的空间区域,数值在区域里沿通道复制。
- Meta-Compact:也是一帧,但按信号维度分区域,动作块占大块,关节和价值占小块。
- Unified Meta-Frame:本文的做法,三个信号分到互不重叠的通道组,写进 DCT 系数后逆变换成一帧。
| 多信号排法 | 帧数 | σ=1.0 相对重建误差 ↓ |
|---|---|---|
| Separate Spatial Dup. | 3 | 0.6178 |
| Meta-Quadrants | 1 | 0.6730 |
| Meta-Compact | 1 | 0.6234 |
| Unified Meta-Frame | 1 | 0.5613 |
最反直觉的是第二行。Meta-Quadrants 同样只用一帧,误差却比三帧各放一个还高。按作者的解释,各区域交界的地方数值突然断开,这种不连续的边界也是去噪器会去「修」的东西。
只省帧数不够:同样挤进一帧,按区域摆比三帧更差,写成频域系数才降到 0.5613。
把数字写进频段,再逆 DCT 变回一帧
既然问题出在长相,作者换了一种写法:数字要能原样取回,铺出来的图案又不再是常数平铺。作者选了 DCT。2D DCT 把一张图拆成一组余弦波的叠加,每个系数是一种波的权重;逆 DCT 再把这些权重叠回成图。正交 DCT 是可逆的,正反做一遍数字不变。
MetaWAM 把一帧的 latent 通道划成五个互不重叠的通道组,作者叫 channel band,下文叫「频段」:任务类型、当前关节、动作块、未来关节、价值各占一段。整个打包和读出流程如下:
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 1 打包 | 归一化后的各信号 | 把数值直接写进自己频段第 0 行(k_H=0)的固定系数位置,其余系数填 0 | 一张稀疏的系数张量 | 否 |
| 2 逆变换 | 系数张量 | 每个通道做一次正交 2D 逆 DCT | 空间域的 meta-frame | 否 |
| 3 去噪 | 8 帧 latent 序列 | VDM 照常去噪,结构不改 | 去噪后的输出 meta-frame | 否 |
| 4 读出 | 输出 meta-frame | 做一次 2D DCT,到固定位置取系数 | 动作、未来关节、价值 | 否 |
| 5 监督 | 读出的信号 | Huber 损失,外加对分配位置以外系数的 L1 惩罚 | 梯度直接回到去噪器 | 是 |
这里的 meta-frame,就是一帧专门装机器人数字、而不装相机画面的 latent 帧。 Hoot 说

训练:一个策略样本
- 任务、当前关节
- 写入真值,频段打开,作干净条件
- 动作、未来关节、价值
- 也写入示教里的真值,但频段关闭:随整段序列一起加噪,作去噪目标
- 损失
- 扩散去噪损失 + 读出信号的 Huber 损失 + 位置外系数的 L1 惩罚
真值在这里只当「答案」,用来教去噪器
推理:一次策略查询
- 任务、当前关节
- 照样打包,写进输入 meta-frame(复用空白首帧)
- 动作、未来关节、价值
- 未知,没有数可写;作为去噪目标,和未来画面一起由去噪器生成
- 读出
- 对去噪后的输出 meta-frame 做 2D DCT,到固定位置取系数,就是归一化后的动作
位置分配在训练和推理中完全一样,读出时不用学解码器
「频段」到底指什么
- 分组依据
- latent 通道:每个信号分到一组互不重叠的通道
- 通道内部
- 存的是 DCT 系数;数值写在第 0 行(k_H=0)的固定位置,其余系数为 0
- 为什么叫「频段」
- 论文原名 frequency-domain channel band:按通道分组,组内数字放在频域系数上
所以划分的是通道,不是频率区间
以策略任务为例:任务和当前关节是干净条件,其余三个频段是去噪目标。表里第 1 步写「否」,指打包这一操作推理时也要做,但推理时只打包已知的任务和当前关节。
出处
论文 §4.2 频段布局与读出(Eq. 2–3,k_H=0 行的固定系数位置,分配在训练和推理中固定);§4.3 输入 meta-frame;§4.4 按频段掩码:打开=干净条件,关闭=去噪目标;§4.5 训练目标(Eq. 4 在干净序列上加噪,Eq. 5–6 读出损失与位置外系数惩罚);图 3用一个可心算的小例子看第 1、2、4 步(示意,只看宽度方向的 4 格)。把关节的两个值 1 和 0.5 写成系数 (1, 0.5, 0, 0),逆 DCT 出来大约是 0.83、0.64、0.36、0.17,是一条下降的坡。读出时对这条坡做 DCT,又精确地得到 (1, 0.5, 0, 0),取前两个位置就是原来的关节值。
这个例子说明了两件事。第一,数字被摊到了余弦波上,不再是常数平铺;作者的解释是这样更贴近去噪器的先验,但这只是解释,小例子并不能证明它就是不掉点的原因。第二,读出只是一次固定的数学变换,不需要学一个解码器。
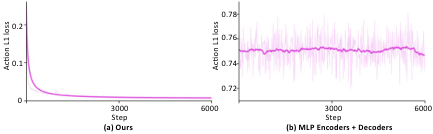
为什么不干脆学一个编码器和解码器?作者在附录里试过 DreamZero 风格的 MLP 编解码器:同样训练 6000 步,MetaWAM 的动作 L1 损失很快降到接近 0,MLP 接口一直停在 0.75 左右。作者的解释是零初始化的投影层起初不传信号,而且编码器一更新,去噪目标也跟着变。这只说明在这套设置下学习式接口没训起来,不代表它在别处一定不行。
一帧同时当策略、世界模型和价值函数的接口
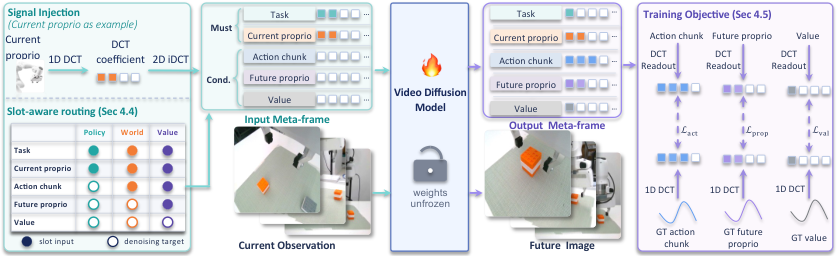
动作、未来关节、价值都住在同一个输出 meta-frame 的固定频段里,从不换帧。三种任务的区别只在于哪些频段是「已知条件」,哪些是「要去噪出来的目标」。MetaWAM 给每个样本配一个按频段开关的掩码:
| 任务 | 打开当作条件的频段 | 留作去噪目标的频段 |
|---|---|---|
| 策略 | 任务、当前关节 | 动作、未来关节、价值 |
| 世界模型 | 任务、当前关节、动作 | 未来关节、价值 |
| 价值 | 任务、当前关节、动作、未来关节 | 价值 |
回到杯子的例子(示意):做策略时,模型只知道现在 7 个关节在哪,要去噪出接下来怎么动;做世界模型时,动作也给它了,它要预测动完之后关节到哪;做价值时,前后状态都给了,只剩回报要估。
如果掩码只能按整帧开关,这件事就做不到:动作和价值在同一帧里,没法打开动作的同时藏住价值。输入那一侧的 meta-frame 也不额外花帧,它复用了 tokenizer 本来就要留的空白首帧,装任务类型和当前关节。
11 帧缩到 8 帧,成功率还略升
8 帧的组成是:输入 meta-frame、三路当前相机、输出 meta-frame、三路未来相机。消融都在 RoboCasa 上做,24 个厨房任务,每个任务只有 50 条人类示教,按 Cosmos Policy 的协议共 3600 次试验。
| 排法 | 帧数 | 成功率 | 单次推理 | 未来画面 PSNR | 价值 MAE |
|---|---|---|---|---|---|
| Separate Spatial Dup. | 11 | 67.1% | 0.479 s | 19.27 | 0.072 |
| Meta-Quadrants | 8 | 65.9% | 0.291 s | 18.86 | 0.081 |
| Meta-Compact | 8 | 68.1% | 0.291 s | 19.41 | 0.065 |
| Unified Meta-Frame | 8 | 68.9% | 0.291 s | 19.95 | 0.046 |
三种 8 帧排法的延迟完全一样,所以快的那 39% 来自少了 3 帧,和怎么摆无关。这说明成功率的差别要归到排法上:Meta-Quadrants 掉到 65.9%,和它在探针上误差最高对得上。不过 Meta-Compact 也有 68.1%,只比本文低 0.8 个点,频域写法在成功率上的优势并不大。
预测画面和价值也没有被牺牲。Unified Meta-Frame 的未来画面 PSNR(峰值信噪比,越高说明预测的画面越接近真实)最高,未来关节误差和价值 MAE(平均绝对误差)都最低。这说明省下来的帧没有以拖累世界模型和价值任务为代价。
探针分数和成功率排在同一个顺序上吗?作者用冻结去噪器的输出直接读回信号,看信号保留了多少:Unified 的保留比例 0.7146,三种对照在 0.60 到 0.66 之间,四种排法的排序和成功率一致。作者自己说,这只能当作比较几种排法的诊断,不拿来预测成功率。
和外部方法比,MetaWAM 在 RoboCasa 上只用每任务 50 条示教,成功率就高于用 300 条示教的 π0(62.5%)。这说明它在小数据下不吃亏,但示教量不同,这组对比只能当参考。
真机上,作者在 Franka 上做了扫地、放杯子、搭积木三个任务,每任务 20 次试验。分布内成功率 85.0%,Cosmos Policy 是 78.3%。加了干扰物和背景变化后是 68.3% 对 63.3%。这说明省帧的接口搬到真机上,成功率也高于逐帧注入的对照。
背景一换、初始姿态一变,它反而不如 Cosmos Policy
LIBERO 是常用的机械臂仿真操作基准,LIBERO-Plus 在它的场景上再施加相机、背景、初始状态等七类扰动。MetaWAM 在 LIBERO-Plus 上总分 83.4,高于 Cosmos Policy 的 82.2,换相机视角时 82.9 对 75.8。
但背景变化下是 72.6 对 88.9,机器人初始状态变化下是 59.9 对 63.3,原版 LIBERO 上 98.1% 也略低于对照的 98.5%。所以它的稳健性并不均匀,总分略高掩盖了两类明显的短板。
放回杯子的例子(示意):初始状态扰动改的,正是写进当前关节频段的那 7 个数的起点,机械臂开局的姿态和示教里不一样。在这一类扰动下,MetaWAM 的成功率低于 Cosmos Policy。作者在局限里也承认它对背景和初始状态敏感,并提到固定的频段划分和损失权重,在各信号尺度差别很大时可能要重新调。
MetaWAM 的频段写法,是先用冻结去噪器量过「认不认」才挑出来的;换别的信号接口之前,这把尺子可以先拿来量一量。
帧数从 11 减到 8 带来了速度。同样只用一帧,Meta-Quadrants 掉了点,Meta-Compact 略升;频域写法在三种 8 帧排法里成功率最高(68.9%),比 Meta-Compact 高 0.8 个点。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Embodied · 2026-10-28Zero-HLM: Generalizable Humanoid Loco-Manipulation without Real Robot Data人形机器人要学会走到桌前、拿起香蕉再放进篮子这类长任务,通常要靠人遥操作采上百条真机示范,桌子挪个位置往往就得重采。Zero-HLM 改为全部在仿真里造数据。它用手机拍一圈真实房间,重建成既像照片、又能做物理交互的仿真场景,再把少量遥操作示范自动改写成上千条新示范。每条新示范随机换一个机器人起点和物体、放置目标的位置,手的轨迹跟着目标一起移动,只留下在仿真里跑成功的。只用这些数据训练的策略直接上真机,三个任务平均成功率 66.7%,高于用真机示范训练的 46.7%。换到真机示范没覆盖的位置后,成功率从 23% 提到 69%。
 Embodied · 2026-11-03Contact Imitation Interface: Transferring Dexterous Skills by Showing How Contact Unfolds用人手示范教机器人灵巧手,难点在于人手和机器手形状不同:转换时如果只追求手形相似,机器手指尖碰到物体的位置往往和人当初碰的不一样,抓取和拨动就会失败。CIMI 把接触放在第一位:示范时记录手指与物体的接触面和指尖摄像头画面,转成机器手动作时先让接触点对齐,再顾及手指姿态;学到的策略也是先预测接触面接下来怎么移动,再由控制器协调手腕和手指去对齐。在 LEAP 和 Wuji 两款机器手的六组手与任务组合上,任务完整做完的平均成功率比基线策略至少高 50 个百分点。迁移人手技能时,对齐接触比对齐手形更关键。
 Embodied · 2026-11-12APS-VLA: Action-Guided and Future-Aware Token Pruning for Efficient Vision-Language-Action ModelsVLA 每一步都要处理几百个视觉 token,推理很慢,可下一步动作往往只取决于画面里的一小块。这篇论文在冻结的 VLA 前面加了一个小打分器,从示范轨迹里学该留下哪些 token。训练时有两个要求:留下的 token 要让原模型给出和看全图时一样的动作,还要能配合示范动作预测几步之后的画面变化。部署时打分器只挑一次,原模型参数和出动作的方式都不变。在 LIBERO 上剪掉 75% 的视觉 token,推理快了 1.57 倍,成功率只比不剪低 1.25 个百分点。再剪狠一些,速度几乎不再涨,成功率却掉得更快。该留哪些 token,要看它对接下来的动作和画面变化有没有用,而不只是看它和指令像不像。这和推荐里按下游目标学特征筛选是同一个思路。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…