目录 · 9 节
1它到底在解决什么问题?2核心想法:按相似度分组,而不是按位置分块3查询时怎么挑候选?4索引怎么边算边建?5代表向量为什么要学?6实验结果7我认为它的局限8一个长上下文推理服务团队可以怎么试9结论与评价
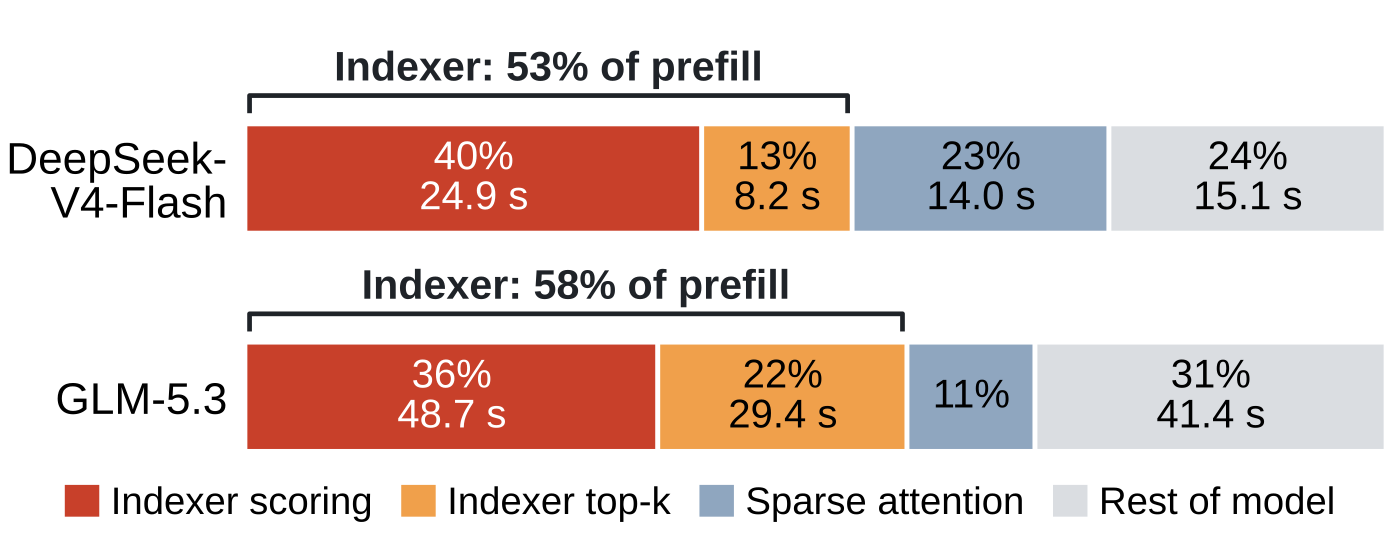
DeepSeek-V4、GLM-5.3 这类学习式稀疏注意力里,每个 query 只对 k 个 key 做注意力,但挑出这 k 个 key 的小打分网络仍要给前缀里的每个 key 打一遍分。上下文到 100 万 token 时,这一步占了 prefill 时间的 53% 到 58%。AttentionIndex 大幅压低了这一步的开销:它在 prefill 过程中把 key 按相似程度分成一组组,query 先给每组的代表打分,只把最有希望的几组成员交给原来的打分网络细选。在这个长度上,它的 prefill 吞吐是逐个打分的 1.3 到 1.8 倍;和速度相近的分块方法 HiSA 比,它在 GLM-5.3 和 DeepSeek-V4-Flash 上分别多找回 17.0 和 10.0 个百分点“本该选中的 key”。
它到底在解决什么问题?
先说清楚这类稀疏注意力怎么工作。DeepSeek 的稀疏注意力(DSA)给模型加了一个轻量的打分网络,论文叫 indexer。对每个 query token(prefill 和解码都一样),indexer 给它前面所有 key 各打一个分,主注意力只看分数最高的 k 个(GLM-5.3 取 2,048 个)。主注意力的开销因此不再随上下文变长,但 indexer 自己的打分开销会。论文第 3.1 节在 100 万 token 的 prefill 里量过:indexer 打分加排序取前 k,在 DeepSeek-V4-Flash 上占 53%,在 GLM-5.3 上占 58%,比模型其余部分加起来还多,是稀疏注意力本身耗时的 2.4 倍和 5.2 倍。
省这一步的自然办法是分两段挑:先粗选一批候选 key,再只对候选用 indexer 细选。候选最多放多少个,论文叫候选预算。现有做法 HiSA 按位置把 key 切成连续的块,每块取平均当代表,粗选时挑代表分高的块。问题在于,位置相邻的 key 内容未必相近。一个块里可能只有两三个重要的 key,平均下来分数不高,整块被丢掉,后面的细选就再也找不回它们。上下文越长,块越多,这种漏选越严重。论文表 1 里,GLM-5.3 在 LongBench-v2 上用 8K 候选,HiSA 找回的比例从 16K 上下文时的 83.9% 降到 256K 时的 41.8%。
这里的“找回比例”是评估用的指标,论文叫 recall:先离线让 indexer 给全部 key 打分,取出前 k 个作为参照答案,再看粗选加细选的结果里有多少落在这个参照答案里。推理时系统并不知道参照答案,它只是评估时拿来对比的。
核心想法:按相似度分组,而不是按位置分块
AttentionIndex 的出发点是:细选那一步本来就是逐个精确打分,所以所有误差都来自粗选时漏掉的 key。如果分组按内容相近来分,重要的 key 会集中在少数几组里,同样的候选预算就能装下更多该选的 key。
这正是向量检索里倒排索引(IVF)的做法。在本文里,被分组的是 indexer 的 key,每组是一些相近的 key(论文叫簇),每组用一个代表向量参与粗选。
把 IVF 搬进注意力有三个难处,论文分别给了办法:
| 难处 | 为什么难 | AttentionIndex 的办法 |
|---|---|---|
| 索引要边算边建 | prefill 每处理一段就多出一批新 key,重建一次索引的开销可能超过它省下的打分 | 新 key 先放进一个“未分组区”,攒够一批再分组;隔一段再整体重排一次,并复用上次的结果 |
| 不能偷看后文 | 每个 query 只能看到它前面的 key,代表向量也不能掺进后面的 key | 每次分组产生一个新的索引版本,只有前缀已经包含这个版本全部 key 的 query 才能用它 |
| 平均值不是好标签 | indexer 的分数不是简单的内积,组内平均的分数不能代表组员的分数 | 离线训练一个小网络,给每组的平均值加一个修正量,用修正后的代表来粗选 |
查询时怎么挑候选?
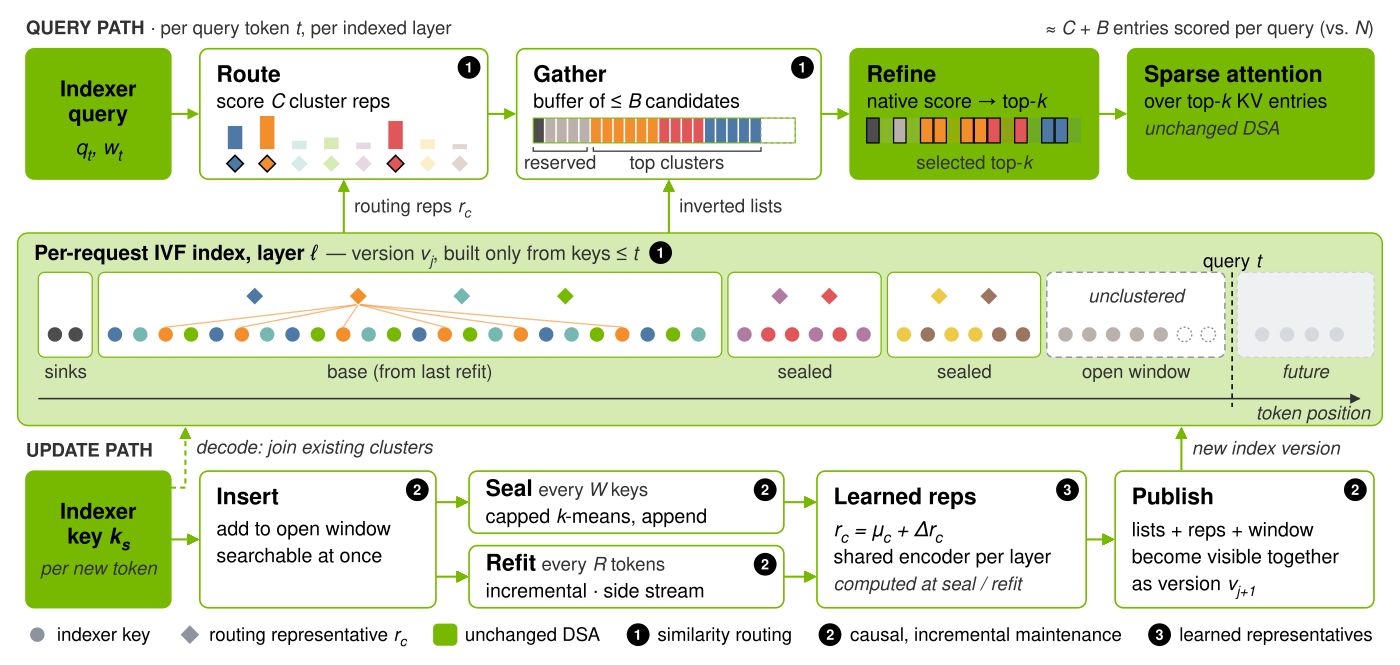
每个 query 先用 indexer 原来的打分公式给每个组的代表打分,把组从高到低排。然后往候选里装 key:开头几个 key和还没分组的新 key 先占固定位置,剩下的位置按排名依次装入各组的全部成员,最后一个组装不下就截断。装满后,indexer 对这些候选逐个打分,取前 k 个交给原来的稀疏注意力。
所以每个 query 要打分的数量从 N(前缀长度)变成大约“组数加候选预算”。GLM-5.3 上每组约 128 个 key,组数是前缀长度的一百多分之一,粗选这一步仍随前缀变长,但常数小得多。稀疏注意力的计算本身没有改。
索引怎么边算边建?
prefill 是按块往前推的,每推一段,前缀里就多出一批 key。AttentionIndex 把维护分成三档:
- 插入。新 key 一产生就进入未分组区。后面的 query 粗选时会把未分组区整个放进候选,所以新 key 立刻能被选中。
- 封存。未分组区每攒满 W 个 key 就分一次组,结果直接追加,已有的组不动。GLM-5.3 上 W 是 1,024,一次分成 8 组,每组约 128 个。第一次封存之前,query 仍然逐个打分。
- 重排。封存只在一批之内分组,前后两批里相近的 key 会被分在不同组。所以每隔 R 个 token(GLM-5.3 上 16,384),把整个前缀重新分一次组,前缀越长,组数越多。
重排不从头做。相邻两次重排的 key 几乎一样,而且 key 生成之后不会再变。所以重排时从上一次的组中心出发,再从最近的新 key 里补几个新中心。每个 key 还记着到自己组中心距离的上界、到其他中心距离的下界;只有新 key 和那些边界已无法保证归属不变的 key 才需要和所有中心比一遍。每次重排只做一轮分配加更新,不追求完全收敛。重排放在另一个 CUDA 流上,和正常前向计算并行。
还有一个细节保证不偷看后文。每次封存或重排都产生一个新的索引版本,组成员、代表和未分组区的信息一起生效。一个 query 只在它的前缀已经包含这个版本所有 key 时才用它。同一个 prefill 块里靠前的 query 继续用旧版本,较新的 key 由它们自己的未分组区覆盖。
代表向量为什么要学?
普通 IVF 用组内平均当代表。用内积检索时这没问题:query 和平均值的内积,正好等于它和各成员内积的平均。indexer 的分数却是多个头各自算内积、过 ReLU、再加权相加,平均值的分数就不等于成员分数的平均了。一个组里明明有几个该选的 key,平均值的分数却可能很低。 Hoot 说

普通 IVF:先平均成员,再打分
- 组成员(示意)
- −2, 2
- 代表 = 平均
- 0
- query = 1 时代表得分
- ReLU(1×0) = 0
粗选看到 0 分,这组被跳过。
逐个打分:先给每个成员打分
- 成员得分
- ReLU(−2) = 0, ReLU(2) = 2
- 得分平均
- 1
- 该不该选
- 得 2 分的 key 该选
组里其实有好 key,平均代表把它藏住了。
本文:学一个修正量加到平均上
- 离线
- 训练小网络,让代表的排序贴近“组里参照答案个数 ÷ 组大小”
- 推理时何时跑
- 只在封存或重排产生新组时跑一次
- 每个 query 做什么
- 照常给代表打分,不重新汇总成员
修正量初始为 0,一开始就等于普通 IVF。
数字示意:只取一个头、权重为 1,query 和 key 都简化成一个数。真实 indexer 有多个头、向量更长,但抵消的道理一样。 出处: 论文方法部分:indexer 分数 = 各头内积过 ReLU 后加权相加;普通 IVF 用组内平均当代表。数字为示意。
论文的办法是保留按距离分组,只修正粗选用的代表。每层一个共享的小网络,读一组成员的几种汇总:成员 key 的平均值、组大小的对数,以及把每个成员 key 先经过一个可学习的小变换、再对结果取平均和取最大得到的特征。训练和推理用的是同一个小网络、同一套汇总。它输出一个修正量,加到平均值上。修正量有上限,初始为 0,所以一开始就等于普通 IVF。这个小网络离线训练:用冻结的模型跑一批 query,把逐个打分选出的前 k 个当参照答案,让代表的排序尽量贴近“每组里参照答案个数除以组大小”。推理时它只在封存或重排产生新组时跑一次,query 粗选时照常给代表打分。
实验结果
实验在 8 张 B200 上用 SGLang 跑 GLM-5.3 和 DeepSeek-V4-Flash,基线是逐个打分(Full DSA)和 HiSA。候选预算在 GLM 上按 token 数算,在 DeepSeek-V4-Flash 上按压缩条目算(每条对应 4 个原始 token)。
先看找回比例。三个数据集、每档预算上,AttentionIndex 都比 HiSA 高。以 LongBench-v2、24K 预算为例:
| 模型 | HiSA | AttentionIndex |
|---|---|---|
| GLM-5.3 | 67.16% | 89.70% |
| DeepSeek-V4-Flash | 75.88% | 90.66% |
用更少的候选它也能赢:GLM-5.3 上它用 24K 候选的结果,在三个数据集上都超过 HiSA 用 64K 候选,少用 62.5% 的候选位置。这和“按内容分组能把该选的 key 集中到更少组里”的设想一致。
再看速度。逐个打分时,上下文从 256K 涨到 100 万,吞吐掉了一半以上。100 万 token 时,AttentionIndex 的 prefill 吞吐在 GLM-5.3 上是逐个打分的 1.6 到 1.8 倍,在 DeepSeek-V4-Flash 上是 1.3 到 1.6 倍;上下文较短时索引还不划算,GLM-5.3 从 384K、DeepSeek-V4-Flash 从 512K 起才在所有预算上不慢于逐个打分。同样预算下,它在 GLM-5.3 上到 512K 至 768K 为止比 HiSA 快,更长时以及在 DeepSeek-V4-Flash 上比 HiSA 慢,因为要维护索引、从分散的位置取候选。所以公平的比法是把速度对齐再比找回比例(论文表 2,吞吐差在 5% 以内):
| 100 万 token | HiSA 预算 | HiSA 找回 | AttentionIndex 预算 | AttentionIndex 找回 |
|---|---|---|---|---|
| GLM-5.3 | 24K | 69.6% | 16K | 86.6% |
| DeepSeek-V4-Flash | 24K | 76.5% | 16K | 86.5% |
速度差不多时,它少用三分之一候选,找回还多 17.0 和 10.0 个百分点。
最后是任务准确率(表 4)。同为 24K 预算,AttentionIndex 在两个模型的三个基准上都比 HiSA 高。差距最大的是 RULER:GLM-5.3 上从 62.6% 到 77.5%,逐个打分是 81.8%;DeepSeek-V4-Flash 上从 67.27% 到 76.14%,逐个打分是 77.83%。LongBench-v2 上差别很小,因为 HiSA 离逐个打分本来只差 2.8 和 0.80 个点。论文的解释是这个基准考的是长文推理,key 选得再准,模型能力也可能先成为瓶颈。按速度对齐(AttentionIndex 16K 对 HiSA 24K)比,它在六组比较里赢四组;LongBench-v2 上反而低 0.6 和 1.39 个点。
作者做了两项消融,分别拿掉重排和学到的代表。关掉重排、只靠封存时,GLM-5.3 在 24K 预算下的找回比例从 88.3% 掉到 78.8%,13 个输入全部变差,可见跨批次重新分组很关键。学到的代表在 GLM-5.3 的四层上把找回比例提高 0.55 到 5.01 个点,在 DeepSeek-V4-Flash 的两层上只提高约 0.2 个点,带来的首 token 时间变化在 1.6% 以内。
我认为它的局限
第一,解码阶段反而不如 HiSA。一个长 prefill 插进正在生成的批次时,用逐个打分的平均每 token 解码时间除以 AttentionIndex 的,得到 1.40 到 1.45 倍的加速;HiSA 的加速是 1.54 到 1.65 倍。论文把优化解码开销留作后续工作。
第二,维护开销随前缀增长。每次重排都要把前缀里所有 key 再过一遍,GLM-5.3 上超过 512K 到 768K 后,同预算下它比 HiSA 慢。100 万 token、24K 预算时,GLM-5.3 上索引的构建、重排、候选打包和跨卡同步这些维护工作占 GPU 工作量的 15%,比全部打分和取前 k(含粗选打分,11%)还多。这些数字是并行流上的 GPU 工作量之和,不等于请求多等的时间,但说明省下的打分有不少花在了维护上。
第三,学到的代表收益不稳定。DeepSeek-V4-Flash 评估的五层里只有两层启用了学到的代表,各提升约 0.2 个点,另外三层仍用平均值。论文猜测和压缩条目把相邻 token 混在一起有关,但没有单独验证。
一个长上下文推理服务团队可以怎么试
- 先确认瓶颈。如果你在用 DeepSeek-V4 或 GLM-5 这类模型处理几十万 token 以上的长上下文,先用 profiler 看一次 prefill 里 indexer 打分加取前 k 的占比。上下文在 256K 以内时,论文的结果说明索引还不划算。
- 先只加封存。把新 key 每攒 1,024 个分成 8 组,粗选时只取排名靠前的组,用离线回放算找回比例,和逐个打分对比。
- 再加重排。每隔 16K token 整体重新分组,看找回比例比只封存时是否提高约 9 个百分点(论文表 5:GLM-5.3、24K 预算从 78.8% 到 88.3%)。
- 最后才考虑学代表。它需要离线训练、收益因层而异,可以只在找回比例最低的几层上试。
结论与评价
最关键的启发是:稀疏注意力把注意力本身的开销压住以后,挑 key 成了新的瓶颈;而挑 key 的误差全部来自粗选,所以按内容分组比按位置分块更能用好有限的候选预算。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。100 万 token 时挑 key 占 prefill 一半以上,长上下文 agent 和代码场景都会碰到 |
| 方法创新性 | 中上。IVF 和带边界的 k-means 加速都是已有技术,新意在于把索引放进单个请求的前向过程里、保证不偷看后文 |
| 实验证据 | 较强。两个真实模型、三个基准、速度对齐后的比较和两项消融,但解码只测到 2 到 4 个并发 |
| 工程成本 | 较高。需要改推理框架的候选选取、跨卡同步索引状态,学代表还要离线训练 |
| 是否值得尝试 | 值得关注。prefill 以百万 token 为主的服务收益最明显,解码为主的服务先等后续工作 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…