目录 · 9 节
1它到底在解决什么问题?2整体流程:先认出哪些曝光像候选会出的,再让它们多算几次3权重从哪来?4为什么只训一个共享模型?5什么时候不该信离线结果?6实验:仿真里收益明显,线上候选几乎打平7我认为它的局限8一个推荐/搜索团队可以怎么试9结论
广告系统上线新排序模型前,要先用日志离线挑出最好的候选,但投放经过拍卖、过滤、缓存,曝光被选中的概率没有记录,IPS 用不了。常见替代是用预测点击的奖励模型给新策略打分,可新策略会把曝光推向日志里少见的广告,那里奖励模型最不准。作者在历史请求上重放候选策略,训练分类器判断每条曝光像日志的还是某个候选的。分类器给出每条曝光属于某个候选和属于日志的概率之比,把这条曝光在所有候选上的比值取平均,就是它训练奖励模型时的权重,越像候选会出的曝光权重越高。线上 CTR 排序系统的五个候选都跑过 A/B;在 50 份随机抽取的日志上各挑一次,挑中真正最好那个的比例从不加权的 0.36 提到 0.40。
做广告和推荐离线评估的人值得读,理由不在那 4 个点的提升,而在它把一个很多团队心里有数、却没人量化的问题摆上了台面:离线评估最不可信的地方,正是新模型和老模型分歧最大的地方。论文给了一个能算出来的诊断量(候选曝光里日志几乎没见过的那部分占多少),用它决定这批候选该信离线结论还是直接送 A/B。线上证据偏弱:最好和第二好的候选在离线估值里难分高下,作者自己也承认离线分不开。
它到底在解决什么问题?
拿不到曝光概率时,离线挑模型通常靠 DM,在多阶段投放里它常常是唯一能用的办法。
问题在于奖励模型是在老模型的曝光上学的。看一个示意的例子:某类请求下,日志里 95% 的曝光是游戏广告,只有 5% 是教育广告。候选 A 和老模型差不多,候选 B 把一半曝光换成了教育广告。
| 示意 | 日志里的曝光占比 | 候选 A | 候选 B |
|---|---|---|---|
| 游戏广告 | 95% | 93% | 50% |
| 教育广告 | 5% | 7% | 50% |
奖励模型在游戏广告上见过大量点击,预测得准;教育广告样本少,预测可能偏高也可能偏低。于是 B 的估计价值有一半押在奖励模型最没把握的区域。更麻烦的是这种误差对 A 和 B 不一样大,排序就可能被翻过来。作者把这叫策略带来的分布偏移。
整体流程:先认出哪些曝光像候选会出的,再让它们多算几次
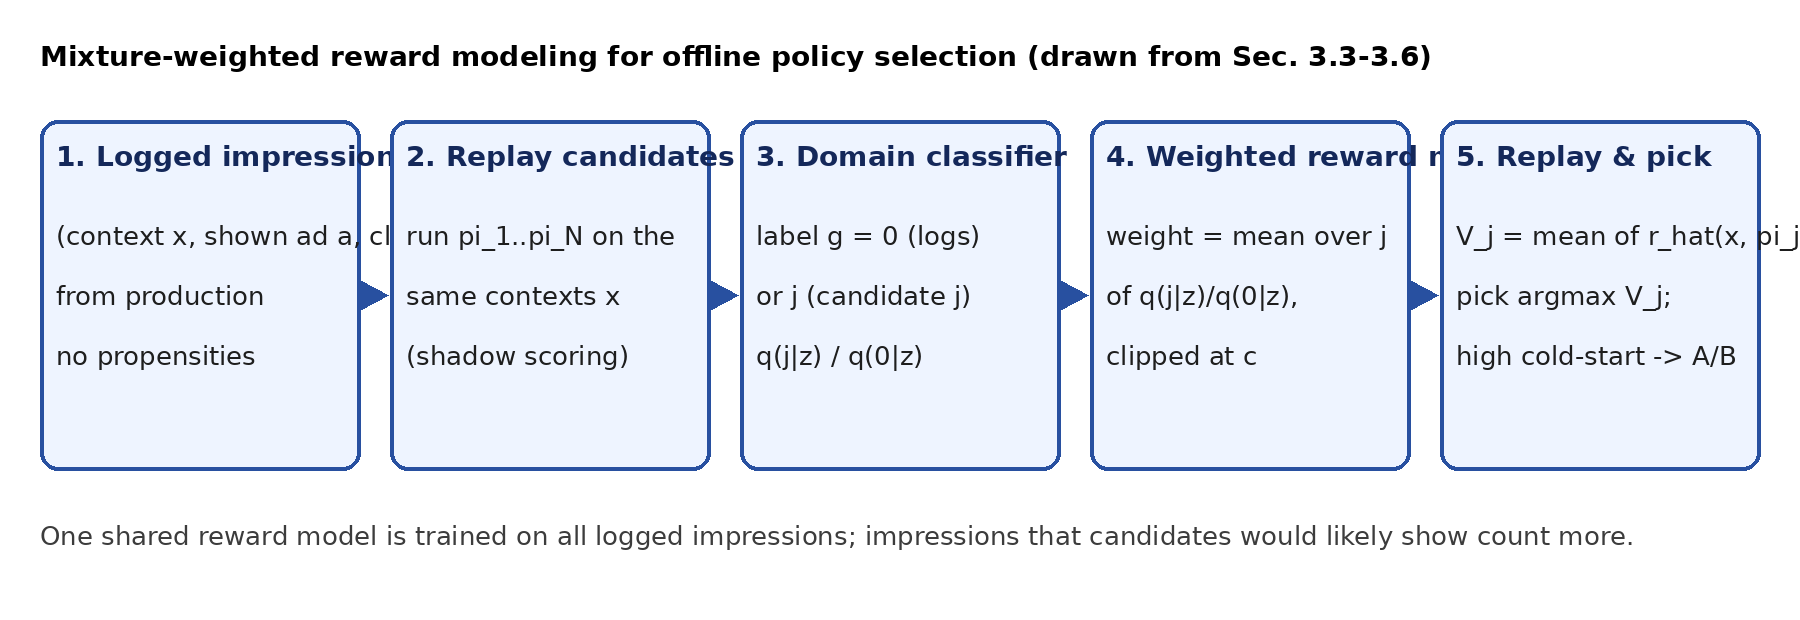
整条链路五步:拿日志曝光;把每个候选放到同样的历史请求上重新选广告(线上实验用 shadow 打分,仿真里离线重跑候选的打分函数,候选选中的广告直接当作它的曝光,论文假设候选可以这样重放);训练一个分类器区分曝光来自日志还是来自哪个候选;把分类器输出换算成日志曝光的样本权重,训练一个奖励模型;最后在单独留出的评估数据上,让奖励模型预测每个候选在每条历史请求上选出的广告的点击率,取平均作为这个候选的估计值,挑最高的那个。关键分工是:分类器只负责回答这条曝光像谁会出的,奖励模型只负责预测点击。下面拆开讲。
权重从哪来?
最直接的想法是给每条日志曝光算一个比值:这条曝光在候选下出现的概率,除以它在日志下出现的概率。候选常出、日志少出的曝光,比值大,训练时多算几次,奖励模型就会在候选关心的区域学得更认真。可这两个概率都算不出来,正是 IPS 用不了的原因。
作者绕开的办法是训练一个多分类器。日志里的真实曝光标为第 0 类,候选 j 在同一批请求上重放出来的曝光标为第 j 类,分类器看一条曝光(用户特征加广告特征),输出它属于每一类的概率。各类样本数相同时,这条曝光属于候选 j 的概率除以属于日志的概率,就等于前面那个算不出来的比值。
手算一下(示意):有两个候选。一条日志曝光,分类器给出日志 0.25、候选 1 是 0.5、候选 2 是 0.25,两个比值是 2 和 1,平均下来权重 1.5。另一条曝光分类器给出 0.5、0.25、0.25,比值都是 0.5,权重 0.5。前一条更像候选会出的曝光,训练时的分量是后一条的 3 倍。
分类器很确信某条曝光不像日志时,分母很小,权重会暴涨。所以权重要截断到一个上限 c,仿真里用 100,线上用 20。作者在仿真里比较了 c 取 1、5、10、20、100:c 在 10 到 100 之间,估值误差几乎一样。c=1 时所有大于 1 的权重都被压到 1,只剩降权、没有升权,在重叠差的时候和不加权模型差不多,只在重叠很好时估值误差最低。
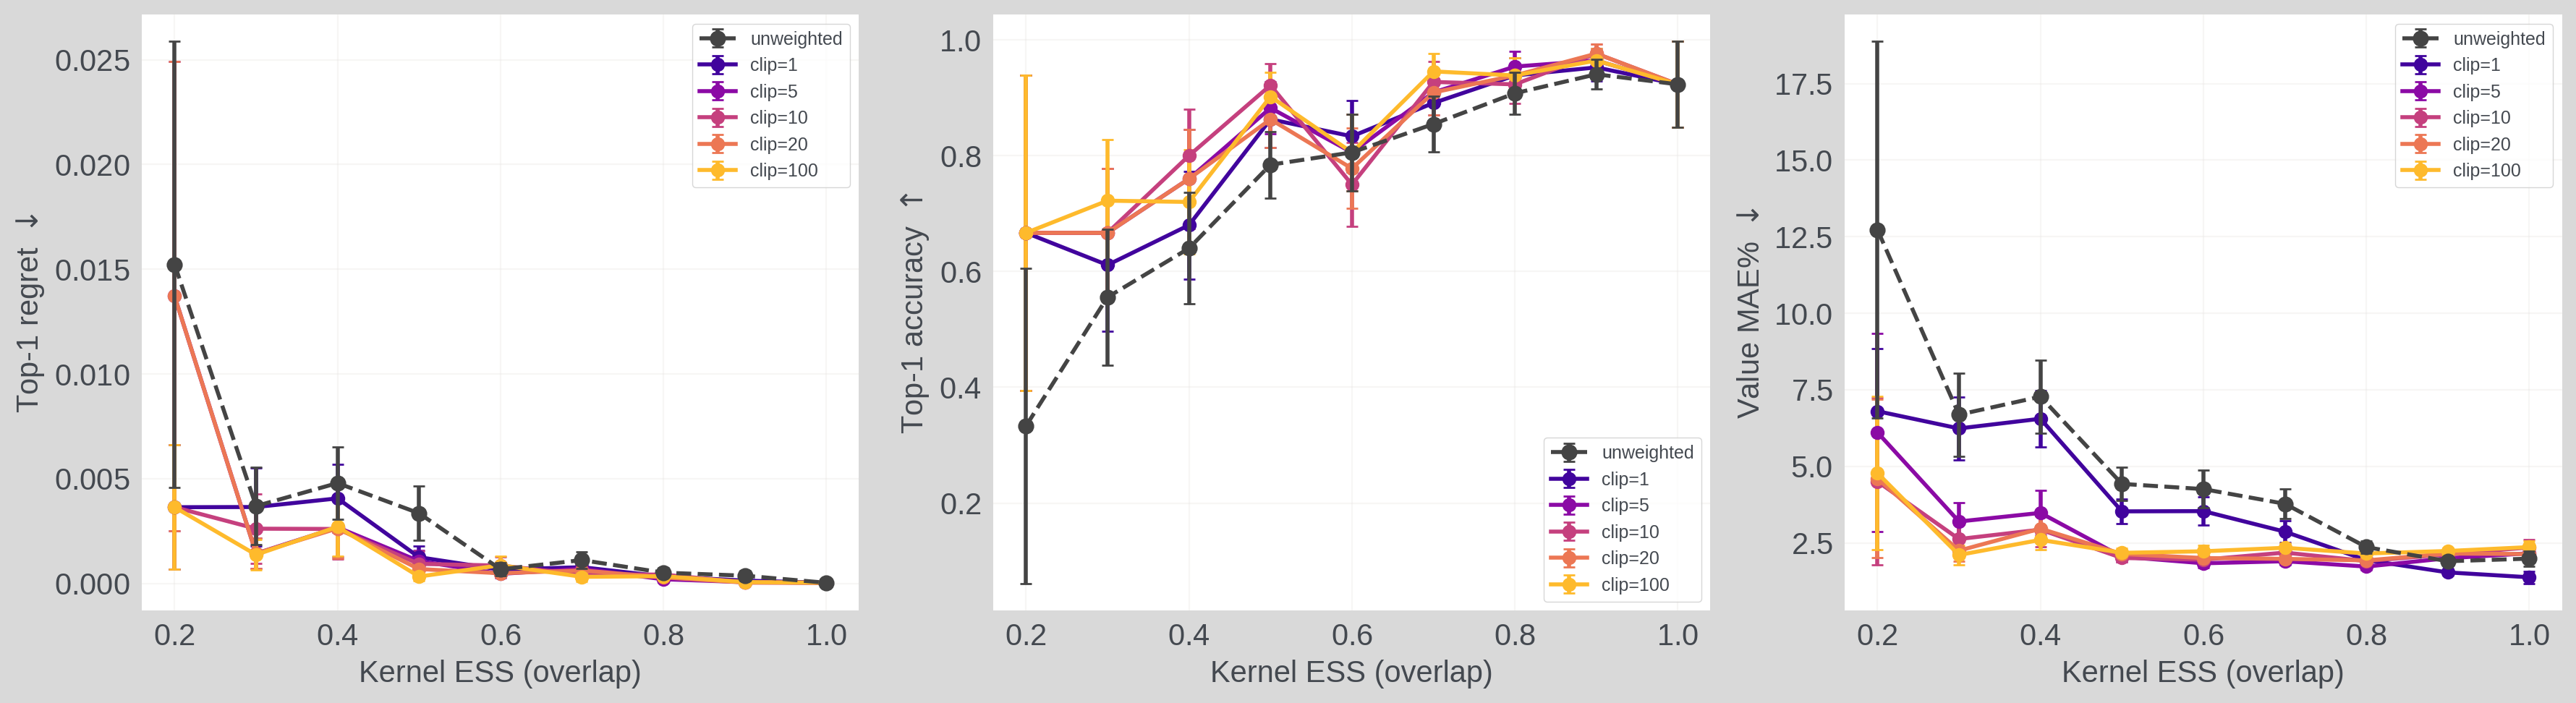
这张图的横轴是有效样本量占样本数的比例:接近 1 说明候选和日志的曝光很像,接近 0 说明少数样本权重特别大,两者差得远。
为什么只训一个共享模型?
更自然的做法是每个候选单独加权、单独训练一个奖励模型,论文把它当作对照组。作者的目标不同:要一个在所有候选会出的曝光上都尽量准的奖励模型,所以把各候选的比值取平均,只训一个模型,再让所有候选用它打分。
实验支持这个选择。仿真里,共享加权模型在 9 项比较上全部好于逐个加权;线上逐个加权的版本挑对的比例只有 0.24,和 IPS 一样低。所以这里的提升不能解释成多训了几个模型。
什么时候不该信离线结果?
论文的理论部分把每个候选的估值误差拆成三块:日志覆盖到的区域里奖励模型的误差;候选曝光里日志几乎没见过的那部分;以及评估样本有限带来的抽样误差。
第二块作者叫冷启动比例:候选会出的曝光里,有多少条属于日志的概率低于阈值(实验取 0.1),也就是日志对它们支持很弱。上界里冷启动这一项不会随日志变多而消失。如果奖励模型的拟合、优化和权重估计误差也都趋近于零,其余几项就会消失,这时错选损失(真正最好的候选和被选中候选的真实点击率之差)的上限,是所有候选里最大冷启动比例的 2 倍。由此得到一个规则:给定能接受的损失,整组候选的最大冷启动比例够小,就信离线挑出的那个,否则把整组候选送去 A/B。
这条规则是渐近结论,只在数据量足够大时才成立。用分类器去估冷启动比例,还要求分类器的概率是校准过的。
实验:仿真里收益明显,线上候选几乎打平
仿真用的是作者开源的广告模拟器:1 万个用户、1000 个广告,每次请求随机给 10 个候选广告,策略选分最高的一个;真实点击率由一个已知函数给出,所以每个候选的真实价值都能算出来。每轮 7 万条曝光分成四份,分别训练分类器、训练奖励模型、校准和评估,跑 50 个随机种子。指标有三个:Top-1 准确率、regret,以及估值的平均百分比误差。
下表按候选和日志的重叠程度分三档,列出 Top-1 准确率和估值误差。表里的 DR 用的是同一组分类器权重。
| 方法 | 低重叠 准确率 | 低重叠 误差% | 中重叠 准确率 | 中重叠 误差% | 高重叠 准确率 | 高重叠 误差% |
|---|---|---|---|---|---|---|
| IPS(用分类器估的比值) | 0.60 | 7.64 | 0.65 | 5.49 | 0.71 | 4.15 |
| 不加权 DM | 0.67 | 7.20 | 0.87 | 2.58 | 0.96 | 1.59 |
| 加权 DM | 0.81 | 2.65 | 0.91 | 1.94 | 0.98 | 1.86 |
| 逐个加权 DM | 0.75 | 3.61 | 0.83 | 2.80 | 0.90 | 2.32 |
| 不加权 DR | 0.82 | 2.64 | 0.93 | 0.70 | 1.00 | 0.30 |
| 加权 DR | 0.90 | 1.71 | 0.95 | 0.43 | 0.99 | 0.21 |
低重叠一档里,冷启动比例约 43%,加权把 DM 的准确率从 0.67 提到 0.81,误差从 7.20% 降到 2.65%。高重叠一档冷启动比例约 12%,加权 DM 的误差反而略高于不加权。这说明加权的价值集中在新模型改动大的时候,改动小时加权带来的波动反而略亏。
线上实验来自一个大规模 CTR 排序系统,一个老模型加五个候选,六个都真实跑过 A/B,所以真实点击率已知。随机挑的准确率是 0.20。
| 方法 | Top-1 准确率 | 估值误差% |
|---|---|---|
| IPS | 0.24 | 4.14 |
| 不加权 DM | 0.36 | 14.10 |
| 加权 DM | 0.40 | 11.56 |
| 逐个加权 DM | 0.24 | 12.43 |
| 不加权 DR | 0.38 | 1.90 |
| 加权 DR | 0.44 | 2.04 |
加权 DR 挑对的比例最高,但估值误差比不加权 DR 略高,两者谈不上谁全面占优。IPS 的估值误差很低,挑对的比例却接近随机。这提醒我们:估值准和挑得对是两回事,候选之间差距很小时,几个百分点的估值误差就足以把排序翻过来。
我认为它的局限
第一,线上证据分不出赢家。加权 DM 估出来的前两名几乎一样,50 份样本里有 24 份两者顺序反过来。这意味着 0.36 到 0.40 的提升建立在一组几乎打平的候选上,作者自己的结论也是这组候选应该送 A/B。
第二,权重的质量完全取决于分类器能不能看出策略差别。附录里把分类器看到的广告特征逐步遮掉,遮掉三分之二时,加权 DM 的准确率从 0.90 降到 0.83,IPS 从 0.62 降到 0.33。分类器的对数损失和挑对候选的比例会跟着变差,可以提示它的区分能力在下降。更隐蔽的是有效样本量占比:特征全遮掉时它从 0.59 升到 1.00,权重变平是因为分类器看不到广告特征,而不是重叠变好了。所以这个占比高,只有在分类器分得出策略时才说明重叠好。
第三,路由规则没有在线上验证过。它是数据无限多时的结论,有限样本下要用完整的误差上界,作者把线上效果留给了后续工作。
一个推荐/搜索团队可以怎么试
- 先只做诊断:把几个候选模型在历史请求上重放,训练一个区分日志和候选的分类器,统计每个候选的冷启动比例。看它和过去离线、线上结论不一致的那些实验是否对得上,对得上说明这个指标有用。
- 再给现有的离线奖励模型加上平均比值的样本权重,截断上限从 20 左右起步。用历史上已经跑过 A/B 的候选组来检验,看挑对的比例和错选损失有没有改善。
- 如果已经在用 DR 一类的修正,就把加权奖励模型换进去当基础预测,比较两种 DR 的挑选结果。
- 最后把冷启动比例当作分流的参考:整组最大冷启动比例高的候选组优先送 A/B;比例低时,还要用论文的完整误差上界确认,才只信离线挑选。统计一个季度后看 A/B 资源是否用得更集中。
结论
最关键的启发是:离线评估要和一个重叠诊断配套使用,候选和日志差得越远,离线结论越该打折。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。多阶段投放拿不到曝光概率,几乎所有广告团队都靠奖励模型做离线挑选 |
| 方法创新性 | 中。用分类器估比值是成熟技巧,新意在把所有候选的比值平均后只训一个模型,并配上冷启动诊断 |
| 实验证据 | 中低。仿真收益清楚,线上候选几乎打平,0.36 到 0.40 的差距说服力有限 |
| 工程成本 | 中。需要候选的 shadow 打分和一个额外的分类器,奖励模型只是多了样本权重 |
| 是否值得尝试 | 值得先试诊断部分,冷启动比例的计算成本低,又能直接指导 A/B 资源分配 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…