目录 · 7 节
1问题被改写成一道二选一2一次判断要经过哪几步3标签靠三方交叉,而不是直接用点击4只奖励答对,理由可以是空的5离线 F1 从 0.783 升到 0.8306线上 5% 流量三天,交易相关用户天 +0.67%7改动很小,位置变了
电商搜索常用两段式做法:相关性模型先看 query 和商品匹配得好不好,把候选分进几个档位;下游按 CTR 优化的个性化排序模型,只在这些档位的约束内排序。档位主要由 query 和商品本身的匹配决定,用户是谁要到排序阶段才进来,所以一件合这位用户口味、却落在低档的商品,排序模型再懂用户,它拿到的排序机会也有限。这篇在 1688 上线的论文把一部分个性化挪到了档位上:LLM 读用户的行为日志,判断一个候选有没有行为证据支持。1688 主搜有四个档位,线上只把第二档里被支持的候选提升一档;最高档本身不动,第三、四档这一版也不动,升完档仍由原来的 CTR 模型在档位内决定谁先谁后。在 5% 流量、持续三天的线上实验里,交易相关用户天提升 0.670%。所以它做的是让相关性档位也反映用户偏好,而不是把低相关结果直接拉到前面:被行为证据支持的第二档候选只升一档,谁排在前面仍由 CTR 模型决定。
难处在于,档位主要由 query 和商品本身的匹配决定,用户是谁要到排序阶段才进来。论文图 1 是一个具体例子:用户搜「flare pants」(喇叭裤),一条奶油色喇叭裤被判为 high、曝光在第 15 位,一条黑灰色 kick flare 牛仔裤被判为 low、曝光在第 56 位。可这位用户当天在同一个 query 下点过一条烟灰色加绒微喇牛仔裤,长期购买记录里阔腿裤的偏好颜色是 khaki、gray、black。排序模型再懂这位用户,也只能在档位定好的结构里排,落在 low 档的黑灰色那条拿到的排序机会有限。
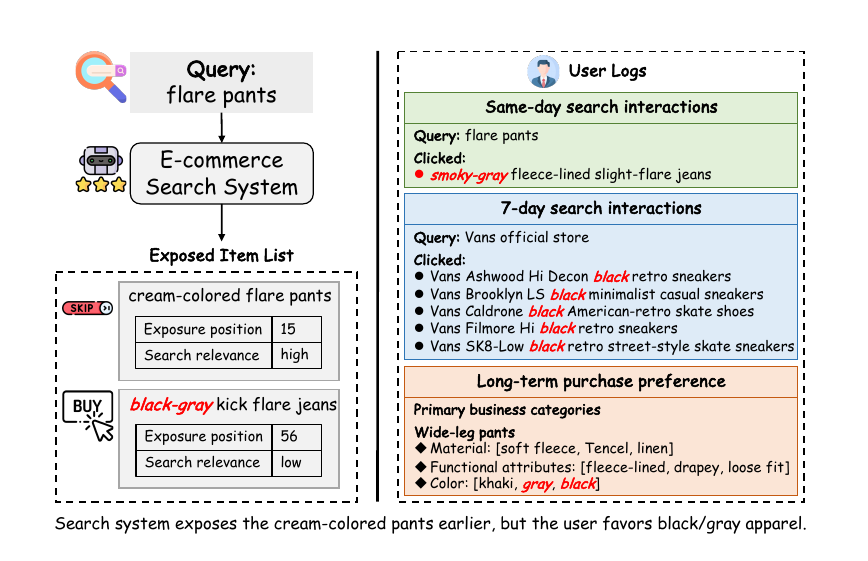
现有办法放回这个例子里都不太顺手。最直接的是把更低档的候选也送进 CTR 排序,让黑灰色那条也有机会,但候选集会变大,档位作为「先保证相关」的质量约束也随之变弱。另一类工作在排序侧做融合,例如 PRECTR(统一相关性与 CTR 的排序框架)和它的后续版本 PRECTR-V2,它们把相关性档位、点击概率和用户偏好一起建模,偏好用数值特征、Semantic ID 或 embedding 表示。作者的看法是,这种压缩后的表示没法逐条核对「用户偏好 gray、black」和「这条裤子是黑灰色」在当前 query 下对不对得上。
所以这篇换了个位置下手。它的判断是:相关性档位不必只是客观 query-item 匹配的结果;当用户行为日志显示出稳定偏好时,可以让 LLM 依据行为证据判断候选是否适合这位用户,并在 CTR 排序前按规则把被支持的候选提升一档——线上只升第二档,升完后仍由 CTR 模型在档位内排序。这样排序模型拿到的候选结构,同时反映了 query-item 匹配和用户偏好。
问题被改写成一道二选一
作者把这件事定义成一个新任务,叫 PBR(Personalized Behavioral Relevance)。输入是一个 query、一个候选商品和这位用户的三段行为记录,输出是 0 或 1:在当前 query 意图下,这个候选有没有被用户的行为偏好支持。论文的推理提示里写明,证据不足就输出 0。
三段行为记录按时间远近分开。第一段是当天的搜索交互,包括点击、加购、收藏、购买;第二段是过去 7 天的搜索交互;第三段是一年内的购买偏好,按类目汇总价格带,按「类目-属性-属性值」(论文叫 CPV)汇总偏好,再加一份描述用户稳定经营特征的画像。图 1 长期偏好里的「阔腿裤:颜色 khaki、gray、black」,就是这种按类目和属性值汇总的形式。
线上怎么用这个 0/1,论文规定得很克制。PBR 只作用于前两档:最高档的候选本来就有很强的 query-item 相关性,不再升档;第二档的候选判为 1,才升到最高档。每个候选最多升一档,第三、四档在这一版里完全不动,所以弱相关的商品不会被直接推到最高的曝光位置。升档也不等于排到前面:PBR 不替代原来的相关性模型,也不替代 CTR 模型,升完档以后仍由 CTR 排序在档位内决定谁先谁后。
拿图 1 做个示意:假设黑灰色那条在第二档,PBR 判 1,它就和奶油色那条一起进入最高档,再由 CTR 模型决定谁先谁后。如果它在第三或第四档,线上这一版不会动它。图 1 用的是 high 和 low 两个标签,并没有对应到线上的四档,不能把图里的 low 理解成「低相关也会被拉到前面」。
一次判断要经过哪几步
BRIDGE 是作者为 PBR 做的整套框架,全称 Behavioral Relevance Inference with Dynamic Guidance from Evidence。它从日志里取上下文、造标签、训练 LLM,再离线把结果算好放进缓存。下面这张表列出各步的输入和产出。
| 步骤 | 输入 | 做什么 | 产出 | 只在训练时 |
|---|---|---|---|---|
| 取上下文 | 用户日志和当前 query | 每条历史记录和 query 算 embedding 相似度,每类只留最像的几条 | 和这个 query 有关的紧凑上下文 | 否 |
| 启发式建池 | 曝光列表和交互位置 | 按位置规则给每个候选一个弱标签 | 正负例大致平衡的待标注池 | 是 |
| 三方标注 | 待标注样本 | 正向标注、反向核验,不一致时由裁判决定 | 保留的样本、标签和正向理由 | 是 |
| SFT | 3 万条保留样本 | 学写七步理由再给标签 | 初始模型 | 是 |
| 评分清单 GRPO | 18,325 条难度合适的样本 | 奖励答对,也奖励理由用对证据 | 最终模型 | 是 |
| 离线推理 | 用户-query-商品三元组 | 写七步理由,输出 0/1 | 缓存里的 PBR 结果 | 否 |
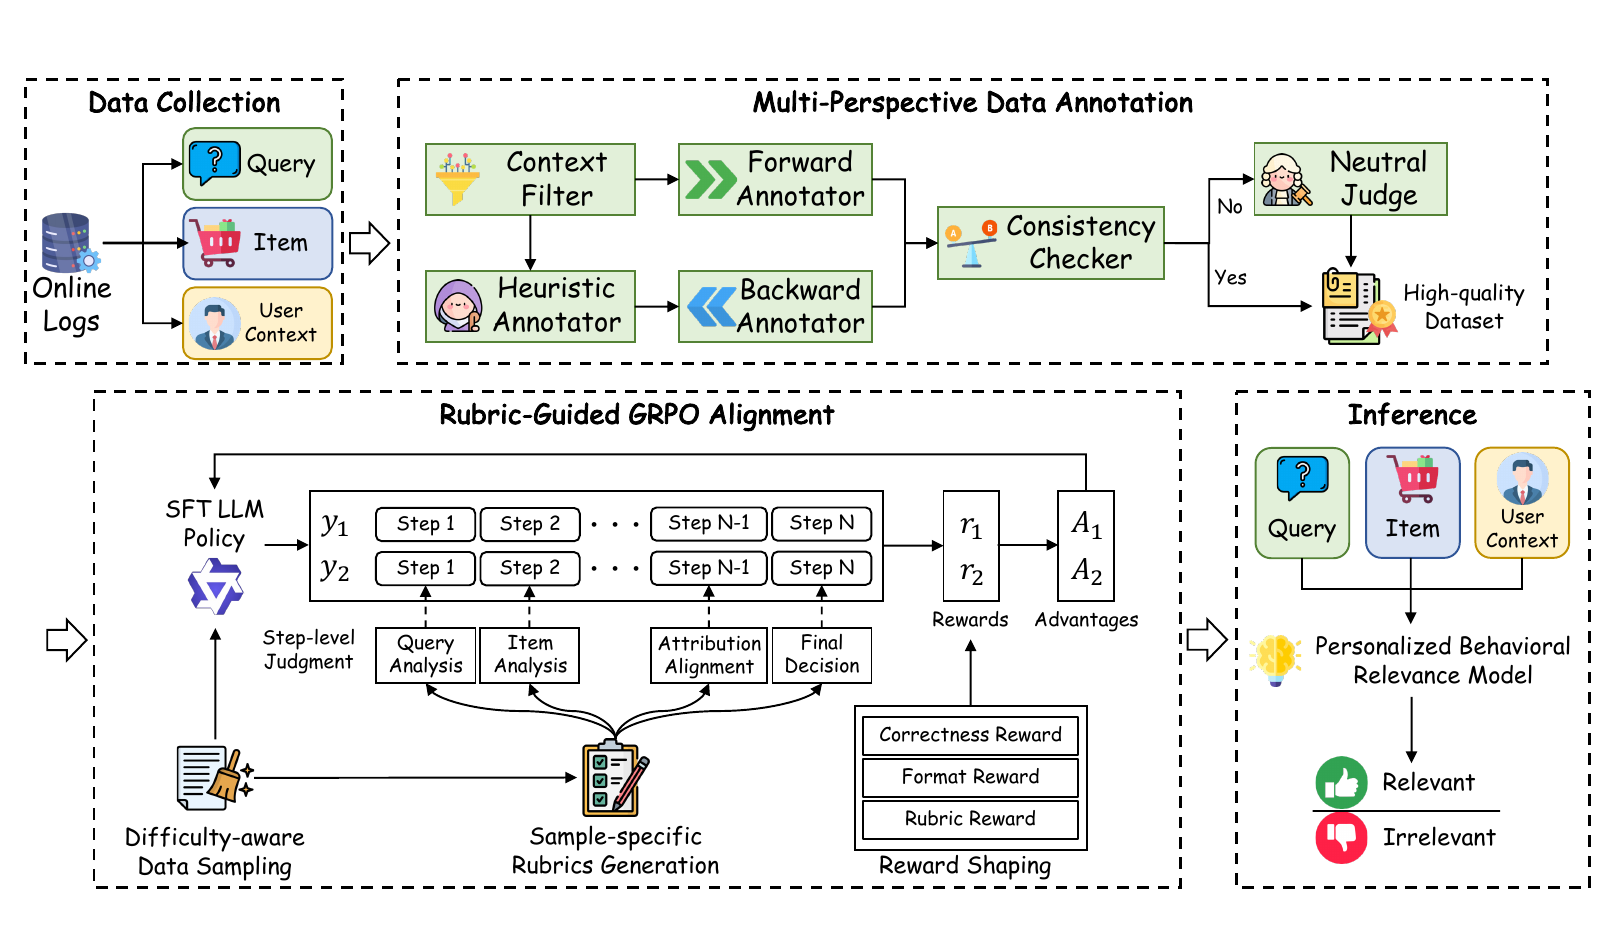
行为上下文里可能有很多和当前 query 无关的记录,所以要先过滤。作者把每条交互记录或偏好记录当作一个检索条目,用 Qwen3-Embedding-8B 算它和 query 的余弦相似度。当天和 7 天的搜索交互各留 10 条,类目价格带和 CPV 偏好各留 5 条,经营画像整体保留。
模型的输出不是直接一个标签,而是先写固定的七步理由:query 意图、商品属性、当天上下文、7 天上下文、长期上下文、属性级对齐,最后是决定和 \boxed{0} 或 \boxed{1}。对图 1 的黑灰色牛仔裤,一份理由大致长这样(示意):
- query 意图:找喇叭裤。
- 商品属性:牛仔面料,kick flare 版型,颜色黑灰。
- 当天:在 flare pants 下点过一条烟灰色加绒微喇牛仔裤。
- 7 天:点过 5 双黑色 Vans 鞋,品类不同,只能间接说明偏好深色。
- 长期:阔腿裤的偏好颜色是 khaki、gray、black。
- 属性级对齐:颜色和当天点击、长期颜色偏好都对得上。
- 决定:\boxed{1}。
同样的流程放到奶油色那条上,颜色这一项在三段记录里找不到支持;最终判 0 还是 1,要看它的其他属性能否拿到行为证据,证据不足就输出 0。作者要七步格式,是想让决定落在具体的 query、商品和行为证据上,而不是一个笼统的整体印象。
标签靠三方交叉,而不是直接用点击
既然要训练,就得有标签。直接拿交互当标签不行:被点过的商品未必真被偏好支持,没被点的也未必不相关,用户可能只是已经选了别的。
作者先用位置规则建一个待标注池。在一次曝光列表里,取有交互商品的最靠前和最靠后位置。示意:用户点了第 8 位和第 20 位。被点的两件算可能的正例;第 8 位之前没点的,用户大概率看过却没选,算信息量大的负例;第 8 到 20 位之间没点的算可能的负例;第 20 位以后不采样,用户也许根本没翻到。这些只是弱提示,不当最终标签。
接下来有三个角色。正向标注者不看弱标签,自己读 query、商品和行为上下文,写理由给标签。反向标注者拿着弱标签当提示,核验证据支不支持它,也给出自己的标签。两者不一致时,中立裁判看两份理由,决定是否接受正向标签。最后只保留「正反一致」或「裁判接受」的样本,SFT 学的是正向标注者的理由,因为推理时模型同样看不到弱标签。
结果是 50.6% 的样本正反一致,27.7% 由裁判接受,21.7% 被丢掉。也就是说,约五分之一的样本正反标签不一致,裁判也不接受正向标签,于是被丢弃。所有角色用的是同一个底座 LLM,只是提示和输入不同。作者另外随机抽了 200 个测试样本请两位博士生独立标注,自动标签和人工的一致率是 93.5%,Cohen's κ 为 0.8669,说明这条流水线造出的标签和人的判断基本一致。
只奖励答对,理由可以是空的
SFT 之后,作者接着用 GRPO 训练:每个输入让当前模型采 8 个输出,按组内相对好坏更新。问题在于,如果奖励只看最终标签,一个只写「用户应该喜欢这条裤子」就答 1 的输出(示意),和一个逐条引用颜色证据再答 1 的输出,拿到的奖励一样。
作者的办法是给每个样本单独写一份评分清单(论文叫 sample-specific rubric)。标签确定后,由 LLM 根据 query、商品、行为上下文和标签,写出和七步理由一一对应的 7 条检查问题,每条带权重。清单只依据输入和标签,不看任何模型写出的理由。训练时由 LLM 裁判逐条判通过或不通过,加权通过率就是理由分。总奖励是:
其中 是标签对不对(1 或 0), 是 0 到 1 的理由分,权重 2 和 1 是论文的设置。示意一下:7 条检查权重都是 1,两个输出都答对 1。A 在长期偏好那步写出了「颜色偏好 gray、black」,过了 6 条,得 2+6/7≈2.86;B 只写「用户喜欢裤子」,过了 3 条,得 2+3/7≈2.43。答错但过了 6 条的输出只有 6/7≈0.86。这说明标签对错仍是大头,理由分的作用是在都答对的输出之间分出高下。 Hoot 说

- A:2×1 + 6/7 ≈ 2.86(示意)
- B:2×1 + 3/7 ≈ 2.43(示意)
- 答错但过 6 条:0 + 6/7 ≈ 0.86(示意)
示意:评分清单有 7 条检查,权重相同,在看到任何回答之前就写好。A 和 B 都答对,差别只在各过了几条。答错的回答就算过了 6 条,也只有 6/7≈0.86。
出处
论文式 3 与实现设置(标签权重 2、理由权重 1),附录 C 的评分清单生成与打分提示用来 GRPO 的样本也挑过。SFT 模型对候选池里每个样本先采 8 个输出,只留下「有对有错」的样本。作者的理由是,全对或全错的组太简单或太难,组内相对优势给不出多少有用信号。这一步从候选池里留下了 18,325 条。
离线 F1 从 0.783 升到 0.830
数据来自 1688 五天的搜索日志,1688 是 B2B 电商平台。标注后共 76,329 条,其中 3 万条做 SFT,5000 条做测试(正例占 55.6%),18,325 条做 GRPO,按用户 ID 切分,避免同一用户同时出现在训练和测试里。测试标签也出自同一条标注流水线,所以离线分数衡量的是模型复现这套判断的能力。主指标是 F1。
| 模型 | Acc | Prec | Rec | F1 |
|---|---|---|---|---|
| Qwen2.5-7B 零样本 | 0.609 | 0.620 | 0.769 | 0.686 |
| Qwen2.5-72B 零样本 | 0.641 | 0.643 | 0.796 | 0.711 |
| Qwen2.5-7B + SFT | 0.748 | 0.752 | 0.817 | 0.783 |
| Qwen2.5-7B 去掉评分清单奖励 | 0.780 | 0.774 | 0.852 | 0.811 |
| BRIDGE(Qwen2.5-7B) | 0.798 | 0.780 | 0.888 | 0.830 |
| Qwen3-8B 零样本 | 0.628 | 0.633 | 0.785 | 0.701 |
| Qwen3-32B 零样本 | 0.708 | 0.699 | 0.835 | 0.761 |
| Qwen3-8B + SFT | 0.781 | 0.768 | 0.868 | 0.815 |
| Qwen3-8B 去掉评分清单奖励 | 0.792 | 0.779 | 0.873 | 0.823 |
| BRIDGE(Qwen3-8B) | 0.806 | 0.791 | 0.885 | 0.835 |
| Qwen3-Reranker-8B 零样本 | 0.495 | 0.556 | 0.447 | 0.496 |
| Qwen3-Reranker-8B + SFT | 0.731 | 0.753 | 0.767 | 0.760 |
表里数字来自论文表 2 和表 3;「去掉评分清单奖励」是保留格式检查、对格式合法的输出只算标签奖励的 GRPO 版本。
零样本的 LLM 召回高、精度低,Qwen2.5-7B 召回 0.769、精度只有 0.620,作者解读为光靠提示会把太多候选判成被支持。换更大的模型有帮助,Qwen3-32B 的 F1 到 0.761,但仍低于训练过的 8B 模型。这说明在这组实验里,这个任务的判断标准要靠标注数据教给模型,单靠换更大的模型补不上。
SFT 带来最大一跳,Qwen2.5-7B 从 0.686 到 0.783。在 SFT 之上,完整的 GRPO 又把 F1 提到 0.830(Qwen2.5-7B)和 0.835(Qwen3-8B)。只用标签奖励的 GRPO 拿到其中一部分,分别是 0.811 和 0.823。这说明评分清单奖励在标签奖励之外还有贡献,但两个底座上幅度都在 0.02 以内。Reranker 零样本只有 0.496,作者认为这个任务和常规的 query-文档检索差别很大,SFT 后的 0.760 也仍低于生成式的 SFT 模型。
作者还用同一套评分清单逐步检查推理质量(论文表 4)。前两步分析 query 和商品,各模型的通过率都在 0.93 以上。最难的是长期上下文那一步,SFT 模型是 0.625,BRIDGE 是 0.785;最后一步「决定有没有依据」从 0.726 升到 0.787。这里的打分者就是训练时给奖励的那个评分清单裁判,所以这组数字说明模型更会满足训练时的检查标准,不等于独立的人工评估。
线上 5% 流量三天,交易相关用户天 +0.67%
线上实验在 1688 主搜做,实验组占 5% 流量,持续三天,对照组是现有系统。实验组的活跃用户天提升 0.187%(p<0.02),交易相关用户天提升 0.670%(p<0.01)。前者数的是有搜索行为的用户天,后者数的是有交易相关转化行为的用户天。这说明只把第二档里被行为证据支持的候选升一档,就能在交易相关的用户天上看到统计显著的提升,活跃用户天也有小幅提升。
LLM 写七步理由并不便宜,所以 BRIDGE 不在线上实时生成。它离线处理用户-query-商品三元组,4 张 H20 每天约处理 102 万个样本,覆盖 2.09 万个 query、1.08 万个用户,平均每个 query 48.6 个候选,离线平均每个 query 要 4.12 秒。线上搜索只查缓存里的 PBR 结果,查不到就走原来的相关性链路,额外延迟可以忽略。
适用范围也是收着的。模块只对行为历史足够丰富的高价值 B2B 买家开启,新注册用户和交互稀疏的用户直接用原来的相关性模块,这样冷启动用户不会被不可靠的偏好推断影响。
结论的边界要放在这些数字旁边看。线上只跑了三天,离线数据只有五天,只在 1688 和行为丰富的用户上验证过。标签、理由和评分清单都出自 LLM,作者自己也说它们可能带着底座模型和提示设计的偏差。
改动很小,位置变了
升档的规则很窄:只看前两档,最多一档,只对行为丰富的用户。这篇改的是个性化介入的位置。图 1 里黑灰色那条被压在后面,是因为档位主要看这条裤子和「flare pants」匹配得好不好;BRIDGE 在档位上多问了一句「这位用户的行为支不支持这条裤子」,并且要求模型写出是哪条记录支持的。CTR 排序没变,变的是它拿到的候选结构。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
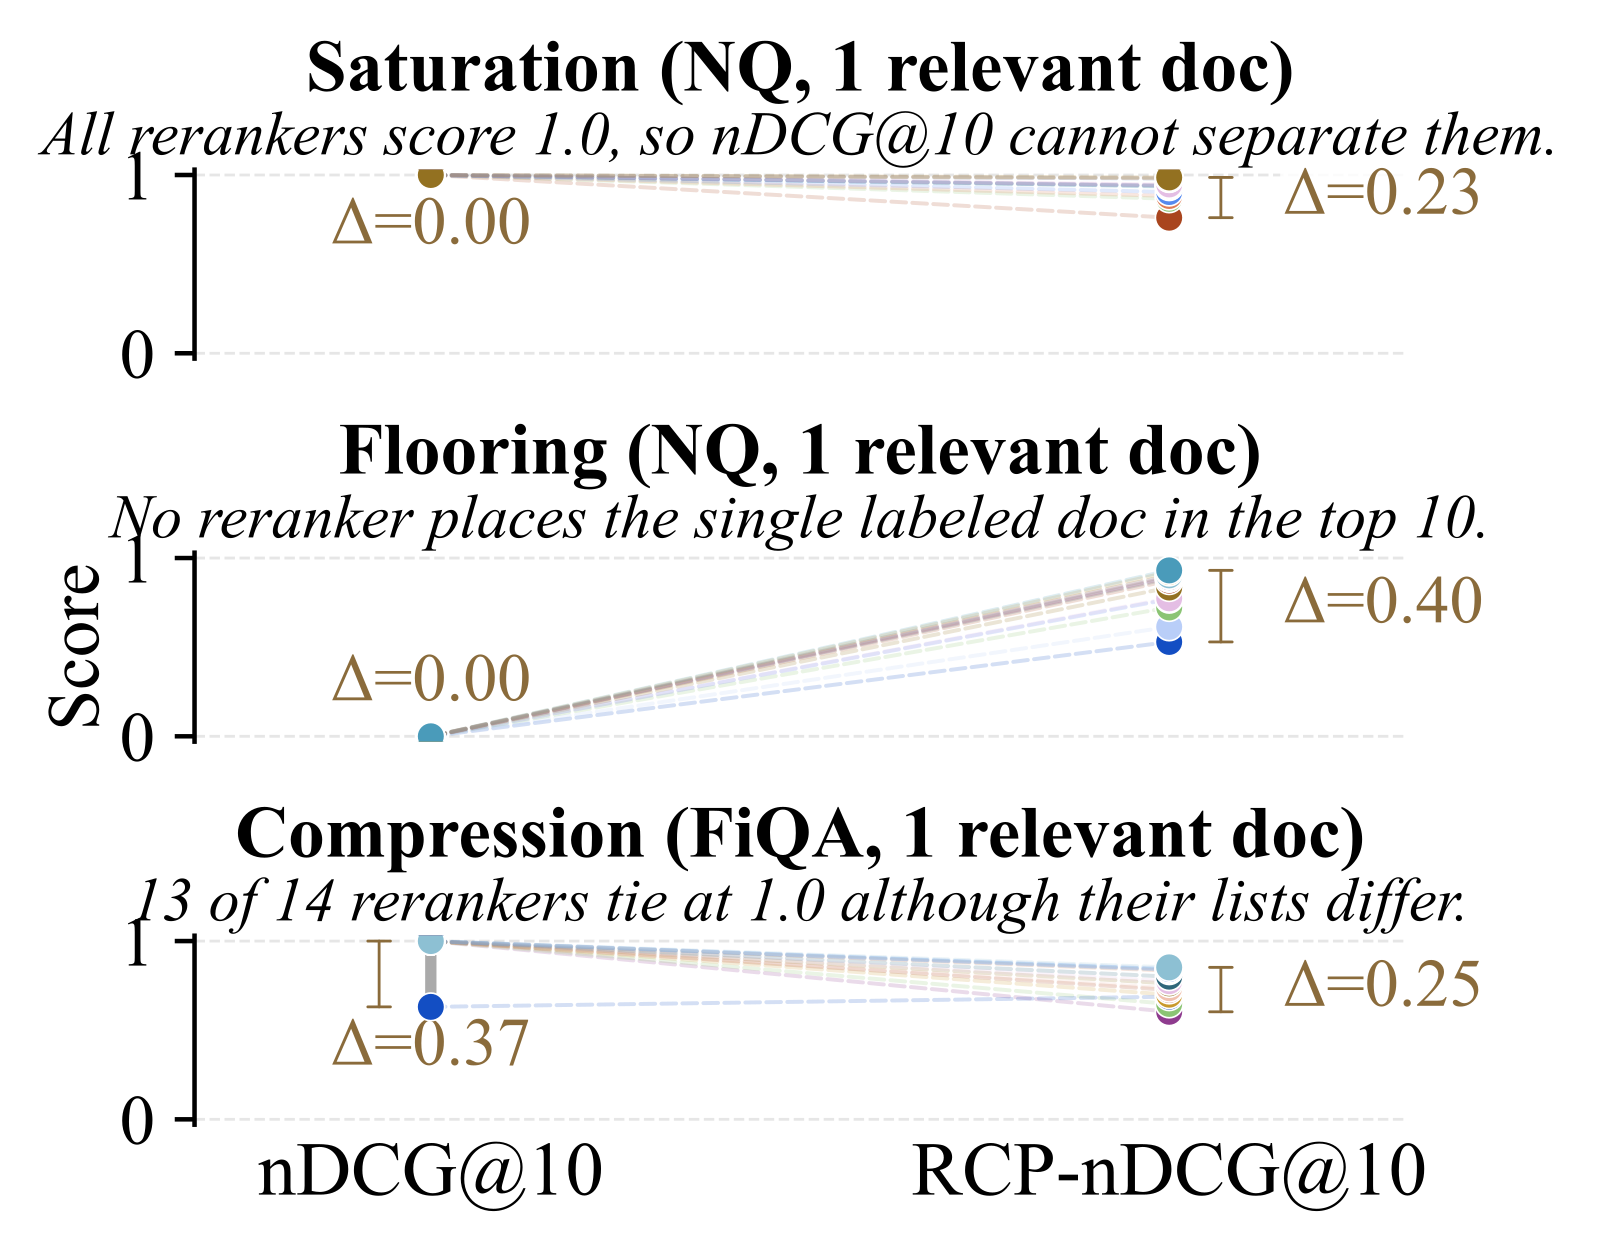 Retrieval · 2026-10-25Rubric-Calibrated Preferences: Cross-Query Calibration of LLM Judgments via Item Response Theory在作者评测的重排器上,NanoBEIR 有 45.6% 的查询,nDCG 分不出高下。根源在人工相关性标注稀疏、有噪声,只有几个离散等级。RCP 先让 LLM 每次读 10 篇文档打分,同一篇会进多个批次,批内一篇比另一篇高得越多,它越可能更相关,Bradley-Terry 模型据此合成每篇的总分。再让 LLM 对每篇回答五个由易到难的是或否问题,从是否切题一直问到是否深入回答了查询。再借助项目反应理论把总分平移、缩放成能力值,能力值比题目难度高得越多,预测通过率越高;题目难度各查询共用,只有平移和缩放按查询拟合到贴近实际回答,不同查询的分数就落到同一把尺子上。以外部标注员的盲评为准,RCP 把有用文档排在无用文档前面的概率做到 0.910,原来的人工标注只有 0.651。
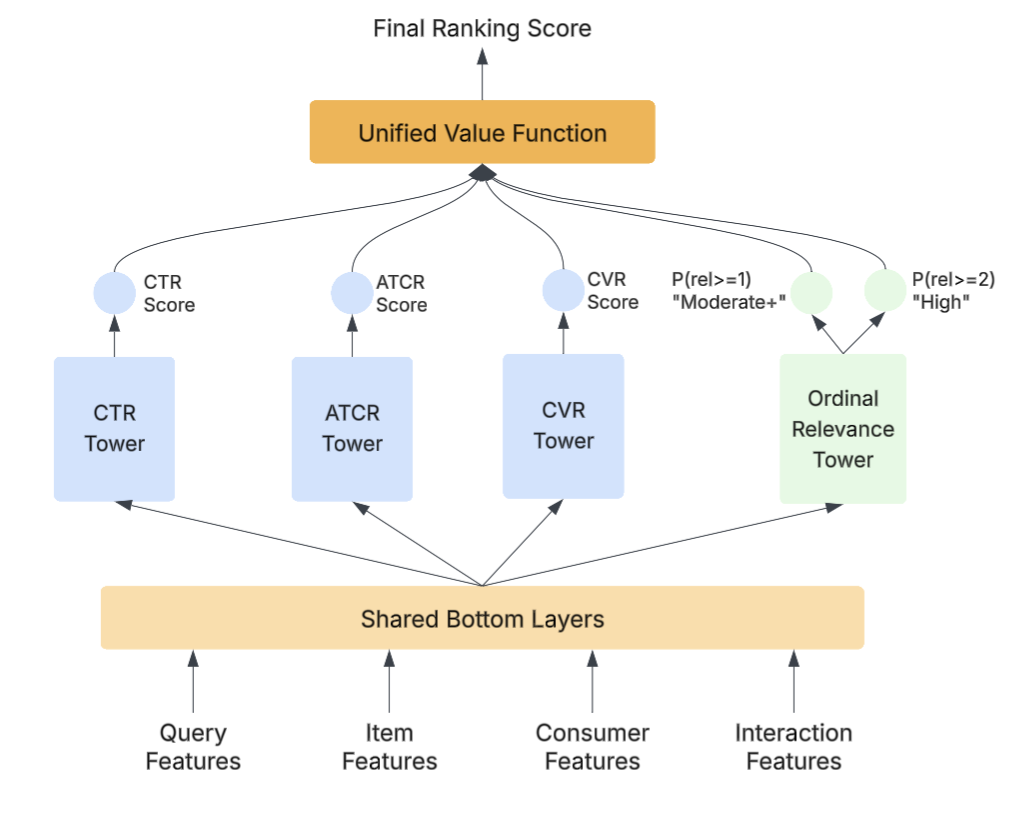 Retrieval · 2026-05-29Joint Optimization of Relevance and Engagement in Multi-Task Ranking for E-Commerce with Efficient LLM Supervision电商搜索只学点击和转化,容易把热门但不对题的商品排上来。DoorDash 离线用小号 LLM 给海量查询-商品对打三级相关性标签,在排序模型里加一个相关性头并计入最终打分,线上不调用 LLM。相关性排序指标 NDCG 从 0.812 升到 0.962,点击和转化预测基本不受影响;三周线上实验里转化率提高 1.10%。
 Retrieval · 2026-04-17From Relevance to Authority: Authority-aware Generative Retrieval in Web Search EnginesNAVER 想让生成式检索在相关度差不多时偏向可信来源。做法是让视觉语言模型看网站截图和文字打 0 到 100 的权威分,再把这个分数当 GRPO 的奖励,训练一个直接生成网站域名的 3B 模型;上线时不替换原排序,只给生成的网站加分。离线 P@3 从 0.3555 提到 0.3856,和 14B 模型打平,R@5 还略低。奖励里只有权威分,相关性全靠 SFT 和 KL 约束兜住。线上 A/B 的对照组本身也有涨幅,口径不清,需要打折看。
 Retrieval · 2026-08-05SPEAR: Selection-aware Personalized End-to-end Adaptive Rewriting and Retrieval for Community Search把推荐里的 PDN(Path-based Deep Network)搬到搜索里挑改写词,会学出一条捷径:“手机壳”“女士连衣裙”这类高频泛词能连上大量内容,也确实带来点击,于是总被选中,用户写下的品牌、型号等限定却丢了。SPEAR(一种端到端训练的个性化改写选择与检索框架)让改写选择直接接受最终点击的监督,再加两道约束:改写的选择权重和它对内容的相关性相乘,两者都高才得分;召回和排序各用一套 embedding,点击目标的梯度不回传到召回那一支。在 10 万条留出的线上会话上,点击召回 Recall@10 从 0.1694 提到 0.3380,改写和原 query 的语义相似度也一起上升。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…