
论文:arXiv 2611.08566,Zhao, Zhang et al.,Workday AI Research。本文只依据论文原文。
一、生产场景
CascadeRec 部署在一个多租户财务规划分析(FP&A)SaaS 平台上。推荐面向企业分析师,任务是在合适的时候把合适的报告、分析材料或规划材料推到他们面前。全站请求量不大,大约每天 1000 次,但每次请求的价值都很高,因此排序质量比吞吐更重要。
二、两个运营事实
第一,LLM 推理是这项功能最大的边际成本。论文给出的成本结构是:Tier-2 推理(更大的模型或多次采样)按单次请求计,大约是 Tier-1 的 3–6 倍。
第二,租户之间差别很大,体现在历史深度、请求量和内容复杂度三个维度。在这种分布下,所有人共用同一个重排器,要么在简单请求上超支,要么让难请求服务不够。请求量还高度偏斜:在均匀昂贵重排下,少数重租户占据了大部分 GPU 开销;在它们的请求高峰期,其他租户的延迟会变差。
系统设计要回答的问题是:哪些请求值得用昂贵推理,以及如何在服务链路里低成本地逐请求做出判断。
三、CascadeRec 做什么
CascadeRec 是一个两层级联:
- Tier-1:每个请求都先经过一个轻量 LLM 重排器。它读取用户最近的交互和候选内容的文本,输出排序后的候选 ID,以及低 / 中 / 高三档口头置信(低档记作 LOW,中档记作 MEDIUM,高档记作 HIGH)。
- 路由器:决定是接受 Tier-1 的结果,还是把请求升级到 Tier-2。论文设计了四类路由器:R0 按历史长度判断,R1 用 Tier-1 的置信,R2 是逻辑回归,R3 是 LLM 协调器。论文只评测了 R0。
- Tier-2:被升级的请求使用三种昂贵推理之一。T2-SC 是 self-consistency:同一提示采样 N=3 次,得到三份排序;T2-MP 用三套不同人设的提示各出一份排序;T2-Large 换用更大的模型。前两种用 Borda 计数把多份排序合成一份,即按每个候选在各份排序中的名次累加得分后重新排序。
- 回退:解析失败、超时或生成卡住时,系统回退到此刻已有的最好排序:有 Tier-1 结果就用 Tier-1,否则用召回顺序。用户看不到 LLM 报错。线下解析失败率约在 0.1% 到 10% 之间,随模型和目录而变。
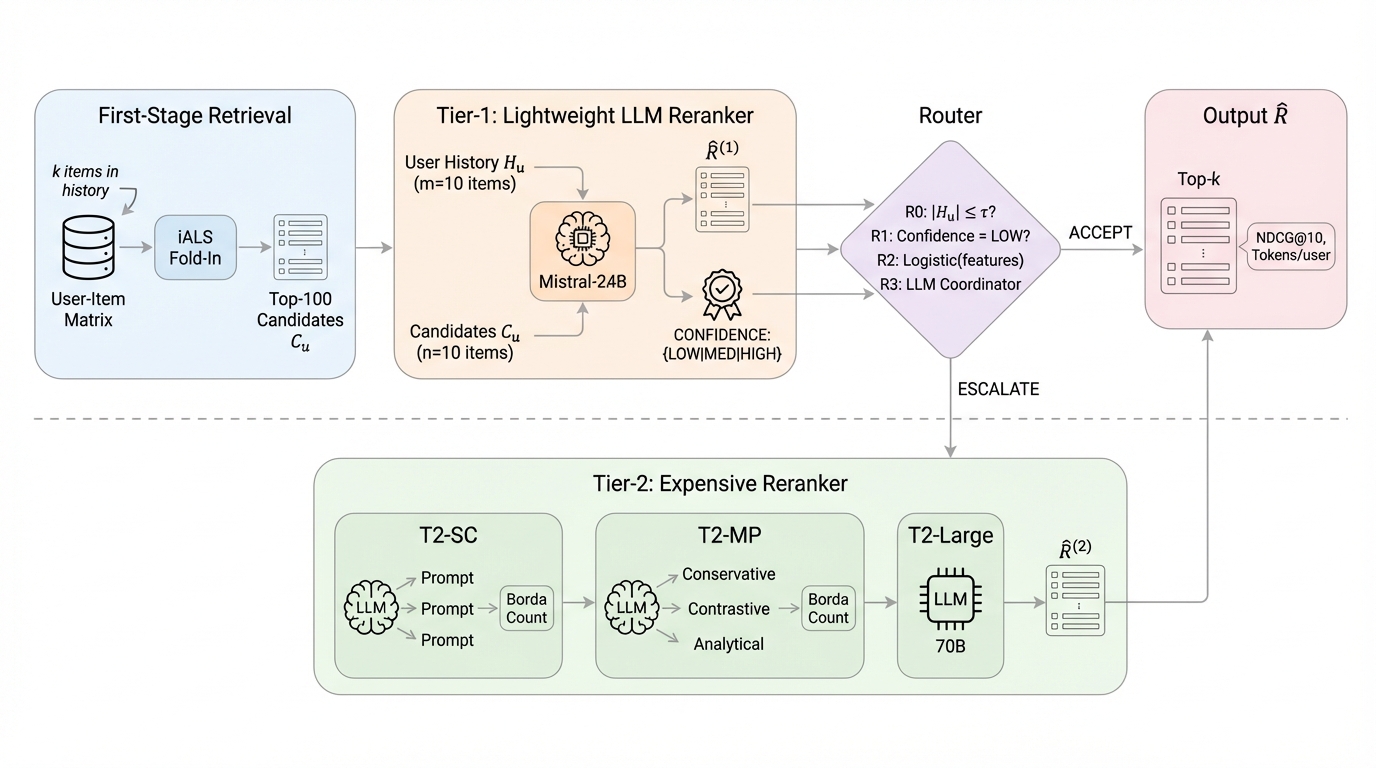
图 1:CascadeRec 架构:每个请求先过轻量 Tier-1;路由器按历史长度、Tier-1 置信等信号决定是否升到更贵的 Tier-2(自洽采样、多路径或更大模型)。
线上路由器是一个零延迟的启发式规则,依据历史长度和 Tier-1 置信。需要注意的是,生产并没有照搬线下实验用的 τ=5(历史不超过 5 条就升级);规则的升级方向和阈值都是配置项,不写死在代码里。
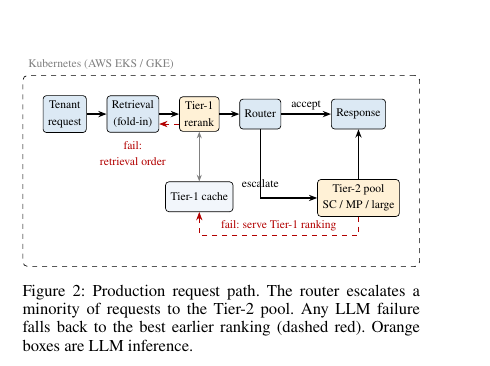
图 2:生产请求路径:检索、Tier-1、路由器、可选的 Tier-2 池串成一条链路;任一阶段的大模型失败都回退到此刻最好的更早排序(虚线红)。
生产 A/B
实验已运行一个多月。对照组是此前的均匀昂贵重排,实验组是 CascadeRec。Tier-1 结果按 (user, model, seed) 缓存,包括对照组在内的所有下游使用方读到的都是同一份 Tier-1 排序。「精确可比」的范围只到这个键:同一用户、同一模型、同一种子下,两组拿到的 Tier-1 排序相同,因此两组差异不来自 Tier-1 的采样噪声;作者称这消除了一类由采样噪声造成的假回退,也让线上 A/B 与线下重放可以对照。结果和口径如下:
- 成本:实验组推理成本约低 10%,按 token 记账。这是两组的整体对比,实验组包含随级联一起上线的全部改动,因此不是路由策略单独带来的节省。
- 质量:迄今未观察到回退,作者报告为持平,不声称增益。由于业务指标仍在累积,目前只有「持平」这一结论,效应量要等最终 A/B 读数。
- 延迟:影响被描述为很小,未升级的请求基本不受影响。这是定性描述。
生产只使用零样本模型,没有与按租户微调的排序器做过生产对比。
四、公开数据上的发现
租户数据不能发布,作者在 MovieLens-1M 和 Amazon-Electronics(2023)上做可复现的线下评估。设置要点:
- 每个用户留出一次交互作为评估目标,历史截断为这次交互之前最近的 k 条,k∈{1,3,5,10,20},每档 200 人。
- 召回使用 implicit ALS(交替最小二乘)加 fold-in。召回器只看到截断后的历史,但潜空间在全体用户上训练,作者明确说这是一个故意做强的基线(B0)。
- MovieLens 上,LLM 只重排召回 top-100 中的前 10 个,第 11–100 位不在重排范围内,召回的 Recall@100 是上限;B0 是召回顺序。Amazon 上,候选是留出的目标加 19 个抽样负例共 20 个,按召回分数排序,这就是 B0 的顺序,LLM 重排全部 20 个。表中每档的分数基于该档的 200 名用户。由于协议不同,Amazon 的绝对数值应理解为固定协议下的对比,不宜与 MovieLens 横向比较。
- 模型为 Mistral-Small-24B 和 Qwen3.5-27B,均为零样本;指标为 NDCG@10。表中带星号表示相对 B0 的差值在 10^4 次配对自助重采样下 95% 区间不含零。线下级联使用 τ=5,因此 k≤5 的档被升级;k=10 和 k=20 未升级,结果与均匀重排 B1 逐位相同。B1 是线下基线:对每个用户都用同一个零样本 LLM 做一次重排,不升级;它不同于生产 A/B 中对照组所用的此前均匀昂贵重排策略。
表 1:各冷启动分段的 NDCG@10(每档 200 名用户;数字取自论文表 1)。* 表示相对 B0 的差值 95% 配对自助区间不含零。级联(CascadeRec,表中记作 CR)使用 τ=5,因此 k≤5 的档被升级。
| 数据集 | 模型 | 方法 | k=1 | k=3 | k=5 | k=10 | k=20 |
|---|---|---|---|---|---|---|---|
| MovieLens-1M | – | B0 | .059 | .076 | .074 | .071 | .038 |
| Mistral | B1 | .053 | .070 | .066 | .070 | .048* | |
| Mistral | CR+SC | .054 | .066 | .069 | .070 | .048* | |
| Mistral | CR+MP | .053 | .074 | .071 | .070 | .048* | |
| Qwen | B1 | .061 | .070 | .073 | .069 | .041 | |
| Qwen | CR+SC | .059 | .062* | .076 | .069 | .041 | |
| Qwen | CR+MP | .056 | .063 | .077 | .069 | .041 | |
| Amazon-Elec. | – | B0 | .507 | .534 | .542 | .562 | .545 |
| Mistral | B1 | .356* | .471* | .479* | .495* | .513 | |
| Mistral | CR+SC | .337* | .462* | .443* | .495* | .513 | |
| Mistral | CR+MP | .340* | .448* | .450* | .495* | .513 | |
| Qwen | B1 | .410* | .511 | .525 | .504* | .551 | |
| Qwen | CR+SC | .419* | .513 | .537 | .504* | .551 | |
| Qwen | CR+MP | .408* | .520 | .532 | .504* | .551 |
主要发现:
- 均匀重排伤害稀疏历史用户。 Amazon + Mistral、k=1 时,B1 为 0.356*,B0 为 0.507,相对下降 29.8%,即摘要所说的「最多约 30%」。同一设置下 Qwen 的 B1 为 0.410*,下降约 19%,说明两种模型在最冷档都受损。
- 把冷用户升级可能更差。 Amazon + Mistral、k=1 时,级联加 self-consistency 为 0.337*,低于均匀重排的 0.356*。换成 Qwen,级联加 self-consistency 为 0.419*,B1 为 0.410*,升级大致中性,两者仍显著低于 B0。
- 唯一显著的增益出现在历史最长的分段。 MovieLens + Mistral、k=20 时,B1 为 0.048*,B0 为 0.038,约 +27%。作者指出该档的截断方式偏重近期行为,可能与最终点击不一致,从而可能压低协同过滤基线,因此要求保守解读这一结果。
- 聚合上没有 LLM 配置胜过 B0。 在成本侧,τ=5 下升级率约 60%,与每个请求都升级相比,Tier-2 token 少花 40%–50%。
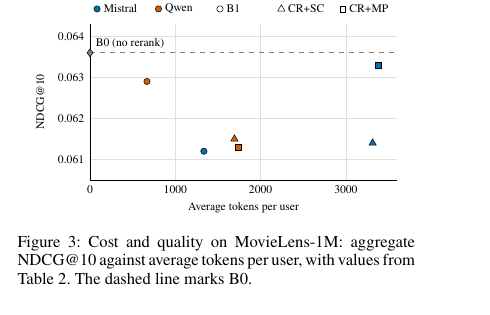
图 3:MovieLens-1M 上的聚合权衡:横轴是每用户平均 token,纵轴是 NDCG@10。虚线是只做召回、不做重排的 B0;均匀重排和 cascade 都要花 token,但聚合分数仍在虚线下方。
线下哪些分段能从升级中受益,取决于领域,所以生产没有照搬 τ=5。生产规则按租户流量上测得的分段差值设定。线上按历史长度和租户规模分段,逐段比较实验组与对照组的质量差,而不只看聚合。这些差值是两组之间的比较,并没有把 Tier-2 或额外推理的作用单独分离出来。规则只在某段通过 rollout 门后才改动,rollout 门检查的正是这些分段差值;全量上线按租户批次推进,每批通过自己的门后才放开。
五、机制
作者把稀疏历史下的伤害主要归因于提示里缺少偏好证据。只有一两条历史时,模型能读到的用户信息很少;作者的解读是,更多采样或更多样的推理往往会再次得出同样错误的结论。这是作者给出的归因,属于对实验结果的解读。
六、落地教训
- 先测分段,再分配算力。 「更难的请求给更多算力」在这里并不成立:冷用户看起来最难,升级却可能让结果更差。升级方向应按分段、按领域实测决定。
- 线下阈值不能直接搬到线上。 τ=5 是用来检验「冷用户一律升级」这一直觉的实验设置,生产没有照搬它,线上规则的方向和阈值是配置项,按分段实测差值调整。
- 成本与质量的口径要分开读。 约 10% 是整个实验组的节省,不等于路由单独的贡献;质量持平是「未观察到回退」,不是已证明的增益;线下 40%–50% 的 Tier-2 token 节省是在可控设置下隔离出的路由效果。
- 兜底要设计进请求路径。 线下解析失败率在约束提示下最高约 10%(表 4 中 Qwen 在 MovieLens 上为 10.4%),而 Qwen 最初的自由输出曾达到 96.9%;回退到已有的最好排序可以保证用户不会看到 LLM 错误。
论文要传达的核心是:昂贵推理应在按分段测量之后再分配,而不是默认加给每个请求或每个「难」请求。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…