目录 · 8 节
1它在回答什么问题2用了哪几种手段,各自看什么3发现一:三段式流水线,阶段相同、细节不同4发现二:专门的匹配头,以及它们怎么被难负例骗5发现三:MiniLM 可能在找“不相关的证据”6我认为它的局限7一个搜索团队可以怎么试8结论
基于 BERT 的 cross-encoder 是最准的重排模型之一,但它内部怎么判断相关一直说不清。这篇论文在三个大小不同的模型、多个域内和域外数据集上追踪信息怎么流动,发现三个模型经历的阶段相同:前中层先让 token 结合上下文,同时有专门的注意力头找 query 和文档之间的字面匹配;更深的层出现找语义匹配的头;最后信号汇向 query 的 token 和 [CLS] 打分。但细节各不相同:三个模型把相关信号汇进 [CLS] 的方式不一样,MiniLM 甚至可能是在找“不相关”的证据。
这是一篇扎实的“解剖报告”,不是新方法。对做精排的团队,它最有用的是两条可以拿来自查的结论:一是负责匹配的注意力头可能被 BM25 挑出来的难负例骗到,论文里只有 MonoBERT-large 明显失灵,作者归因于它的训练损失而不是模型大小;二是 MiniLM 可能在找“不相关的证据”,而不是“相关的证据”。第二条仍是论文的假设,关键控制实验只用了一对 query 和文档,结论要打折看。
它在回答什么问题
论文研究三个模型:MiniLM-L12-v2(33M 参数、12 层)、MonoBERT-base(12 层,作者自己在 MS MARCO 上微调)和 MonoBERT-large(340M 参数、24 层)(§3.1)。MonoBERT-base 是故意挑的“对照组”:层数和 MiniLM 一样,预训练方式和 MonoBERT-large 一样,这样能分开看模型大小和预训练各自的影响。
域内数据用 TREC DL 2019–2022 里人工标注过的 226 个查询;域外数据从 BEIR 里挑了最像传统检索的几个,包括金融问答 FiQA、新冠文献检索 TREC-Covid、医学检索 NFCorpus 和 BioASQ、开放域问答 Natural Questions 等(§3.2)。
要回答的问题可以压成一句:一个 query 和一篇文档拼在一起送进模型,从第一层到最后的 [CLS] 打分,中间哪些部件在干活、信息从哪流向哪、流过去的是什么信号。为了说清“流向”,论文把输入切成五块:[CLS]、query 的 token、第一个 [SEP]、文档的 token、第二个 [SEP],注意力矩阵就被切成 5×5=25 个格子,每个格子代表一种传递方向,比如“文档 token 从 query token 那里取信息”(§5,图 5)。
用了哪几种手段,各自看什么
单一的可解释性方法容易看走眼,所以论文用了四种手段互相印证,下表是其中三种,第四种 Information Bottleneck 在表后说明:
| 手段 | 做法 | 回答什么 |
|---|---|---|
| 归因(NIG,积分梯度用在神经元上的版本) | 以“把要研究的那段输入换成填充符 [PAD]”为起点,沿两者 embedding 之间的直线插值,并主要在模型判断发生变化的区间取样(§4.1);每走一步,记下打分对某个部件的值(FFN 神经元的激活,或注意力头 softmax 之后的注意力概率)的梯度乘以这个值这一步的变化,累加起来;同一部件在所有 token 上的结果再求和,就是它的归因分(§4.1) | 哪些部件最重要 |
| 屏蔽传递方向 | 从第 1 层到第 ℓ 层,把某个格子的注意力全置零,看 nDCG@10 还剩原来的百分之几 | 某个方向的信息从第几层开始不可或缺 |
| 注意力对比 | 同一个 query,分别配相关文档、随机文档(简单负例)、BM25 挑出的不相关文档(难负例),对每个头算两个量,都是先对每个 query token 单独算、再把所有 query token 加起来、最后对整个数据集的 query 取平均:一是这个 token 看文档时最大的那个注意力权重,二是它在文档上的注意力熵;再比较相关和不相关时这两个量差多少;然后算注意力落在与出发 token 完全相同的 token 上的概率(论文用它近似字面匹配) | 每个头在找字面匹配还是语义匹配 |
归因这一步做了一个对检索很关键的改动:不是单看一对 query 和文档,而是用三元组(query、相关文档、不相关文档),归因的是“相关文档比不相关文档得分高”这件事(§4.2)。具体说,相关对和不相关对各自从自己的起点(被研究部分换成填充符的输入)出发,按同一个进度同步插值;被求导的输出是两者打分之差再过 sigmoid(式 2)。这样找到的是负责区分的部件,而不是负责打分的通用部件。第四种手段 Information Bottleneck 给每一层的每个注意力头配一组可学习的开关,每个开关管一个“从哪部分输入传到哪部分”的方向([CLS]、query、文档、两个 [SEP] 两两之间共 25 个方向),乘在注意力矩阵对应的区块上。这组开关在 MS MARCO 训练集上学一次、所有样本共用,原模型冻结;损失一边要求加遮罩后的打分和原打分接近,一边惩罚打开的开关数,最后按阈值二值化(附录 E)。学完后 MiniLM 只保留约 9% 的方向,MonoBERT-base 约 15%,MonoBERT-large 约 21%。加上遮罩后三个模型在所有数据集上都没有统计显著的下降,比如 MiniLM 在 TREC DL 2019 上从 0.74 到 0.71(表 2),说明这组一起学出来的遮罩在所测数据上没有造成统计显著的排序下降。
发现一:三段式流水线,阶段相同、细节不同
把几种手段的结果叠在一起,三个模型经历的阶段相同(§5.2、§10):
- 前中层:query 和文档各自结合上下文,同时两边互相取信息。论文据此反驳了早先的假设:早先认为一开始 query 和文档互不理睬,实际上跨两边的传递和各自内部的传递在同一批层里同时发生。
- 后几层:信息主要流向 query 的 token,query 在这里像一个“收集箱”。
- 最后:信号汇进 [CLS]。这一步三个模型做法不同(§7.2、§10)。MiniLM 先在 query 的 token 上把信号加工好,最后才交给 [CLS],屏蔽所有 token 向 [CLS] 传信息,它的性能直到最后几层才开始掉(图 9)。MonoBERT-large 把原始信号收进 [CLS],再在 [CLS] 里用好几层加工。MonoBERT-base 介于两者之间,[CLS] 从较早的层就开始积累相关信息。论文推测,12 层不够让 [CLS] 独自完成全部加工(§8.4)。
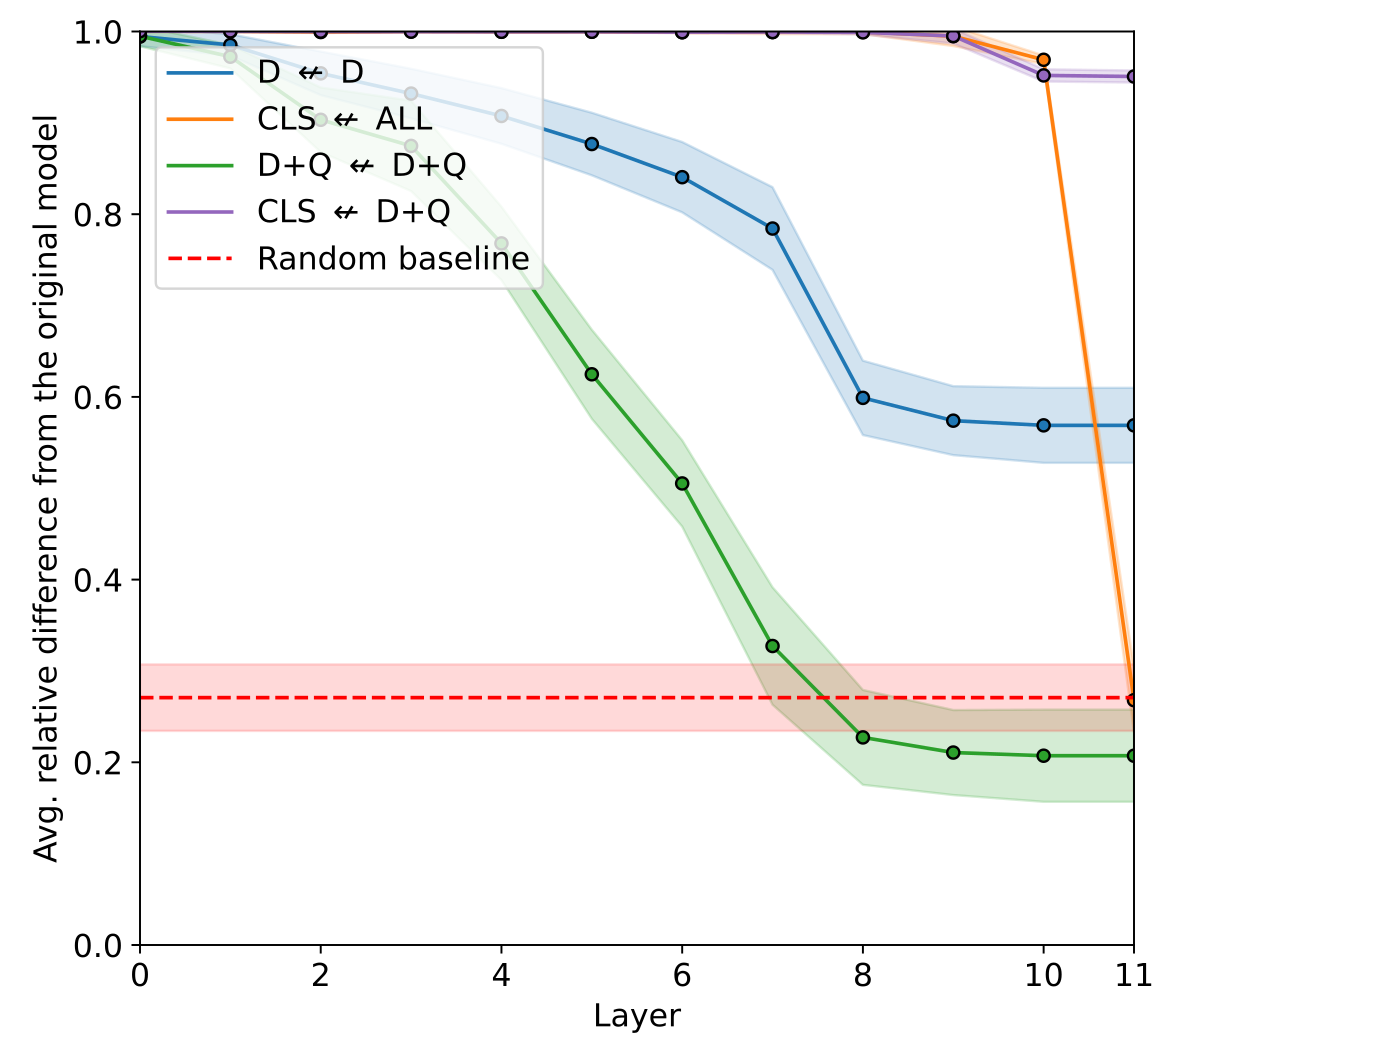
一个具体例子:在 TREC DL 上,把 query 和文档之间以及各自内部的传递从头屏蔽到底,三个模型都掉到随机排序的水平(§5.3)。但在域外数据上,两个 MonoBERT 还能保住一部分性能,说明它们学到了绕开显式交互的路径,MiniLM 没有。归因结果也显示了同样的差别:换到域外数据集,两个 MonoBERT 依赖的重要神经元和注意力头和域内大不相同,MiniLM 基本不换(§4.4),这是论文认为 MiniLM 更稳定的依据。
发现二:专门的匹配头,以及它们怎么被难负例骗
注意力对比找到了一小批“匹配头”:文档相关时,它们的注意力明显更集中地落在对面的某个 token 上,而且是双向的,query 看文档和文档看 query 同时变强(§6.2,图 11)。再看被关注的是不是同一个 token,可以把匹配头分成两类。以 MiniLM 为例,中间层有两个头主要盯“同一个 token”,是字面匹配;更靠后的一个头主要盯和出发 token 不同的 token。论文把“出发 token 和被关注 token 不同”的匹配称为语义匹配,这是按 token 是否相同划分的定义(§6.2)。三个模型都是字面匹配头在前、语义匹配头在后(图 13),因为语义匹配要等 token 先结合上下文、有了意思之后才做得了。
这批头确实重要。MiniLM 归因排名前 10 的注意力头里,8 个与此前用因果追踪方法找到的“匹配头”重合,6 个在本文的对比图里被单独标出(表 3)。这说明归因(NIG)排名再加上注意力对比,可以比因果追踪更省事地定位这些头。
难负例是这一节最值得做检索的人注意的地方。把对比对象从随机文档换成 BM25 挑出的难负例,所有头的差别都变小;MiniLM 和 MonoBERT-base 最突出的匹配头仍然站得住,MonoBERT-large 最突出的两个头(第 11 层和第 15 层的第 13 个头)却不再显眼(图 12)。换句话说,难负例和 query 字面上很像,MonoBERT-large 的匹配头分不清“词对上了”和“真的相关”。论文把这归因于训练损失:MonoBERT-large 用更简单的二分类交叉熵微调,MiniLM 用 listwise 损失,MonoBERT-base 用 InfoNCE(§8.4),所以不能简单说成模型越大越差。另外,§7.2 在每一层分别取 [CLS]、query token 和文档 token 的隐藏状态,用线性判别分析(LDA)检验相关和不相关文档能否被线性分开,发现三个模型在域外数据上都分得更差,遇到难负例时也要到更深的层才分得开。论文由此推测,cross-encoder 在没吃透新领域语义时会更依赖字面匹配,这可能是它在域外出错的原因。
发现三:MiniLM 可能在找“不相关的证据”
最出人意料的是一个控制实验(§5.3,图 10b)。作者在所有层、所有注意力头上把注意力权重都置零,只留下 [CLS] 看自己这一项,并手动把这一项从 0 调到 1,看模型给一对不相关的 query 和文档打多少分。作者把这个权重当作“读多读少”的代理:在正常运行的模型里,注意力权重加起来等于 1,[CLS] 看自己的权重越高,留给 query 和文档的就越少。实验里其他权重一直是零,[CLS] 并没有真的读进更多或更少内容,所以它测的是“只改这个代理值”时打分怎么变,结论要打折看。
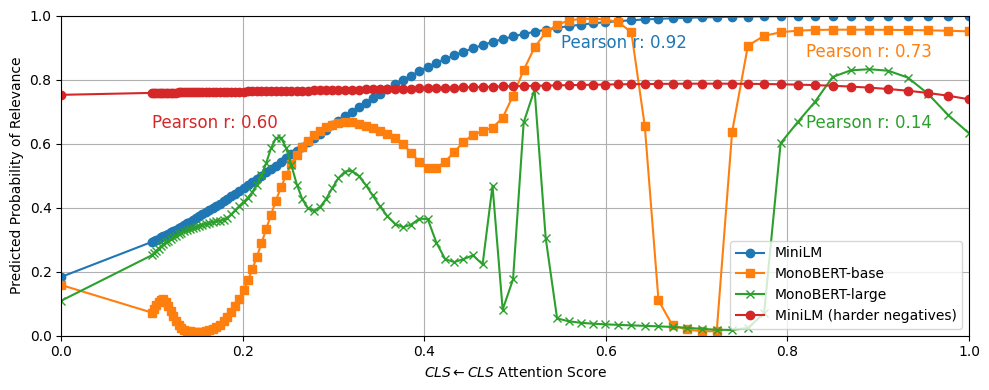
结果 MiniLM 的打分随这个权重几乎单调上升,相关系数 0.92;MonoBERT-large 只有 0.14,MonoBERT-base 0.73 但曲线起伏不定。也就是说,只要 [CLS] 看自己这一项的权重变大,MiniLM 就更倾向于判相关。作者据此提出一个假设:MiniLM 的默认答案像是“相关”,读 query 和文档是为了找出“不相关”的理由。数据集层面也有呼应:屏蔽 query 与文档之间以及各自内部的传递后,MiniLM 在域内和域外都跌到随机水平以下(§5.3);MiniLM 有几个头在文档不相关时反而注意力更集中,域内域外都如此(§6.2)。用更难的负例(ColBERT-v2 挑出的)训练的 MiniLM 更极端,不论权重多少都判为相关。
基于这些,论文的实用建议是:MiniLM-L12-v2 效果略好于两个 MonoBERT(表 5),内部机制在域外更稳定,比 MonoBERT 更划算(§10);MonoBERT 尤其是 large 版可能参数过多,同一件事学了几条并行的路(§5.2)。
我认为它的局限
- 只研究了 BERT 类模型。 论文明确排除了基于 decoder 的大模型重排(§3.1),而现在线上越来越多用 LLM 重排,这些结论能否迁移不知道。
- “找不相关证据”的关键实验只用了一对样本。 图 10b 是在一个 query 和一篇不相关文档上调权重得到的,0.92 这个相关系数不代表整个数据集。作者自己也承认屏蔽实验有信息泄漏:屏蔽是在 softmax 之后把权重置零,被遮住的 token 仍会影响剩下那一项的权重大小,信息就这样漏了进来。所以 [CLS] 只能看自己时,MiniLM 仍保留约 80% 的性能(§5.3、§8.3)。
- 难负例和域外的结论偏定性。 匹配头被难负例骗、域外更依赖字面匹配,主要来自注意力对比图和逐层可分性分析,论文没有量化这对排序指标的影响。作者在另一篇后续工作(Vast et al., 2026)里据此删掉多余的注意力方向,报告延迟大幅降低、域外效果也更好(§8.5),但那些结果不在本文里,这里无法核实。
一个搜索团队可以怎么试
- 如果线上精排是 BERT 类 cross-encoder,先复现注意力对比:取一批 query,分别配相关文档、随机文档和 BM25 难负例,找出注意力差别最大的几个头,看它们在难负例上是否“失灵”。
- 单独建一个“字面像但不相关”的评测切片(BM25 高分的不相关文档),比较当前模型在这一片和整体上的 nDCG@10 差距,判断字面匹配依赖有多重。
- 在候选模型选型时,把 MiniLM-L12-v2 和更大的 BERT 精排放在同一批域外数据上比,论文的结论是小模型未必吃亏。
- 若在用 MiniLM,可以在少量样本上重复 [CLS] 自注意力的控制实验,看模型是否也有“默认相关”的倾向;如果有,空文档或噪声文档可能被打高分。这一点是据该实验的推测,论文没有测过,值得单独监控。
结论
| 维度 | 判断 | 理由 |
|---|---|---|
| 新意 | 中 | 主要是整合与验证已有假设,修正了早先“先各自理解再交互”的说法 |
| 证据 | 中 | 三模型、域内外、多手段交叉印证,但多为图上定性结论,关键控制实验只用一对样本 |
| 对实践的价值 | 中 | 给出难负例和“默认相关”两个可自查的风险点,以及 MiniLM 更划算的选型建议 |
| 适用范围 | 窄 | 只覆盖 BERT 类 cross-encoder,不含 LLM 重排 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
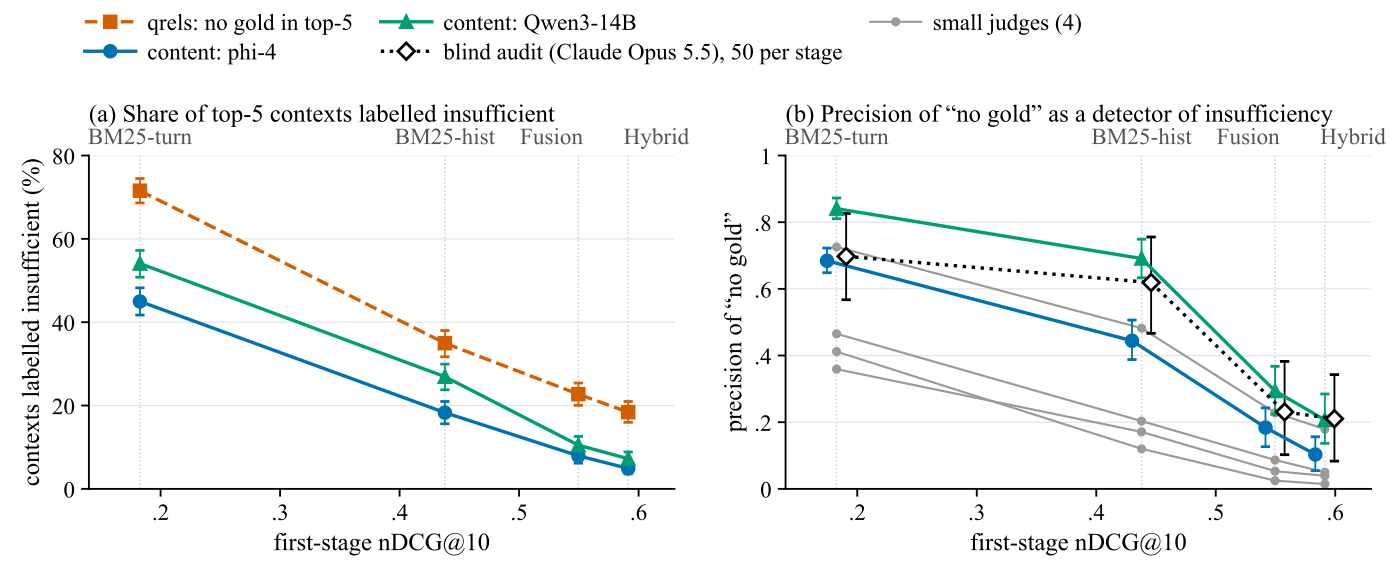 Retrieval · 2026-11-03Better Retrievers, Worse Labels: How Incomplete Relevance Judgments Distort Abstention Evaluation in Conversational RAG对话式 RAG 评测里,判断检索内容够不够回答常走一条捷径:检索结果里没有标注过的相关文档,就算答不了,模型这时拒答算对。作者在 RECOR 上换了四个检索器重跑,发现检索器越强,这条捷径越不准:没有标注文档、其实却含有答案的上下文,从 28% 升到 72%。原因是相关性标注不全,强检索器常常找到没被标过的有用文档。用这条捷径打分,会奖励本该回答却拒答的模型。评测拒答时应该看检索内容本身,而不是看有没有命中标注文档。
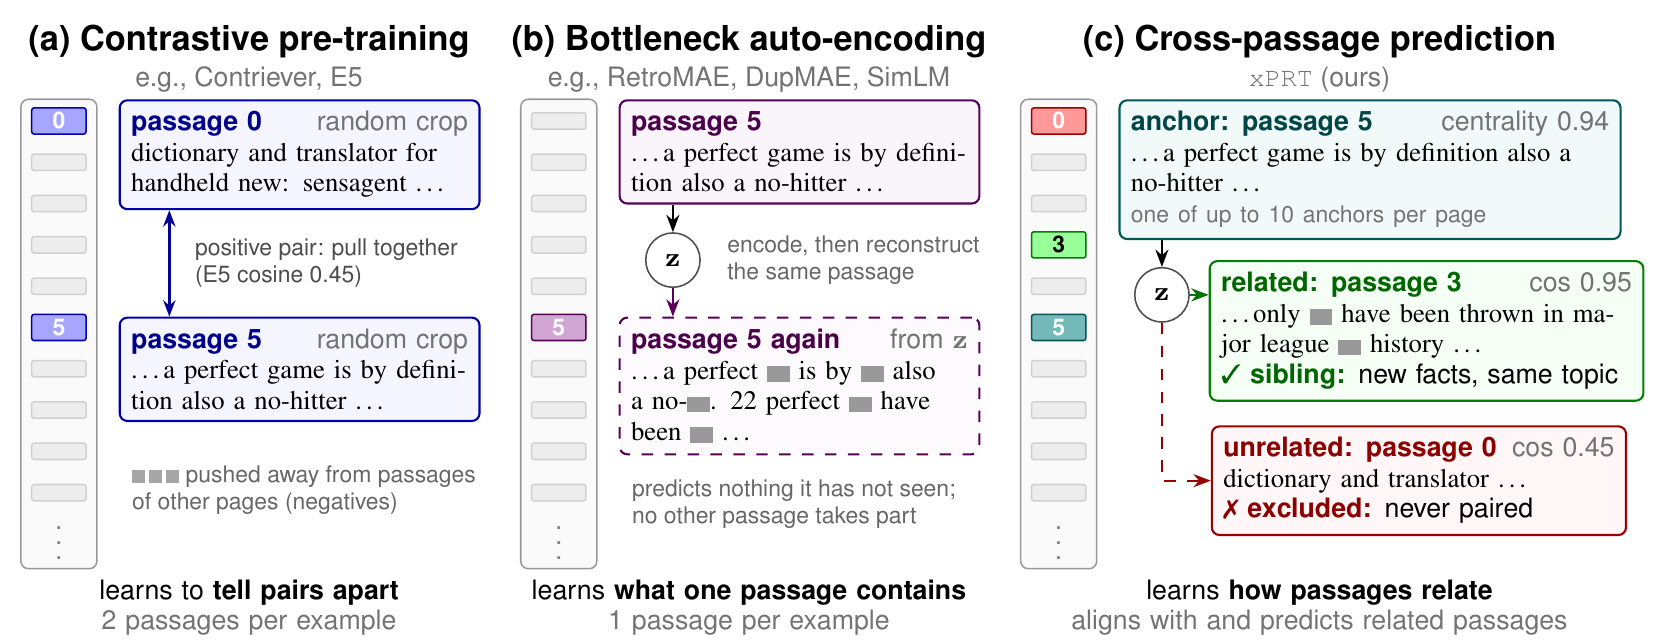 Retrieval · 2026-11-02xPRT: Cross-Passage Retrieval Pretraining同一篇网页里哪几段在讲相关的事,本身就能拿来训练检索模型。xPRT 先挑出向量和全文平均向量足够接近的段落当代表段,再按向量相似度和词面重合,给每个代表段找出同文档里最相关的四段,然后训练 embedding:代表段要在混着其他文档段落的候选里认出和它最相关的那一段;相关段被遮掉大部分词后,单层小解码器要借助代表段的向量把这些词补回来。在已经很强的 E5 上只换训练目标继续预训练,五种已有方法在 MTEB 上最多涨 0.38 分,xPRT 稳定涨约 1.8 分。起作用的主要是正样本怎么选,新加的补词项只贡献一小部分。
 Retrieval · 2026-04-17From Relevance to Authority: Authority-aware Generative Retrieval in Web Search EnginesNAVER 想让生成式检索在相关度差不多时偏向可信来源。做法是让视觉语言模型看网站截图和文字打 0 到 100 的权威分,再把这个分数当 GRPO 的奖励,训练一个直接生成网站域名的 3B 模型;上线时不替换原排序,只给生成的网站加分。离线 P@3 从 0.3555 提到 0.3856,和 14B 模型打平,R@5 还略低。奖励里只有权威分,相关性全靠 SFT 和 KL 约束兜住。线上 A/B 的对照组本身也有涨幅,口径不清,需要打折看。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…