目录 · 10 节
1它到底在解决什么问题?2先看全景:离线建一张表,线上两步走3第一步:把商品分数摊到编码的边上4第二步:按打分模型的把握程度决定加多少5第三步:在剪枝前把加分算进路径分数6实验怎么做7这套方案真的更好吗?8我认为它的局限9一个推荐团队可以怎么试10一句话结论
用 Semantic ID 做生成式推荐时,模型要一个 token 一个 token 地生成商品编码,beam search 每一步只留下分数最高的几条前缀,一条前缀被剪掉,它下面的所有商品就再也生成不出来。用户刚冒出一个新兴趣、历史里只有一两次相关行为时,这个问题最明显。比如一直在买手机配件的人刚买了一只游戏鼠标,下一件其实想买机械键盘,生成模型却在第一步就把“游戏外设”这一支剪掉了。同一份历史交给 SASRec 这类给全库商品直接打分的模型,机械键盘排在第二。这篇论文提出 TCBSA(测试时协同 beam search 调整),在每次剪枝之前,把打分模型给出的商品分数折算成对编码前缀的加分,两个模型都不重新训练。在 4 个公开数据集上,给 TIGER 加上它之后 NDCG@10 提高 4.9% 到 30.4%;而且在这 4 个数据集上,beam 宽度 20 的 TCBSA 都比把 TIGER 的 beam 开到 50 还准,延迟反而低 23% 到 32%。
做生成式召回的团队值得读。它解决的是一个上线后很常见、却很少有人单独处理的问题:生成模型和传统打分模型各有长处,大家通常等两边都出完列表再融合,可生成模型在中途剪掉的商品,融合时已经找不回来了。核心思想一句话:打分模型负责告诉生成模型“哪些前缀下面有好商品”,生成模型照常解码,只是每一步排序前把这份加分算进去。
它到底在解决什么问题?
先用论文图 1 的例子把问题走一遍。商品编码有两层(示意,真实实验里是 4 层):第一层 42 代表手机配件,81 代表游戏外设;第二层再细分到具体商品,机械键盘的编码是 [81, 29],游戏鼠标是 [81, 14]。
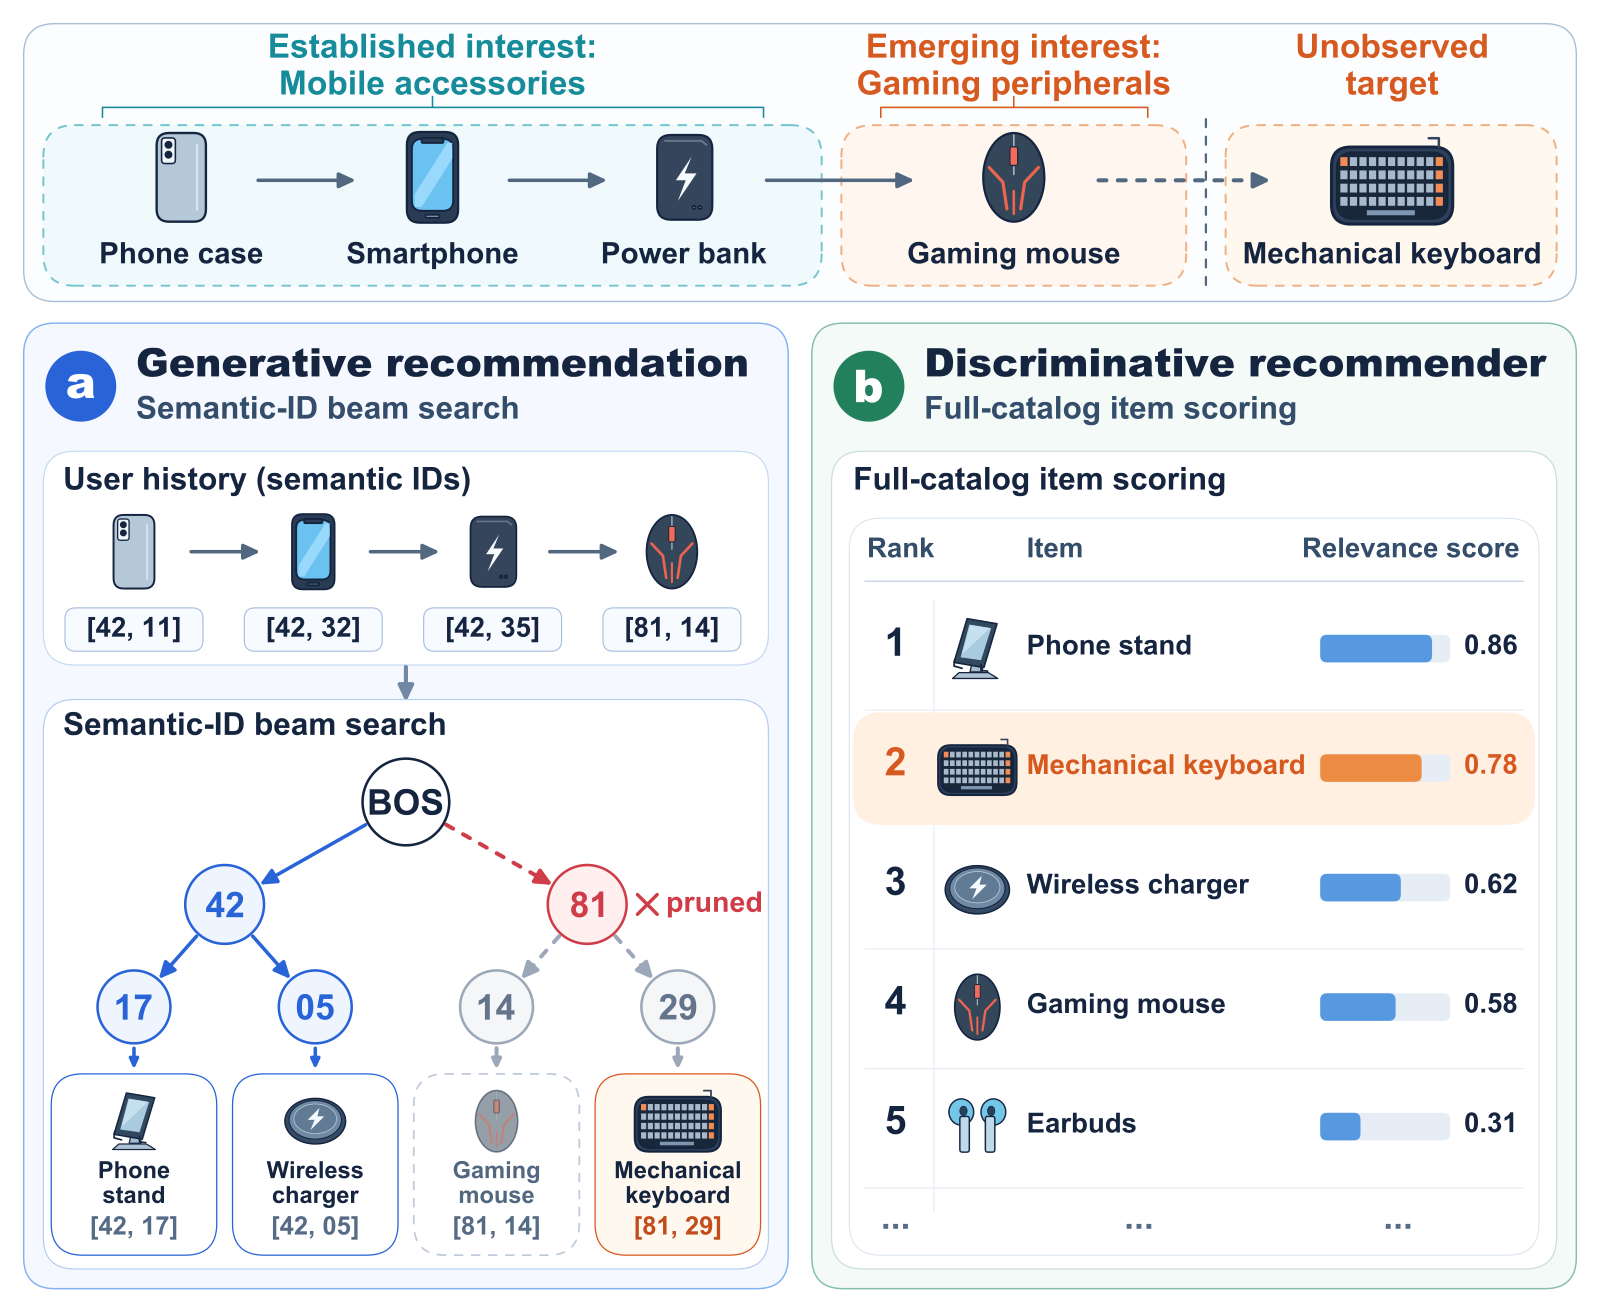
用户历史里前三件都是手机配件,只有最后一件是游戏鼠标。生成模型从历史里学到“这个人买手机配件”,第一步给 42 的概率远高于 81。如果 beam 只够留下几条前缀,81 就被剪掉了。剪枝是不可逆的,81 下面的机械键盘之后再也不会出现。打分模型不是逐个 token 做决定,它直接给全库每件商品一个分数,最近一次点击的游戏鼠标对它影响很大,所以机械键盘排得很靠前。
为什么不把两个模型的最终列表合起来?论文对比的 MemGen 就是这么做的:两边各出一个前 K 名,再按权重混合。合并确实能从打分模型的列表里捡回机械键盘,但只能照搬打分模型的排序。生成模型对“游戏外设”这一支下面其他商品的判断,因为这一支第一步就被剪掉了,一个也给不出来。要让生成模型自己把这一支走下去,必须在剪枝之前介入。
难点在于两个模型说的不是同一种话。打分模型的分数是给整件商品的,生成模型每一步要决定的是“前缀 42 后面接哪个 token”,一个前缀下面挂着很多商品。所以需要一个办法,把“商品级”的分数翻译成“前缀级”的加分。
先看全景:离线建一张表,线上两步走
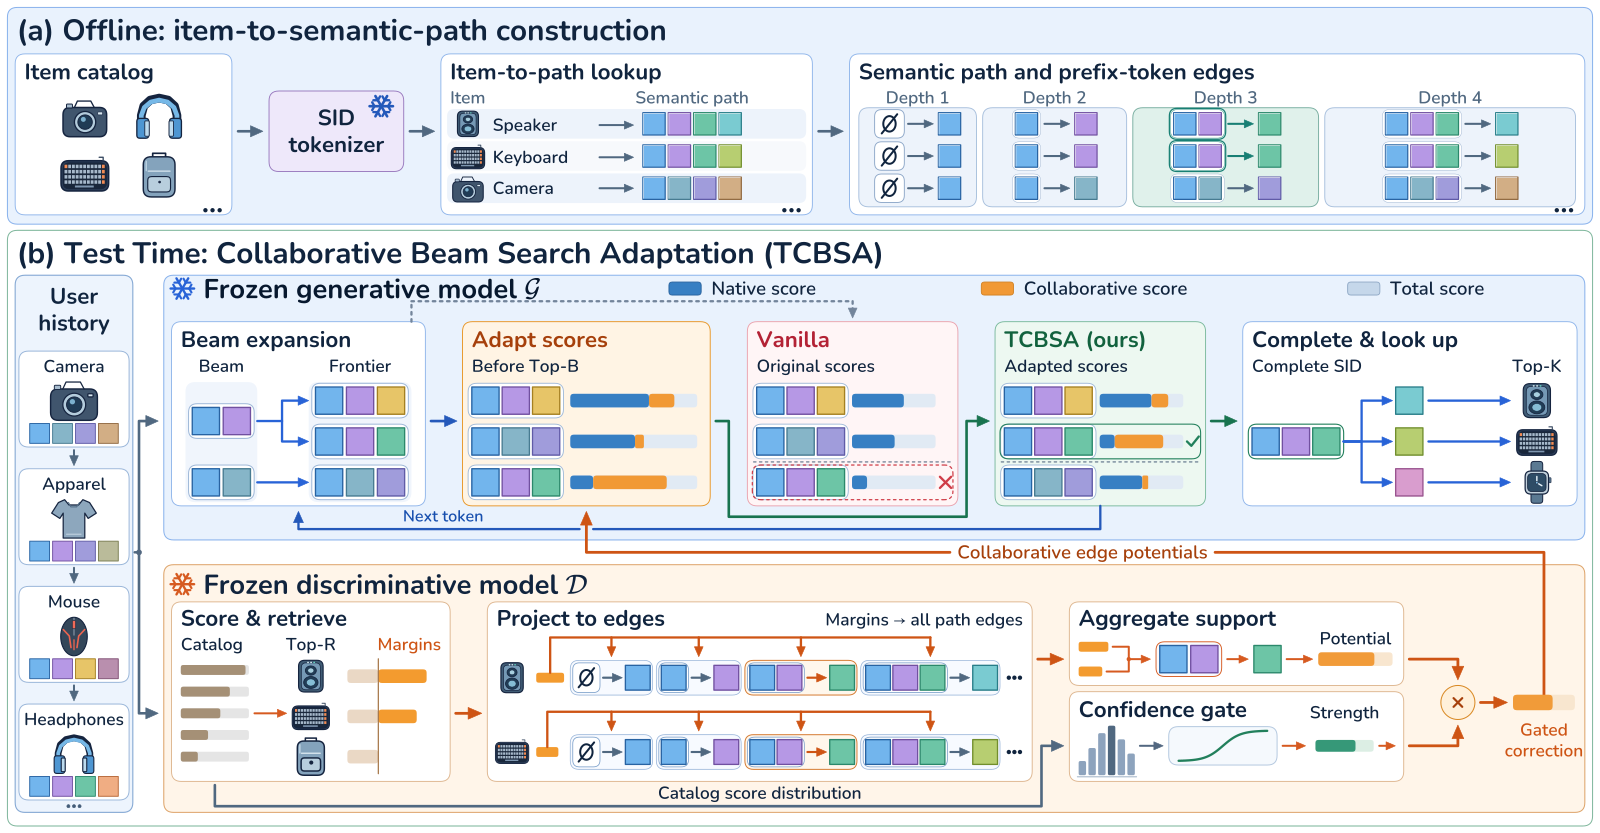
整个流程是:
- 离线:Semantic ID 是固定的,每件商品的编码 [c1, c2, c3, c4] 对应 4 条边,第一条是“空前缀接 c1”,第二条是“前缀 c1 接 c2”,依此类推。把每件商品的这 4 条边存成一张查找表。
- 线上第一步:打分模型给全库商品打分,取前 R 名(实验里 R=500),把分差摊到边上,得到每条边的加分,再按打分模型的把握程度乘一个系数。
- 线上第二步:生成模型照常做 beam search,只在每一步排序前,把这条边的加分加到路径的累计分数上。
关键分工是:打分模型只提供“这条路下面有没有好商品”的信号,生成模型仍然负责把编码一步步写完。两个模型的参数都不动。下面拆开讲。
第一步:把商品分数摊到编码的边上
为什么不直接用打分模型的原始分数?因为这类分数没有天然的零点,所有商品同时加 10 分,排序完全不变,可如果拿原始分数去加到生成模型的对数概率上,结果就会跟着乱变。所以作者只看每件商品比第 R 名高出多少:
其中 是打分模型给商品 的分数, 是第 R 名的分数。排在第 R 名之后的商品得 0。这个分差不受整体平移影响。
接下来,一条边可能被前 R 名里好几件商品经过。前缀 81 后面接 29 这条边,可能只有机械键盘经过;而“空前缀接 81”这条边,键盘、鼠标、耳机等所有游戏外设都会经过。作者把经过同一条边的商品分差合成一个数,作为这条边的加分 , 是当前前缀, 是候选 token。合成方式默认取最大的 8 个分差的平均,Yelp 上用的是取最大值。
一个能手算的小例子(示意):前 R 名里,机械键盘高出第 R 名 0.9,游戏鼠标高出 0.5,它们都经过“空前缀接 81”这条边,于是这条边的加分是两者平均 0.7。手机支架高出 0.3,它经过“空前缀接 42”,这条边加分 0.3。没有任何前 R 名商品经过的边,加分是 0。
这样摊还有一个副作用:前 R 名以外的商品也能沾光。只要它和前 R 名里的商品共用一段前缀,这段前缀就会被保住,后面的 token 再由生成模型自己补完。实验里这确实发生了,后面会讲。
第二步:按打分模型的把握程度决定加多少
为什么需要这一步?打分模型也有拿不准的时候,如果对每个用户都用同样的力度加分,在打分模型自己都没把握的用户上,加分只会把生成模型原本对的排序打乱。
作者用一个很轻的办法衡量把握程度:对打分模型的全库分数做 softmax,取最大的那个概率 。分数越集中在少数商品上, 越大。然后用一个 S 形函数把 换成加分系数:
是最大力度, 控制开关有多陡, 是门槛, 是 sigmoid。 高于门槛时系数接近 ,低于门槛时迅速变小。
按论文在 Science 数据集上选出的参数 、、 手算:如果某个用户的 ,,sigmoid 约 0.73,系数约 0.87;如果 ,sigmoid 约 0.27,系数只剩约 0.33。同样的边加分,对后一个用户只用三分之一多一点的力度。
第三步:在剪枝前把加分算进路径分数
生成模型原本给每条候选路径一个累计分数,就是一路上每个 token 的对数概率之和。TCBSA 只在这个累加里多加一项:
是前缀 已有的累计分数, 是生成模型给下一个 token 的原始对数概率, 就是前面算出的加分。每一步都按这个新分数取前 B 名,生成模型本身输出的概率没有任何改变。
接着前面的例子(示意):第一步有三个候选前缀,生成模型给出的对数概率分别是 42 得 −0.5、55 得 −1.2、81 得 −1.6,beam 只留 2 条。不加分时,留下的是 42 和 55,81 被剪掉。用系数 0.87 加分后:42 变成 −0.5+0.87×0.3≈−0.24,55 没有加分仍是 −1.2,81 变成 −1.6+0.87×0.7≈−0.99。现在留下的是 42 和 81,机械键盘所在的那一支保住了。 Hoot 说

剪枝后再重排(对照)
- 按原始分剪
- 42(−0.5)、55(−1.2)留下
- 81(−1.6)
- 第一步就被剪掉
- 再加分重排
- 只在 42、55 之间排
- 机械键盘那一支
- 找不回来
被剪掉的前缀下面的整棵子树都不会再生成,后处理够不着。
剪枝前加分(TCBSA)
- 42
- −0.5 + 0.87 × 0.3 ≈ −0.24
- 55
- 没有加分,仍是 −1.2
- 81
- −1.6 + 0.87 × 0.7 ≈ −0.99 → 留下
- 验算保留条件
- 42 可不管;对 55:0.87 × 0.7 ≈ 0.61 > 1.6 − 1.2 = 0.4 ✓
条件成立,81 最多排第 2 名,一定留在 beam 里,这和右栏直接算出的结果一致。
沿用正文的示意数字(beam 留 2 条,系数 0.87)。左栏“剪枝后重排”是我们设的对照做法;右栏最后一行把论文附录的保留条件代入这组数字验算。 出处: 论文 §4.3:路径分数 S(p⊕t) = S(p) + log π₀(t|p) + ηA(p,t),每步按新分数取前 B 名;附录保留条件:至多 B−1 个可不管,其余每个都要满足 η × 加分差 > 原始分差
论文附录还给了一个保留条件。把同一层除目标以外的候选前缀分成两部分:最多 B−1 个可以不管,剩下的每一个都要满足“目标比它多得的加分乘以系数,大于目标在原始分数上落后它的差距”。这样剩下的都排在目标后面,目标最多排第 B 名,一定留在 beam 里。打分模型没把握时系数被压得很小,加分对原始排序的改动也有上界。
实验怎么做
数据是 Amazon Reviews 2023 的三个品类(Industrial and Scientific、Musical Instruments、Office Products,下文简称 Science、Music、Office)和 Yelp,每个用户的最后一次行为做测试,倒数第二次做验证,输入最多保留最近 20 次行为。评测在全库上做,不做负采样。生成模型用 TIGER 和 MiniOneRec,商品编码由 Sentence-T5 编码商品文本后做三层 RQ-K-means,再加一位去重 token,共 4 位。打分模型用 SASRec 或 GRU4Rec。对比方法包括训练时引入行为先验的 Human-Prior、训练时考虑前缀的 APAO-Pairwise,以及合并最终列表的 MemGen 两个版本。默认 beam 宽度 20,R=500。超参数只在 TIGER 加 SASRec 这一对上调,另外两对直接沿用。
这套方案真的更好吗?
先看主结果。下表是 NDCG@10,数字照抄论文表 1:
| 方法 | Science | Music | Office | Yelp |
|---|---|---|---|---|
| TIGER | 0.0226 | 0.0334 | 0.0277 | 0.0242 |
| SASRec | 0.0198 | 0.0318 | 0.0215 | 0.0281 |
| MemGen-Adaptive(合并最终列表) | 0.0241 | 0.0353 | 0.0287 | 0.0311 |
| TIGER + TCBSA(SASRec) | 0.0249 | 0.0363 | 0.0291 | 0.0316 |
| MiniOneRec | 0.0244 | 0.0326 | 0.0262 | 0.0365 |
| MiniOneRec + TCBSA(SASRec) | 0.0260 | 0.0350 | 0.0268 | 0.0400 |
论文报告 Recall@5、Recall@10、NDCG@5、NDCG@10 四个指标,4 个数据集一共 16 组比较。每一组的最好成绩都出自 TCBSA 的某个版本,其中 14 组显著好于最强的对比方法。在同一对 TIGER 和 SASRec 上,它在所有数据集和指标上都超过合并列表的 MemGen。这说明在剪枝前介入,确实比事后合并列表多拿回了东西。换成 MiniOneRec 后提升变小(NDCG@10 提高 2.3% 到 9.6%),我的理解是,MiniOneRec 本身做过强化学习,原始 beam 已经更准,可救的余地小一些。
再看新兴趣。作者把商品文本向量聚成 16 类,挑出“最后一两次行为属于新的一类、之前四次里至少三次属于另一类”的用户。在 Science 上,只有一次新兴趣行为的 602 个用户里,TIGER 的 NDCG@10 是 0.0398,加上 TCBSA 后是 0.0462。这说明它恰好补在生成模型最弱的地方。但在 Yelp 只有一次新兴趣行为的子集上,单独的 SASRec 仍然最好(0.0525 对 0.0502),打分模型本身就擅长抓最近的行为。
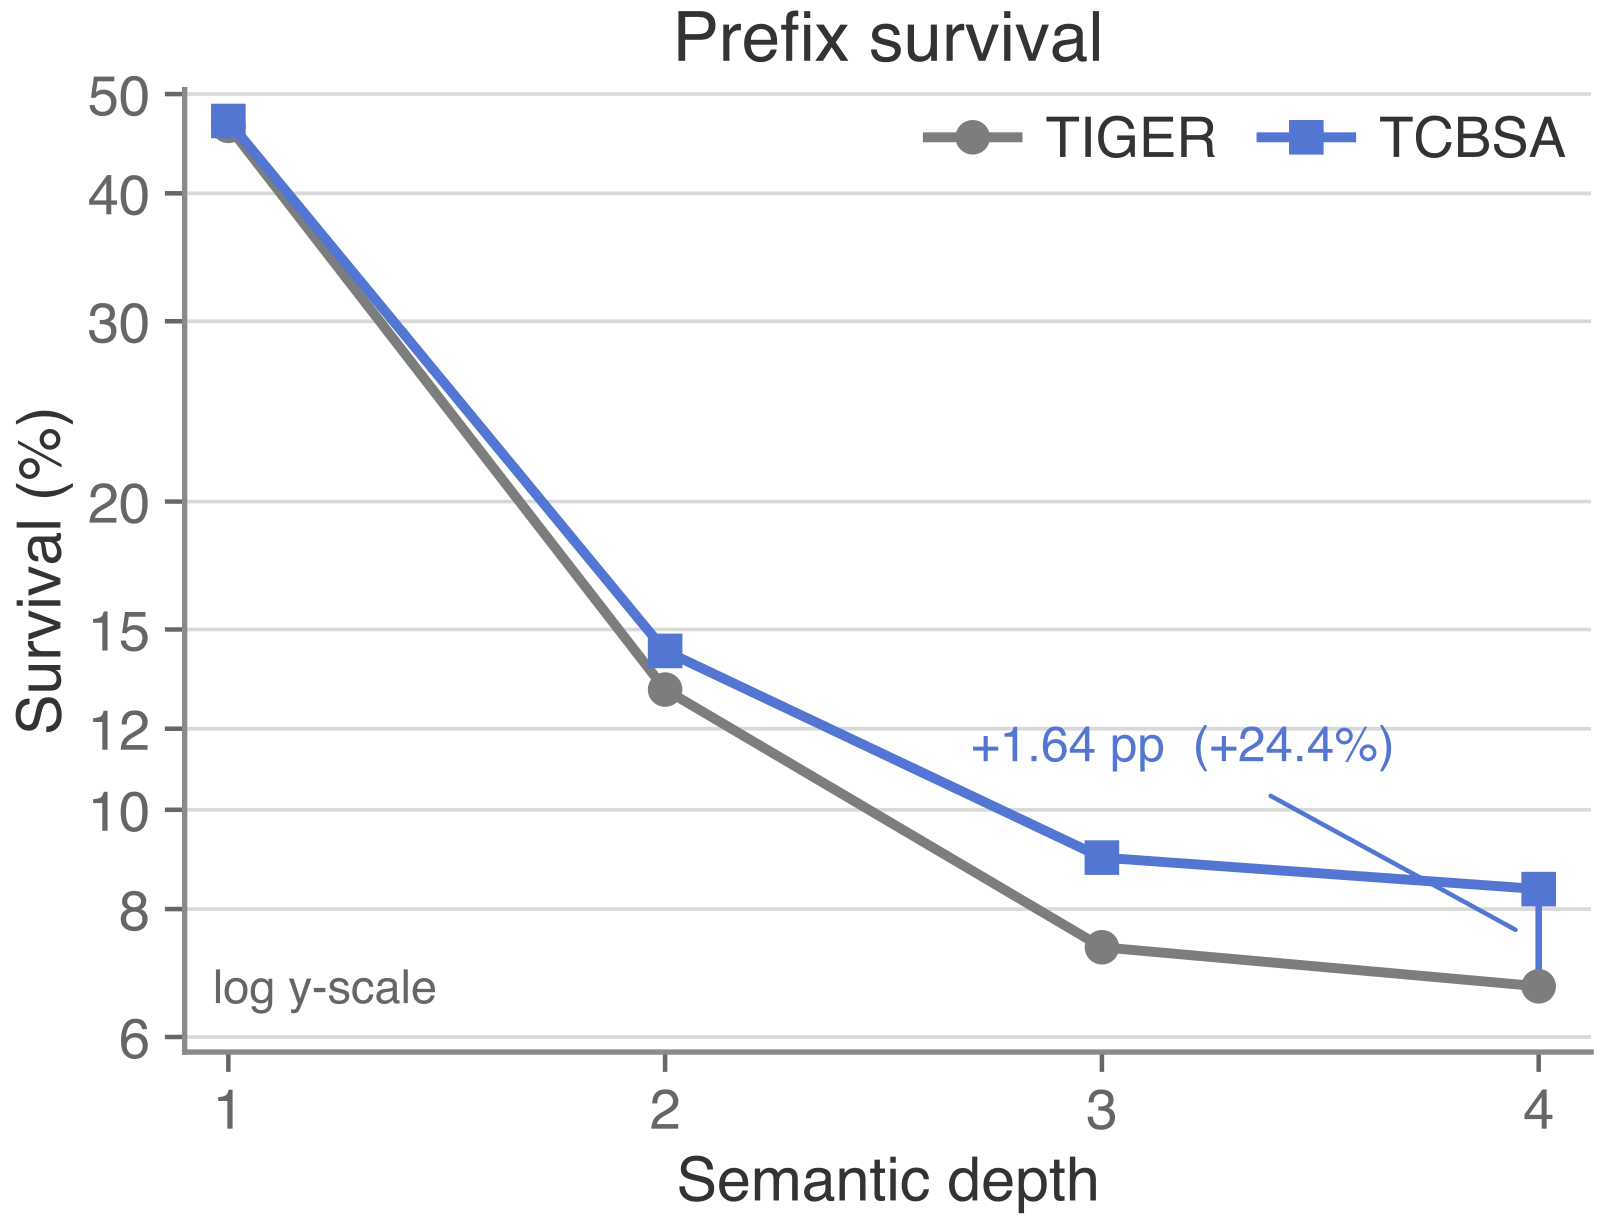
它真的是靠“保住前缀”起作用的吗?作者在 Yelp 上追踪了解码过程。到最后一层,目标前缀的存活率从 6.72% 提到 8.37%。原始 TIGER 第一次剪掉目标前缀的 28,385 个样本里,TCBSA 在同一步救回了 2,163 个,其中 985 个一直保留到完整编码,632 个最终进了前 10 名。被救回的 token,在生成模型自己的排序里中位数是第 22 名,56.68% 排在原始前 20 名之外。这说明加分确实把生成模型原本看不上的分支拉了回来。代价也有:它让 12.68% 原本能活过第一层的目标前缀被挤掉了,但前 10 名命中的总数从 1,393 增加到 1,738,净多 345 个。
共享前缀的作用是真的吗?作者做了一个干预实验:对那些不在 SASRec 前 500 名里、却被 TCBSA 推荐对了的商品,把它自己编码路径上的加分去掉重跑。在 Office 上,532 个这样的命中里丢了 29.89%;作为对照,去掉强度相当、但不在目标路径上的加分,只丢了 0.04%。这说明这些命中确实来自和前 R 名商品共用前缀带来的加分,而不是巧合。
置信度开关有没有用?去掉开关、对所有用户都用最大力度,NDCG@10 下降 1.88% 到 9.08%。几种合成方式(平均、最大值等)之间差别不到 2%,合成方式不太敏感,开关才是关键。
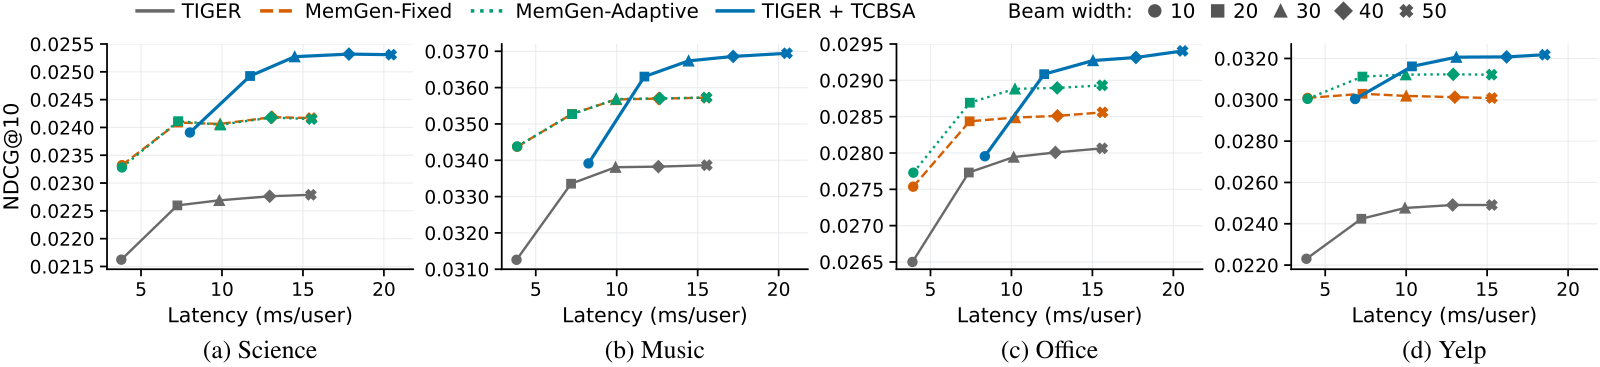
最后是延迟。在同样的 beam 宽度 20 下,TCBSA 的延迟是 TIGER 的 1.43 到 1.63 倍,因为多了一次打分模型给全库打分。但如果和“把 beam 开大”比,它更划算:beam 20 的 TCBSA 比 beam 50 的 TIGER 更准,延迟还低 22.95% 到 32.27%,说明多花的那点打分时间,比把 beam 加宽一倍多要便宜。剪枝丢掉的东西,靠更聪明地排序比靠更宽的 beam 便宜。
我认为它的局限
第一,线上要多跑一个全库打分。论文的延迟是在 RTX 5880 显卡上、每批 32 个用户测的,同宽度下是原来的 1.43 到 1.63 倍。实验里最大的商品库只有约 7.8 万件(Office),线上几百万到上亿商品时,全库打分加取前 500 名的成本会明显上升,通常要换成近似检索,这时候加分信号会不会变弱,要自己在大库上实测。
第二,增益很依赖打分模型和生成模型的差距。TIGER 在 Yelp 上本来就弱,NDCG@10 提高 30.4%;MiniOneRec 在 Office 上只提高 2.3%。如果你的生成模型已经比打分模型强很多,能借到的信号就少。
第三,实验全是离线的公开数据集,商品编码也只有 4 位。层数更多、每层候选更多的编码,剪枝更频繁,TCBSA 的收益可能更大,也可能因为加分被摊得更薄而变小,只能在自己的编码上跑一遍才知道。
一个推荐团队可以怎么试
- 先离线诊断:在现有生成式召回上记录目标商品的前缀在每一层的存活率,看是不是大量在前一两层就被剪掉。如果存活率本来就高,这个方法没有可救的东西。
- 用现成的序列打分模型(比如已经在线上的 SASRec 类召回)做 TCBSA 的最小版本:只加分差摊边和固定系数,不加置信度开关,比较同 beam 宽度下的召回率。
- 有效再加置信度开关。论文里去掉开关最多掉 9% 的 NDCG@10,开关的三个参数只需要在验证集上扫一遍。
- 最后测延迟:和“把 beam 开大到同样耗时”比,而不是和原始 beam 比,这才是上线时真正的对照。
一句话结论
生成式推荐的剪枝损失,可以在不改模型的情况下,用一个现成的打分模型在解码中途补回来,关键是在剪枝之前、而不是出完列表之后介入。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。Semantic ID 生成式召回上线后普遍要面对 beam 剪枝丢商品的问题 |
| 方法创新性 | 中高。把商品分数摊到编码前缀上的做法简单,但切中了两类模型接不上的地方 |
| 实验证据 | 中高。4 个数据集、3 种模型组合,有解码追踪和干预对照;全部是离线实验 |
| 工程成本 | 中。不用训练,但要多一次全库打分,同 beam 宽度下延迟约 1.4 到 1.6 倍 |
| 是否值得尝试 | 值得。已有生成式召回和传统召回并存的团队,可以用几天时间离线验证 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…