目录 · 9 节
1它要解决什么问题?2整体结构3机制一:按频率截断的编码4机制二:长度和内容分开预测5机制三:按长度分配名额再统一排序6实验结果7我认为它的局限8一个生成式推荐团队可以怎么试9一句话结论
多数生成式推荐给所有物品同样长度的 SID,热门物品反复为细粒度编码付出成本,缩短编码又会压缩长尾物品的语义。JevRec 借鉴自然语言里常用词更短的规律:先用残差量化给每个物品编出 4 级编码。每一级各有一张向量表(论文叫码本),先在第一张表里找离物品向量最近的一项、记下序号,剩下的误差再到下一张表里找,所以前几级描述大类,越往后越细,这几张表所有物品共用。它按训练集交互频率把物品排序分组,越热门的组截掉越多末尾的细粒度编码,长尾物品保留完整描述;同一组里截短后前缀相同的物品,末尾再各补一个不同的编号(防冲突编码),保证每个物品唯一。它还用一个单独的输出头先预测长度、再按长度生成内容,减少两个目标在同一个输出头上的梯度冲突。在三个 Amazon 公开数据集上,它在 Recall@5、Recall@10、NDCG@5、NDCG@10 共 12 个指标上都超过最强基线,这 12 个相对提升平均为 6.52%,相对 TIGER 平均为 12.04%,每轮训练时间比 TIGER 短约 16%,推理也更快。
做生成式推荐的团队值得读这篇,主要是它把 SID 长度从一个全局超参数变成了每个物品自己的属性,而且消融实验把收益来源拆得比较清楚:按频率分配长度才有用,随机分配长度只拿到一小部分收益,反过来给热门物品长编码反而更差。需要留意的是,实验规模很小,模型只有 4 层、隐藏维度 128,物品数在 2.5 万左右,基线结果大多直接引用前人论文,在千万级物品库和更大模型上是否成立还需要自己验证。
它要解决什么问题?
生成式推荐逐个 token 生成下一个物品的 SID。常见做法是用残差量化把物品文本向量切成几级编码,前几级是粗粒度的类别,后几级越来越细,最后再加一个防冲突编码区分剩下仍然重名的物品。几乎所有方法都给每个物品同样的长度,比如三级语义编码加一个防冲突编码,一共四个 token。
问题出在交互分布极不均匀。下面用一个游戏商店的例子说明(示意):
| 物品 | 训练集交互次数 | 固定长度方案 | 问题 |
|---|---|---|---|
| 一款大热的开放世界游戏 | 2,000 次 | 4 个 token | 每次出现在用户历史和训练目标里都要花 4 个 token,细粒度编码被重复计算 2,000 次 |
| 一款中等热度的策略游戏 | 25 次 | 4 个 token | 长度刚好合适 |
| 一款小众动作游戏 | 7 次 | 4 个 token | 交互太少,协同信号很弱,本该靠更细的内容描述来补,却和热门物品一样只有 4 个 token |
想省成本把所有物品都缩短到 3 个 token,长尾物品的语义也一起被压缩了。想给长尾物品更多描述,所有物品都得变长,热门物品的成本更高。固定长度把“整个物品库需要多少语义细节”和“实际交互中要付出多少编码成本”绑在了同一个数字上。
自然语言早就处理过这个矛盾:常用词短,比如 I 和 you,不常用的词长,比如 international。语言没有把所有词都缩短,而是只让高频表达变便宜,同时保留丰富的词汇。JevRec 就是把这个思路搬到物品编码上。
整体结构
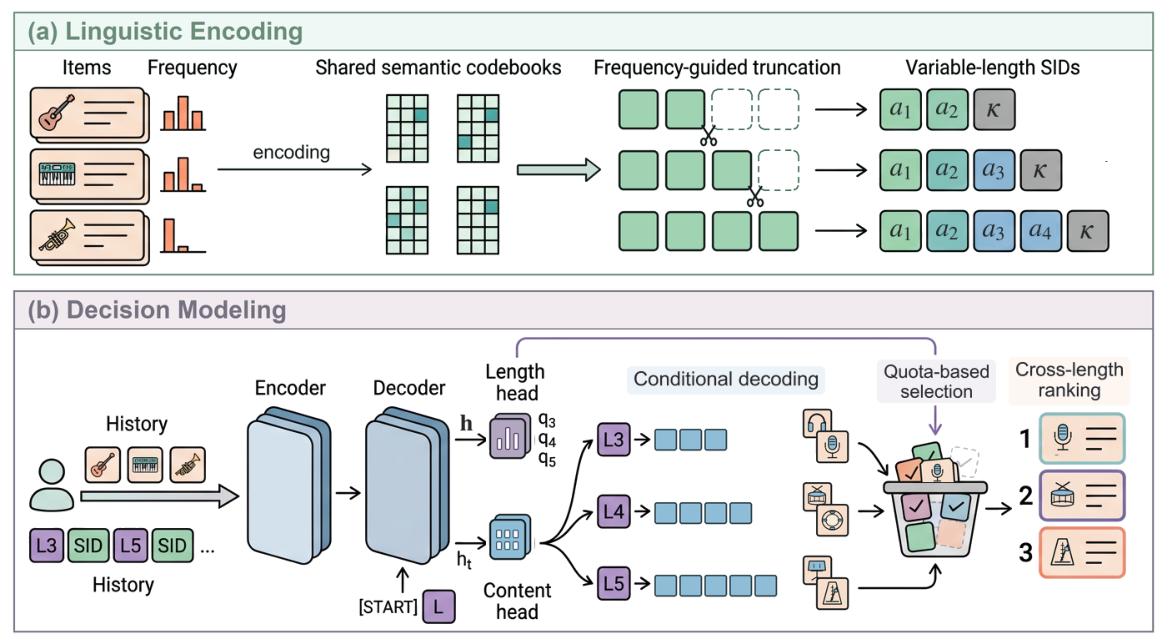
| 环节 | 做什么 |
|---|---|
| 分组 | 按训练集交互次数给物品排序,切成 N 组,默认 3 组,约 44.6%、35.2%、20.2% 的物品分别进入高、中、低频组 |
| 编码 | 用 sentence-t5 编码物品文本,拟合一个 4 级残差量化器,所有组共用;高频组保留前 2 级、中频 3 级、低频 4 级,各自补一个防冲突编码,总长度为 3、4、5 |
| 序列格式 | 用户历史里每个物品前面加一个长度标记,告诉模型接下来几个 token 属于这个物品 |
| 长度头 | 一个三层小网络,读入历史表示和每个候选长度的嵌入,输出 3 种长度的概率 |
| 内容头 | 原本的 T5 输出层,在给定长度标记之后逐个生成编码 |
| 推理 | 每种长度各跑一次束搜索,按长度概率分配名额,最后用“长度概率 × 内容概率”统一排序 |
模型本身很小:编码器和解码器各 4 层,隐藏维度 128,在两张 H20 上训练 200 轮。
机制一:按频率截断的编码
关键是所有物品共用一套码本。残差量化的特点是前面的编码描述大方向,后面的编码在前面的基础上补细节。所以截掉末尾几级,相当于用更粗的粒度描述同一个物品,不需要为每个频率组单独学一套语义空间。
论文的案例直接展示了效果。三款游戏的编码如下:
| 游戏 | 训练集交互次数 | 所在组 | SID | 长度 |
|---|---|---|---|---|
| Grand Theft Auto V | 2,142 | 高频 | 36, 352, 1028 | 3 |
| Warcraft III: The Frozen Throne | 25 | 中频 | 77, 412, 558, 1026 | 4 |
| Sekiro: Shadows Die Twice | 7 | 低频 | 23, 463, 514, 789, 1026 | 5 |
每串最后一个数字是防冲突编码。截断以后,同一个组里可能有好几个物品前缀完全相同,防冲突编码在组内给它们编号,保证每个物品的完整 SID 唯一。防冲突编码可以跨前缀复用,因为唯一性看的是整串。
分组按物品数量比例切,不按交互次数阈值切。原因是长尾分布下,如果按“交互超过 100 次算热门”这种绝对阈值,绝大多数物品会落进最长那一组,短编码组几乎是空的。作者的做法是取形状参数为 2.1 的伽马分布,在 1、2、3 三个整数点上算概率密度,再归一化成比例。三个点的密度约为 0.368、0.290、0.167,因为三者之和约 0.825,所以归一化后分别是 44.6%、35.2%、20.2%,这就是三个组的物品占比。排好序的物品清单按这个比例从头到尾依次切开。形状参数越小,切给短编码组的物品越多。同一套设置用在三个数据集上。
机制二:长度和内容分开预测
编码长度不一以后,模型要先决定下一个物品是几个 token,再生成具体编码。最直接的做法是把长度标记当作普通 token,让同一个输出层先预测长度标记、再预测编码。作者认为这两件事性质不同:长度是对整个物品的一次三选一判断,内容是逐个 token 的细粒度生成。每个训练样本只有 1 个长度标签,却有 3 到 5 个内容标签,共用输出层时训练会偏向内容。
他们测了两个目标在共享参数上的梯度方向。具体做法是在训练第 5 到 135 轮之间取 27 个检查点,每个检查点算 48 个批次里长度损失和内容损失梯度的余弦相似度,负值表示两个目标在往相反方向拉。
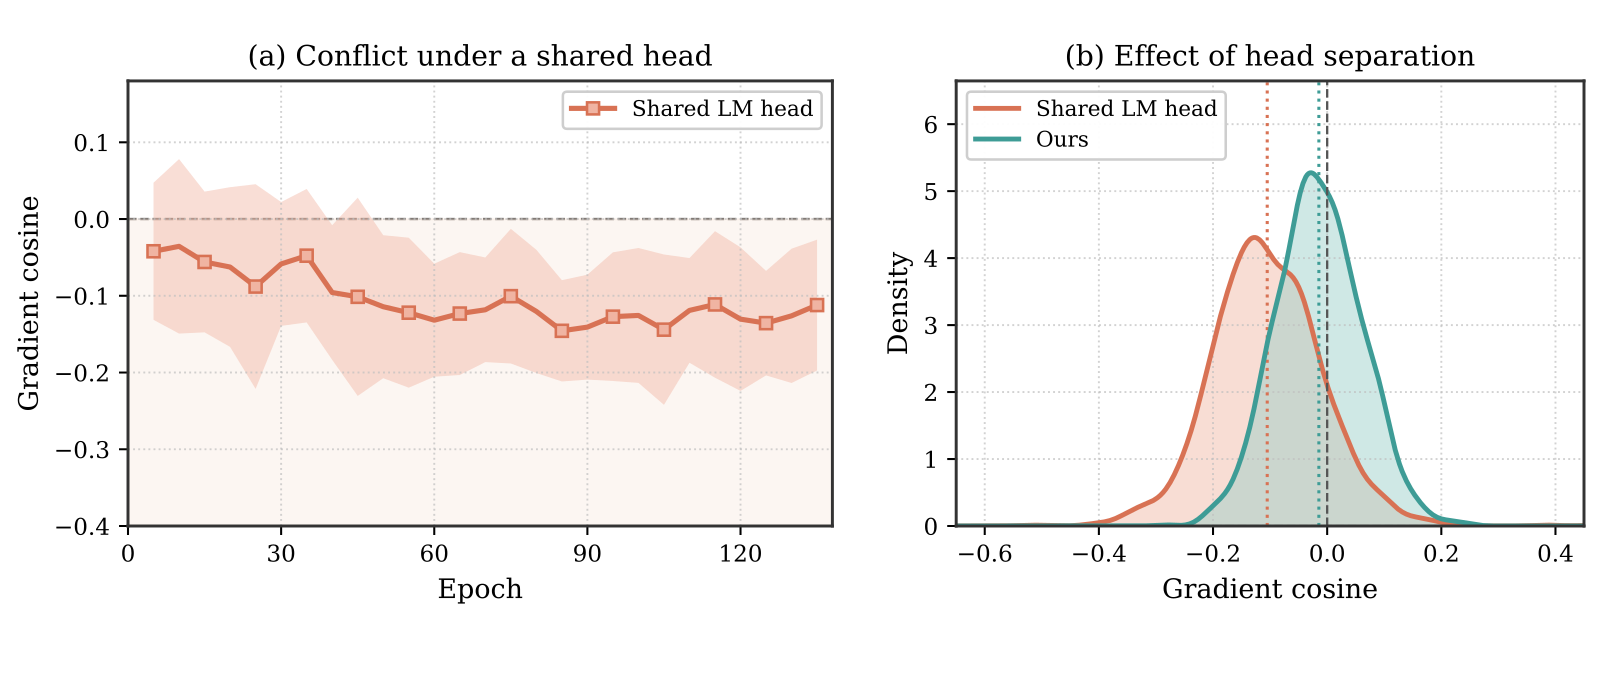
共用输出层时,平均余弦在每个记录的检查点都是负的,训练过程中没有自己恢复一致。换成两个输出头后,平均值从 -0.105 变成 -0.015,冲突明显减轻,但没有完全消失,因为两个头仍然共用下面的主干。
长度头的设计是把解码器起始位置的状态和每个候选长度的嵌入拼起来,过一个三层小网络打分,三个候选长度的分数一起过一次 softmax,得到三种长度各自的概率。这个长度嵌入和内容生成时用作前缀的长度标记是同一个向量,所以长度头选的东西和内容头接到的条件是对齐的。
机制三:按长度分配名额再统一排序
推理时如果只取最可能的长度,一旦长度判断错了,正确物品就完全进不了列表。JevRec 保留全部长度分支,用长度概率决定每个分支能占几个名额。
举个例子,推荐列表长度为 10,长度头给出三种长度的概率分别是 0.52、0.31、0.17(示意)。先按比例取整数部分,得到 5、3、1,共 9 个名额;剩下 1 个名额给小数部分最大的长度,0.7 最大,所以长度 5 的分支多拿 1 个,最终是 5、3、2。每个分支各自做束搜索,只保留能对应到真实物品的编码,再按内容概率选出各自名额内的物品。
选出来的物品合在一起,按“长度概率 × 内容概率”排序,不同长度的物品可以交错排列。如果某个分支找不到足够的有效物品,空出的名额由其他分支里得分最高的落选者补上。
实验结果
三个数据集来自 Amazon Reviews 2023:乐器、工业与科学、电子游戏,各有约 2.5 万个物品、5 万到 9.5 万个用户。评测用留一法,在全量物品上算 Recall 和 NDCG,不做负采样。下面是和最强的三个生成式基线的对比(Recall@10 / NDCG@10):
| 方法 | 乐器 | 科学 | 游戏 |
|---|---|---|---|
| TIGER(固定长度) | 0.0564 / 0.0306 | 0.0422 / 0.0226 | 0.0868 / 0.0467 |
| LETTER | 0.0580 / 0.0313 | 0.0435 / 0.0232 | 0.0877 / 0.0473 |
| ActionPiece | 0.0615 / 0.0318 | 0.0452 / 0.0236 | 0.0927 / 0.0490 |
| JevRec | 0.0643 / 0.0340 | 0.0486 / 0.0253 | 0.0966 / 0.0514 |
上表只列了 @10,论文完整表格里 @5 和 @10 共 12 个指标全部超过最强基线,论文用配对 t 检验标注了相对最强基线的显著提升。Recall@5 的相对提升在三个数据集上都大于 Recall@10,说明提升集中在列表最前面几位。
消融实验最值得看,因为它回答了“到底是哪部分在起作用”:
| 变体 | 和 JevRec 相比 | 说明 |
|---|---|---|
| 随机分配长度 | 平均低 8.70% | 变长本身不是关键,按频率分配才是 |
| 反过来给热门物品长编码 | 每个指标都比随机分配更差 | 方向反了就有害,支持“热门短、长尾长” |
| 长度和内容共用输出层 | 平均低 7.50% | 分开输出头确实有用 |
| 去掉长度标记 | 这一组里下降最大 | 模型得自己猜物品边界和目标长度 |
| 长度头只看历史 | 每个指标和 JevRec 的相对差距都不到 1% | 关键是把长度单独拿出来预测,具体打分器怎么设计不重要 |
| 不按长度分配名额 | 12 个指标全部下降 | 名额分配让列表构成符合长度分布 |
效率方面,和 TIGER 相比,每轮训练时间平均少 15.75%,三个数据集的测试集推理总时间也都更短。在乐器数据集上,JevRec 的验证集 NDCG@10 在每个检查点都高于 TIGER,最佳点也早 20 轮出现。
超参数方面,论文测了组数 N 从 2 到 5、最短长度 M 从 2 到 5。N 取全部值、M 取 2 到 4 时,NDCG@10 和默认设置相差都不到 3.2%。但 M 超过 3 以后三个数据集的 NDCG@10 都开始下降,从 4 到 5 降得最明显,因为热门物品的编码也被迫变长了,这反过来印证了“热门物品要短”的设计。
我认为它的局限
第一,规模太小。模型只有 4 层、隐藏维度 128,物品库约 2.5 万个,用户历史最多 20 个物品。工业级生成式推荐的物品库通常在千万级以上,编码层级更多,模型也大得多。在那种规模下,热门物品省下的 token 和长度判断带来的额外误差,两者谁更大,现有实验回答不了。
第二,对比条件不完全一致。大部分基线结果直接引用前人论文,消融里的“固定长度”变体也是直接复用 TIGER 的结果,而不是在 JevRec 的代码里只把长度改成固定后重训。另外基线的束宽是 50,JevRec 是每个长度分支 10、一共 30。这些差异不一定偏向某一方,但会让 6.52% 的提升里有多少来自编码设计、有多少来自实现细节变得不好判断。
第三,频率是按训练集一次性算好的。新物品上架时没有交互记录,热门程度也会随时间变化,物品一旦从长尾变热门,它的编码长度就要变,模型里学到的东西也得跟着调整。论文的离线留一评测不会遇到这个问题,线上系统一定会遇到。
一个生成式推荐团队可以怎么试
- 先看自己的分布:统计训练集里前 20% 的热门物品贡献了多少交互,以及固定长度 SID 下用户历史的平均 token 数。热门越集中,按频率缩短编码能省下的越多。
- 在现有残差量化编码上直接做截断实验,不用重训量化器:高频组少保留一级,低频组多保留一级,补上组内防冲突编码,先测离线指标。
- 同时跑一组随机长度作对照。如果按频率分配和随机分配差不多,说明自己场景里的收益可能来自别的因素。
- 加一个单独的长度头,和把长度标记当普通 token 的版本对比;训练时记录两个损失的梯度余弦,看共享输出层下是否真的存在持续冲突。
- 上线前设计好频率漂移的处理:比如按周重新分组,或者只允许物品在相邻长度之间迁移,并评估重新编码对已有模型的影响。
一句话结论
按交互频率给物品分配编码长度,热门短、长尾长,是这篇论文最有说服力的发现:随机变长和反向分配都更差,说明收益来自对齐频率,而不只是让长度可变。
| 维度 | 判断 |
|---|---|
| 问题重要性 | 中高。生成式推荐里编码长度直接影响训练成本和长尾效果 |
| 新意 | 中高。变长 SID 已有人做,按频率分组截断、共用码本加单独长度头的组合是新的 |
| 证据强度 | 中。三个数据集一致提升,消融拆分清楚;但规模小,基线多为引用 |
| 工程成本 | 低到中。编码改造可以复用现有量化器,长度头只是一个小网络,难点在频率漂移 |
| 值不值得试 | 值得在离线实验里先试截断编码和随机长度对照,成本很低 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…