目录 · 8 节
1加一个新目标,为什么要等好几周?2Light Heads 怎么挂上去3为什么要截断梯度,又为什么每次清零?4新头比完整训练的预测头差多少?5线上省了多少时间,带来了什么6我认为它的局限7一个推荐团队可以怎么试8结论
YouTube 这篇工程论文让多任务排序模型加一个新预测目标时,不必再冷启动重训大模型,也不必等几十个实验模型逐个补上新预测。核心思想一句话:新目标不进主模型,而是做成一个挂在共享层上面的小预测头(论文叫 Light Head),它只读共享层的输出、不往下传梯度、每次训练开始时清零重学,所有排序模型从同一份配置里读到它。用上这套框架后,排序模型加下游模型的一轮完整实验周期从 24 天缩到 11 天,其中联合实验最早能开始的时间从第 17 天提前到第 5 天(下游模型和联合实验的含义见下一节)。代价是点击这类数据多的任务,AUC 比完整训练的预测头低约 0.01。已有持续训练流水线的推荐团队可以直接借鉴。
加一个新目标,为什么要等好几周?
先说清楚“下游模型”。YouTube 的排序模型对每个视频输出一组预测,比如点击概率、互动率、正面反馈概率;后面还有一个模型(论文举的是学出来的奖励模型或打分融合层)拿这组预测当输入,算出最终排序分。下游模型训练和上线都要求输入的这组预测前后一致。传统做法下,只有少数带新任务的实验模型会输出新预测,下游模型要等这些实验攒够日志才能训练;上线时其余几十个实验模型又没有这个预测,输入就会时有时无。
设想一个团队想加一个“看完后会不会再来”的新目标(示意)。传统做法分四步,见下表:
| 步骤(示意) | 做什么 | 为什么慢 |
|---|---|---|
| 1 | 给排序模型加新预测头,从头训练 | 大模型冷启动要一周到几周 |
| 2 | 新模型上 A/B 实验,记录新预测 | 几十个实验分流量,单个实验的样本少 |
| 3 | 用这些记录训练下游模型 | 要等数据攒够 |
| 4 | 排序模型和下游模型一起做联合实验 | 前三步都完成才能开始 |
图 4 上半部分就是这条时间线,总共 24 天。实验证明有效之后还有更长的一段:线上同时跑着几十个实验模型,它们都得补上这个新预测头,下游模型才能在全量流量上用它,论文说这一步要两到三个月。
除了时间,还有一个风险:新目标和老目标共用底层,如果两个目标方向不一致,新目标的梯度会把共享层往别处拉,老目标反而变差。
Light Heads 怎么挂上去
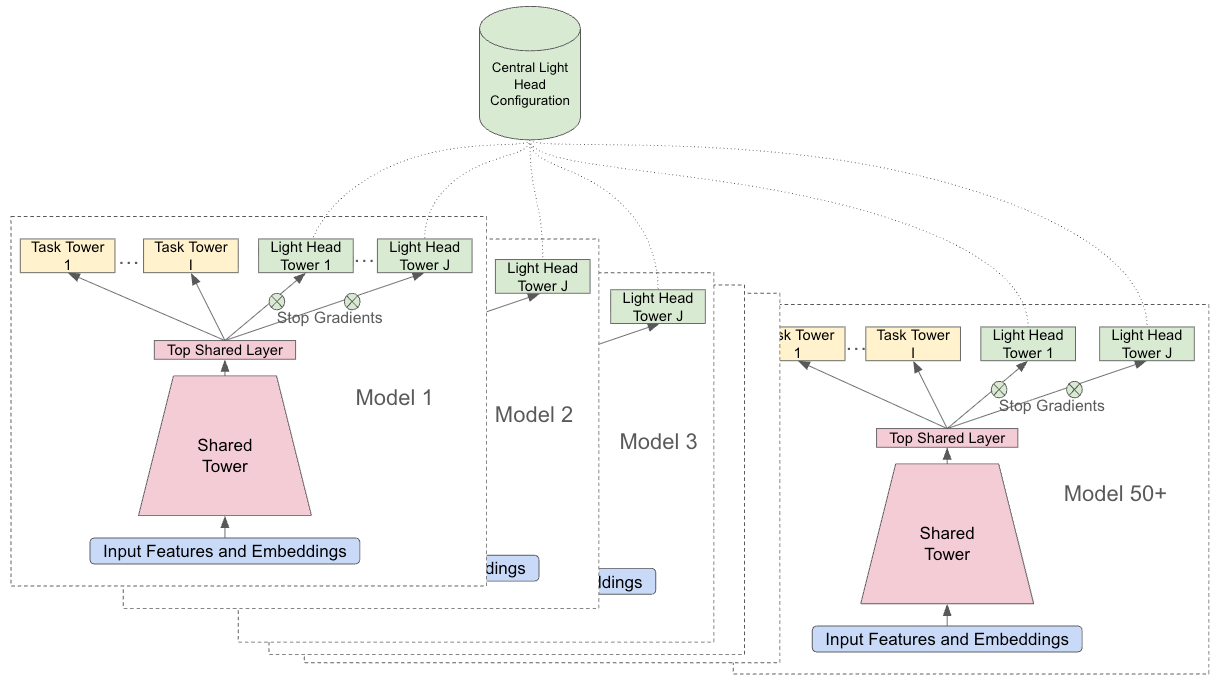
整套框架只有两部分:一份独立于模型代码的中央配置,以及每个模型里读配置、把预测头插进计算图的一小段代码。配置里写清这个头的标签、损失函数、激活函数、是分类还是回归、监控哪些指标,还可以加采样或样本加权的函数。新目标的标签可以是日志里已有的字段,也可以由单独的数据生成任务算出新标签,再和原有训练数据拼在一起。模型在持续训练的过程中读这份配置,把新头插在和原有预测头同一层,下面的共享层照常由原有目标训练,只是不受新头影响。
数据流按顺序是这样的:
- 研究员在中央配置里写一个新头。
- 每个排序模型在下一次训练开始时读配置,把这个浅层小网络(几层隐藏层)接到共享层的输出上。
- 训练时,新头只更新自己的几层参数,共享层收不到它的梯度。
- 训练跑完才导出模型上线。上线的各个模型都开始输出并记录这个新预测,新数据从多个模型同时积累,攒够下游训练数据比只靠一个新模型快得多;还没带这个头的旧模型返回默认值。
下面逐个说为什么要这几个设计。
为什么要截断梯度,又为什么每次清零?
截断梯度(stop-gradient)解决的是新老目标打架。新头的梯度进不了共享层,老目标的效果就碰不到。论文把它类比成 LoRA 和 adapter:底座冻住,只训上面加的小模块。区别在于这里的底座并没有冻住,共享层照常被老目标训练,只是不受新头影响。
清零重学解决的是另一件事:同一个头在不同模型里要表现一致。线上有新模型也有跑了很久的老模型。如果新头的参数一直保留,老模型里的头训练得更久,新模型里的头训练得更少,同一个预测在不同模型里质量不同,下游模型就没法放心混着用。Light Heads 不保存这个头的 checkpoint,每次训练开始都从随机初始化重来。
清零能行,靠的是两个条件同时成立:头很浅,梯度又不往下走,所以一次训练之内就能收敛。在这套系统里,一次训练是一个定时任务,处理最新一段日志。新头在这次训练开头的几步之内就回到原来的水平,之后的步数都在继续训练一个已经收敛的头,图 3 就是这种曲线。
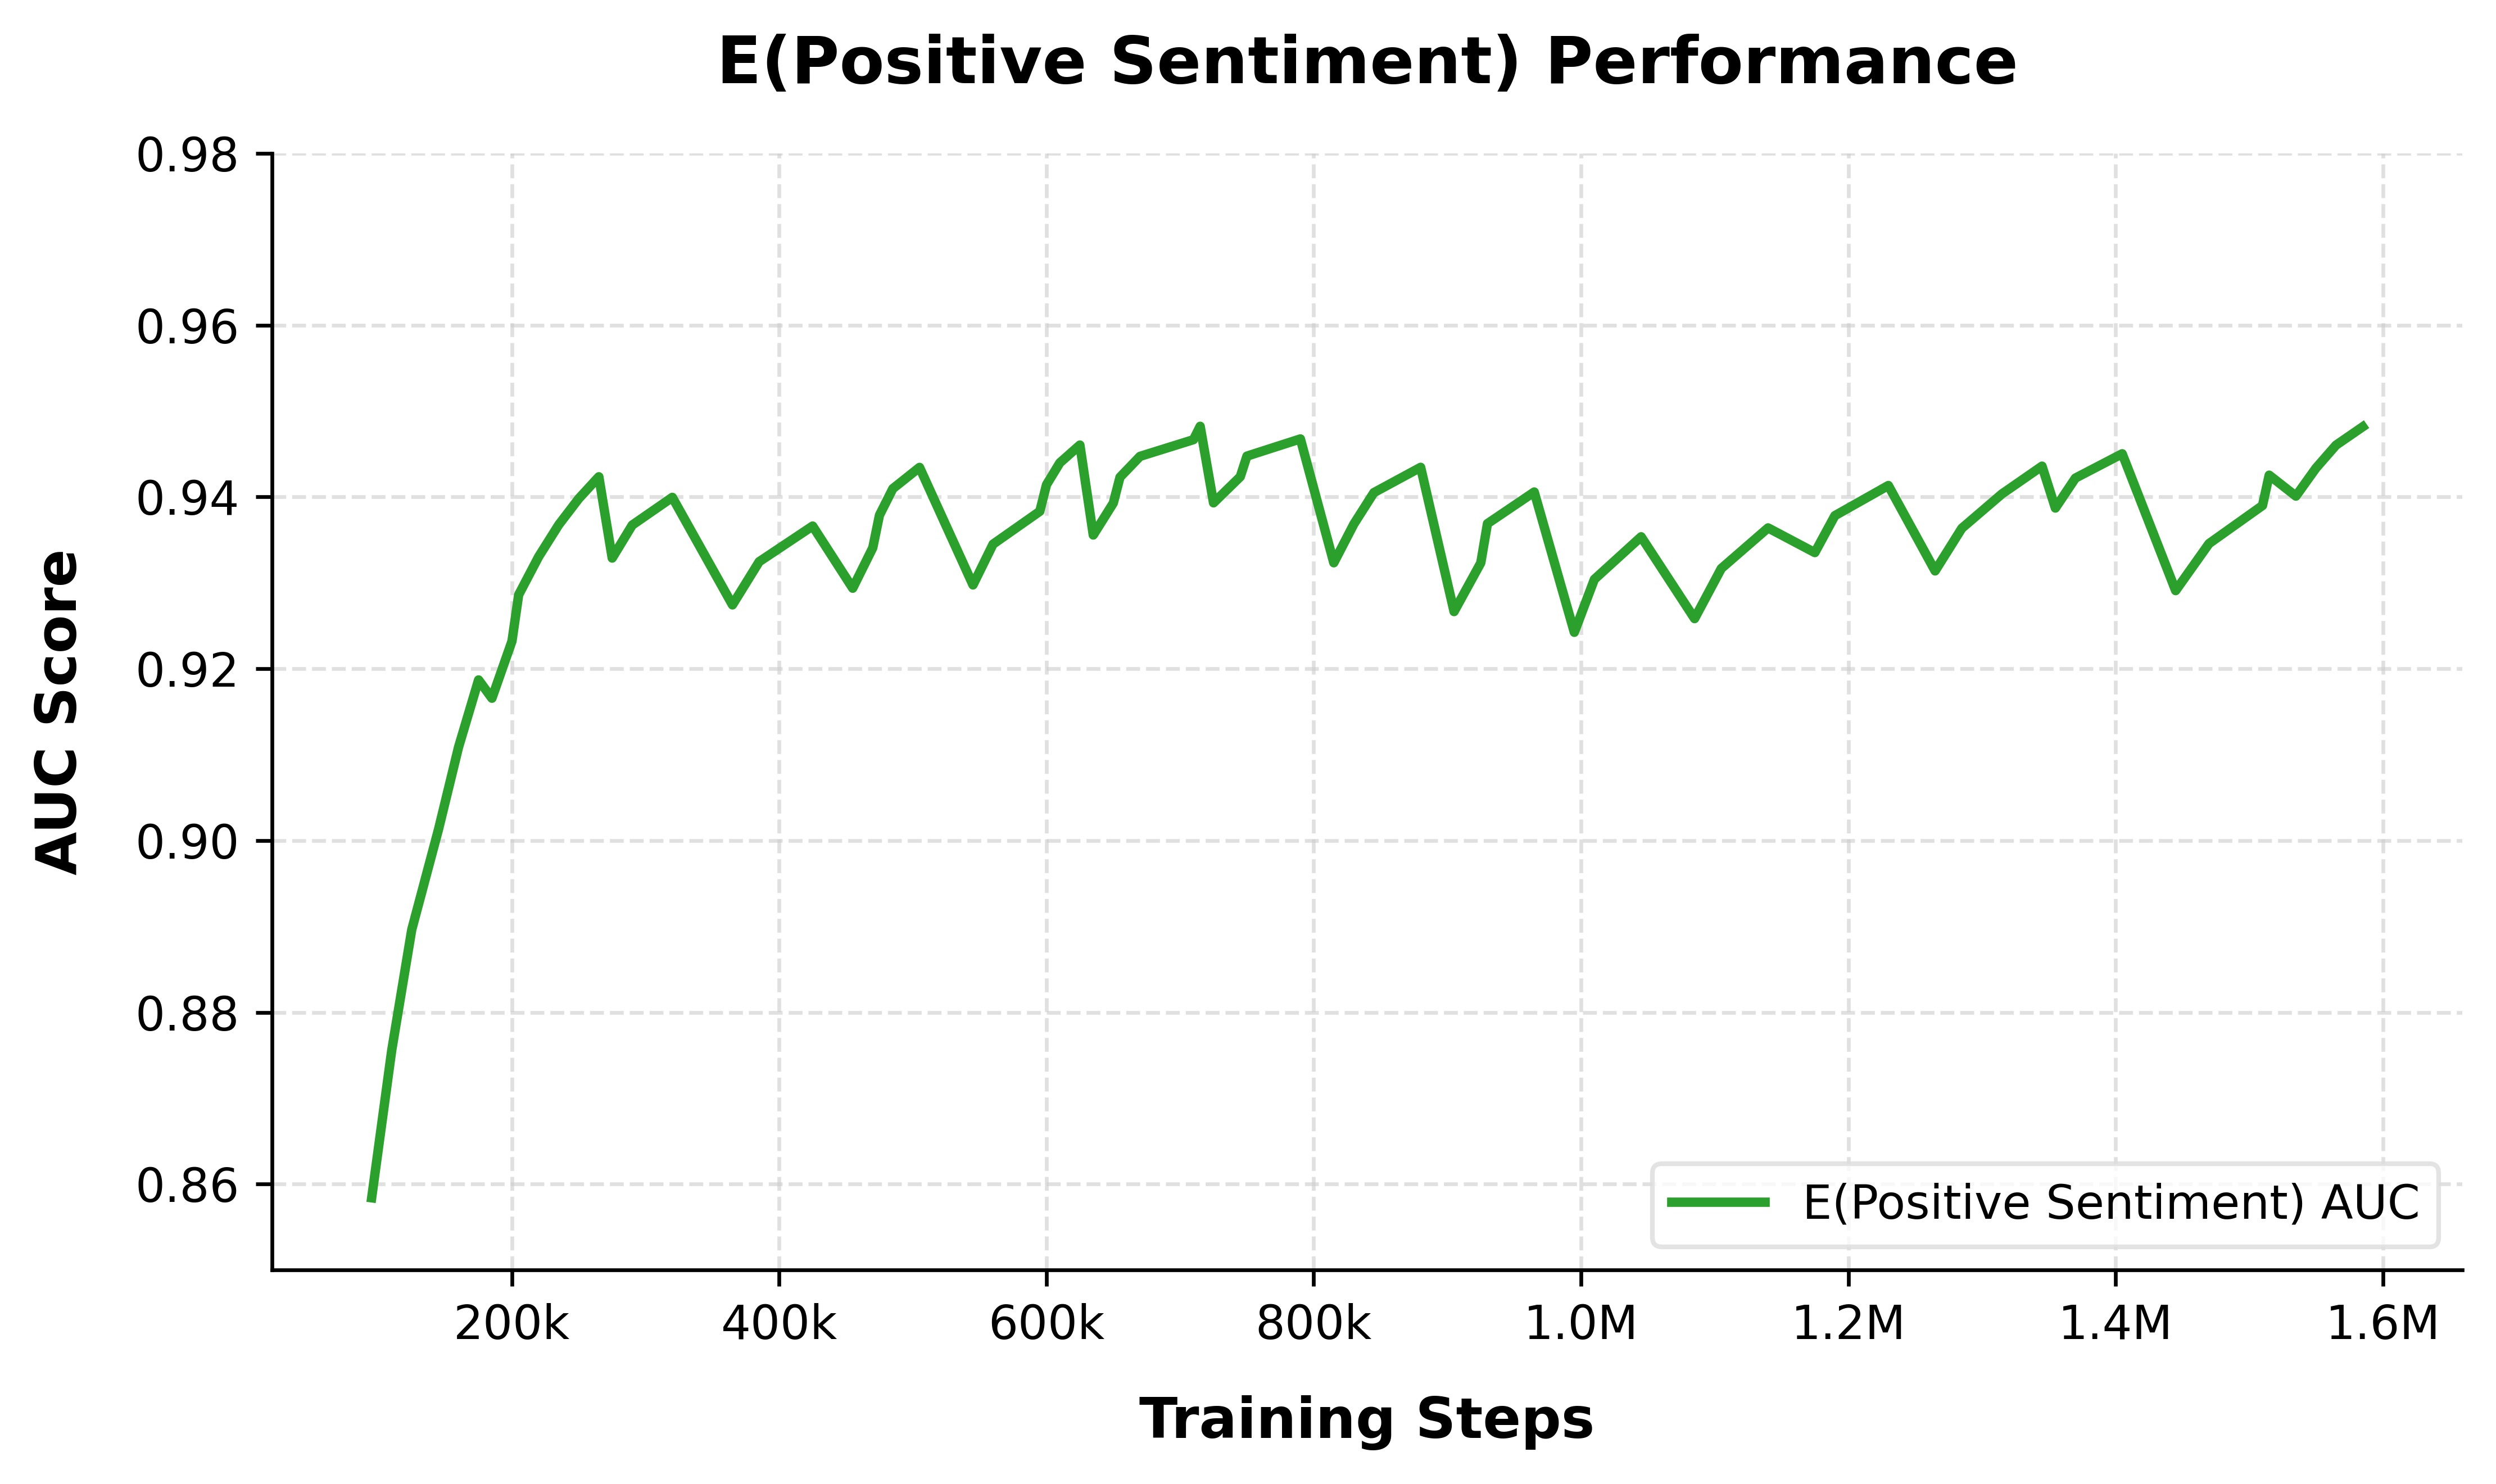
线上质量为什么不受影响?因为模型要整次训练跑完才导出上线,这时新头早已收敛。另一面是,新头在很大程度上依赖共享层学到的表征,共享层变好,新头也跟着变好。
新头比完整训练的预测头差多少?
实验在 YouTube 首页和“接着看”(Watch Next)两个排序模型上做。完整预测头从第 0 步起和模型一起训练、梯度回传;Light Head 从第 120 万步才加进来,截断梯度、每次清零。
| 预测目标 | 完整预测头 | Light Head |
|---|---|---|
| 点击率 P(CTR),AUC | 0.781 | 0.772 |
| 正面反馈 E(Positive Sentiment),AUC | 0.9557 | 0.9553 |
| 互动率 E(Interaction Rate),AUC | 0.9794 | 0.9704 |
| 互动量 E(Engagement),RMSE | 0.9673 | 0.9675 |
表格里的差距集中在样本多的任务上。点击率这种任务,完整预测头能把共享层也往自己需要的方向训练,Light Head 只能用现成的表征,所以 AUC 低了约 0.01。正面反馈这种样本少的任务,两者几乎一样,因为共享层本来就为其他目标学了足够通用的表征。论文还测了两个没有对应完整头的新目标,“会不会再来”的 AUC 是 0.8523,“会不会分享”是 0.9224,说明对和现有目标性质相近的新目标,共享层的表征也够用;论文也提醒这两个目标和已有任务性质相似,而且没有完整头可比。
截断梯度是不是真的必要?去掉之后,主模型原有的预测头变差了,点击率 AUC 从 0.7767 掉到 0.7704,说明新头的梯度确实在伤害老目标。Light Head 自己也变差了,它的点击率 AUC 从 0.7667 降到 0.7584。共享层被新目标拉偏后,建在它上面的头也会跟着变差,被测的主模型预测头和部分 Light Head 都是这样,这正是论文说的目标冲突。
清零有没有代价?有一点。点击率 AUC 清零时 0.764、不清零 0.7646,正面反馈清零时 0.9508、不清零 0.952;样本少的正面反馈提升更多,所以框架允许对样本特别少的头关掉清零,保留参数接着训。
线上省了多少时间,带来了什么
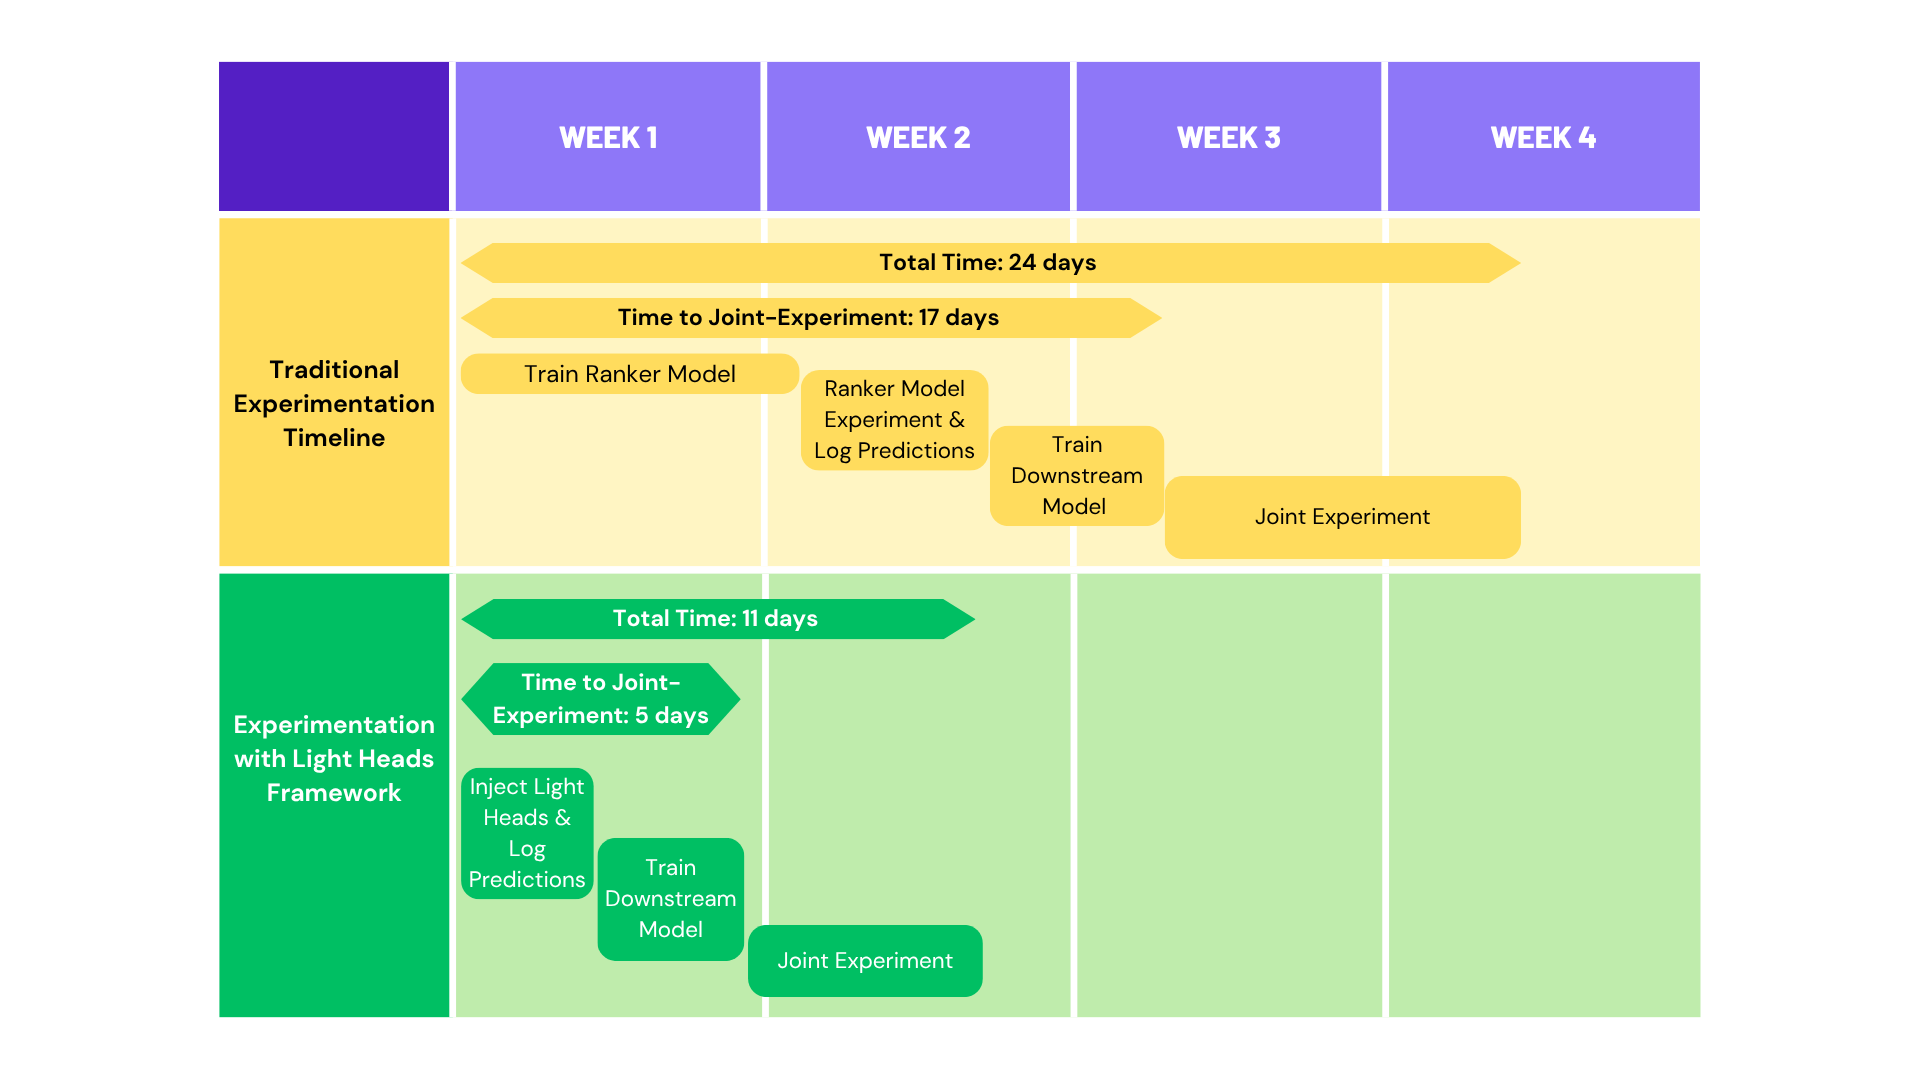
时间主要省在两处。排序模型不用冷启动,新头注入持续训练的模型后最快一天就能上线。所有模型和所有实验都在输出新预测,下游模型的训练数据一下子多了很多,不用等一个实验的少量流量慢慢攒。上线环节也一样,原来两到三个月的补头时间可以缩到几天。
两个上线案例:一个优化长期回报的头,让整体互动提升 0.03%(p<0.05),低质量曝光减少 0.40%;一个专门面向 Primetime 付费频道订阅用户的头,让这部分用户的相关互动提升 13.83%。Primetime 这个案例对应论文说的另一个用处(§3.2):主模型在大盘数据上训练,加权小众数据会伤大盘指标;Light Head 可以只用这一块数据训练,不碰共享层。
为了让这种全局注入在生产上安全,论文还做了三件事:配置只在每次训练开始时读一次,中途改动等下次训练再生效;上线前自动评估所有头,包括新头;某个模型还没读到新配置时,下游拿到的是预先设好的默认值。
我认为它的局限
第一,代价集中在最重要的任务上。点击率是排序里分量最大的目标之一,Light Head 的 AUC 比完整头低 0.009。论文的取舍是用这点精度换时间,并且说成功的 Light Head 通常就留在线上,不再升级成完整头。对精度极敏感的主目标,这个取舍未必合适。
第二,依赖持续训练。新头每次都从随机参数开始,必须在导出上线前的同一次训练里收敛,所以需要一条持续训练流水线:模型按定时任务不断用最新日志接着训,配置也能在训练时动态读入。论文明确说,只做低频批量训练、没有这种流水线的系统不适用这种清零做法。
第三,证据大多来自离线 AUC 的对比,而且各张表的实验做于不同时间,绝对数值不能横向比,只能看同一张表里两列的差。线上收益只有两个案例,没有更系统的统计。
一个推荐团队可以怎么试
- 先选一个样本少、但和现有目标性质相近的新目标,比如分享或收藏,在现有多任务模型上加一个截断梯度的浅层头,和完整预测头对比 AUC。样本少的任务最可能接近持平,适合先验证共享层够不够用。
- 再测清零:同一个头分别清零和保留参数,看收敛需要多少步。如果一次训练的步数不够收敛,就只能保留参数。
- 有效之后再做中央配置,让多个排序模型同时输出这个预测,统计下游模型训练数据的积累速度是否明显加快。这一步的收益取决于你的系统有多少个并行实验模型,单阶段推荐收益有限。
- 最后用它去做联合实验,对比实验周期是否像论文一样缩短一半以上。
结论
最值得带走的一点:加新目标慢,不只慢在大模型冷启动重训,更慢在要等全体模型输出同一组预测、下游数据攒够。Light Heads 用一份配置让所有模型同时输出同一个新预测,把这个等待基本去掉了。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。多阶段推荐系统里加目标慢是普遍痛点,论文给出了 24 天和 17 天这样的具体代价 |
| 方法创新性 | 中。截断梯度和小预测头都不新,新在每次清零加中央配置,让同一个头在所有模型里一致 |
| 实验证据 | 中。离线对比和消融清楚,线上只有两个案例,各表数据来自不同时间 |
| 工程成本 | 中低。主要是配置读取和监控代码,前提是已有持续训练流水线 |
| 是否值得尝试 | 值得。有多个并行实验模型和下游融合模型的团队收益最大 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
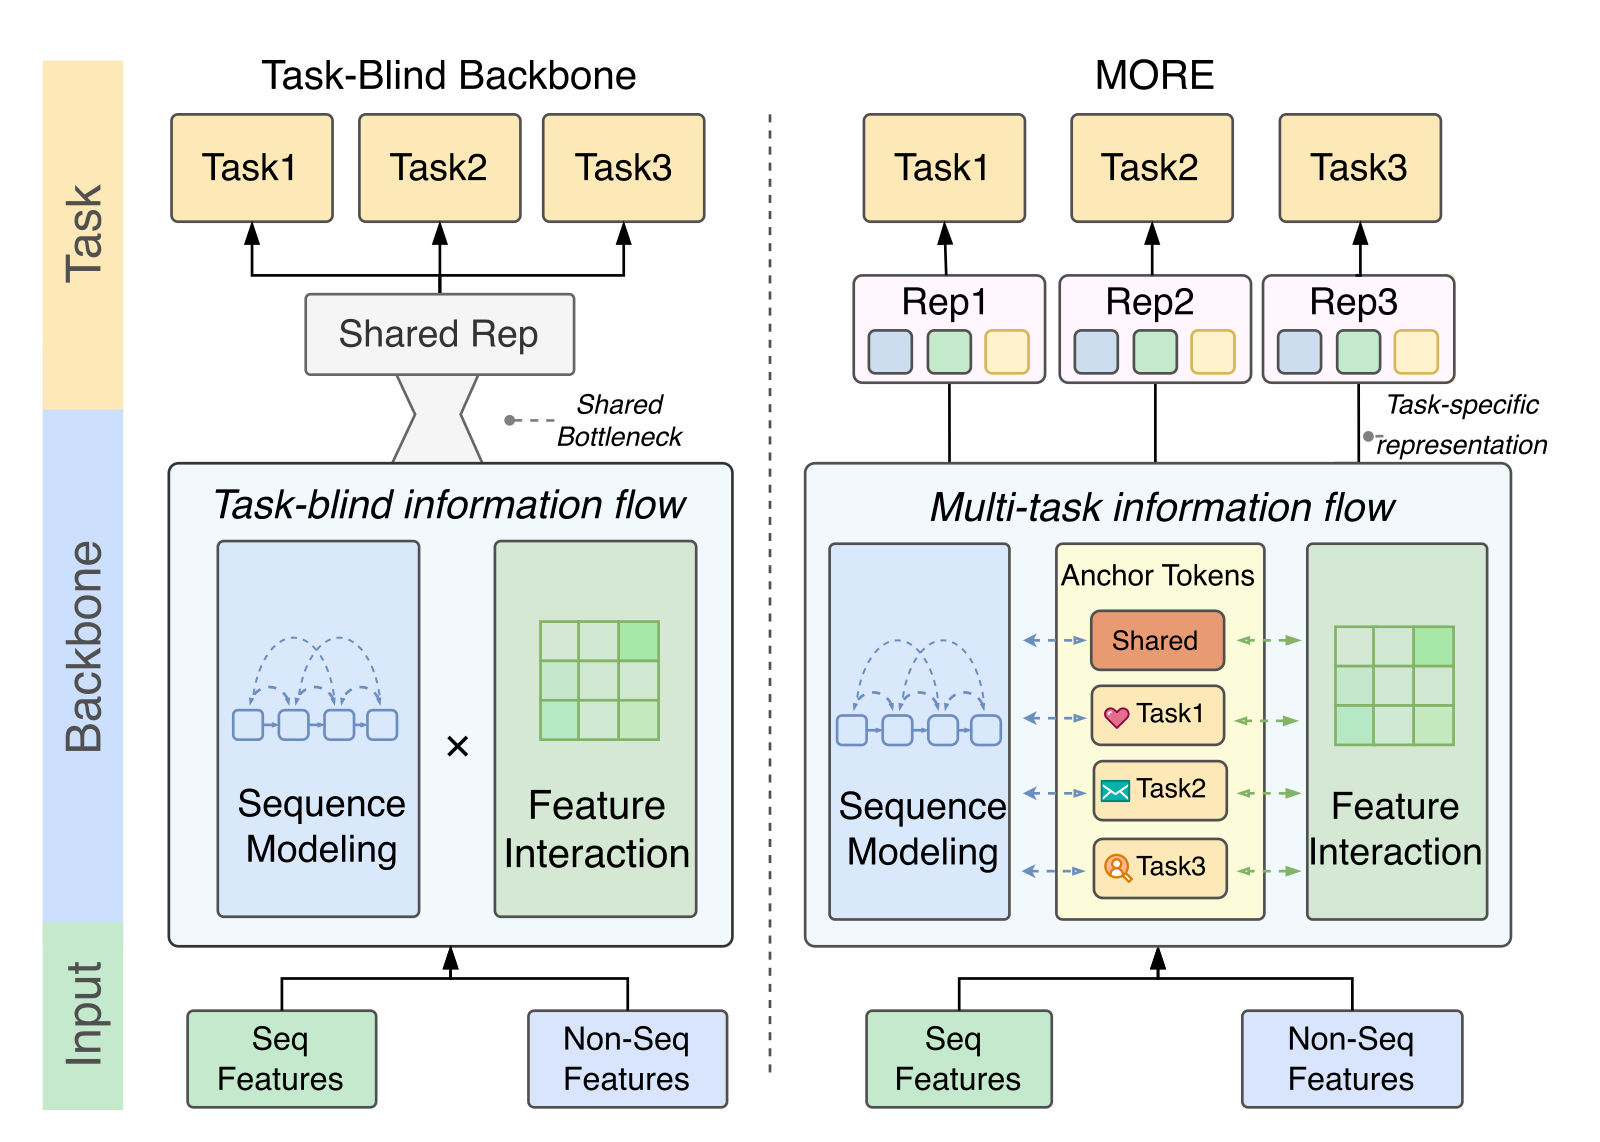 Personalization · 2026-09-10Task-Blind No MORE: Multi-Task Information Flow in Unified Ranking Backbones多任务精排里,常见的统一骨干让所有任务共用前面每一层,只在最后的预测塔才分开,点击和深聊这类差别很大的目标被迫共享同一套中间表示。陌陌的这篇论文在骨干里放一组随层更新的小向量,几个由所有任务共用,每个任务再各有一个。每个任务的小向量从第一层起就用自己的注意力参数读行为历史,彼此之间用掩码隔开,避免互相串信号。离线七个任务都超过三种统一骨干,两周线上实验里使用时长提升 3.0%。
 Personalization · 2026-10-24A Framework for Value-Aligned Modeling and Robust ExperimentationGoogle Discover 广告团队的模型迭代里,离线结果和线上结果对不上:转化模型离线损失的变化和线上广告主价值的相关系数只有 0.1,大量离线变好的改动在小流量 A/B 阶段失败。这篇论文把离线损失按每次点击对广告主值多少钱加权,让损失下降对应到价值上升。改完以后,离线到线上的相关系数升到 0.65,两类模型换用新目标后线上价值合计提升 4.7%。
 Personalization · 2026-07-22Uncertainty as Remedy: Mitigating Satisfaction Label Bias in Short Video Multi-Objective Ensemble Ranking快手的 UAME 让融合排序模型除了打分再输出一个方差,表示各行为目标对这个视频的意见有多不一致,训练时给冲突大的视频对加权,线上只用均值打分、推理成本不变。EMER 底座上关注预估 GAUC 从 0.684 提到 0.724,线上长播 +1.6%;但 7 日留存只涨约 0.01%,不加权的消融有几项低于底座。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…