 已录用 CIKM 2026

向量检索用的 HNSW 图索引,在向量已经量化压小之后,内存大头往往变成了图里的边;这篇 eBay 和比萨大学的工作说明,边可以无损压到原来的一半左右,查询还不变慢。做法分两步:先离线给节点重新编号,让经常出现在同一个邻居列表里的节点编号挨在一起,这样列表里相邻编号的差值就很小;再用 Stream VByte 这种按字节对齐、能用 SIMD 指令一次解码多个整数的压缩格式存这些差值。在 eBay 的 726 万商品向量上,每条边从 33.3 bit 降到 18.3 bit,98% 准确率下平均查询时间从 632 微秒降到 564 微秒。这套方法 2025 年初已经上线 eBay 的搜索引擎,图的内存少了 44.3%,召回和延迟都没变。
做向量检索、尤其是向量已经做过量化的团队值得读。它的价值不在新算法,而在把“重新编号 + 差值 + 快速整数解码”这套搜索引擎倒排表的老办法,证明在 HNSW 上也成立,而且给出了为什么别的路子不行的测量。需要提醒的是,论文里压缩版比原版还快,主要功劳是重新编号带来的内存局部性,不是压缩本身。
场景示意
下面是一个示意场景(非论文数据),帮助理解边为什么会成为内存大头:
| 项目 | 未量化 | 向量做了 PQ 量化 |
|---|---|---|
| 1000 万个 96 维向量 | 每个 384 字节,共约 3.8 GB | 每个 48 字节,共约 0.5 GB |
| 每个节点约 50 条边,每条 32 bit | 共约 2.0 GB | 共约 2.0 GB |
| 边占索引的比例 | 约三分之一 | 约八成 |
向量压缩做得越狠,边的占比就越高。论文图 1 里,eBay 的 96 维商品向量和做了 PQ 量化的 SnowFlake 向量,都是边占了大头。
为什么边难压
HNSW 的每个节点最多连 64 条边(论文用的参数下),实际平均四五十条。每条边存的是邻居的编号,默认编号是数据入库的顺序,和图结构没有关系。作者测了编号分布的熵,在 eBay 数据上是 22.62 bit,而直接定长存每个编号也就多 1 bit 多一点。这说明编号几乎是均匀随机的,定长存已经接近最优,常规压缩无从下手。
网页图压缩的经典做法是“引用复制”:一个节点的邻居列表如果和另一个节点很像,就只记“抄那个节点的哪几个”。作者算了这种做法在最理想情况下能省多少:eBay 图上每个节点平均 49.9 条边,和最像的那个节点只共享 5.2 条,扣掉记录“抄哪几个”的开销,整张图最多省 8.8%。原因是 HNSW 刻意限制了每个节点的度数,没有网页图里那种连着成千上万节点的中心节点,列表之间重叠很少。所以这条路被放弃。
方法:先排号,再存差值
第二条路是存差值。把邻居列表排好序,只存相邻两个编号的差。手算一个例子(示意):某节点的邻居编号是 1,203,881、1,204,017、5,330,102、5,330,250。存原值每个要 23 bit;存差值是 1,203,881、136、4,126,085、148,小的差值只要 8 bit,可大的差值还是 22 bit。论文实测,只做差值,熵从 22.62 bit 降到 18.52 bit,省得不多,因为默认编号下邻居散落在整个编号范围里。
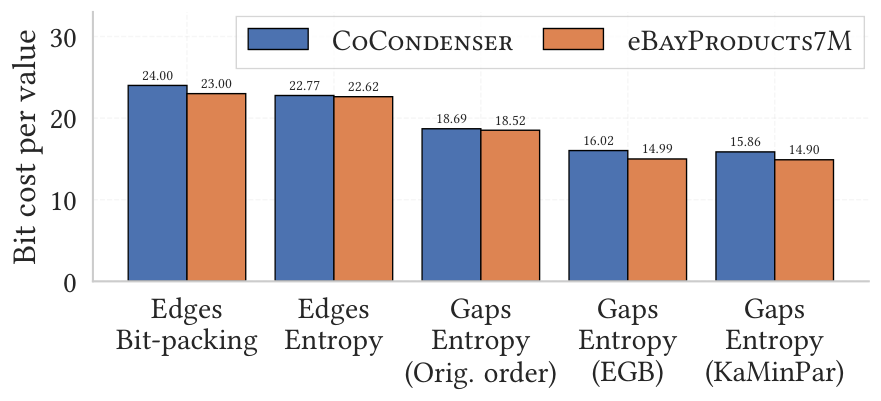
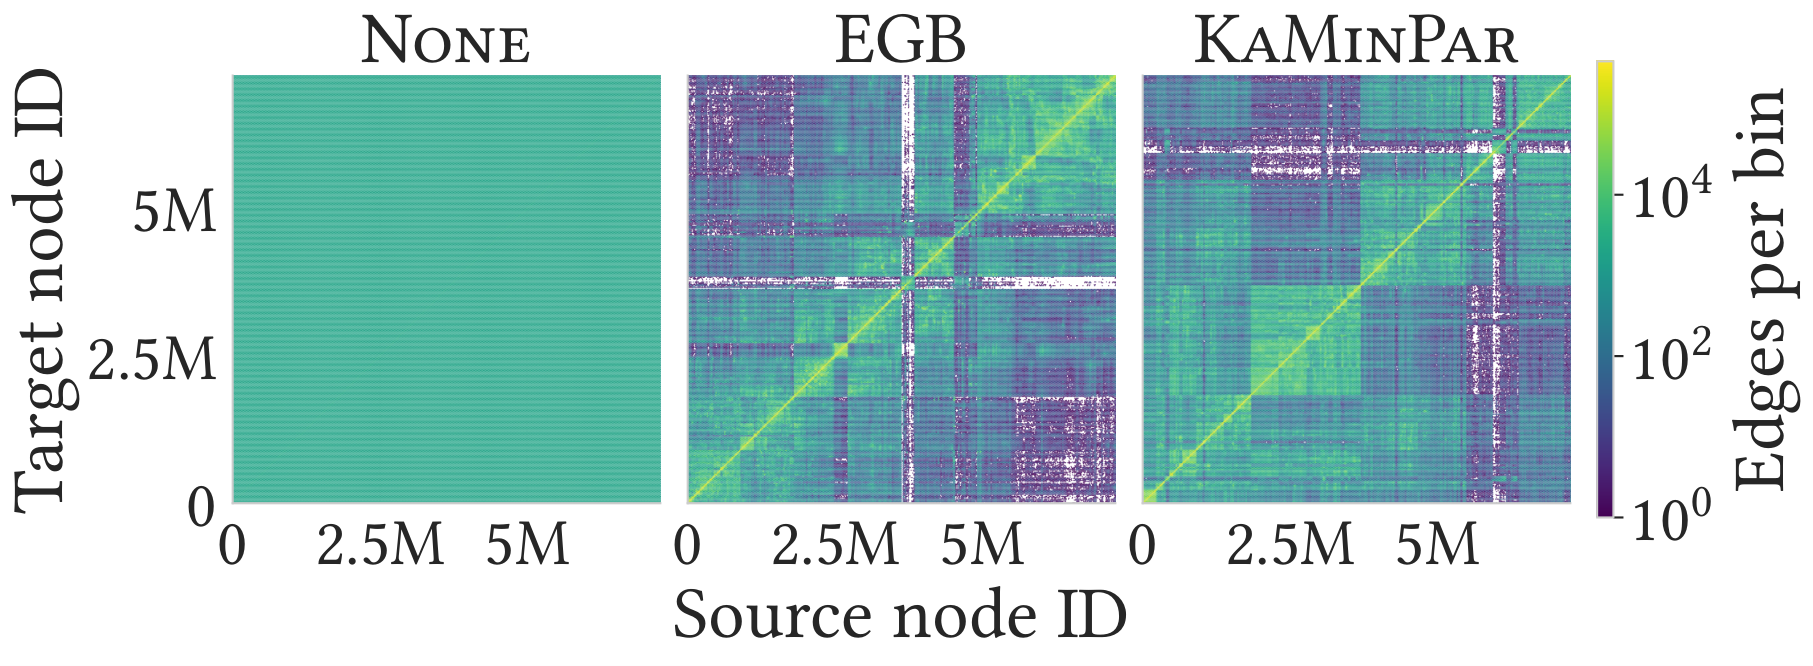
关键一步是重新编号。作者用 EGB(Enhanced Graph Bisection,一种递归二分的重排算法)离线给所有节点重新分配编号。做法是先把全部节点均分成两半,然后反复在两半之间交换节点,每次挑能让差值总代价下降最多的那一对,直到换不动为止。这里的代价是估算的差值比特数:对每个邻居列表,看它的邻居在两半里各有几个,设一个列表在左半(共 n1 个节点)里有 d1 个邻居、右半(共 n2 个)里有 d2 个,代价就按 d1·log(n1/(d1+1)) + d2·log(n2/(d2+1)) 估算,意思是某一半里的邻居越多,它们之间的平均间隔越小,每个差值要的比特就越少。交换一对节点后,把受影响的列表代价重算一遍,就知道总代价降了多少。再对每一半重复这个过程,一直分到每块只剩少量节点(论文沿用原算法的设置,没有给出具体块大小)。最后按划分的先后顺序连续编号,同一小块里的节点编号就挨在一起,经常一起出现在邻居列表里的节点也就拿到了相近的编号。重排后,差值的熵在 eBay 数据上从 18.52 bit 进一步降到 14.99 bit。
最后选压缩格式。熵是下限,不同整数压缩格式离下限的远近不同,解码速度也不同。Zeta 码最省,但要逐 bit 解码,慢。Stream VByte 把每个整数存成 1 到 4 个字节,再用 2 bit 记下每个整数占几个字节,4 个整数的长度信息拼成一个字节,解码时用一条 SIMD 重排指令一次还原 4 个整数,不需要分支判断。它比 Zeta 每条边多不到 1 bit,但解码快得多。
还有两处小开销:邻居列表的起止位置数组原来每项 64 bit,用 Elias-Fano 编码压到约 8 bit;重新编号后,查询结果要换回原始编号,所以还要多存一张反查表。
查询时怎么解码
压缩只有在不拖慢查询时才有意义,所以存储格式要配合 HNSW 的访问方式。HNSW 查询是贪心走图:从入口节点出发,每到一个节点就读出它的全部邻居,算这些邻居和查询向量的距离,挑更近的继续走。一次查询会随机跳到几百个节点,每次只需要一个节点的邻居列表。
因此作者按列表为单位压缩,每个列表单独成块,块的起点就是起止位置数组里记的位置。查询到某个节点时,先从 Elias-Fano 数组里取出它的起点,再只解码这一块,不需要扫描别的列表。一块平均四五十个差值,Stream VByte 一次还原 4 个,十几次 SIMD 指令就能解完,再做一遍前缀和把差值还原成编号。相比之下,后面算距离要读几十个向量,解码这点开销几乎看不出来,这就是延迟基本不变的原因。
另一个容易忽略的细节是:重新编号时,向量也按新编号重新排列存放,所以编号相近的邻居,向量在内存里也挨着,读向量时缓存和预取更有效。这部分收益和压缩无关,下面的局限里会再提。
实验结果
作者在 4 个数据集上比较,每个都用同样的 HNSW 参数,在 98% 准确率(返回的前 10 个里有几个是真正最近的 10 个之一)下取最快配置:
| 数据集 | 原版 bit/边 | Stream VByte bit/边 | Zeta bit/边 | 原版耗时 | Stream VByte 耗时 | Zeta 耗时 |
|---|---|---|---|---|---|---|
| eBay 726 万商品 | 33.3 | 18.3 | 17.4 | 632 | 564 | 714 |
| CoCondenser 884 万稀疏向量 | 33.4 | 19.4 | 18.7 | 778 | 765 | 819 |
| Sift 100 万图像 | 34.1 | 16.1 | 14.6 | 111 | 114 | 141 |
| SnowFlake 884 万 PQ 向量 | 33.6 | 18.0 | 17.0 | 497 | 494 | 545 |
耗时单位是微秒。这说明 Stream VByte 的空间离最省的 Zeta 只差 4% 到 10%,而 Zeta 在 Sift 上慢了约 27%。Stream VByte 在 3 个数据集上不比原版慢,只在 Sift 上慢了 3 微秒。
重新编号是一次性的离线开销,占建索引总时间的 3.5%(CoCondenser)到 30%(Sift)。
我认为的局限
第一,“压缩后更快”主要来自重新编号。作者自己测到,只重新编号不压缩,原版的平均查询时间就能降 3.0% 到 17.0%,因为相近的节点在内存里也挨着,缓存命中更高。而表里的原版用的是默认编号。所以公平的对照应该是“重新编号的原版”,那样 Stream VByte 大概率会比它慢一点,表里没有这一列。
第二,省下的是边,不是整个索引。eBay 数据上边从 33.3 降到 18.3 bit,约省 45%,但如果你的向量没有量化、维度又高(比如 1024 维浮点),边只占索引的一小部分,整体内存只能省个位数百分比。
第三,只测了度数上限 64 的低度数图。作者说这是更难压的情况,但在度数更高的配置下收益和延迟会怎么变,没有数据;代码也还没公开,作者说会放进 kANNolo 这个 Rust 库。
搜索团队可以怎么试
第一步:先量一下自己的索引里边占多少内存。用每个节点的平均边数乘以 32 bit,和向量占用比一比;边不到三成就不必折腾。
第二步:只做重新编号,不压缩。这一步本身就可能让查询快几个百分点,而且只需要离线改一次编号、多存一张反查表。
第三步:再加差值和 Stream VByte。它有现成的 C 和 Rust 实现,改动集中在读邻居列表的那个函数里,上线前在自己的查询日志上对比延迟分位数。
结论
一句话:HNSW 的边看起来像随机数,但重新编号之后就和搜索引擎的倒排表一样好压。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。向量量化普及后,边成了内存大头 |
| 方法新颖性 | 低到中。重排、差值、Stream VByte 都是现成技术,贡献在组合与测量 |
| 实验证据 | 中。4 个数据集加线上部署,但缺“重新编号的原版”这个对照 |
| 工程成本 | 低。离线重排一次,读邻居的地方换成解码 |
| 是否值得试 | 向量已量化、内存吃紧的团队值得直接试;向量未量化的团队收益有限 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…