目录 · 7 节
1拼接串的数量随分歧位置指数增长2用一个“走哪条续写”的输入向量代替 chain rule3训练时只奖励覆盖得最好的那个 mode4建树时每个前缀按最擅长它的 mode 打分5先猜一个 mode 不行,得把几种续写都交给目标模型挑6同样数据下比最强单 mode 树快 4.8–7.6%,省下的预算还给了真续写7主要在小 batch 划算,收益多集中在分叉处
Speculative decoding 让小的草稿模型先猜后面若干个 token,大模型一次前向并行验收,输出分布和逐个生成完全一样。DFlash 这类块式草稿模型一次前向给出后面每个位置各自的分布,DDTree 把各位置的概率相乘来挑草稿树里的前缀。可这一乘,几种合理的续写就被拼成目标模型从不会说的句子:论文实测,64 个节点的乘积树里有 27–33% 是这种拼接串。论文的做法是给草稿模型加 K 个代表「走哪种续写」的输入 mode,同一次前向起草 K 段各自连贯的块,合进一棵树交给大模型去挑,验证仍然无损。这篇找到的是块式草稿模型的一处预算浪费,并把草稿树的预算从拼接串还给真实的续写;它主要在小 batch 划算,在 SGLang 闭环吞吐里,从 batch 8 起就落后于 DDTree。
Speculative decoding 的做法是让一个小的草稿模型先猜后面若干个 token,再让大模型(下文叫目标模型)一次前向并行检查。猜对的前缀直接收下,输出分布和逐个生成完全一样。眼下最快的草稿模型是块式的:DFlash 读取目标模型的 hidden states,一次前向就给出后面 15 个位置各自的 token 分布。DDTree 再把这些分布组织成一棵草稿树,树里放 B 个候选前缀(B 叫节点预算)。目标模型一次前向验完整棵树,沿着自己真正要说的那条路径收下最长的匹配。
难点在于树里该放哪些前缀。论文先给了一个等式(Proposition 1):每轮期望接受的 token 数,正好等于树里所有前缀在目标模型下的概率之和。所以 B 个节点的最优树,就是联合概率最大的那 B 个前缀。可是块式草稿模型每个位置只给一个分布,它不知道第 2 个位置的哪个词该配第 1 个位置的哪个词。DDTree 只能把各位置的概率相乘,当作前缀的分数。
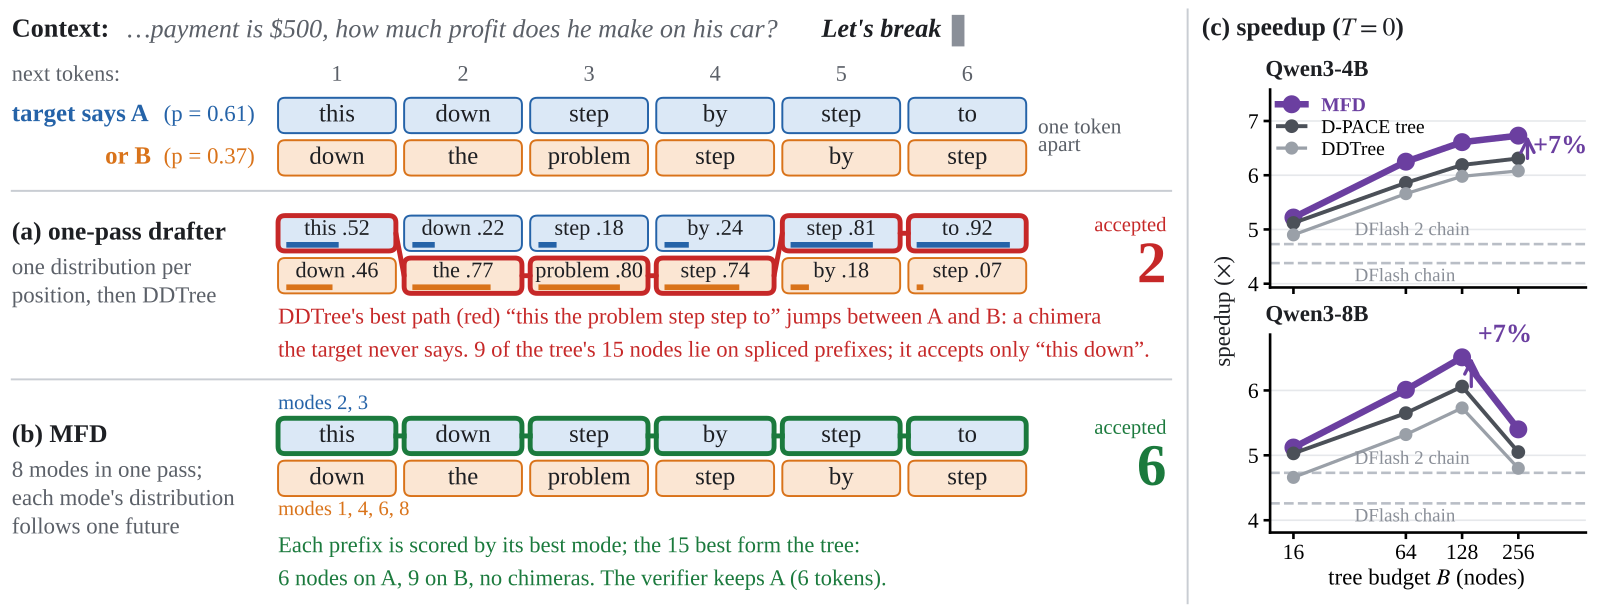
用一个示意例子看乘法在哪里出错。目标模型在 “Let's break” 之后有两种说法:A 是 “this down”,概率 0.6;B 是 “down the”,概率 0.4。草稿模型学到的各位置分布于是是:第 1 位 this 0.6、down 0.4;第 2 位 down 0.6、the 0.4。按乘积排序,深度 2 的四个候选分数如下:
- this down:0.6 × 0.6 = 0.36(真实概率 0.6)
- this the:0.6 × 0.4 = 0.24(真实概率 0,目标模型不会这么说)
- down down:0.4 × 0.6 = 0.24(真实概率 0)
- down the:0.4 × 0.4 = 0.16(真实概率 0.4)
如果预算是 4 个节点,DDTree 选 this、down、this down,再在两个 0.24 里挑一个。因为乘积给拼凑出来的前缀打了更高的分,真正的续写 down the 排在它们后面,进不了树。按 Proposition 1 算,这棵树每轮期望接受 0.6 + 0.4 + 0.6 + 0 = 1.6 个 token;换成 down the,就是最优的 2.0。论文把 this the 这种从不同续写里各取几个 token 拼成的前缀叫 chimera,下文叫拼接串。
现有的补法有两条。第一条是 chain rule:每个位置都看前面已经起草的 token,像自回归草稿模型那样。在例子里,看到第 1 个词是 this,就知道第 2 个词该是 down。代价是要付出一部分顺序起草,而这正是块式模型一次前向省掉的。第二条是把每个位置的分布训得更准。论文证明这条路有天花板:即使每个位置的分布都准确,位置之间的依赖仍会让乘积排序出错。上面的例子里分布已经完全准确,拼接串照样排在真续写前面。
拼接串的数量随分歧位置指数增长
两个续写如果只在 2 个位置上不同,乘积树为了同时装下它们,至少要多装 1 个拼接串,例子里就是这样。Lemma 1 把它推广:两个在 m 个位置上不同的续写,乘积树想都装下,除平局外还要附带 2^(m−1) − 1 个拼接前缀。m = 4 时是 7 个,m = 10 时是 511 个。续写错开一个 token、换个措辞、调个顺序,分叉之后几乎每个位置都不同,m 很快就变大。
Proposition 2 给了一个极端情形的账:两个续写各占一半概率、15 个位置处处不同、预算 256 个节点。最优树能接受全部 15 个 token,任何乘积排序最多 12 个。只用真实的各位置分布时,按两种续写怎样配对取平均,最多约 8 个(log2(258) ≈ 8)。这说明把分布训得再准也补不上这段差距,问题出在相乘这个排序方式本身。
真实模型里也是这样。下图是论文在 GSM8K 上的真实例子,目标是 Qwen3-4B:DDTree 的最佳路径 “this the problem step step to” 在 A、B 两种说法之间来回跳,15 个节点里 9 个在拼接前缀上,只接受了 2 个 token。在 628 个 prompt 上统计,64 个节点的乘积树里 27–33% 的节点是拼接串,最佳路径在 61–65% 的轮次里经过拼接串。
用一个“走哪条续写”的输入向量代替 chain rule
既然 chain rule 要付串行的代价,作者换了另一种经典工具:隐变量。隐变量只回答一个问题,“这次走的是哪条续写”。一旦知道答案,各位置之间就基本不再相关,相乘又成立了。Proposition 3 算了这能省多少:K 个取值的隐变量,若正好分清 K 个处处不同的续写,能去掉 (D−1)·log K 的相关性,随块长线性增长。关键在于它不需要已经起草出来的 token,所以 K 份草稿可以在同一次前向里起草。
具体做法叫 Multi-Future Drafting(MFD)。它在 DFlash 草稿模型的输入端加 K 个可学习的 mode embedding,每个 mode 代表一种续写走向。起草 mode k 时,把它的 embedding 加到块里每个位置的输入上。K 份块并排放进同一次前向:它们共享对上下文的计算,各自只看自己那一份块。新增参数只有 K 个 embedding 加一个 gate,K = 8、宽度 2560 时约 23K 个。
回到示意例子,假设 K = 2,起草出来的中间产物是两张各位置分布表,而不是一张:
| 第 1 位 | 第 2 位 | |
|---|---|---|
| mode 1(跟 A) | this 0.95,down 0.05 | down 0.95,the 0.05 |
| mode 2(跟 B) | down 0.95,this 0.05 | the 0.95,down 0.05 |
每张表内部仍是相乘,但 mode 1 里 this the 只有 0.95 × 0.05 ≈ 0.05,拼接串自然沉了下去。整条链路如下:
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 起草 | 上下文 hidden states + K 个 mode embedding | 一次前向起草 K 份 15 位的块 | K 张各位置分布表 | 否 |
| 选 mode 训练 | 目标模型的真实续写 | 算每个 mode 能覆盖多少,最好的那个拿大部分梯度 | 各 mode 分工 | 是 |
| 建树 | K 张分布表 | 每个前缀按最擅长它的 mode 打分,取前 B 个 | 一棵 B 节点的树 | 否 |
| 验证 | 这棵树 | 目标模型一次前向,和 DDTree 完全相同 | 接受的 token | 否 |
在 Qwen3-4B 上,多出来的 mode 每轮多花约 0.6 ms(eager 执行),在 SGLang 引擎里约 0.2 ms。
训练时只奖励覆盖得最好的那个 mode
最直接的训法是把同一个损失在 K 个 mode 上取平均。问题是这样每个 mode 的目标完全一样,最后学成 K 份一样的单 mode 草稿模型。MFD 改成 winner-take-all:对目标模型的一段真实续写,先算每个 mode 的覆盖量,也就是按这个 mode 的概率直接算出的、从头开始连续对上的 token 数的期望。覆盖量最大的 mode 拿 0.9 的权重,其余 7 个各拿 0.1/7 ≈ 0.014。
示意:一段以 “down the” 开头的续写,mode 2 能对上约 4 个 token,其他 mode 都不到 1 个。这一步的梯度主要来自 mode 2 的损失,把它往 B 推;草稿网络本身是各 mode 共享的,也会一起更新。下一段以 “this down” 开头的续写则主要更新跟 A 的那个 mode。久而久之 mode 各管一类续写,这就是 multiple-choice learning 的 oracle loss。每个 mode 内部用的是 D-PACE 损失:一种按“这个位置有多大可能被接受到”给交叉熵加权的 DFlash 微调方法。保留 0.014 的小权重,是为了让每个 mode 都不被闲置。为了让每步训练算力和单 mode 基线持平,基线每条序列取 512 个起草起点,MFD 取 8 个 mode × 64 个起点。
建树时每个前缀按最擅长它的 mode 打分
有了 K 张分布表,树怎么建?MFD 给每个前缀打的分,是它在各个 mode 下“先验概率 × 乘积”里的最大值,然后取分数最高的 B 个。计时用的是均匀先验。示意例子里两个 mode 各 0.5:this down 在 mode 1 下得 0.5 × 0.95 × 0.95 ≈ 0.45,down the 在 mode 2 下同样约 0.45。this the 在两个 mode 下都只有约 0.02,排到最后。4 个节点的树于是正好是 this、down、this down、down the,等于最优树。
实现上,K 个 mode 各自做 best-first 搜索,合并进同一个堆,精确地取前 B 个。两个 mode 若跟的是同一种续写,同一个前缀会被弹出两次,第二次复用已有节点、不再占预算。K = 1 时整个过程退化成 DDTree。用最大值而不用 K 个 mode 的概率之和,是因为最大值对应的树恰好是各 mode 子树的并集,一个堆就能算准。验证阶段和同预算的 DDTree 完全相同,所以仍然无损。
先猜一个 mode 不行,得把几种续写都交给目标模型挑
一个自然的问题:既然有 gate,为什么不让 gate 挑一个 mode,只验证那一条?Table 3 在同一个 K = 8 的草稿模型上比了四种用法,数字是每轮平均接受 token 数(下文记 τ)相对单 mode D-PACE 的变化,用训练四分之一个 epoch 的草稿模型模拟得出,T = 0:
| 用法 | 含义 | τ 变化 |
|---|---|---|
| gate 链 | 各 mode 都起草后,验证前由 gate 挑其中一条链 | −4.6% |
| oracle 链 | 事后知道每个块哪个 mode 最好,用它的链 | +27.4% |
| gate 树(B = 64) | 整棵树的预算都给 gate 挑的 mode | −7.3% |
| mixture 树(B = 512) | 所有 mode 按上一节的打分合成一棵树 | +7.8% |
这说明正确的续写确实藏在某个 mode 里,只是验证前很难猜中:K = 4 时 gate 只在 38% 的训练块上选对(随机是 25%),K = 32 时只有 10%。只有一棵会分叉、交给目标模型去挑的树,才能拿到其中一部分收益。表里多 mode 草稿模型训练用的起草块是 D-PACE 的两倍,块数对齐到 512 时,K = 4 在 B = 64 仍有 +5.0%。
另外两个对照也指向同一点。直接验证 8 个 mode 各自的最可能链(最多 120 个节点),只追平 D-PACE 的 64 节点树,因为几条链重复了共同前缀。把每个位置的 mode 打乱再建树,收益跌到 D-PACE 以下。收益来自同一个 mode 内部跨位置的配套。
同样数据下比最强单 mode 树快 4.8–7.6%,省下的预算还给了真续写
主结果在 batch size 1、Hugging Face Transformers 里计时,目标是 Qwen 4B 到 27B 的四个模型,取五个任务的均值。最强基线一般是同数据、同配方训练的 D-PACE + DDTree。训练 3 个 epoch 的 MFD 比它快 4.8–7.4%(T = 0)和 5.7–7.6%(T = 1)。以 Qwen3-4B、T = 0 为例,这一格的最强基线是训练 1 个 epoch 的 D-PACE + DDTree,加速比 6.73× 对 6.31×(快约 6.7%),τ 是 9.71 对 8.91。用全量 1.42M 条 prompt 微调后领先扩大到 6.2–12.2%,最高是 Qwen3.5-4B 的 7.78×。基线和 MFD 用的是同样的数据和训练配方,这说明多出来的速度来自 mode 和 mixture 树。
预算去向的统计更直接。在 Qwen3-4B 上,MFD 树比 D-PACE 树多覆盖 8.3%(B = 64)和 10.3%(B = 256)的概率,按每轮接受的起草 token 数算(这组统计每个任务 24 个 prompt、T = 1,口径和主结果不同),64 个节点的 MFD 树是 6.78 个,256 个节点的 D-PACE 树是 6.87 个,两者接近。分叉处(第二候选概率至少 10%)的收益更大:MFD 在这些地方多接受 10–12% 的 token,其他地方只多 2–4%。但在同等难度下,目标模型很确定的地方收益也差不多大。这说明收益跟随单 mode 树提前停下的位置,而这些位置多在分叉处。mixture 树并没有消灭拼接串,64 节点时仍有 22–24%,但分叉处新增的拼接串少了 54–57%。
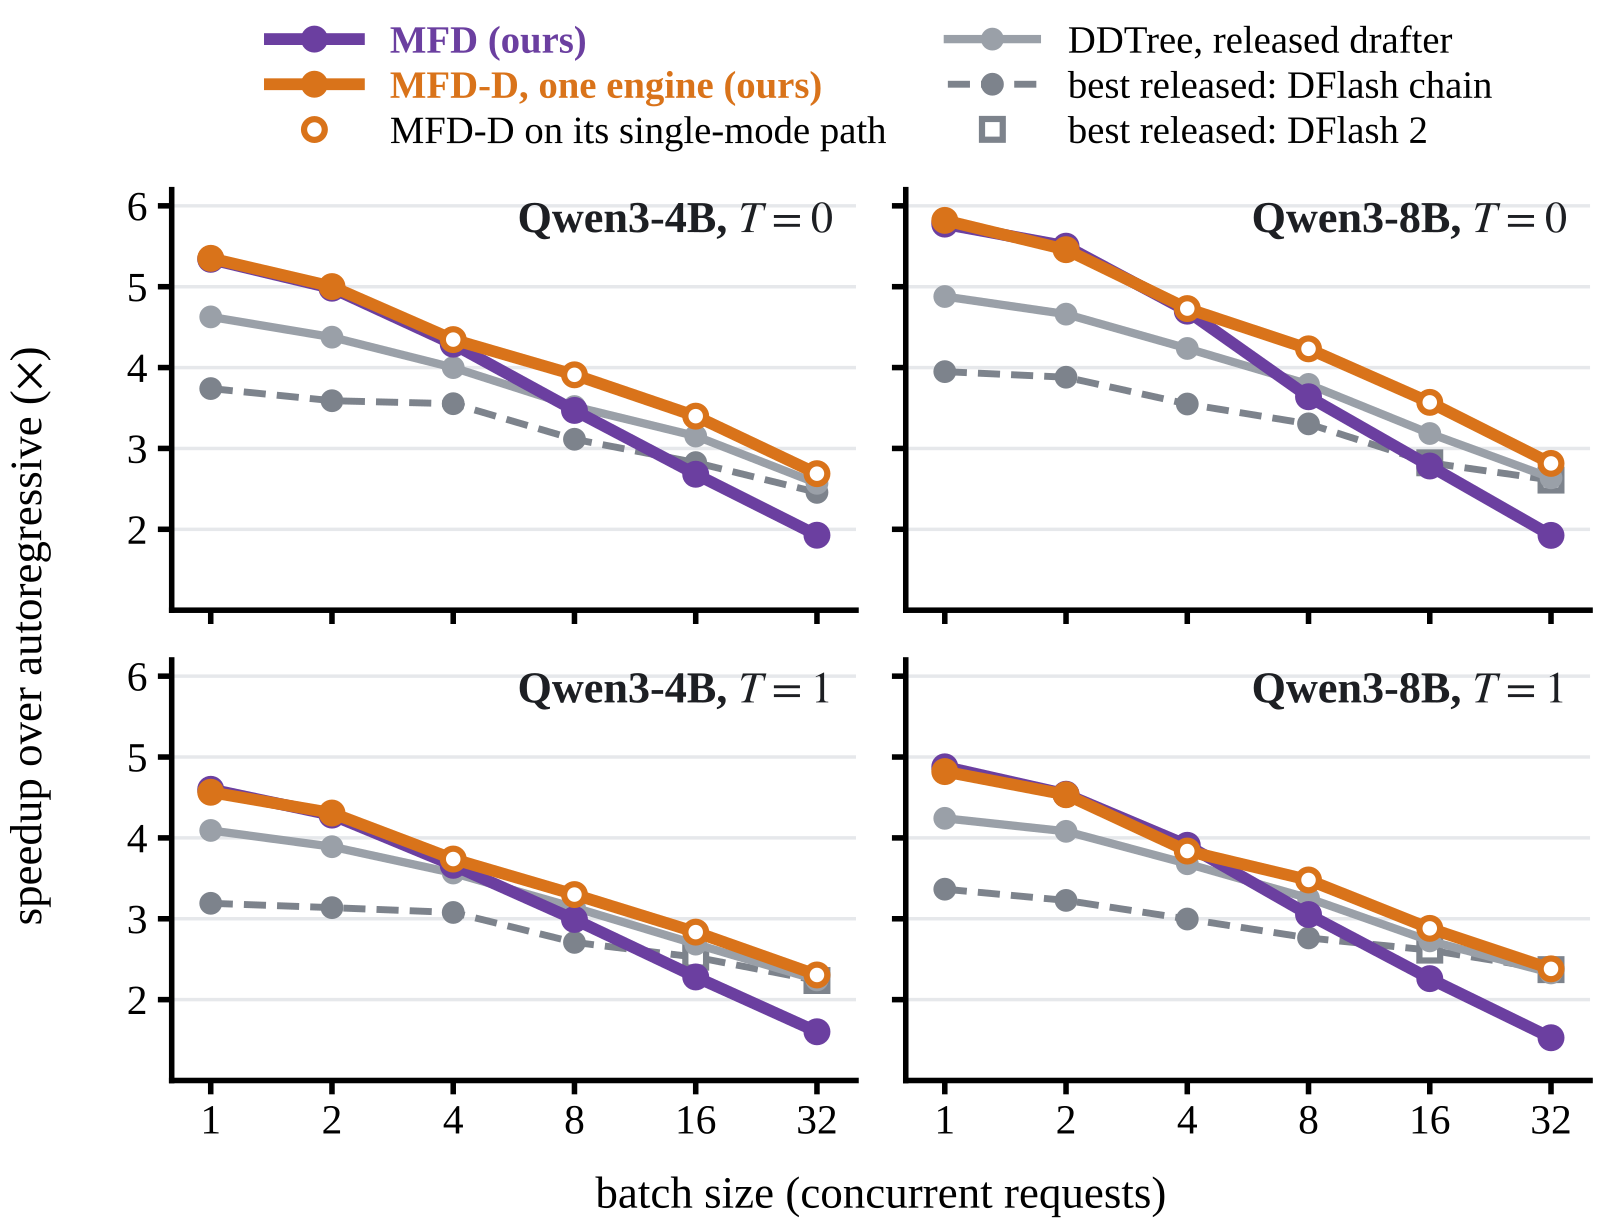
和同期工作比,在同样 prompt 上训练时,MFD 在 Qwen3-4B/8B 上比 DARTree 快 9–16%。DARTree 让草稿按已起草 token 逐深度修正,同为 64 节点时它每轮接受得更多(T = 0 下 Qwen3-4B 是 9.97 对 9.67),但建树每轮要 2.6–2.7 ms,MFD 约 0.35 ms。MFD 在最佳预算下每轮接受数也略高(Qwen3-4B 10.49 对 9.97,Qwen3-8B 10.18 对 10.09),所以整体更快。在 SGLang 0.5.22 里,batch size 1 时 MFD 比最快的已发布草稿模型(DFlash 的单链)快 45–46%,比同引擎、同数据的 D-PACE 快 7–9%。
主要在小 batch 划算,收益多集中在分叉处
在示意例子里,如果上下文已经是 “Let's break this”,下一个词几乎肯定是 down,走哪条续写已经大致定了,多起草的 K 份几乎只剩成本。论文的 hedging 价值(Eq. 3)说的就是这件事:草稿模型看得到的信息足以确定哪个 mode 会赢时,它为 0。
batch 变大时,这份成本开始压过收益。因为起草 K 份块的开销随 batch 增长,接受长度却不变:batch 32 时 MFD 起草一轮 18.6 ms,单 mode 只要 3.9 ms。在 SGLang 闭环吞吐里,MFD 在 batch 1–2 比已发布方案快 10–18%,batch 4 快 3–11%,从 batch 8 起落后于 DDTree。作者给的 MFD-D 多训一条不带 mode 的默认路径,从 3 个并发请求起就改用它。它在所有 batch 下都最快,但从 3 个请求起已经不用 mixture 了。
还有两处边界。在已经按已起草 token 条件化的 Domino 草稿模型上加 8 个 mode,τ 在 B = 64 时 −1.3%、B = 128 时 +1.3%。这说明位置之间的配套一旦由 chain rule 补上,隐变量就没剩下多少可做,在作者测的这个草稿模型上,两者叠加的额外收益很有限。小预算也不一定赢,两个 Gated-DeltaNet 混合架构目标在 B = 16、T = 0 时,MFD 都略低于 D-PACE。
所以这篇论文的价值在于把账算清楚:草稿树的预算应该按整条前缀的概率分配,而逐位置相乘会把预算分给拼接串。在单请求、低延迟的推理场景里,给块式草稿模型加几个代表续写走向的输入向量,就能用同一次前向把这部分预算还给真续写。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Infra · 2026-11-12ForeSpark: Joint Draft and Verification Budget Scheduling for Parallel Speculative Decoding并行草稿模型一次前向就能写出一整块草稿 token。现在的做法是先写满一整块,再挑最有希望的几个去验证。作者发现高负载下这很浪费:写草稿占到每步时间的 40%,而写出来的大部分根本没被验证就丢掉了。难点在于并行草稿模型必须在写之前就定好长度,没法像逐个生成的草稿模型那样写到没把握时停下。ForeSpark 在写草稿前,先用目标模型当前的上下文特征估计每个请求写不同长度时能被接受多少,再把整个 batch 里所有请求的草稿长度和验证名额一起排序分配。在 vLLM 上,同样的单请求生成速度下,吞吐比目前最强的 DSpark 最多高 1.77 倍,输出分布不变。草稿写多长,要在写之前按请求定下来。
 Infra · 2026-11-05HybridSpec: Throughput-Aware Speculative Decoding for Hybrid GDN-MoE Models给混合了 Gated DeltaNet(GDN,带循环状态的线性注意力层)和 MoE 的模型做投机解码,每轮验证几个草稿 token 不能照搬稠密模型的设定。在一个 Qwen 混合模型上,一轮验证的 token 数从 4 加到 16,验证耗时涨了 71%。HybridSpec 每一轮给每个可选长度打分:按草稿置信度估出的预计产出 token 数,减去这段验证耗时按平均速度本可产出的 token 数。目标模型跑到第一个 MoE 路由器时,再看多验一个 token 会多用几个新专家,把这部分耗时算进得分,划算才多验。在三个这类模型上,同用 DFlash 出草稿,速度是每轮验满的原版 DFlash 的 1.3 倍左右。
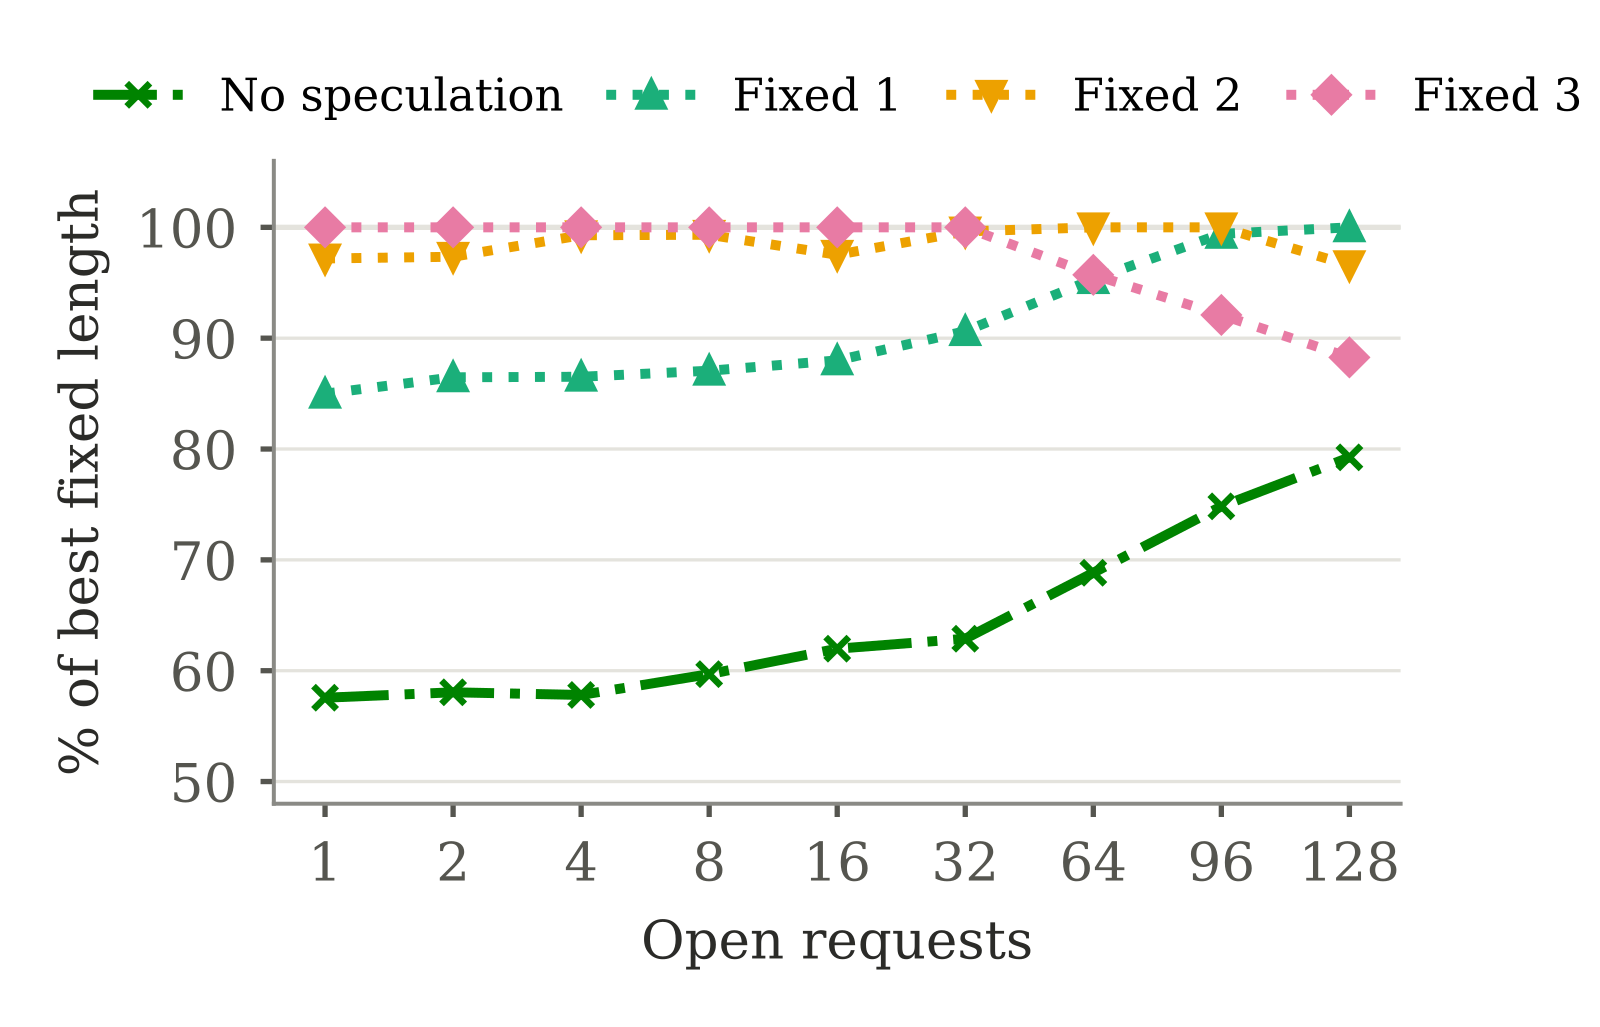 Infra · 2026-11-02TableTune: Measured, Self-Correcting Draft-Length Tables for Dynamic Speculative DecodingvLLM 文档里那张按批大小决定投机解码每步猜几个 token 的配置表,换一种 GPU 或模型就可能明显拖慢吞吐;这篇论文给出一个几分钟就能把最优表实测出来、上线后还能随流量自动修正的工具。投机解码只在 GPU 还有空闲算力时才划算:同一批里的请求越多,每步该猜的 token 就该越少。TableTune 在 vLLM 自己的服务路径上把每种批大小、每种猜测长度都实测一遍,算出吞吐最高的表。上线后,插件读取 vLLM 记录的猜中次数,结合测好的单步耗时,重算每种批大小下每秒能产出多少有效 token,挑最高的长度重写这张表。在一个 MoE 模型上,以每种负载下最快的固定猜测长度为基准,文档里的表最多慢 18%,实测表最多慢 3%。
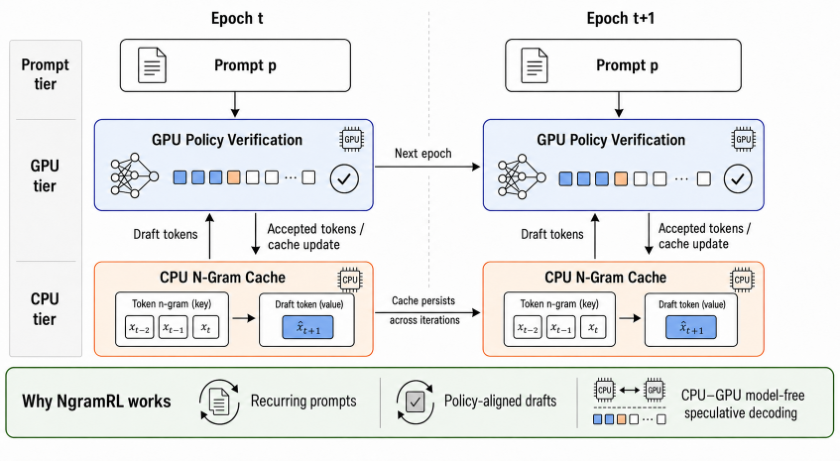 Infra · 2026-10-27NgramRL: Accelerating RL Post-Training for Structured Generation via Rollout-Aware N-gram Speculative Decoding大模型强化学习后训练里,生成回答常常占到训练时间的七成以上。这篇论文注意到,同一道题在前几轮训练中生成过的回答很像这一轮要生成的内容,可以直接拿来当草稿。他们提出 NgramRL,每道题只用自己最近几次的回答建一个 n-gram 草稿表。生成时拿当前回答的最后几个词去表里查,把表中接在后面的内容当草稿,大模型一次验证多个 token,不需要额外的草稿模型,也不占 GPU 显存,生成结果的分布也不变。在推理和结构化生成任务上,缓存预热后大模型每次前向能确认 3.6 到 7.8 个 token,最多是 SuffixDecoding 的 2 倍,后者是用全局历史回答建后缀树查草稿的同类方法。
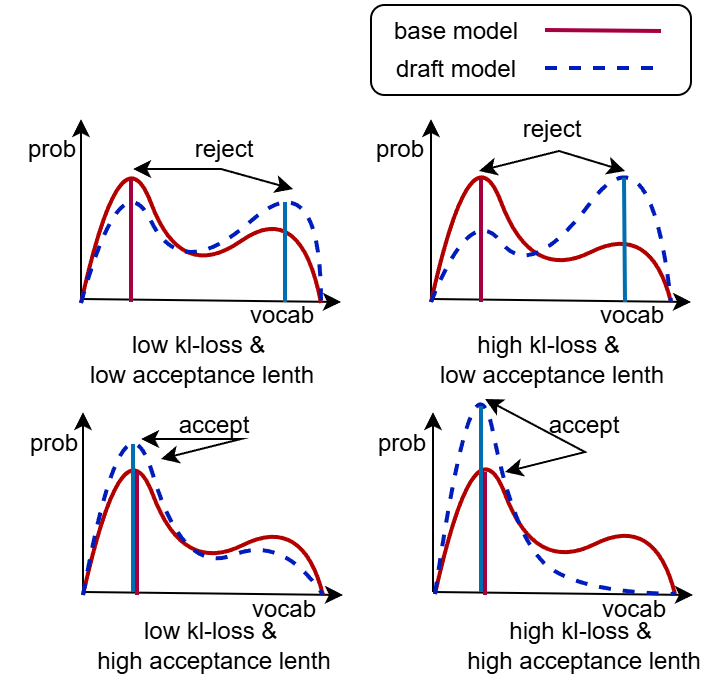 Infra · 2026-10-23RCSD: Reinforcement and Continual Learning for Domain-Specific Speculative Decoding海信的 RCSD 在用 HASS 蒸馏训好的投机解码草稿模型上,再用 DPO 或 GRPO 继续训练:目标模型自己生成的序列为"好",目标与草稿交替生成的序列为"差",GRPO 版用接受率打分。Qwen3-1.7B 和 Llama-3.1-8B 上,四个数据集、草稿步数 3–6 的接受长度都高于 HASS,例如 Qwen3-1.7B 在 GSM8K、步数 6 时从 2.176 到 3.246;Llama-3.1-8B 在 ShareGPT 上吞吐从 142.3 到 176.6 token/s。论文没有给出生成质量评测。
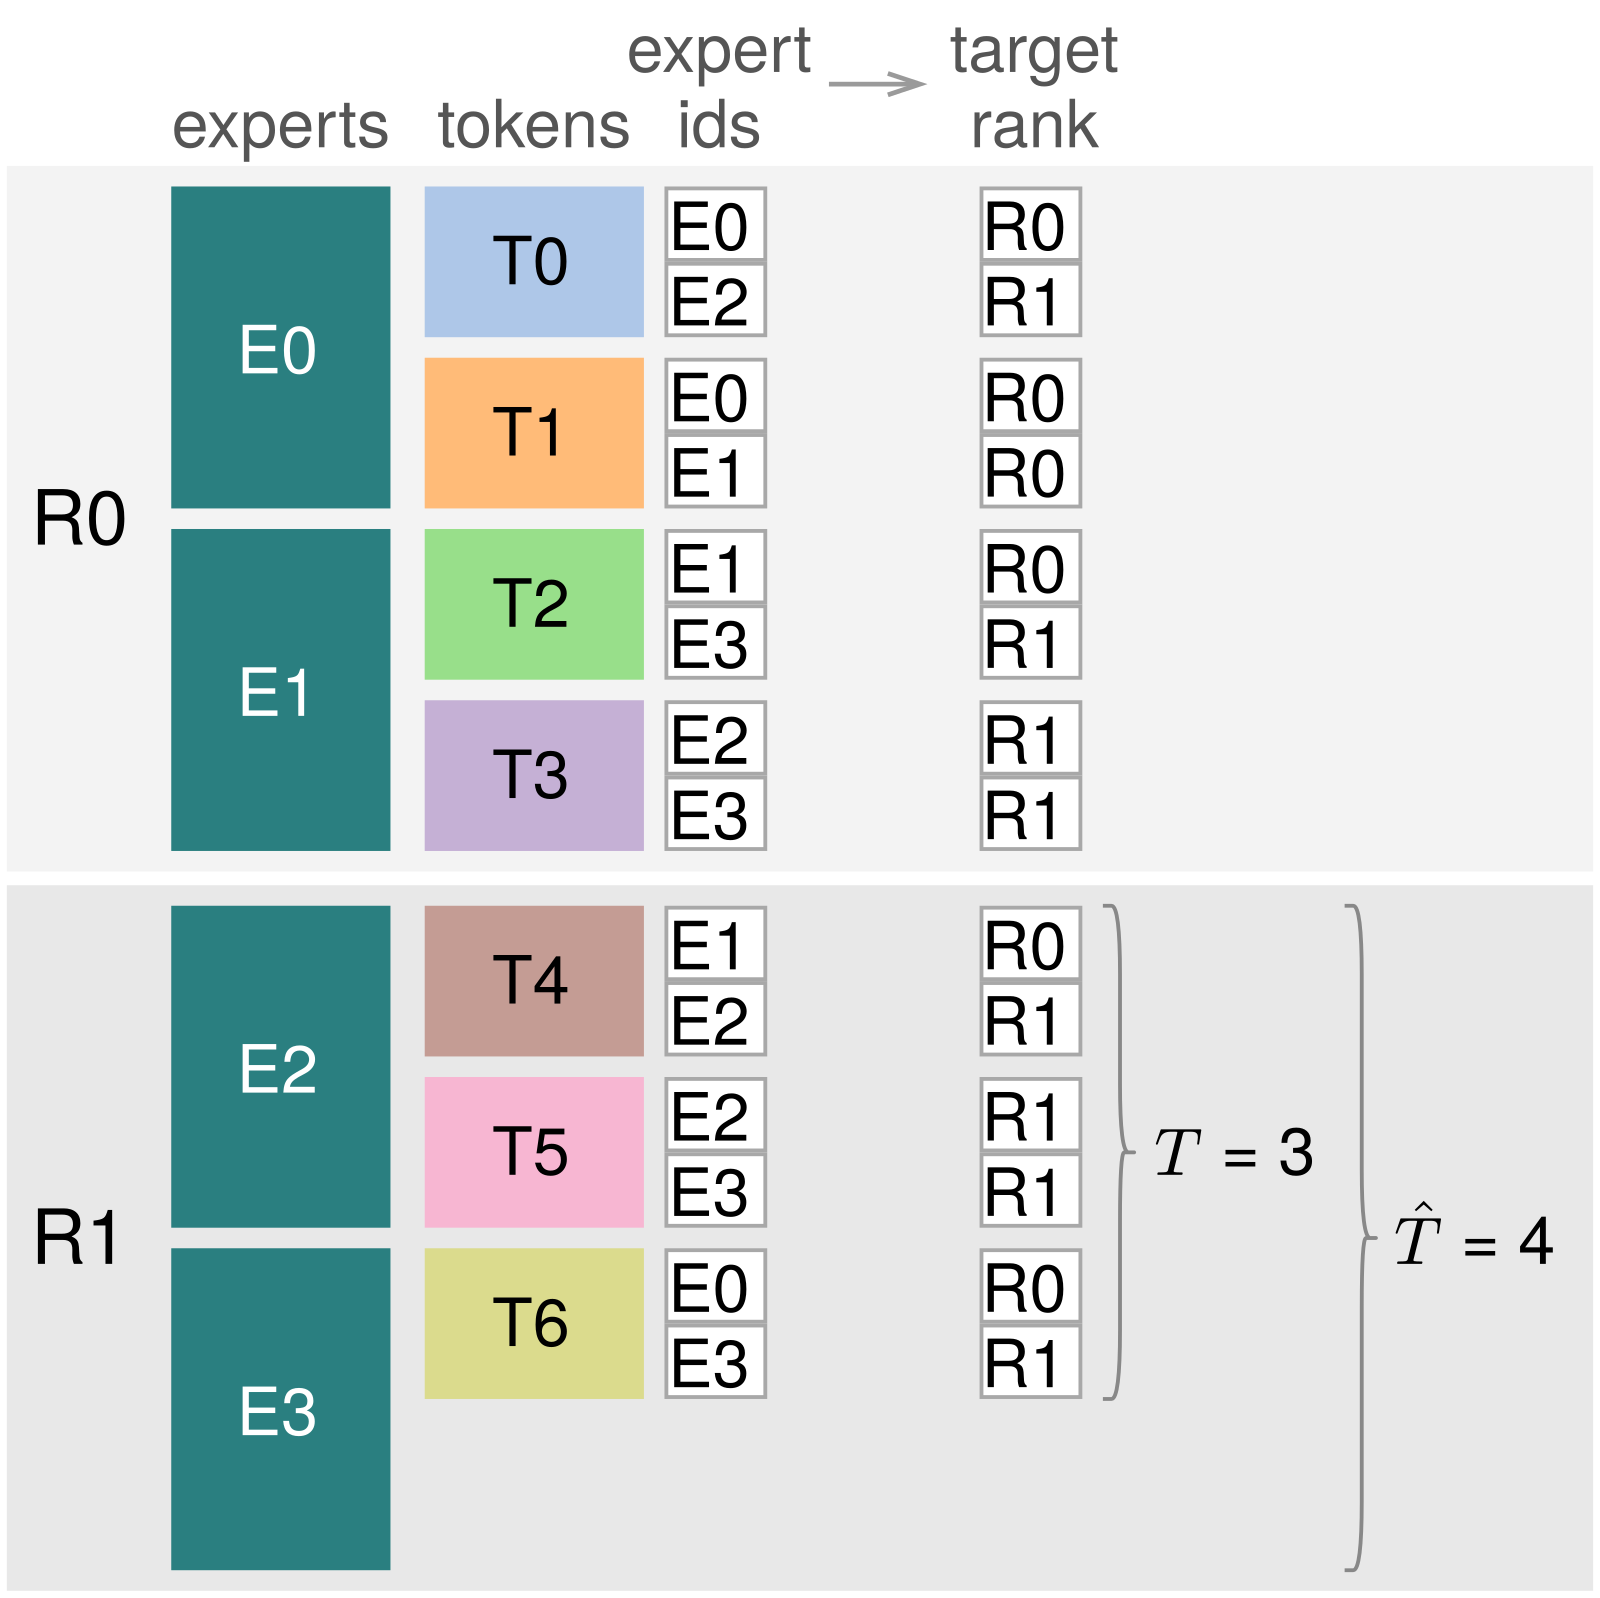 Infra · 2026-11-12One-Sided Expert-Parallel All-to-All for Mixture-of-Experts Inference over NVLinkMoE 推理时每一层都要做两次 all-to-all:先把 token 发到持有对应专家的 GPU,再把专家的输出收回来。推理时每张卡一次只处理很少的 token,这时耗时的不是搬数据,而是 GPU 之间互相等待、同步这类固定开销:数据量小到在 NVLink 上几乎瞬间传完,一来一回却要几十微秒。NVLinkOneSided 让每张卡只凭自己的路由结果,直接把 token 写进目标卡上专门留给它的那块缓冲区,不用先交换 token 数量之类的信息;后面的分组 GEMM 也直接从这块缓冲区读,不再按专家重新复制一遍。在 Blackwell GPU 上,发送加回收比 DeepEP 快 1.2 到 3.0 倍,batch 越小优势越大。整层 MoE 在每卡 128 个 token 以内,比融合成一个 kernel 的 DeepGEMM MegaMoE 还快。小 batch 的 decode 通…
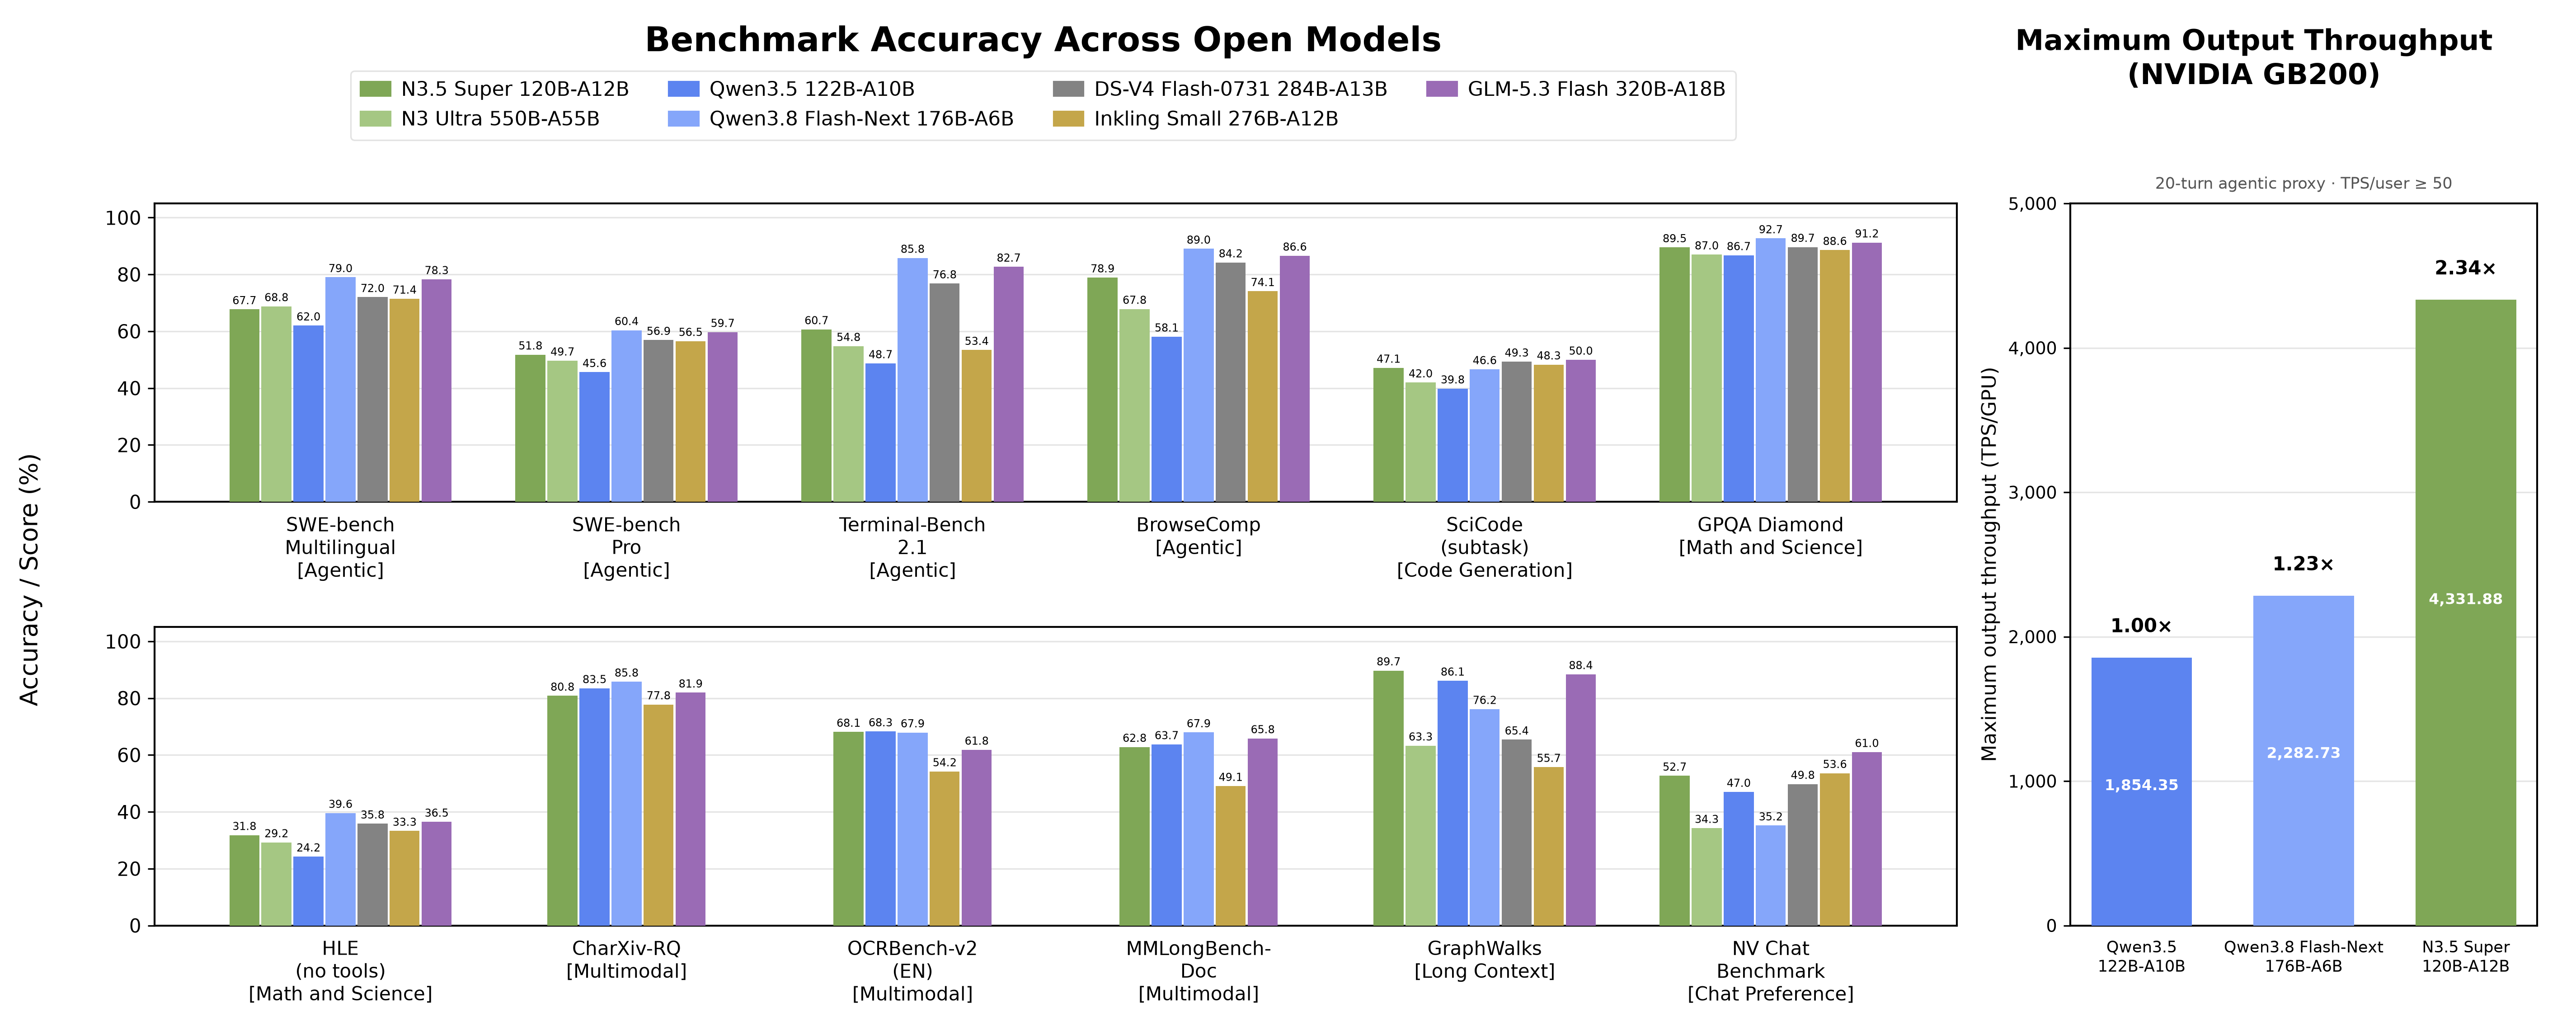 Infra · 2026-11-02Nemotron 3.5 Super and Lightning: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Models for Agentic AI开源模型做 agent,能力和推理成本常常只能顾一头。NVIDIA 的 Nemotron 3.5 Super 把两头一起优化:它是 Mamba 和 Transformer 混合的 MoE 模型,每个 token 只激活约十分之一的参数,在 SWE-bench Pro 上拿到 51.78%,超过了激活参数多好几倍的上一代 Ultra。对做推理部署的人更有用的是它的部署设计:模型自带多 token 预测头来做投机解码,后训练里再专门练这个头,平均每步被接受的 token 数比原来的头多出 21.8%(按概率采样草稿时),贪心解码时多出 10.1%。NVFP4 量化后,在交互式 agent 负载上吞吐是 BF16 的 2.43 倍。基座、后训练和量化后的权重连同训练数据一起开放。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…