目录 · 8 节
1一次推荐请求从头到尾的六个环节2步与步之间的交接交给单独的 runtime3权重每分钟更新上百次,每个请求全程只用一个版本4为什么大量短注意力行比一条长序列更难算5按每一步的形状分别编译执行计划6两段式 Top-K:从 420 万个分数里挑候选,结果不变7端到端吞吐是 GeneralGen 的 1.84 到 2.88 倍8上线以后,瓶颈回到稠密解码
生成式推荐看着像大模型逐字生成,算力却花在海量很短的注意力计算和每一步挑上百个候选上,大模型推理框架照顾不到这两处,所以快手放弃改造它,专门写了一套服务系统 RecoGEM。
传统推荐系统给候选物品打分,召回、粗排、精排一层层缩小范围,靠前的阶段为了省算力只能算得很粗。生成式推荐(GR)换了一条路:模型根据用户上下文(静态信息、短期行为、长期兴趣),直接生成要推荐的物品编号。每件物品用一小串编号表示,这串编号叫 Semantic ID(SID)。示意:一部 iPhone 18 的 SID 有 3 位,第一位表示「手机」,第二位表示「iOS」,第三位定到这款手机。模型一位一位地生成,每一位有自己的词表(这一位能取的全部编号),靠前的位分大类,靠后的位定到具体物品。
难处在于一次请求(给一个用户出一批推荐)要同时推荐很多件物品,模型得同时沿很多串编号往下走。系统每生成一位,都要保留一批候选前缀,也就是已经生成的前几位(这种做法叫 beam search),把每个前缀和这一位词表里的编号组合起来打分,再挑出下一步继续走的前缀。示意:第 1 步留下「手机」和「家电」两个前缀,第 2 步给这两个前缀各接 4 个可能的编号,得到 8 个续写,再从中挑 2 个。线上的规模大得多,快手的一组配置是 512 个前缀、每个前缀接 8192 个编号,一个请求单步就有约 420 万个分数要比较。
要服务这类模型,最接近的现成方案是大模型推理框架,它们的请求调度、KV cache 管理和解码优化都很成熟。这些框架的前提是每一步做同样的事:读当前序列,从同一个词表里预测下一个 token,接到序列末尾。把手机的例子放进这样的循环就对不上了。第 2 步挑完之后,幸存的可能是「手机-iOS」和「手机-Android」,这两个前缀都要继承「手机」的 KV cache,各自往下走,「家电」的 KV cache 则要扔掉。也就是说,每一步结束时要按幸存前缀复制和丢弃 KV cache,不只是在序列末尾接一个 token。大模型框架的解码循环里没有这个环节,用它做 GR 只能在循环外面另写一层逻辑。
据论文介绍,快手最早就是这样改造大模型框架的,后来放弃了这条路。把定制的输入输出、步与步之间的状态交接、线上更新和推荐业务逻辑塞进大模型引擎,工程量比从头写一套 GR 服务系统还大。性能上也吃亏:改造后的 TensorRT-LLM 在 CPU 上做 beam search,再按选中的前缀把 KV cache 重新排列一遍,这笔开销每一步都要付,存活的前缀越多付得越多。
RecoGEM 的设计分两半。步与步之间的事情(保管候选前缀和它们的 KV、做线上更新)交给一个专门的 runtime,执行引擎只管张量计算。引擎内部再按 GR 每一步真实的张量形状(有多少行、每行多长、挑几个候选),专门优化注意力、执行计划(编译器按输入形状定下的执行方案)和候选选择。OneModel 是快手一个 0.2B 参数的线上模型,RecoGEM 跑它时单实例在 batch 32 下做到 1,053 QPS、P99 30.8 ms。对照版本 GeneralGen 是同一套系统改用单一形状的执行计划和普通 GPU kernel,RecoGEM 的吞吐是它的 2.88 倍。这说明同一个模型只因为注意力、执行计划和候选选择按形状重写,吞吐就差出近 3 倍。这套系统已经上线九个多月,服务 4 亿日活。
一次推荐请求从头到尾的六个环节
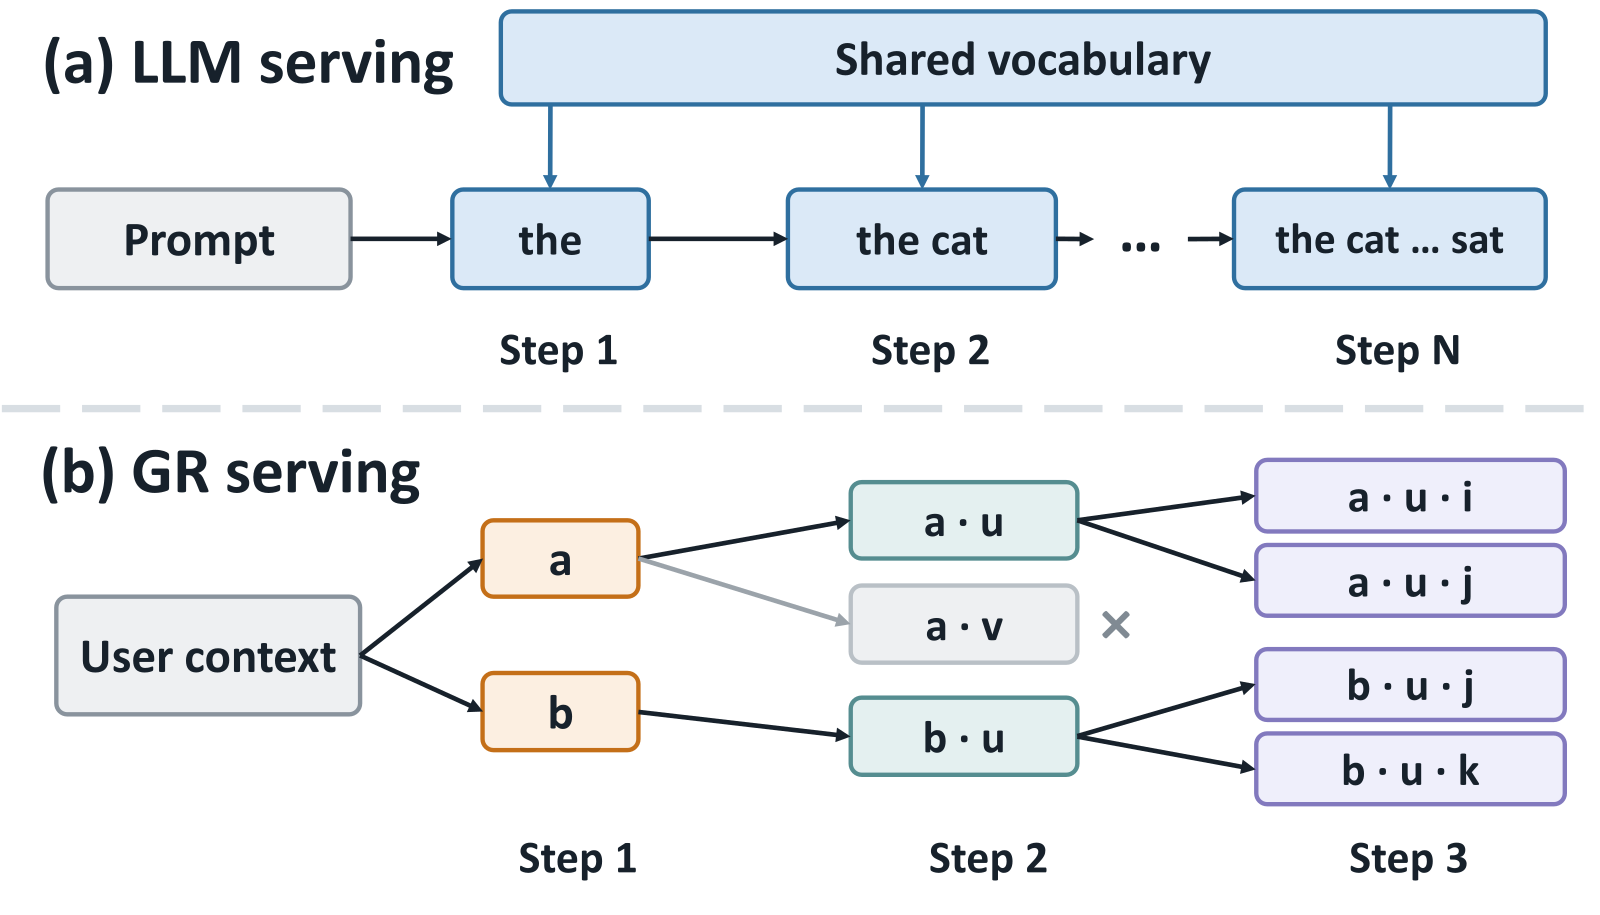
后文一直沿用前面推荐手机的这个请求。示意配置是:SID 3 位,每位词表 4 个编号,beam 宽 2(每步留 2 个前缀),只算 1 个请求。
有两个词会反复出现。cross-KV 是用户上下文编码一次得到的 KV cache,整个请求里不变。self-KV 是每个候选前缀自己的 KV cache,跟着前缀走,前缀被淘汰它就没用了。
| 环节 | 输入 | 做什么 | 产出 | 何时发生 |
|---|---|---|---|---|
| 发布 | PyTorch 模型图、服务策略 | 生成部署契约,按每一步的形状编译引擎 | 校验过的引擎和契约 | 离线,模型发布时 |
| 编码上下文 | 用户静态信息、短期行为、长期兴趣 | 编码器编码一次 | cross-KV | 每个请求一次 |
| 解码一位 | 前缀、self-KV、cross-KV | 跑解码器,给每个前缀的每个续写打分 | 分数矩阵(第 2 步是 2 行 4 列) | 每步一次 |
| 选候选 | 分数矩阵 | 两段式 Top-K | 幸存前缀和它们的父行编号 | 每步一次 |
| 准备下一步 | 幸存前缀的父行编号、self-KV | 按父行把幸存前缀的 self-KV 复制到一起 | 紧凑排列的 self-KV | 每步一次 |
| 映射物品 | 生成完的 SID | 查回目录里的物品 | 推荐结果 | 每个请求一次 |
第 2 步结束时,系统手里的中间产物长这样(示意,分数是到这一步为止的累计分,越大越好;父行是这个前缀从上一步分数矩阵的第几行长出来):
幸存前缀        累计分   父行
手机-iOS          9      第 0 行(手机)
手机-Android      8      第 0 行(手机)
表里「解码一位」和「选候选」由引擎完成,「准备下一步」由 runtime 完成。大模型框架把这几件事都藏在同一个循环后面,RecoGEM 则把步与步的边界露出来。边界露出来以后,每一步用什么 kernel、什么执行计划都可以单独定,后面所有的优化都靠这个边界。
步与步之间的交接交给单独的 runtime
第 2 步选完之后,self-KV 的缓冲区里还是两行:第 0 行是「手机」,第 1 行是「家电」。下一步需要的却是两份「手机」的 KV,因为 iOS 和 Android 都从「手机」接着往下走。只给「家电」那一行打个无效标记是不够的,「手机」的 KV 要出现两次,原来的缓冲区里只有一份。
RecoGEM 用两块缓冲区解决这件事。runtime 按幸存前缀的父行编号,从正在用的缓冲区里取出对应行的 self-KV,复制到备用缓冲区,下一步就把备用缓冲区当输入。示意: Hoot 说

示意:2 条前缀、每条扩 3 个续写、留下 2 个。名称和分数都是示意,和正文的手机、家电例子不同,累计分按概率相乘只为好算。
出处
论文 §2.2 观察 1(幸存者继承父序列的 KV cache,无幸存则不再使用;iOS/Android 例子);§3.2 双缓冲压实(用幸存索引 gather-copy 到备用缓冲);图 4、图 11正在用的缓冲区:[手机 KV, 家电 KV]
幸存前缀的父行:[0, 0]
备用缓冲区: [手机 KV, 手机 KV]第 3 步的引擎读到的是紧密排列的 2 行,「家电」的 KV 不再进入计算。runtime 还把复制做成了流水:一行 KV 在复制时,runtime 同时准备下一个幸存前缀的源地址,两件事在时间上重叠。
runtime 要替快手十多个 GR 模型家族做这种步间交接,就得知道每个引擎收什么输入、吐什么输出。如果把这些写死在 runtime 代码里,每换一个模型都要改一遍服务程序。RecoGEM 的办法是从模型图和一小份服务策略(batch 大小、量化精度、候选数、并行布局)自动生成一份部署契约。契约包含四类记录,大致长这样(示意,四类记录来自论文,写法和取值是编的):
weight_binding:   decoder.layer0.attn.q -> tensor_12
io_mapping:       step2.output.self_kv  -> step3.input.past_kv
request_batching: max_batch = 32
pipeline_flow:    context -> step1 -> step2 -> step3
runtime 加载一次部署时,先拿契约核对编译好的引擎,权重绑定、输入输出映射、batch 大小和流程都对上才用。之后请求怎么组织、下一步的输入从上一步的哪个输出来,都按这份契约执行。
权重每分钟更新上百次,每个请求全程只用一个版本
GR 继承了传统推荐对新鲜度的要求,模型权重、SID 词表和候选选择策略(每一步怎么扩展、保留候选)都会在流量还在跑的时候变。快手的 GR 生产集群里,在线更新权重(论文叫 refit)峰值达到每分钟 107 次,最忙的一小时里每台服务器要接收 346 GB 的 FP32 权重数据。这个频率下,排空流量、替换引擎、再恢复流量的老办法来不及做。生产上试过的 beam search 策略变体也有二十种左右,把策略写死在程序里,每改一次就要发一次版。
词表更新还多一层要求:同一个请求内必须版本一致。SID 词表是从物品表示里学出来的分组,重新学过之后编号的含义会变。示意:旧词表里第一位的编号 17 表示「手机」,刷新后 17 变成了「家电」。手机这个请求如果第 1 步用旧词表生成了 17,解码结束后拿新版本去查物品,查到的就是一件家电。所以每个请求从第一步到映射物品,必须全程用同一版的权重、词表和策略。
RecoGEM 的规则很简单:新版本(编译好的引擎,以及变了的契约)过了契约校验,才会被请求用到。runtime 在处理请求的路径之外把新版本准备好。切换时,它短暂停止接纳新请求,让已经发出的请求在旧版本上跑完,然后原子地切换引擎指针,契约变了就连契约指针一起切。排队的请求随后进入新版本,旧版本等没有请求引用了再退役。手机这个请求全程跑在旧版本上,排在它后面的请求全程跑在新版本上。和排空流量的老办法相比,新版本早已在旁边编译、校验好,切换时只等手头的请求跑完、换一个指针,服务程序也不用重新发版。
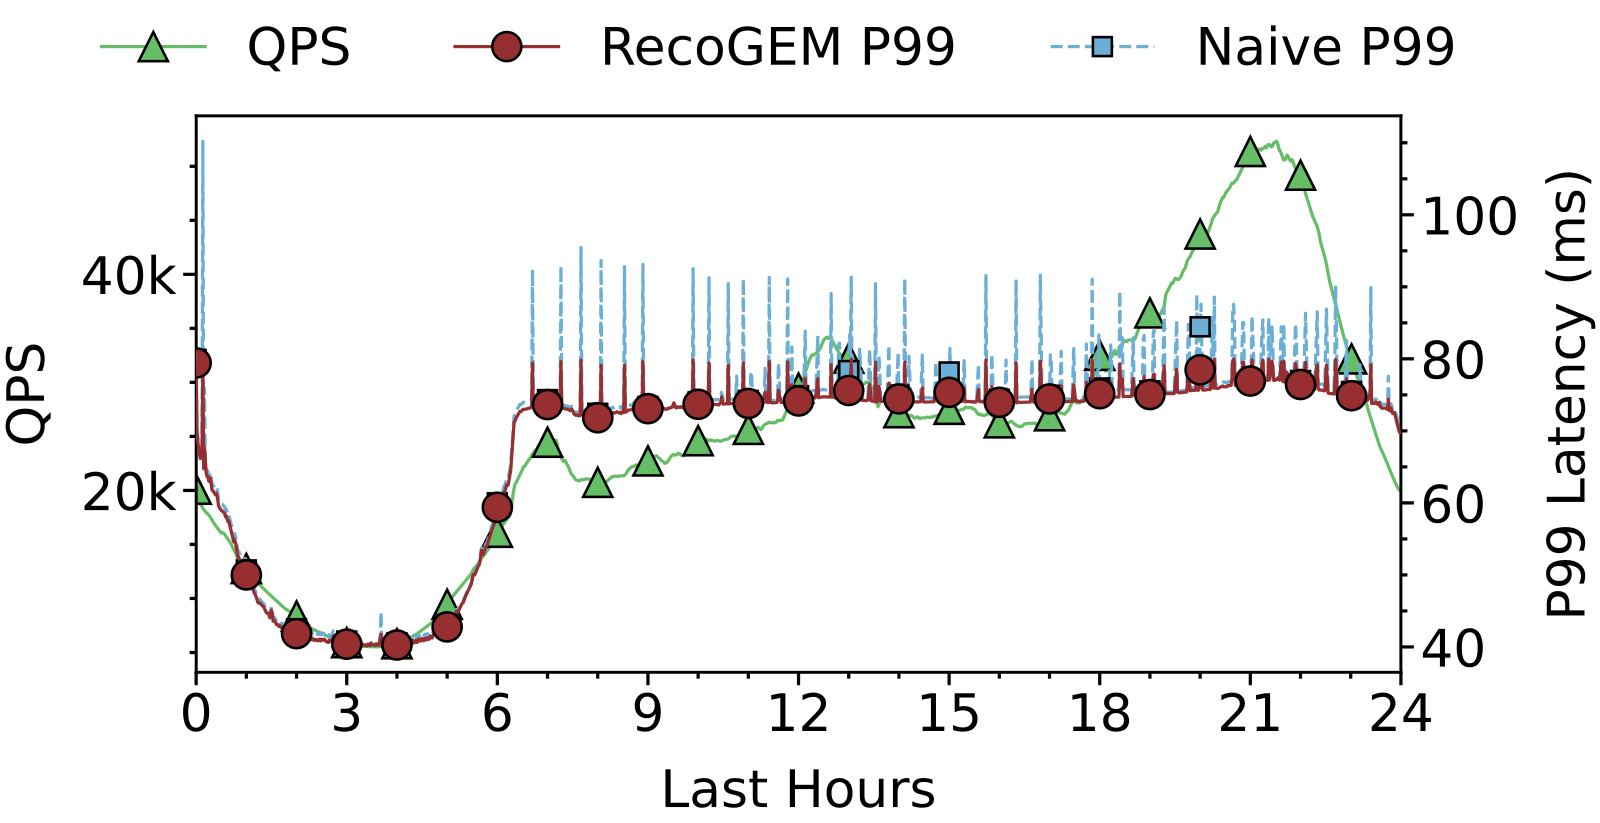
快手早期的更新办法是重建整个执行引擎,直接推到服务实例上。更新因此干扰正在跑的推理,更新期间反复出现尖峰,P99 尖峰大 2–3 倍。换成指针切换后,24 小时生产曲线上流量从约 5,000 QPS 变到 50,000 QPS 以上,P99 全程低于 80 ms,没有可见的 SLA 违约。集群历史峰值是 60,000 QPS,P99 同样低于 80 ms。这说明更新方式本身会影响尾延迟,新版本在请求路径之外准备好之后,这段曲线上全天的更新没有把 P99 推过 80 ms。
为什么大量短注意力行比一条长序列更难算
runtime 管好了步与步之间的事,引擎里的第一笔账是 self-attention。这里把「一个候选前缀在一个 head 下读自己的前缀」算作一行。大模型解码的压力在 KV 的长度上,一条序列要读很长的 prompt 和已生成的历史。GR 的压力换到了行数上:每行只读已经生成的几位 SID,行数却等于请求数乘 beam 宽再乘 head 数。论文把这个现象叫维度倒置:大模型是行少而长,GR 是行多而短。
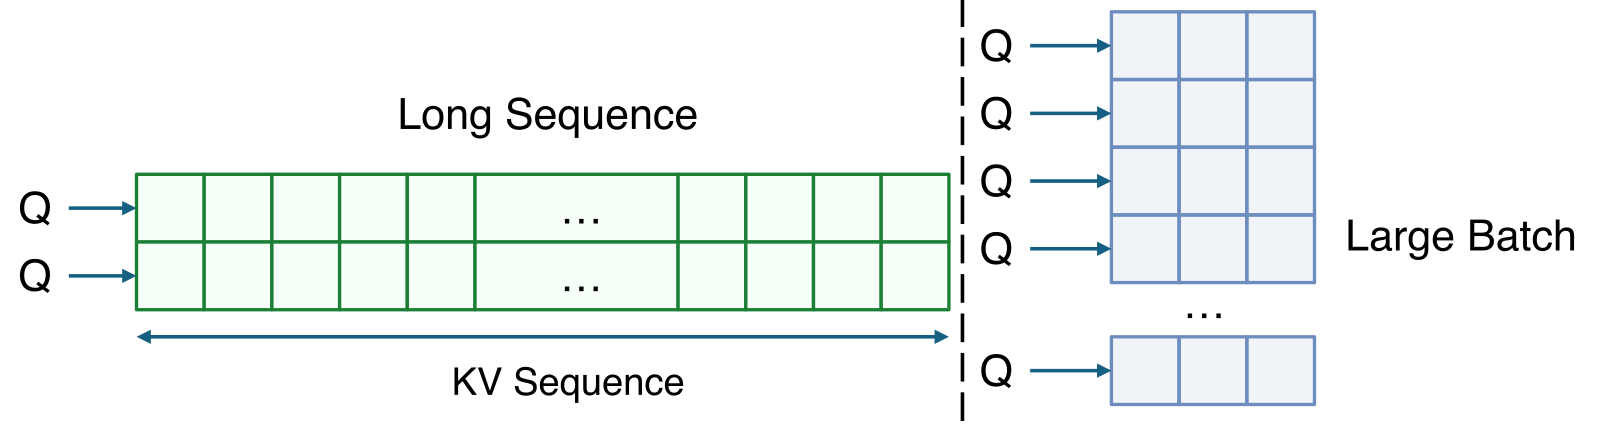
行数多听上去正好适合批量计算,问题出在现成 kernel 的摊薄方式上。tile 是一次装进 GPU 片上内存一起算的一小块数据。通用的注意力 kernel 沿着一条长序列切 tile,靠序列够长把启动开销摊掉。GR 的短行如果每行单独算一次,一行只有几次点积、一个很小的 softmax 和一次按权重取 V 的加权和,这点计算量盖不住启动开销。
那为什么不把短行拼成一条长序列?因为通用 kernel 会对一整行一起做 softmax,而每个候选的 softmax 必须各算各的。示意:候选 A 对两个位置的原始分是 (1, 1),候选 B 是 (3, 3),分开算时两个候选在各自两个位置上的权重都是 0.5。如果拼成一行算 softmax,A 的权重会被 B 压到每个位置约 0.06。候选 A 的注意力结果就被无关的候选 B 改掉了。
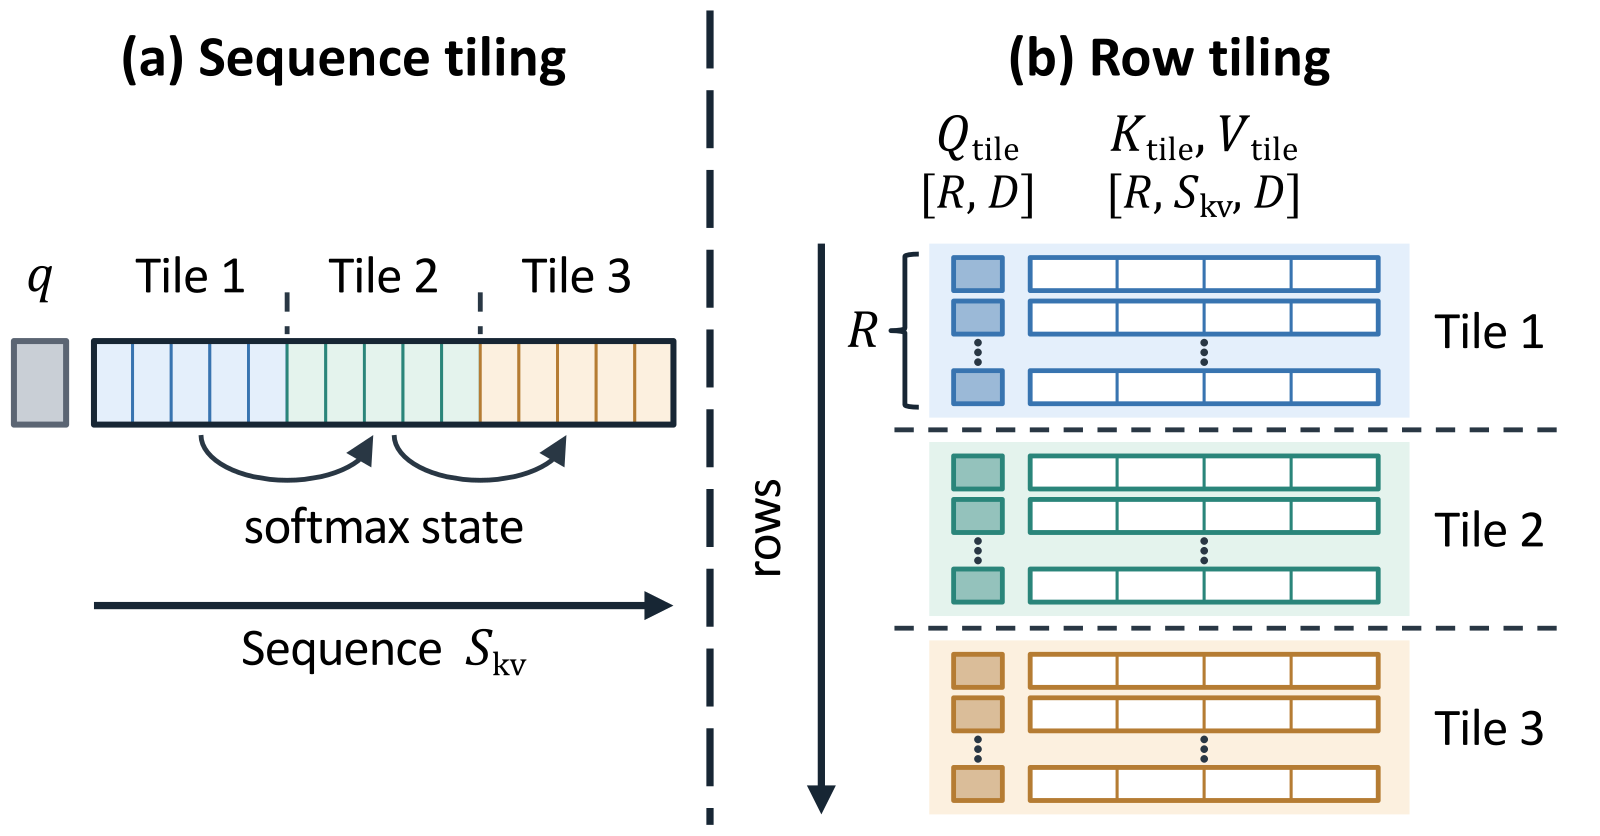
row-tiled attention 的做法是把 R 条完整的短行装进一个 tile,论文的实现里每个 tile 装 64 行。tile 之内每一行单独做完点积、softmax 和取值,中间结果留在片上,只把输出写回显存。示意:一共 8 行,每处理一个 tile 的固定准备开销(把数据搬上片、安排计算)算 10,每行计算算 1。一行一个 tile 的总成本是 8×(10+1)=88。每 4 行装一个 tile,总成本是 2×(10+4)=28。这个例子说明,行内的计算量没有变,省下来的是固定开销的次数,论文的说法是把准备开销分摊到多条独立的行上。 Hoot 说
- 被拼在一起的 KV 位置
12 个位置在一个分母下抢权重,不同候选互相串了。
- tile 1 的行
- tile 2 的行
- 一个 tile:装载和调度的单位
tile 之间不传 softmax 归一化状态,所以能边算边加载。这不等于什么状态都不留:评测里 block 还靠 persistent scheduler 跨 tile 存活。
- 一次 softmax 的归一化范围
- 为什么不能拼(示意数字):设 A 行三个位置的 exp 分数是 6、1、1,B 行是 3、2、1。各算各的,A 第一位的权重是 6/8=0.75,B 第一位是 3/6=0.5。拼成一次 softmax 后分母都变成 14,两者降到 0.43 和 0.21,B 行的权重总和只剩 0.43,本该是 1。
- 装块省的是什么:论文最大的设置里 16384×64 约一百万行,早期路径每行一个独立工作单元。每 tile 装 64 行后只剩 16384 个 tile,block 调度和 pipeline 准备的开销由这些行分摊。
行是 batch 和 head 折叠后的短行,列是这一行能读的 self-attention KV 位置。示意:4 行、S_kv=3、每 tile 2 行。这张图只画解码的某一步,行数和前缀长度都随步变化。短行只针对 self-attention:cross-KV 来自用户上下文编码,不是 SID 前缀,不在这张图里。
出处
论文 §2.3 观察 3(每个候选的 softmax 必须隔离);§4.1 row-tiled self-attention(tile 之间不需要彼此的归一化状态);§2.1 与 §3.2(cross-KV 来自上下文编码);§5.4(iii)(约一百万行、每 tile 64 行、persistent scheduler);图 12、图 13打包还带来第二个好处。每行的 softmax 在 tile 内就算完了,tile 之间不用传递归一化状态,所以系统可以一边算第 k 个 tile,一边加载第 k+1 个 tile。沿长序列切的 tile 属于同一行,tile 之间要维护 softmax 归一化状态,彼此并不独立。
单测 attention 的结果可以分两层看。这组测试的规模是 16384 条序列、64 个 head、每个 head 64 维,总共约一百万条短行。row-tiled attention 在前缀长度为 1 时用 0.142 ms,前缀长度到 8 也低于 0.85 ms。前缀长度不超过 4 的主要区间里,它比快手早期一行一个工作单元的版本快 7.2–9.4 倍。两者每行做的计算一样,这说明行数很多时,一行一个工作单元的调度和启动开销占了大头,把行打包、让 tile 重叠执行省的就是这部分。同一组测试里,它比 PyTorch 的 SDPA 路径最多快 154.4 倍,SDPA 的耗时在短前缀范围内几乎不随前缀长度变化。这说明通用路径的时间大多花在固定的 tile 处理上,真正有用的那几次点积占比很小。
按每一步的形状分别编译执行计划
手机这个请求每一步的形状,在部署配置定下来时就全知道了(示意,BoS 算前缀的第 1 位):
| 步骤 | 读的前缀长度 | 进来的行数 | 每行候选数 | 留下的行数 |
|---|---|---|---|---|
| 第 1 步 | 1 | 1 | 4 | 2 |
| 第 2 步 | 2 | 2 | 4 | 2 |
| 第 3 步 | 3 | 2 | 4 | 2 |
大模型引擎每一步调用的都是同一个编译好的接口,于是只能为它编一个对所有位置都有效的计划。放到这张表上,这个计划得同时兼容前缀长度 1 到 3、行数 1 到 2,softmax 的长度只能在运行时才定。每一步实际的形状都很窄,计划却按三步的并集来做优化。
step-granular planning 把这张表变成编译产物,分三段走。先从 PyTorch 训练图建一张什么形状都能表示的宽泛计算图。接着在编译期从第 1 步到最后一步空跑一遍(dry run),把每一步产出的张量维度记下来,作为下一步的输入。最后按每一步的维度生成各自专门的计算图。请求数随流量变,这个维度保持动态,所以编译产物仍然能接不同的流量。
这张形状表会直接传给前面讲的 kernel。第 3 步的前缀长度已知是 3,引擎就可以给这一步绑定 softmax 长度固定为 3 的 attention 版本,不用再为可变长度留余地。每步的候选宽度和保留 beam 宽也已知,候选选择同样可以按具体形状来编译。
对照实验用的是 HomoGen,它保留全部专用 kernel,只把按步编译换回单一形状的计划。在 OneModel、batch 32 下,平均解码延迟从 RecoGEM 的 30.4 ms 升到 39.5 ms。OneModel 的 SID 有 4 位,前三步的延迟都高出 40% 以上。论文的解释是,前几步的保留 beam 宽和候选宽度各不相同,单一形状的计划和这几步实际的形状差得最多,所以按步编译的收益主要落在前几步。
两段式 Top-K:从 420 万个分数里挑候选,结果不变
每一步打完分,下一步要等 beam search 选出幸存前缀才能开始,所以选择的快慢直接算进延迟。大模型通常只选不到 10 个 token,GR 每步通常要选 128 个以上的前缀。最直接的做法是把一个请求的分数矩阵(W 个前缀,每个前缀接 C 个编号)摊平成一行,跑一次大的 Top-K。这样做结果是对的,但 W=512、C=8192 时摊平后有约 420 万个分数,FP16 下占 8 MiB,远超 GPU 一个线程块的本地内存,选择就变成了反复读写慢得多的全局显存。
RecoGEM 的办法是分两段选:第一段在每个前缀的那一行里各取前 K 个,第二段在所有留下来的分数里再选 K 个。回到手机这个请求的第 2 步(示意,K=2):
第 0 行(手机):9, 8, 3, 1   → 行内留下 9, 8
第 1 行(家电):7, 6, 5, 2   → 行内留下 7, 6
合并 9, 8, 7, 6,再选前 2 个   → 9, 8
第一段把 8 个分数减到 4 个,最后选出的 9 和 8 正是前面中间产物里的「手机-iOS」和「手机-Android」。家电那一行的 5 被丢掉是安全的,因为同一行里已经有 7 和 6 比它高,它不可能进入全局前 2。
第一段丢掉的分数在同一行里已经被 K 个分数压过,所以两段式选出的结果和全局 Top-K 完全相同。
两段的计算形状不一样,RecoGEM 用了两条路径。第一段是很多条宽度有上限的独立行,每行分数放进共享内存,用 radix 方法按数值区间逐轮收窄,多行可以挤在一个线程块里(论文叫 flash radix)。第二段是请求级的一条宽行,它被切到多个线程块上分别选前 K 个,再合并结果(multi-block radix),道理和上面一样,各块的前 K 个合起来一定包含全局前 K 个。
在词表 8192 的单测里,batch 32、beam 512 时 RecoGEM 用 0.618 ms,比 PyTorch ATen 快 2.08 倍,比不按行切开的标准 radix 快 1.70 倍。beam 1024 时用 1.307 ms。靠两两比较交换的 Bitonic 路径在 K 到 1024 时比 RecoGEM 慢 20.6–26.6 倍。这说明在 GR 这种大 K 选择里,选错算法的代价能到二十多倍,选对 radix 之后,按行切开的做法还能再快 1.70 倍。
端到端吞吐是 GeneralGen 的 1.84 到 2.88 倍
端到端的对比用了两个线上模型,OneRec-v2(4B 参数)和前面的 OneModel(0.2B 参数),下表固定在 batch 32。这里比的是 RecoGEM 和 GeneralGen,后者保留 RecoGEM 的其余模块,只换成单一形状的计划和普通 kernel。
| 模型(batch 32) | RecoGEM P99 | RecoGEM QPS | GeneralGen P99 | GeneralGen QPS | QPS 倍数 |
|---|---|---|---|---|---|
| OneRec-v2(4B 参数) | 61.5 ms | 526 | 112.5 ms | 286 | 1.84× |
| OneModel(0.2B 参数) | 30.8 ms | 1,053 | 89.0 ms | 366 | 2.88× |
OneRec-v2 的生产目标是 P99 不超过 100 ms。RecoGEM 在 batch 1 到 32 的整个扫描范围内都低于这条线,GeneralGen 到 batch 32 时已经超过。这说明对 4B 参数的 OneRec-v2,按形状优化决定了 batch 开到 32 时还能不能守住延迟目标。两个倍数都是和自家 GeneralGen 比的,回答的是「按形状特化值多少吞吐」,同一个模型的推荐效果不在这组对比里。
和外部方案比,RecoGEM 领先得更多。TorchEager(PyTorch 动态图直接跑)和改造后的 TensorRT-LLM 在两个模型上延迟都明显更高、吞吐明显更低。TensorRT-LLM 的延迟随 batch 上升很快,QPS 很早就到顶,这和前面说的 CPU 上做 beam search、再重排 KV cache 的开销方向一致。
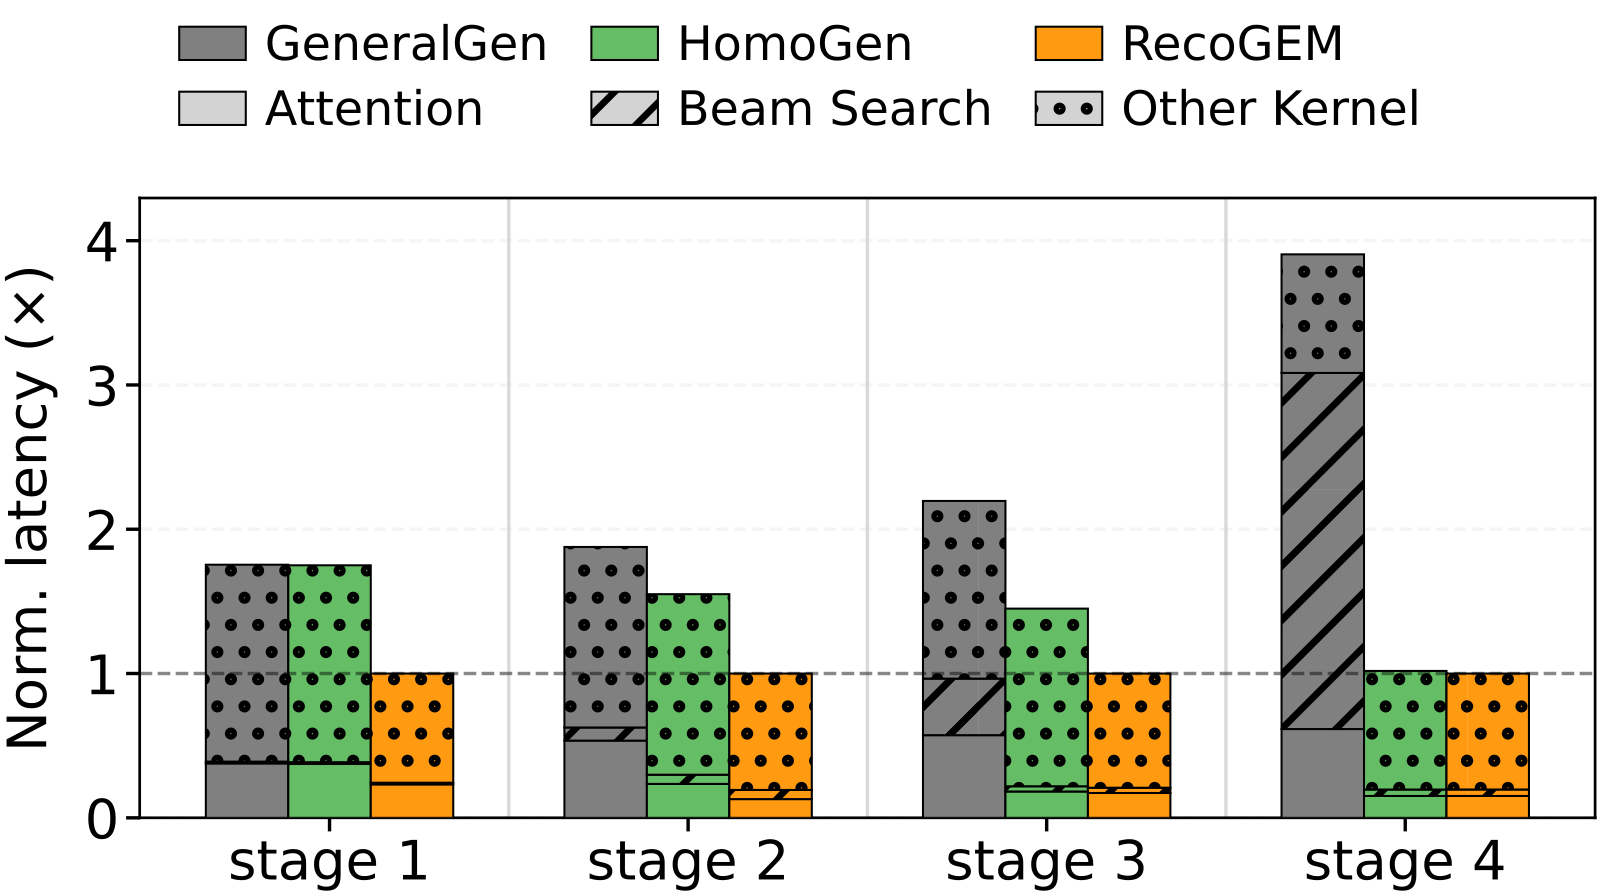
OneModel 的 SID 有 4 位,按步拆开看,两类优化的收益分布在不同位置。按步编译的收益主要在前几步,前面已经讲过。专用 attention 和候选选择的收益主要在后面几步,最后一步 RecoGEM 用 13.8 ms,GeneralGen 用 54.0 ms,多出来的时间主要花在候选选择上。这说明整体差距能落到具体某一步、某一段计算上。
上线以后,瓶颈回到稠密解码
论文最后给了一组瓶颈变化的数字,正好回到开头「算力花在哪」的问题。传统打分模型(DLRM)的服务里,稀疏 embedding 查找和特征物化常常占总延迟的 50% 以上,快手的 GR 部署里 embedding 查找不到 10%。另一个 GR 服务系统 xGR 报告候选选择占服务时间的 40% 以上,RecoGEM 优化之后,即使候选集很大,这一项也降到 10% 以下。按作者的说法,GR 的成本先搬到了解码器和候选选择上,候选选择优化完以后,压力又回到稠密的解码计算。
作者认为这些优化依赖的是负载的形状,和推荐语义关系不大:解码步数少、短序列很多、每步从固定词表里选。按这个说法,生成式检索这类负载也能用上同样的 kernel。
这篇留给同行的判断很具体:GR 的压力落在海量短注意力行和每一步的大 K 选择上,长 KV 不是这里的瓶颈。大模型框架的循环把各步的差别藏了起来。RecoGEM 把步与步的边界露出来,每一步的 attention、候选选择和执行计划才能各自按这一步的形状来做。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Infra · 2026-11-13Evolving Infra: Agent-Adaptive LLM Serving at ScaleAgent 负载给推理集群出了两道难题。有的 agent 偏 prefill,有的偏 decode,比例还随时间漂移,固定的 prefill 和 decode 节点配比总有时段吃亏。上下文压缩和子 agent 又改变了哪些 KV 值得留:子 agent 跑了几分钟回来,提示几乎全能复用之前的 KV,刚压缩完上下文的请求却大多用不上。按最近访问时间淘汰 KV,正好删错。Evolving Infra 把 KV 放进所有节点主存组成的共享池,节点切换 prefill 和 decode 角色时不用重启,也不丢缓存。在线规划器按负载组成调节点配比,KV 管理器按 agent 的分支是否还活着决定先淘汰谁。和 NVIDIA 的 Dynamo 相比,平均端到端延迟最多降 4.1 倍,P95 TTFT 最多降 14 倍。服务 agent 时,判断 KV 有没有用要看分支还在不在跑。
 Infra · 2026-10-26KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving长上下文推理会反复用到同一段前缀,比如系统提示、整份文档、代码仓库和多轮会话历史。这些前缀的 KV cache 早已放不进 GPU 显存和主机内存,只能落到硬盘上,下次命中再读回来,读盘就卡在了每一步推理的关键路径上。现有系统只读节点本地的 NVMe,集群早已挂载的并行文件系统却几乎闲着。这篇论文做了 KVStream:每块 KV 在本地盘和共享存储各写一份,读的时候两边同时读,谁先读完谁接着领下一批。接进 LMCache 实测,离线吞吐最高是 LMCache 的 1.49 倍,突发流量下平均 TTFT 最多快 6.1 倍。
 Infra · 2026-11-05Look Before You Launch: Learned Throughput Prediction for Hardware Selection in a Production Training Fleet同一个训练任务往往能跑在好几种加速卡上,跑在哪种上最划算,取决于它在每种卡上的吞吐。任务放错了卡照样能跑完、不报错,多花的钱没人察觉。LEAP(作者在生产机群上部署的选卡服务)在任务提交时就预测它在每种候选卡上的吞吐,再按每花一块钱能换来的吞吐给这些卡排序,每天给数万次训练任务选卡。它有 77% 的预测和实测吞吐相差不到两成。半年后,能换卡的训练 GPU 小时里有 95% 都由它排过序,作者估计因此省下约 3% 的训练算力成本。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…