目录 · 9 节
1它到底在解决什么问题?2整体流程3语义预训练:先学会「谁和谁像」4编码器注意力:专门看「上一个到这一个」5偏好蒸馏:把老师的打分拆到每个分叉上6这套方案真的更好吗?7我认为它的局限8一个推荐团队可以怎么试9一句话结论
用 SID 做生成式推荐的团队,手里通常还有一个效果不错的传统序列模型。电子科大这篇 REGER(显式建模物品间关系的生成式推荐框架)最值得借鉴的,是把这个传统模型的打分「拆」到 SID 前缀树的每一个分叉上,让生成模型在每一步不只知道正确答案是哪个 token,还知道其他分叉大概有多好。这一项单独加到 TIGER 上,Beauty 数据集的 Recall@10 从 0.0673 提到 0.0794,每轮训练从 19 秒变成 23 秒,推理时间不变;在完整的 REGER 里去掉它,三个数据集的 Recall@5 下降 10.9% 到 18.0%,是三个模块里影响最大的。另外两个模块,一个是让模型先学会「哪些物品内容相似」的预训练,一个是让编码器专门看相邻两次交互的注意力头,都是小改动,各自带来几个百分点。需要留意的是,实验全部在 Amazon 的小数据集上(Beauty 只有约 1.2 万个物品,历史截断到 20 条),老师模型选得不好时,前几位的推荐还会变差。
它到底在解决什么问题?
生成式推荐先把每个物品编成一串 SID,前面的 token 粗分、后面的细分,再让模型逐个 token 生成下一个物品。问题在于,用户偏好、物品相似度这些关系都定义在「物品」上,而模型的基本单位是 token,物品之间的关系只能靠模型自己从 token 里慢慢悟。论文把这个问题拆成三处:
| 环节 | 现在的做法 | 缺了什么 |
|---|---|---|
| 学物品语义 | SID 的 token embedding 随机初始化,模型从零训练 | 不知道哪些物品内容相似 |
| 编码用户历史 | 把历史物品的 SID 拼成一长串,做双向注意力 | 没有专门表达「上一个物品到这一个物品」的转移 |
| 生成下一个物品 | 交叉熵只告诉模型正确 token 是哪个 | 交叉熵不直接教模型比较其他候选的好坏,模型主要靠自己学 |
用一个示意场景贯穿全文:一个美妆用户先后买了洁面乳、化妆水、精华液,下一次买的是面霜。每个物品编 4 个 token,第 1 个 token 区分「护肤」和「彩妆」,第 2 个区分品类,第 3 个区分具体款,第 4 个只用来区分 SID 完全相同的物品。
整体流程
| 阶段 | 做什么 | 解决哪个缺口 |
|---|---|---|
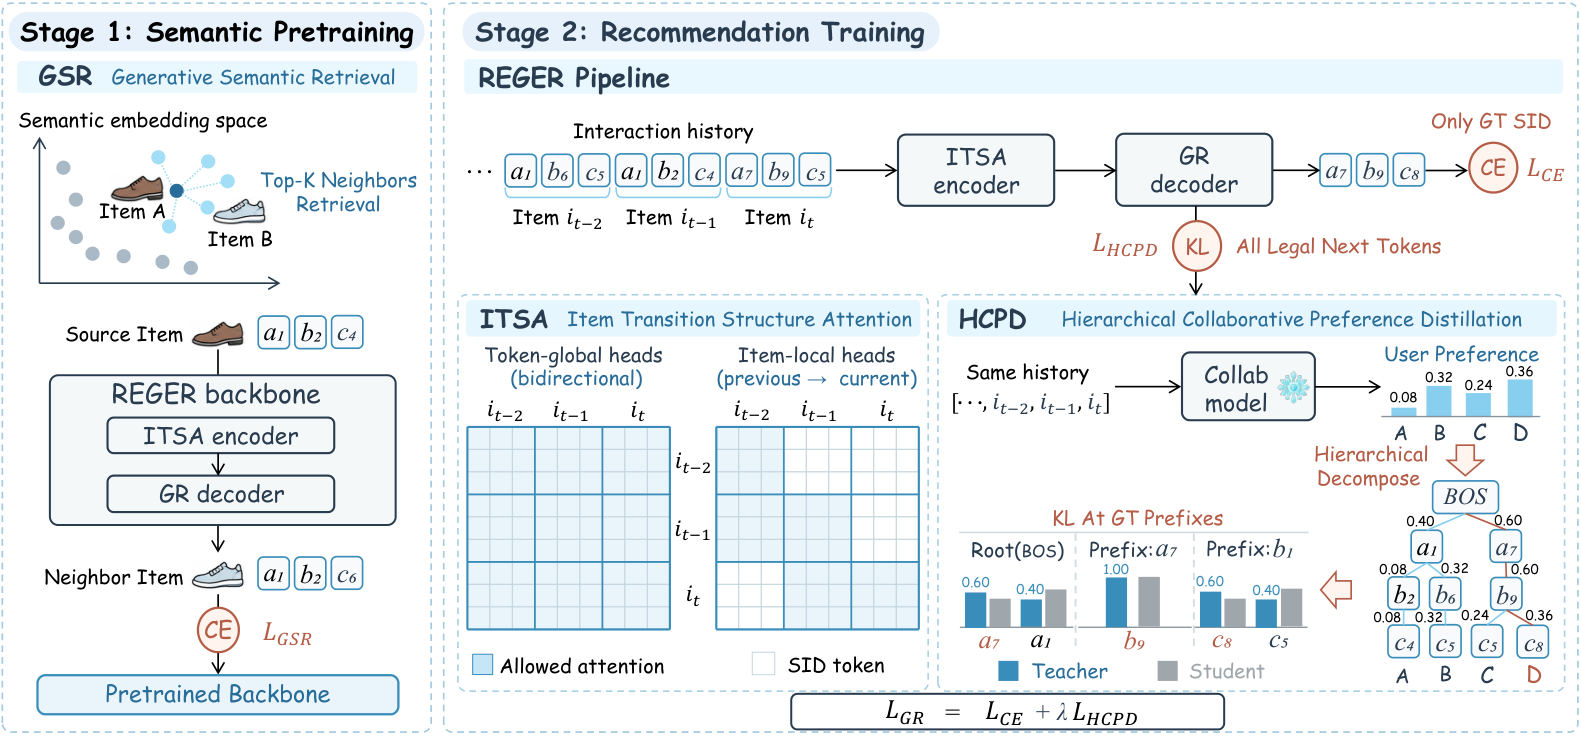
| 第一阶段:语义预训练(GSR) | 输入一个物品的 SID,让模型生成它内容最相近的物品的 SID | 学物品语义 |
| 第二阶段:推荐训练 | 编码器用新的注意力结构(ITSA),损失是交叉熵加偏好蒸馏(HCPD) | 编码历史、生成下一个物品 |
推理时和普通 TIGER 一样做 beam search,不需要老师模型,也不多任何模块。
语义预训练:先学会「谁和谁像」
为什么要做?从零训练的模型,token embedding 是随机的。两个都是面霜的物品,SID 前缀可能相同,但模型并不知道它们在内容上有多像,只能等用户行为慢慢教。交互少的物品尤其吃亏。
怎么做?用物品文本的 embedding(也就是给 RQ-VAE 做量化的那份)算余弦相似度,给每个物品找最近的 10 个邻居。每一对「物品 i、邻居 j」都是一条训练样本:编码器输入 i 的 SID,解码器生成 j 的 SID。这一步完全不用用户行为。
示意:输入「某品牌保湿面霜」的 SID,要求生成「另一品牌修护面霜」的 SID。大量这样的样本训下来,模型用交叉熵学习生成邻居的 SID,从中学习物品之间的语义关系,编码器也学会了把一个物品的 4 个 token 当成一个整体来读。
预训练的检查点不是按预训练损失选,而是按推荐验证集效果选,因为目标是给后面的推荐打底。邻居数也是这样调的:10 个最好,增加到 20、50 反而变差,说明拉进太远的邻居会把不相关的物品也教成相似。
编码器注意力:专门看「上一个到这一个」
为什么要做?用户历史被拍平成一长串 token,普通的双向注意力里,每个 token 可以看所有 token,模型要自己判断哪些 token 属于同一个物品、哪两个物品是相邻的。而推荐里很关键的信号恰恰是相邻两次交互之间的转移,比如「买了化妆水之后买精华液」。
怎么做?把编码器每层的 6 个注意力头分成两种,只改注意力掩码,不加参数:
| 注意力头 | 每个 token 能看到什么 |
|---|---|
| 全局头 | 整个历史的所有 token |
| 局部头 | 只看自己所在物品的 4 个 token,加上前一个物品的 4 个 token |
用示意场景手推一遍。历史是「洁面乳、化妆水、精华液」三个物品,共 12 个 token。在每一层的局部头里,精华液的 4 个 token 只直接注意精华液和化妆水的 8 个 token;化妆水的 token 只直接注意化妆水和洁面乳;洁面乳是第一个物品,只直接注意自己。局部头仍可能间接读到更早的历史信息:前一层的表示可以带着这些信息,全局头也能把它们带进每层的输出。这样每个局部头都被迫回答一个具体问题:从上一个物品到这个物品,发生了什么转移。全局头则负责更远的上下文。
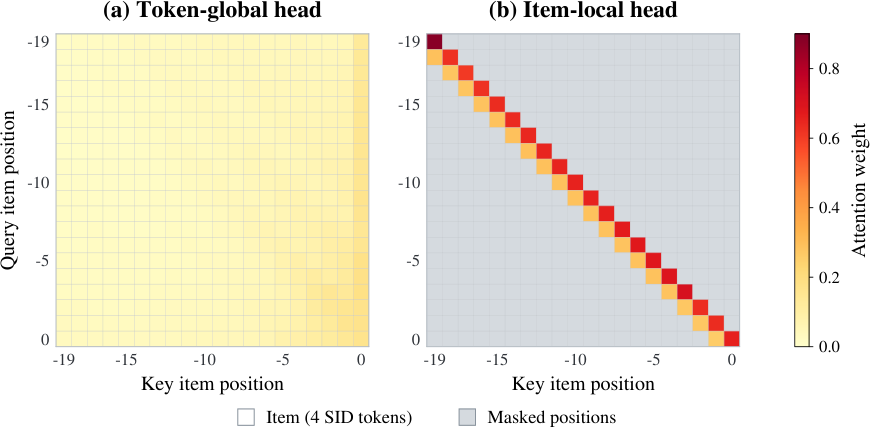
两种头的比例按数据集调:Beauty 是局部 2 个、全局 4 个,Sports 是 5:1,Toys 是 3:3,三者都比全用局部或全用全局好。论文图 4 把最后一层的注意力按物品聚合,局部头在对角线下方有一条清晰的斜带,说明它确实在稳定地看前一个物品。
偏好蒸馏:把老师的打分拆到每个分叉上
这是全文最核心、收益也最大的部分。
为什么要做?交叉熵只用真实 token 当目标,不直接教模型比较其他候选的好坏。但在推荐里,没被点到的物品并不都一样差:用户买了面霜,另一款面霜大概率也是好推荐,而口红就不是。传统的序列模型(论文用的是 DuoRec)能给全部物品打出这种分数,问题是怎么把物品级的分数变成每一步 token 级的监督。
怎么做?分三步:
| 步骤 | 做什么 |
|---|---|
| 老师打分 | DuoRec 不更新参数。它和学生读取当前样本的同一份用户交互历史,给全部物品打分,再做 softmax,得到老师对每个物品的偏好概率 |
| 拆到分叉 | 在正确答案的每个前缀上,把下一个 token 走同一个分叉的那些物品的老师概率加起来,再按这一步各分叉的总和换算成比例,得到老师认为下一步走每个分叉的概率 |
| 学生对齐 | 学生在同一个前缀上只看真实存在物品的那些分叉,把自己在这些分叉上的概率重新换算成加起来等于 1,再最小化它和老师分叉概率之间的 KL |
最终损失是交叉熵加上这个 KL 乘以一个权重,权重在 0.8 到 1.0 之间效果最好。
用一个能手算的例子看清楚。假设目录里只有 4 个物品,每个用两个 token 编码(示意):
| 物品 | SID | 老师概率(示意) |
|---|---|---|
| 面霜 A | (1, 1) | 0.4 |
| 面霜 B | (1, 2) | 0.1 |
| 口红 C | (2, 1) | 0.3 |
| 口红 D | (2, 2) | 0.2 |
用户真正买的是面霜 B,也就是 (1, 2)。
- 第 1 步,前缀为空。老师在分叉 1 上的概率是 A 和 B 之和 0.5,分叉 2 是 C 和 D 之和 0.5,所以老师分布是 (0.5, 0.5)。交叉熵只要求选 1,蒸馏则告诉模型「走 2 也不算太差」。
- 第 2 步,前缀为 (1)。只看 A 和 B:A 占 0.4 ÷ 0.5 = 0.8,B 占 0.1 ÷ 0.5 = 0.2。交叉熵要求选 2(也就是 B),所以蒸馏会告诉模型,在这一支下老师其实更看好 A。
交叉熵把模型钉在用户真实选择上,蒸馏则补上「其他分叉各有多好」的相对信息,两者互补。KL 对每个分叉 logit 的梯度正比于「学生概率减老师概率」,所以被学生低估的那个分叉会被直接往上推。
为什么学生只在真实存在物品的分叉上重新换算概率?因为词表里很多 token 在这个前缀下根本不对应任何物品。如果用全词表的概率去和老师比,损失里会多出一项「合法 token 总概率不够」的惩罚,它和老师无关,而且会偏向已经概率高的分叉。论文附录做了对照:用全词表概率的版本在 Beauty 上 NDCG@5 是 0.0382,重新归一化的版本是 0.0395。
理论上,作者证明了两件事:物品的偏好概率可以精确拆成沿 SID 路径的各步条件概率之积;物品级的 KL 可以精确拆成各前缀上条件 KL 的加权和,权重是该前缀下的老师概率总量。实际训练只在正确答案的路径上算,所以它是这个完整分解的一个近似,作者在附录里也明确了二者的差别。
这套方案真的更好吗?
先看主结果,Recall@10,三个 Amazon 2014 数据集:
| 方法 | Beauty | Sports | Toys |
|---|---|---|---|
| DuoRec(判别式,也是老师) | 0.0875 | 0.0493 | 0.0961 |
| TIGER | 0.0673 | 0.0432 | 0.0659 |
| ActionPiece(最强生成式基线之一) | 0.0772 | 0.0473 | 0.0729 |
| LIGER(生成加稠密检索的混合方法) | 0.0830 | 0.0480 | 0.0838 |
| REGER | 0.0870 | 0.0545 | 0.0934 |
REGER 在三个数据集、四个指标上都超过所有生成式和混合方法。和老师 DuoRec 比,Sports 上明显更好,Beauty 基本持平,Toys 的召回仍低于老师,但 NDCG 持平或略好。这说明学生在吸收老师偏好的同时,还用上了 SID 和语义预训练带来的额外信息,有时能反超老师。
再看偏好蒸馏单独的价值。把几种「用老师信号训生成模型」的方法都加到同一个 TIGER 上,老师都是 DuoRec:
| 方法 | Beauty R@10 | Sports R@10 | Toys R@10 | 每轮训练(秒) | 测试推理(秒) |
|---|---|---|---|---|---|
| TIGER | 0.0673 | 0.0432 | 0.0659 | 19 | 16 |
| + TCA-Aux | 0.0721 | 0.0455 | 0.0738 | 22 | 106 |
| + GFlowGR-TB | 0.0699 | 0.0436 | 0.0660 | 239 | 16 |
| + HCPD | 0.0794 | 0.0501 | 0.0823 | 23 | 16 |
偏好蒸馏(HCPD)效果最好,而训练只慢了几秒,推理完全不变。另外两种方法都有明显代价:GFlowGR-TB(把老师打分当作整条生成路径的终点奖励、再约束每条路径概率与奖励匹配的方法)每轮训练从 19 秒涨到 239 秒;TCA(用老师打分做 token 软标签的方法)推理时要沿前缀树逐步检查、只允许生成真实存在物品的 token,测试时间从 16 秒涨到 106 秒。对线上系统来说,「推理不变、训练小幅增加」和离线指标同样重要。
最后看消融,Recall@5:
| 变体 | Beauty | Sports | Toys |
|---|---|---|---|
| 去掉语义预训练 | 0.0537 | 0.0346 | 0.0557 |
| 去掉局部注意力 | 0.0566 | 0.0340 | 0.0579 |
| 去掉偏好蒸馏 | 0.0514 | 0.0318 | 0.0502 |
| 完整 REGER | 0.0594 | 0.0357 | 0.0612 |
这组消融里,去掉偏好蒸馏后,Recall@5 降得最多,说明它对完整模型很重要;另外两个模块在 Beauty 和 Toys 上贡献更大,Sports 上较小。
我认为它的局限
第一,数据规模很小。Beauty 只有约 2.2 万用户、1.2 万物品,历史截断到最近 20 条。老师要对全部物品打分再做 softmax,在百万、千万级物品的目录上,这一步要改成采样或只算候选子集,所以论文的结论能保留多少需要自己验证。
第二,老师选不好会有副作用。换成 SASRec 当老师时,Beauty 的 Recall@5 从不蒸馏的 0.0514 降到 0.0465,但 Recall@50 从 0.1685 升到 0.1759。原因是 KL 会把被学生低估的好物品往上推,也会把老师的错误排序一起搬过来,所以长列表召回变好、头部排序变差。
第三,调参点不少。局部和全局头的比例三个数据集各不相同(2:4、5:1、3:3),蒸馏权重在 0.8 到 1.0 之间变化,预训练检查点还要按推荐效果挑,因为每个超参都要按推荐效果单独调,换到新业务上调参成本不低。
一个推荐团队可以怎么试
- 优先试偏好蒸馏。拿现有的召回或精排序列模型当老师,在正确答案的每个前缀上,把老师给同一分叉下各物品的概率加起来换算成分叉概率,再和学生在合法分叉上的概率算 KL,权重从 0.5 到 1.0 扫一遍。
- 物品很多时,老师不要对全目录打分,先只在老师的前几千个候选上做 softmax,其他分叉记为零,看效果是否保住。
- 换老师前先做对比:同时看 Recall@5 和 Recall@50。如果长列表变好、头部变差,说明老师的排序精度不够,换更强的老师或调低权重。
- 再试局部注意力头。它不加参数、只改掩码,先从局部和全局各一半开始。
- 语义预训练放到最后,它对冷门物品多的业务更有用,检查点按推荐验证集挑。
一句话结论
判别式模型对全部物品的偏好,可以沿 SID 前缀树精确拆成每一步的分叉偏好;只在正确路径上做这种蒸馏,就能以几乎为零的推理成本,让生成式推荐学到「其他候选有多好」。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。生成式推荐只靠交叉熵时,训练目标不直接教模型比较候选的好坏,模型主要靠自己学 |
| 方法创新性 | 中高。分叉级偏好蒸馏有清楚的理论依据;预训练和局部注意力是常规思路的组合 |
| 实验证据 | 中。六个公开数据集、十多个基线、训练和推理耗时都有;但数据都是小规模学术集,没有线上实验 |
| 工程成本 | 低到中。推理不变,训练略增;老师全目录打分在大目录上需要改造 |
| 是否值得尝试 | 值得,尤其是已有强序列模型、正在上生成式召回的团队,先单独试偏好蒸馏 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…