目录 · 9 节
1它到底在解决什么问题?2整体流程3两个目标分开预测,上线时再合并4为什么奖励要用“相对于线上的提升”5离线评估:按剩余天数怎么分配成本权重6线上结果7我认为它的局限8一个广告或推荐团队可以怎么试9一句话结论
广告自动出价系统里,PID(比例-积分-微分)控制器每隔几秒根据花费进度调整出价,但同一套控制参数要同时服务几十万个预算、周期、流量各不相同的广告计划。Pinterest 没有让强化学习直接出价,而是每天给每个计划从 9 组参数倍数里挑一组,在默认值上下各调一小档,PID 照常跑。七天的线上 A/B 中,有效点击成本 eCPC 显著下降 0.25%,收入基本不变;上线后两个月,对比留出流量,距离结束还有一周以上的计划 eCPC 低了近 1%。
做出价和预算控制的团队值得读这篇,价值主要在部署方式:强化学习只决定“今天用哪组参数”,结果写成一张查找表,线上不加载任何模型,最坏情况也只是参数偏离默认值一小档,安全边界很清楚。但要看清它的限制:折扣因子设成 0,学到的其实是“每天选一个动作、只看当天结果”的上下文 bandit,跨天的取舍完全交给人工设计的权重曲线;线上收益只有千分之几,上线后的长期数据也没有做显著性检验。
它到底在解决什么问题?
PID 控制器是工业界最常见的预算平滑工具。它盯着“实际花费进度”和“目标花费曲线”之间的差距:比例项看眼前差多少,积分项看一路累积差了多少,误差越大,出价调整越猛。系数 、 决定反应的力度。
问题在于,同一组系数不可能对所有计划都合适。用一个计划的生命周期说明(示意):
| 时间点(示意) | 计划状态 | 更合适的控制方式 |
|---|---|---|
| 投放第 3 天,还剩 7 天 | 没花完的预算可以滚到后面 | 反应温和一点,少为追进度去抢贵的流量,压低单次点击成本 |
| 投放第 9 天,还剩 1 天 | 剩下的预算过了今天就作废 | 反应积极一点,优先把预算花出去 |
| 预算很大的计划 | 流量需求高,波动大 | 可能需要和小预算计划不同的力度 |
固定参数只能在这些情况之间折中。论文的做法是保留 PID,但每天早上按每个计划的状态替它挑一组系数。
整体流程
| 环节 | 做什么 | 频率 |
|---|---|---|
| 状态 | 计划 ID 的 embedding、剩余天数、日预算、目标花费曲线、前一天的 CTR、CPC 和收入 | 每天一次 |
| 动作 | 和 各乘以 、1 或 三档之一,共 9 种组合;微分项固定不动,因为它的误差信号噪声太大 | 每天一次 |
| 决策 | 一个两头的 Q 网络,分别预测每个动作对“预算花出率”和“CPC”的相对变化,再按剩余天数加权合并 | 每天零点跑一次 |
| 服务 | 结果写成一张“计划到参数”的查找表,出价系统每隔几秒查表,用这组参数跑 PID | 秒级 |
| 探索 | 每个计划划出一小部分预算和独立的用户桶,随机选动作,用于积累训练数据 | 持续 |
论文里 的例子是 0.2,也就是在默认值上下浮动 20%。动作空间刻意做得很小,目的就是把线上探索限制在已验证配置附近。
两个目标分开预测,上线时再合并
预算花出率和 CPC 天然冲突:出价高,预算花得快,但每次点击更贵;出价低,CPC 好看,但预算可能花不完。常规做法是把两个奖励加权成一个数再训练,但这样权重一改就要重训。
论文让网络的共享主干后接两个输出头,一个预测预算花出率的变化,一个预测 CPC 的变化,训练时两个头各算各的损失。到了推理时才合并:
是计划剩余的天数, 是成本权重,剩余天数越少权重越小,策略也就越来越偏向“把钱花出去”。
手算一个例子(示意)。两个候选动作:动作 A 让预算花出率提高 1%、CPC 提高 2%;动作 B 让花出率不变、CPC 降低 1%。离结束还早时,取 :A 得分 1−2=−1,B 得分 0+1=1,选 B,省钱优先。快结束时,取 :A 得分 1−0.2=0.8,B 得分 0+0.1=0.1,改选 A,花钱优先。同一个模型,只换权重就换了策略,不用重训。
选动作时也不直接取分数最高的那个,而是保留得分前 K 的动作,用带温度的 softmax 抽样。这样每天的决策带一点随机性,不会所有计划同时挤到同一个动作上。
为什么奖励要用“相对于线上的提升”
直接用 CPC 的绝对值做奖励,会遇到两个问题。第一,不同动作之间的差别相对于 CPC 本身太小,比如 1.01 美元和 1.00 美元,网络很难学会给这些动作排序。第二,不同计划的 CPC 从几分钱到几十美元都有,误差大的计划会主导整个损失;而预算花出率又被限制在 0 到 1 之间,两个目标的量级完全不同,合并时权重很难调。
论文的办法是把奖励定义成“这个动作的结果相对于线上默认配置的变化比例”。这样一来,所有计划、两个目标都落在可比的尺度上,合并权重也不用再去补偿量级差异。
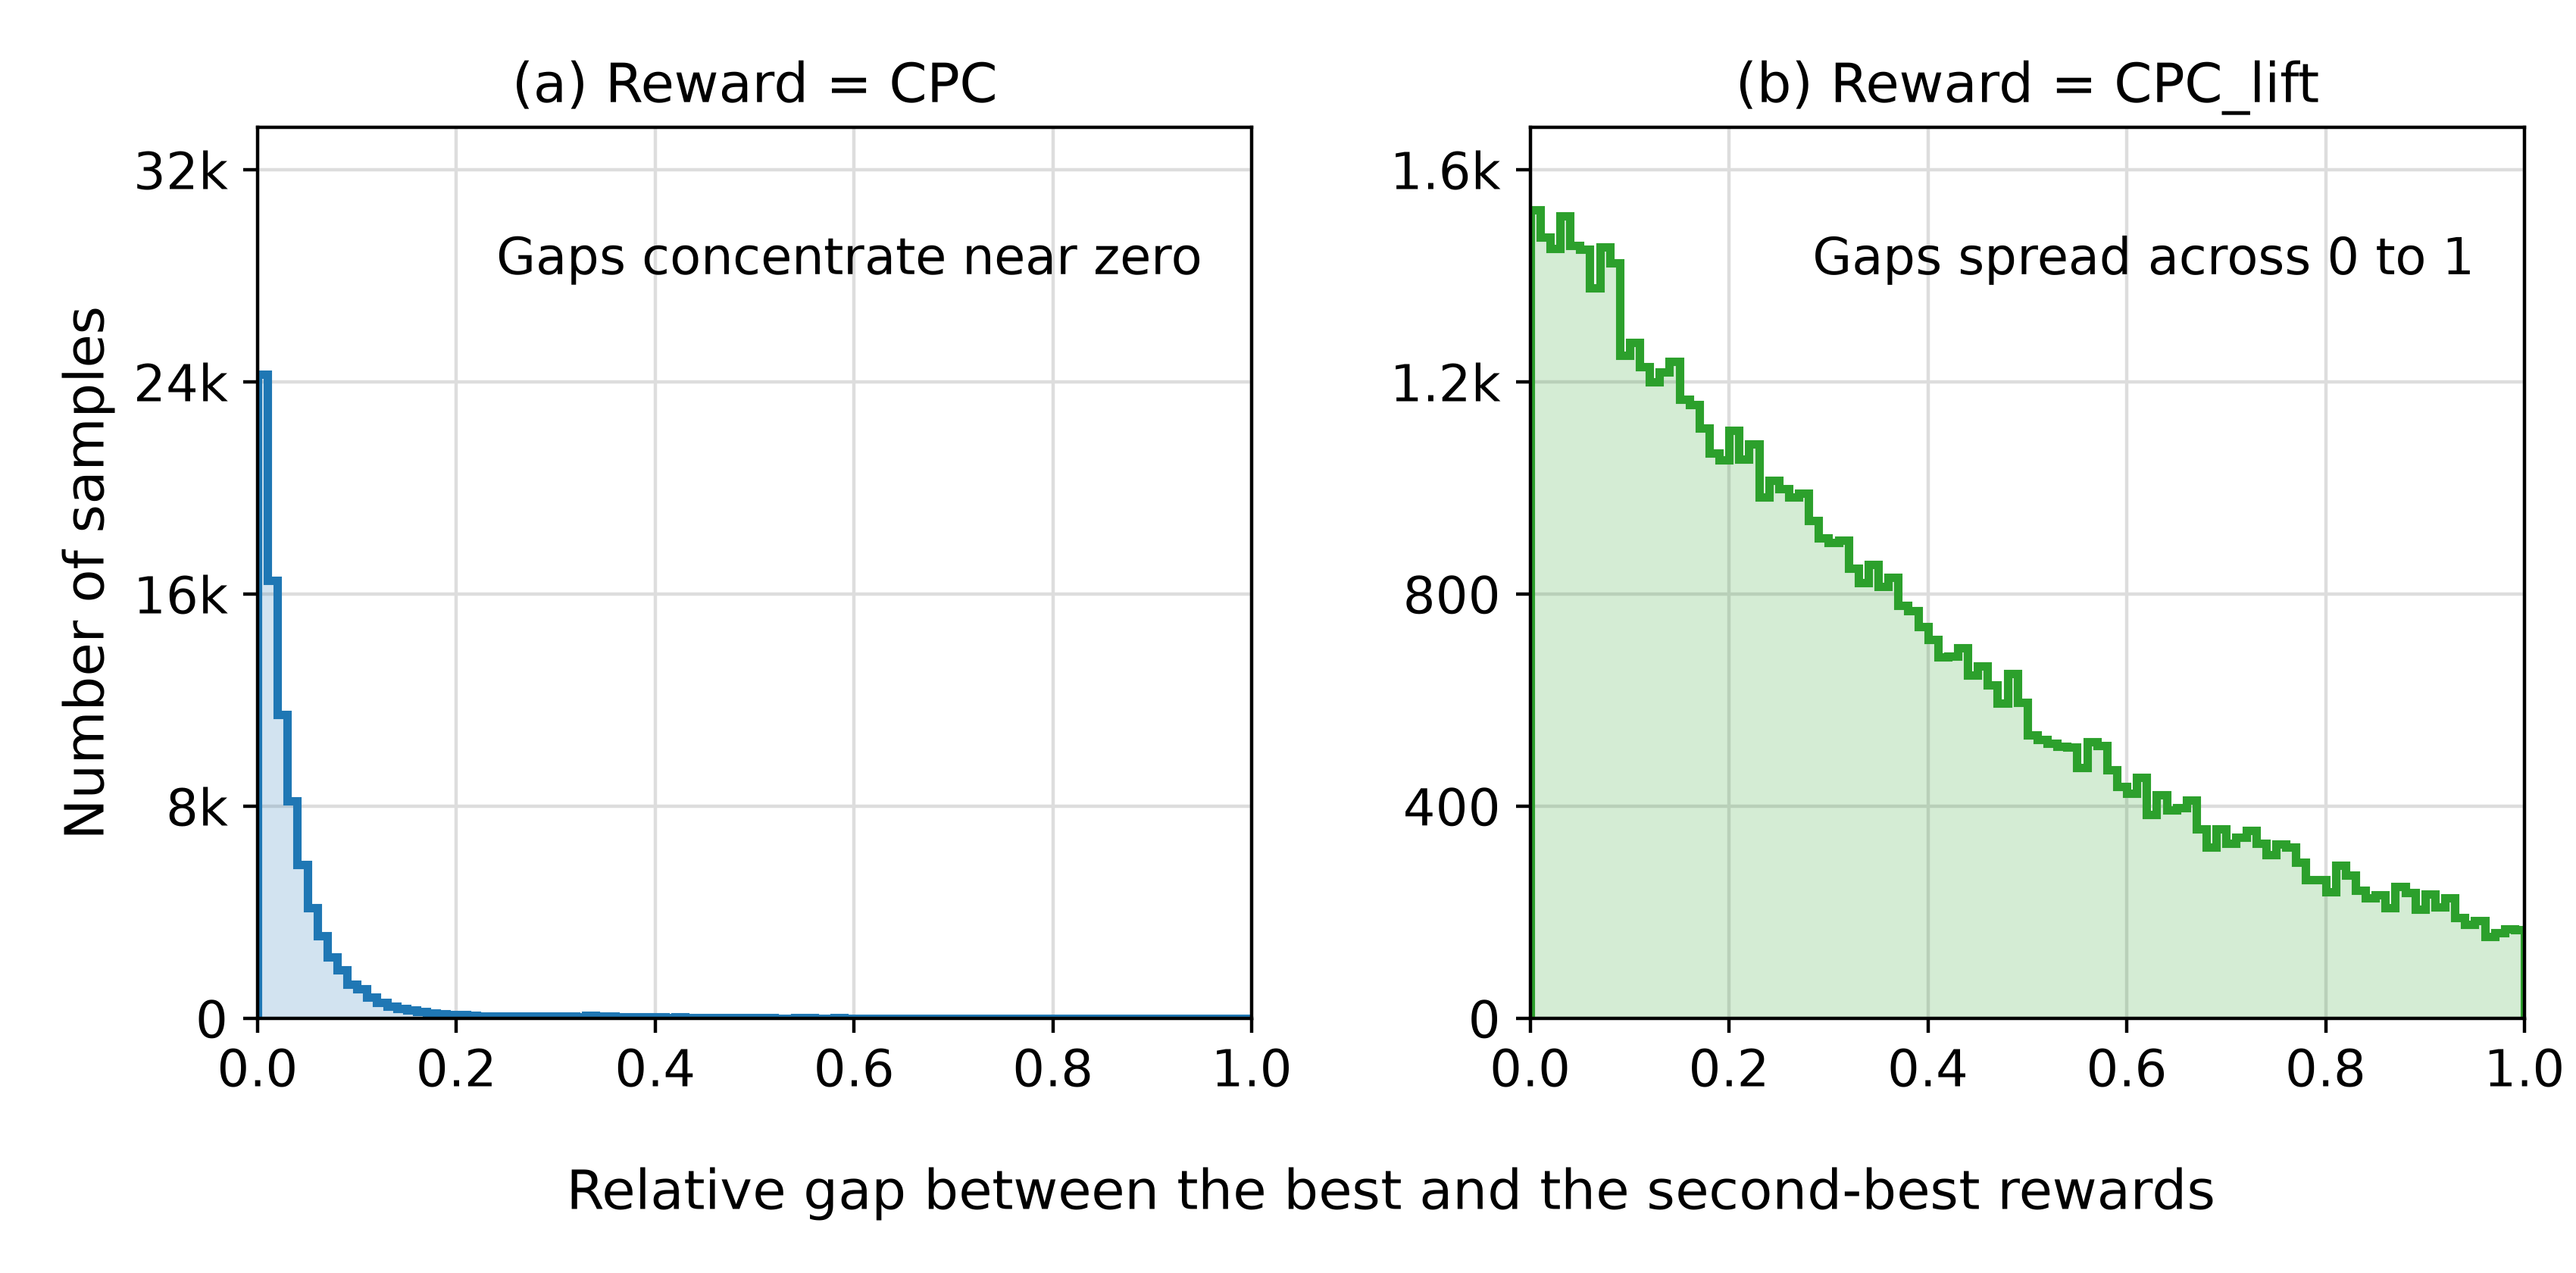
离线消融显示,这个改动影响很大:用绝对值奖励时,计划最后一天的收入提升只有 0.08%;换成相对提升后是 2.77%,其他日子的 CPC 降幅也从 2.17% 扩大到 3.02%。这些数字来自离线的重要性加权估计,绝对值不能直接当成线上收益,但方向很明确。
离线评估:按剩余天数怎么分配成本权重
离线评估用的是随机探索流量的日志:21 天训练、7 天评估,用重要性加权(IPS)估计新策略相对线上配置的提升。IPS 的思路是给日志里的每条记录重新加权:探索时每个动作被随机选中的概率是 1/9,如果新策略在同样的状态下会以 0.5 的概率选这个动作,这条记录的结果就乘以 0.5÷(1/9)=4.5;新策略根本不会选的动作,权重就是 0。所有记录加权平均,就得到“如果当时用新策略,结果会怎样”的估计。因为探索日志里每个动作的概率是已知且相同的,这个估计没有系统偏差,代价是方差较大,这也是下面逐日曲线色带很宽的原因。
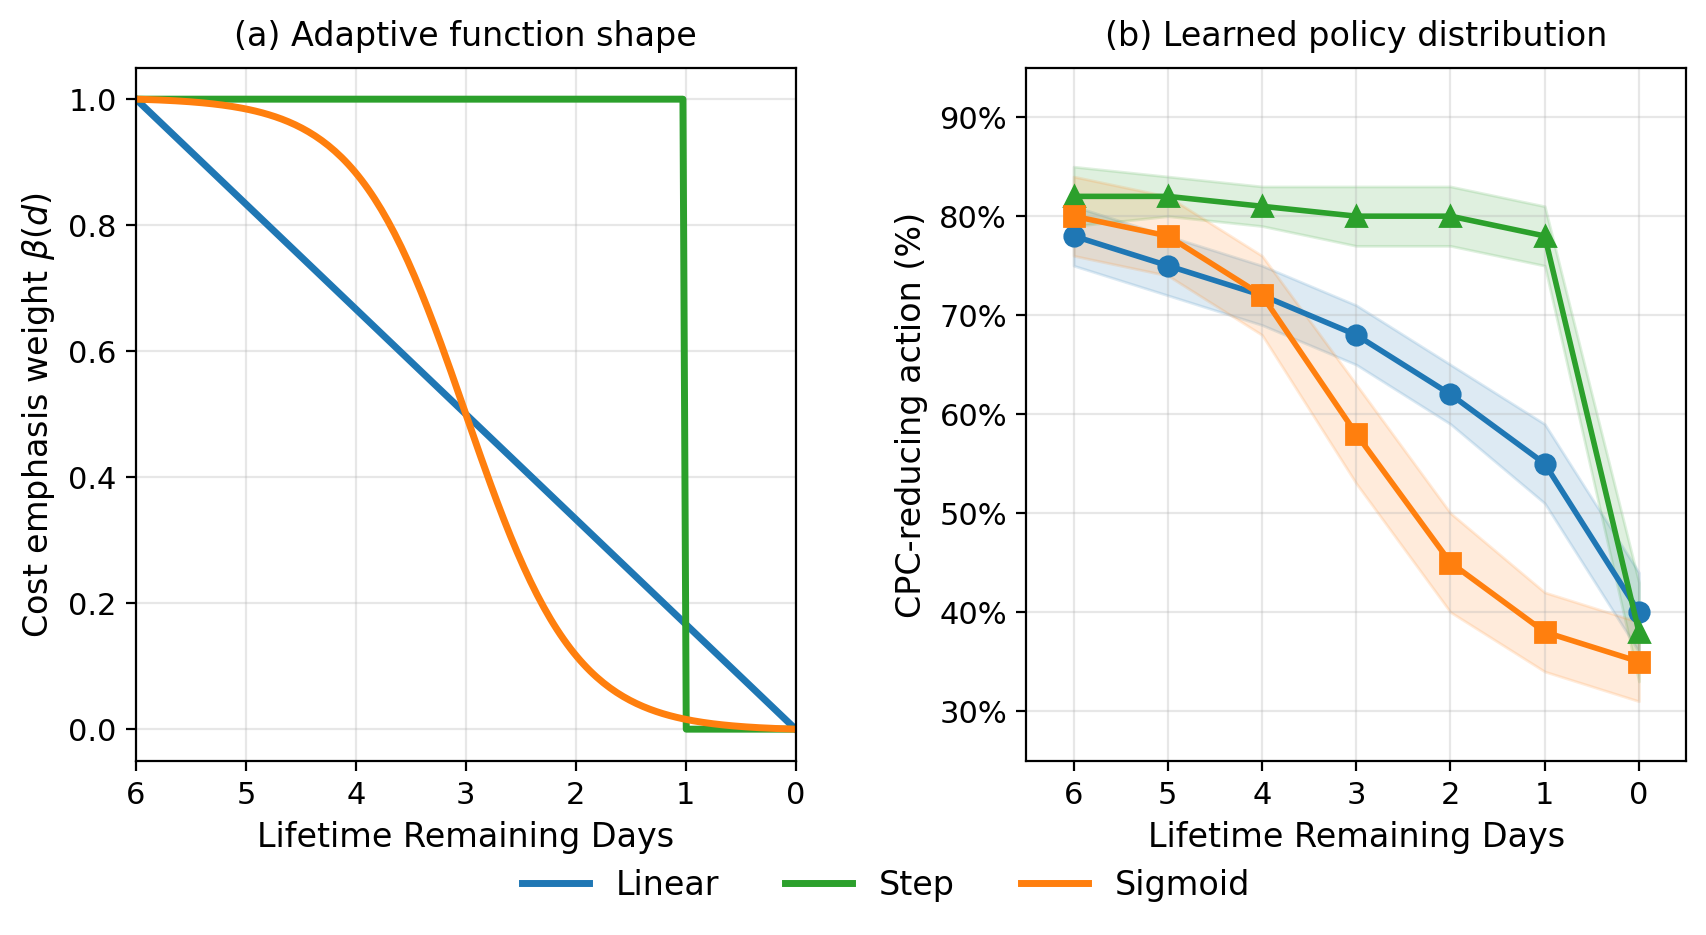
成本权重随剩余天数变化的形状,作者比较了三种:最后一天突然切换的阶梯函数、线性递减、以及介于两者之间的 S 形曲线。
| 权重形状 | 收入变化 | CPC 变化 |
|---|---|---|
| 阶梯 | -1.11% | -1.23% |
| 线性(上线选择) | +0.05% | -0.34% |
| S 形 | +1.41% | +0.49% |
只有线性曲线同时做到收入不降、CPC 下降,所以上线用了它。不过线性方案的收入变化只有 +0.05%,几乎就是零;它的胜出更像是“唯一没有在任何一项上变差的方案”,而不是在两项上都明显领先。
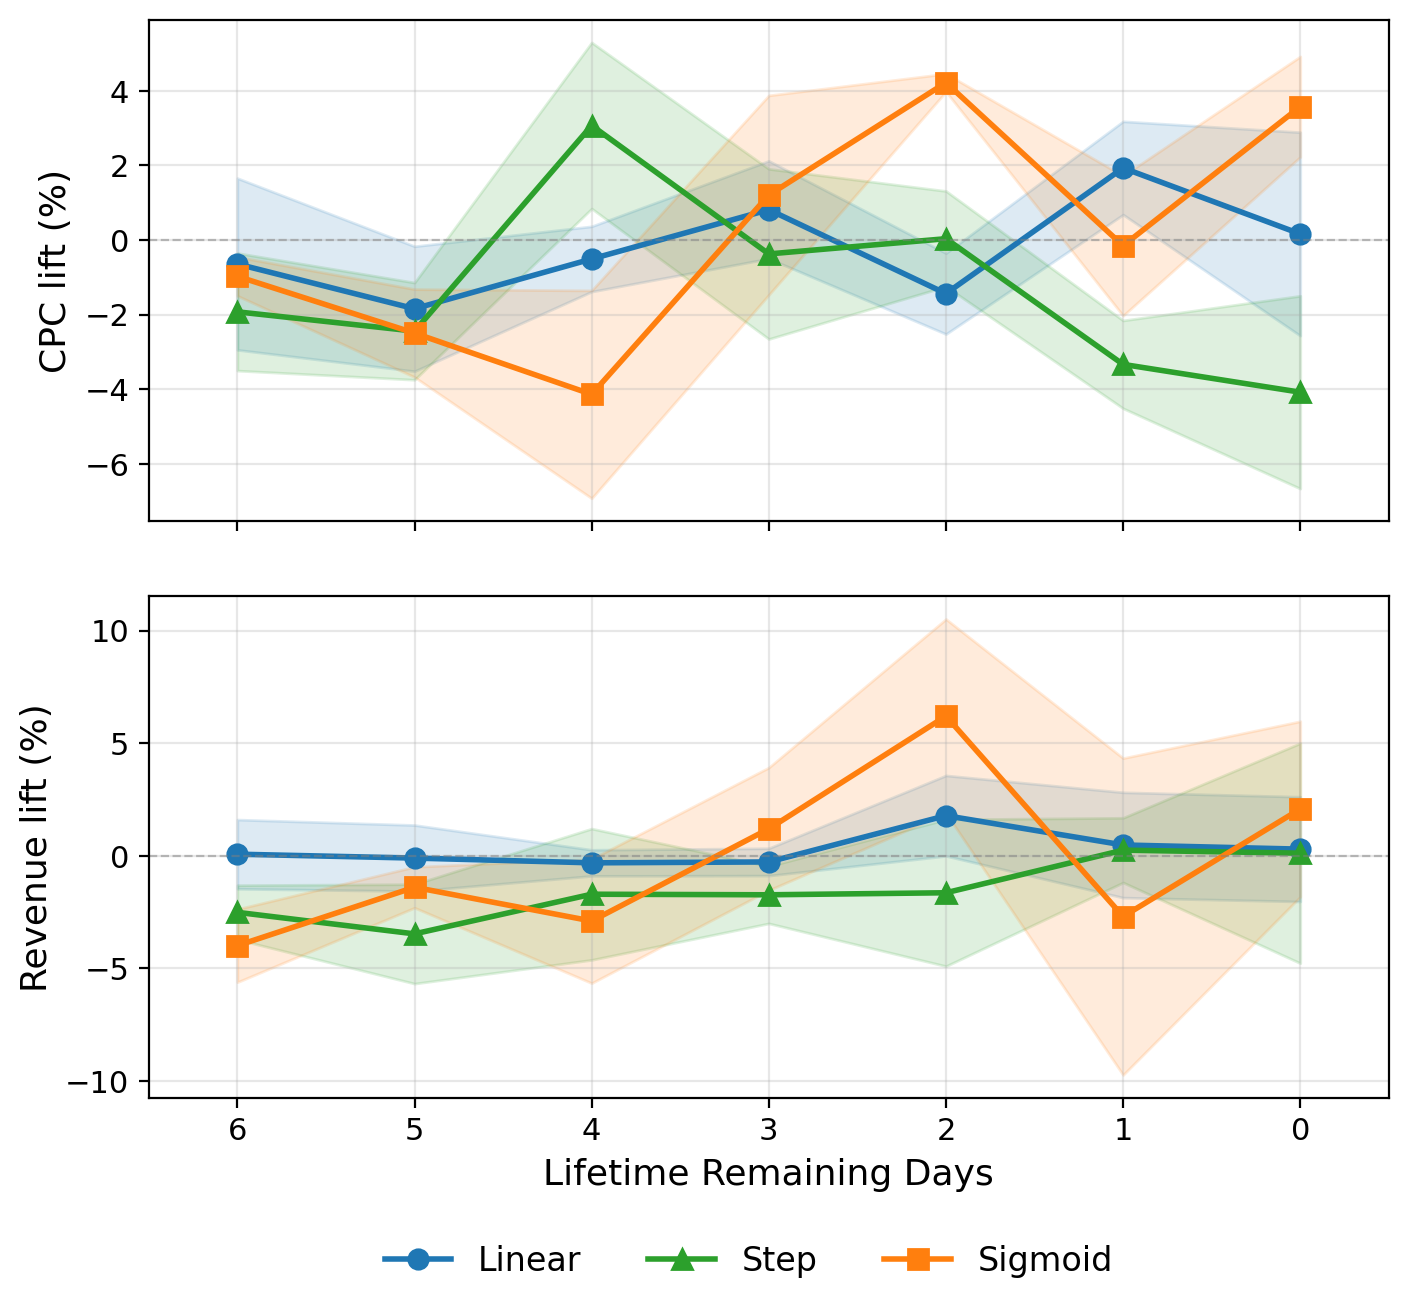
逐日拆开看,三条曲线的色带在大多数天都跨过 0,单看某一天的数字没有意义,只有汇总后的方向比较可靠。
线上结果
七天的线上 A/B 对比的是同一套服务设施上的默认参数:
| 指标 | 全部计划 | 实验期间结束的计划 |
|---|---|---|
| 收入 | 持平 | +0.43% |
| 点击 | +0.19% | +0.25% |
| eCPC | -0.25%(显著) | +0.18% |
全部计划上,eCPC 下降 0.25% 且显著,收入不变,相当于同样的钱买到了更多点击。实验期间结束的计划,收入和点击上升、eCPC 略升,符合“快结束时优先花钱”的设计意图。
按预算和历史 CPC 分组,所有分组的 eCPC 点估计都是下降的,降得最多的是大预算计划(-0.90%,点击 +0.81%)和高 CPC 计划(-0.64%)。这和直觉一致:这两类计划的调参空间最大。
上线后两个月,作者对比了一小块继续用默认参数的留出流量。距离结束还有一周以上的计划,eCPC 低了近 1%,预算花出率略低;不到一周的计划,花出率反过来略高,eCPC 仍然更低。这说明线性权重确实让策略在计划后期从省钱转向花钱。但留出流量太小,作者没有做显著性检验,只能当作方向参考。
我认为它的局限
第一,“强化学习”在这里其实是上下文 bandit。折扣因子设成 0,模型只预测今天这个动作对今天结果的影响;今天多花钱会让明天剩余预算变少,这种跨天影响完全没有被学到,只靠人工设定的线性权重去近似。作者在讨论里也承认,多步设定下两个头的合并不再有最优性保证。
第二,收益很小,有些数字只是方向性的。全部计划上 eCPC 降 0.25%;实验期间结束的那批计划 eCPC 反而升了 0.18%;上线两个月的数据没有显著性检验;离线消融里上线方案的收入提升只有 0.05%。对这个规模的平台来说千分之几也有实际价值,但不能把它理解成明显的效果提升。
第三,探索成本要自己摸索。随机探索需要从每个计划里划出一部分预算和独立的用户桶,划多少、 取多大、top-K 保留几个动作,都要在自己的系统里试出来;作为奖励基准的“线上默认配置下的结果”如何与探索记录一一匹配,也需要专门设计。这些设置决定了探索会牺牲多少收入,也决定了离线 IPS 估计的方差有多大。对于计划数量少、单个计划预算小的业务,探索流量可能不足以让 9 个动作都被充分采样。
一个广告或推荐团队可以怎么试
- 先确认问题存在:把计划按剩余天数、预算大小分组,看固定 PID 参数下各组的花出率和 CPC 是否有系统性偏差。如果各组表现差不多,调参的空间就很小。
- 划出一小块独立预算和用户桶做随机探索:、 各取三档,每天随机分配,记录“状态、动作、当天花出率、当天 CPC”。
- 训练一个两头的回归模型,预测每个动作相对默认配置的变化比例;先用 IPS 在留出的探索日志上评估,再决定是否上线。
- 合并权重先用简单的线性递减,按剩余天数从成本优先过渡到花出优先;上线形式保持“每天一张查找表”,出价系统不加载模型。
- 设好兜底:一旦某计划花出率或 CPC 偏离阈值,当天退回默认参数。
一句话结论
让强化学习替 PID 挑参数、而不是替它出价,是一个在线上风险和收益之间很稳妥的折中,值得借鉴的是这种部署形态,而不是千分之几的收益数字。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。固定的预算控制参数难以适配各类计划,是出价系统里普遍存在的问题 |
| 方法创新性 | 中。参数级强化学习在控制领域早有先例;双头预测加推理时合并、相对提升奖励是实用的工程设计 |
| 实验证据 | 中。有七天线上 A/B 和两个月上线数据,但收益很小,长期数据未做检验,部分细节未公开 |
| 工程成本 | 低到中。线上只多一张查找表;主要成本是持续的随机探索预算和每天的训练、推理任务 |
| 是否值得尝试 | 值得,尤其适合已有 PID 平滑、计划类型差异大的系统;先从小范围探索和离线 IPS 评估做起 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…