目录 · 5 节
1不动推荐模型,只在分数上加一个两方向的修正2先在前一天把修正项学好,今天只做校准3按用户画像分给 8 组系数,让同一个视频对不同用户修正不同4提升的大头来自先在前一天预训练5收益不大,MF 上输给类目分组,推理慢了约 10 倍
SAGE-PAIR 这篇论文说明:新一天的标注只有千分之五时,与其拿它去学新参数,不如只校准一个前一天就学好、物品侧只有两个方向的分数修正项。
推荐系统通常按天滚动更新。新的一天开始后,线上模型照常给用户排视频,但用户点没点、要等结果回流才知道。到下一次排序更新时,能拿到结果的曝光只占当天的很小一部分。这篇论文考察的预算是 0.05% 到 1%,主实验用 0.5%。
以论文实验里的 5 月 28 日为例:这天一早,系统手里有一个用前几天数据训好的推荐模型。当天的曝光池里有一百多万条曝光,但更新前只有约 5.8K 条拿到了点击结果,所以能用来更新的信号只有千分之五。这篇稿子后面都沿用这一天。
难就难在,这一天和前一天已经不太一样了。5 月 28 日出现的视频只有 29.0% 在 5 月 27 日出现过,用户也只有 48.8% 重合。没在这两天上训练过的推荐模型,Macro-AUC 从 27 日的 0.553135 降到 28 日的 0.546759。也就是说,模型确实该改,但 5.8K 条结果远少于一个推荐模型的自由度,靠这点结果估不出该往哪儿改。
最直接的做法是拿这 5.8K 条结果微调整个推荐模型。用户、物品和交互的参数都会动,作者的论点是,每个参数分到的有效信号极少。论文在 KuaiSAR-small 上做过这个对照:全模型微调后 NDCG@10 从 0.626024 变成 0.626048,几乎没有带来提升。换成 LoRA 或 Adapter 只训几百个参数,问题仍在:它们学的是推荐模型内部表示上的一个变换,这个变换和「今天哪些视频该往前排」之间隔着好几层,5.8K 条结果同样很难把它定下来。
不动推荐模型,只在分数上加一个两方向的修正
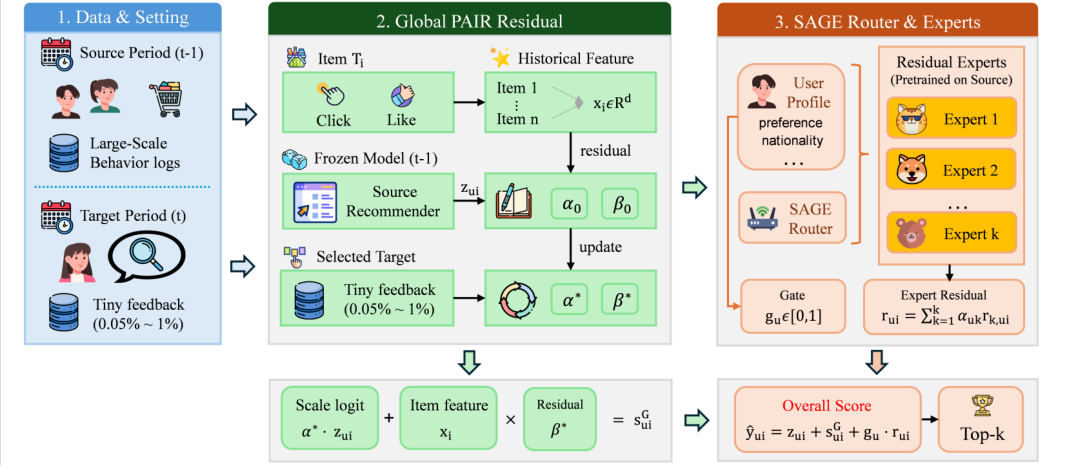
SAGE-PAIR 的出发点是:既然标注少,就把它能改的东西限制到很少几个方向。推荐模型完全冻结,它给每个「用户–视频」对打出原始分数 。修正项只在这个分数上加减一点。
论文把最基础的全局修正叫 PAIR(加在冻结分数上、对所有用户相同的小修正),打分是:
这里 是视频在前一窗口的点击率和点赞率,、 是它们各自的权重, 是原始分数的缩放系数。物品侧只有这两个数,不是学出来的 embedding。作者的用意是:别让稀少的标注去识别一个自由的物品表示,只让它决定「昨天点击率高的视频今天要不要再往前提一点、点赞率高的呢」。
这两个统计量要先做收缩。示意:某个视频昨天只曝光了 4 次、被点赞 2 次,原始点赞率 0.5;全站点赞率设为 0.05,收缩强度用论文的 α=20,收缩后是 (2+20×0.05)/(4+20)=0.125。曝光很少的视频会被拉回全站水平,偶然几次点赞就不会变成一个很大的修正方向。收缩后的值再按全站均值和标准差标准化,两种行为的惩罚才能放在同一个尺度上比较。
那前一天没出现过的视频怎么办?5 月 28 日的视频里有七成属于这种情况。按公式推,曝光数和点击数都是 0,收缩后就等于全站平均率,标准化后两维特征对所有新视频是同一个常数,修正项给它们的加分也完全一样。
缩放系数 带一个 惩罚。不加这个惩罚,模型可以靠把原始分数整体放大或缩小来拟合这 5.8K 条结果,这等于拿缩放冒充重训。惩罚让 只做小幅校准。
示意:视频 V 昨天点击很多、点赞很少,标准化后 。若学到 ,它的修正是 0.3−0.1=+0.2,对所有用户都一样。
先在前一天把修正项学好,今天只做校准
只有三个参数的全局修正,用 5.8K 条结果估也会抖。所以 SAGE-PAIR 的第二步是:同样形式的修正项,先在前一天的完整标注上训一遍。前一天的结果已经全部回流,有 1.23M 行;当天那点结果只负责在这个基础上继续优化。
两个阶段的训练目标相同:每条有标注的(用户、视频、是否点击)单独算一个二元交叉熵,再加 L2 惩罚,把 拉向 0、把 拉向 1,也就是让打分不要离冻结模型的原始分数太远。这是逐条的点击预测损失,不是成对排序损失。
| 步骤 | 用的数据 | 做什么 | 产出 |
|---|---|---|---|
| 1 | 5 月 22–26 日 | 训练推荐模型,之后冻结 | 原始分数 |
| 2 | 28 日之前的源数据 | 算每个视频的点击率、点赞率,算每个用户的画像 | 固定的 和用户画像 |
| 3 | 5 月 27 日 1.23M 行 | 推荐模型不动,训练修正项,5 个 epoch | 修正项的初始状态 |
| 4 | 5 月 28 日 0.5%(约 5.8K 条) | 从第 3 步的状态出发继续训 8 个 epoch | 最终修正项 |
| 5 | 5 月 29–31 日 | 打分排序、评测 | NDCG@10 等 |
第 3 步只给初始值,不给约束:第 4 步里所有参数都从前一天的状态复制过来,之后只按 28 日的结果更新。论文把只用当天标注的版本叫 target-only PAIR,先在前一天预训练的版本叫 source-pretrained PAIR。 Hoot 说

① 前一天(5 月 27 日)预训练
- 训练数据
- 这一天全部回流的结果,1.23M 行
- 更新哪些参数
- 缩放系数、两个全局权重、路由矩阵、8 组专家系数,全部
- 训练轮数
- 5 个 epoch
- 视频 V 的修正(示意)
- x=(+1.0, −0.5),β=(0.3, 0.2),修正 0.3−0.1=+0.2
② 当天(5 月 28 日)校准
- 训练数据
- 从当天曝光池里不看结果均匀抽 0.5%,抽定后才揭示点击,约 5.8K 条;不是最早回流的那部分
- 更新哪些参数
- 还是全部,从 ① 的状态复制过来再训,方向没有被锁定
- 训练轮数
- 8 个 epoch,只用这 0.5% 的行
- 视频 V 的修正(示意)
- x 不变,β 校准成 (0.1, 0.4),修正 0.1−0.2=−0.1
两阶段都不动:推荐模型、每个视频的两维特征 x(点击率、点赞率)、每个用户的画像。它们在拿到当天标签之前就算好了,所以修正永远只能在这两种特征上加减;前一天决定的只是从哪组权重开始学。
左右两栏是同一个修正项的两个训练阶段,下方是两阶段都不动的部分。视频 V 的系数是示意数字,用来说明当天校准可以把同一个视频的修正从加分改成减分。
出处
论文 §4.1(物品特征和用户画像由源时期交互算出,之后固定);§3.3、§4.2(x 与画像在拿到目标标签前固定,只更新修正参数);§4.3、§4.5(前一天 5 个 epoch 预训练;目标阶段所有参数从源状态复制后继续训 8 个 epoch,「是初始化,不是约束」);§3.2、§5.1(曝光池按不看结果的规则均匀抽样,抽定后才揭示标签,0.5%,约 5.8K 条);表 1(27 日 1.23M 行)我的理解是,这一步把「往哪个方向修」交给 1.23M 行去定,把「修多少」留给 5.8K 条去调。前一天和今天用的是同一套系统、同一种视频特征,所以前一天学到的方向在今天大体还能用。
按用户画像分给 8 组系数,让同一个视频对不同用户修正不同
全局修正对所有用户一样。可同一个「点击多、点赞少」的视频,对爱看游戏的用户可能该往前排,对爱看美食的用户可能该往后排。只靠 5.8K 条结果给每类用户学一套修正,正好落在标注最不够用的地方。
SAGE-PAIR (Core) 的做法是准备 8 组系数(论文叫 expert),每组只有两个数,分别作用在点击率和点赞率上。每个用户有一份固定画像:37 个一级类目的点击直方图,加两个活跃度槽,共 39 维。一个小的路由矩阵把画像变成 8 组系数上的权重,权重加起来等于 1。这个用户的专属系数,就是 8 组系数按权重加起来的结果。
前一天没出现过的用户没有画像。论文为此写明了回退路径:没有画像的用户去掉专家项,只用 source-pretrained PAIR;连相邻的前一天都没有时,退回 target-only PAIR。
示意,假设只有两组系数起作用:第 3 组是 (0.2, 0),第 5 组是 (0, 0.4)。
| 用户 | 第 3 组权重 | 第 5 组权重 | 专属系数 | 视频 V 的额外修正 |
|---|---|---|---|---|
| 爱看游戏的用户 | 0.8 | 0.2 | (0.16, 0.08) | 0.16−0.04=+0.12 |
| 爱看美食的用户 | 0.2 | 0.8 | (0.04, 0.32) | 0.04−0.16=−0.12 |
视频 V 先拿到全局的 +0.2,再按用户分别加 +0.12 或 −0.12。这张表就是修正项最终在线上产出的东西:每个用户一份两维系数。
路由矩阵和这些系数也在前一天一起预训练,当天再校准。整个 Core 版加上全局权重和缩放系数,共 331 个参数。
因为每组系数只有两个数,这些系数最多张成两个方向。它们不是一个个独立的预测器,只是同一个两维空间里的锚点,每个用户在锚点之间按权重插值,修正始终落在点击率、点赞率这两个方向上。
论文还有一个 SAGE-PAIR (Full) 版本,多了一个按画像算出的 0 到 1 门控(乘在专家修正上)和搜索行为画像。后面的消融显示这两项影响很小。
提升的大头来自先在前一天预训练
论文的结果按「格」统计:一格是一个推荐模型种子和一个抽样种子的组合,同一格里的两个方法用同一个推荐模型、同一批标注,逐格做差。在 KuaiSAR-v2 的锁定实验里(5 个推荐模型种子 × 5 个抽样种子,共 25 格),SAGE-PAIR (Full) 把 NDCG@10 从 target-only PAIR 的 0.615217 提到 0.626115,相对 +1.77%,25 格全部为正。Recall@10、NDCG@20、Recall@20 和 Macro-AUC 也都同向上升。这说明提升不是某一个截断位置的偶然。
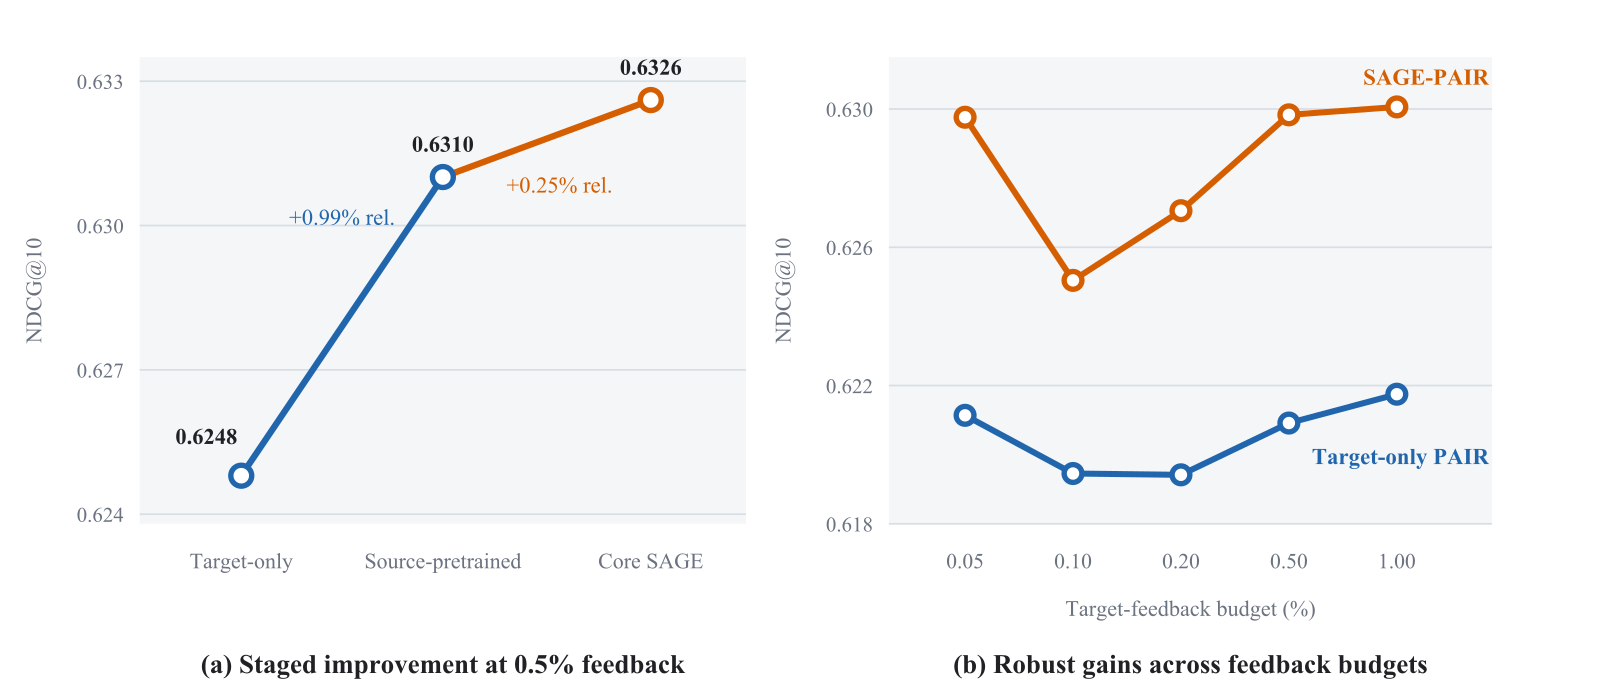
更关键的是把这个提升拆开。在另一批公平对比里(3 个推荐模型种子 × 5 个抽样种子,共 15 格),target-only PAIR 是 0.624800,source-pretrained PAIR 升到 0.631008(+0.99%),SAGE-PAIR (Core) 再到 0.632608(再 +0.25%)。这说明两步都有用,但分量差得多。
不同批实验的 target-only PAIR 参照分数不同,所以跨组的数字不能直接比较。
同样一份 0.5% 的标注,提升的大头来自先在前一天预训练(+0.99%),按用户分组的专家只再加四分之一个百分点。
有人会问:LoRA 和 Adapter 也先在前一天预训练,是不是一样有效?论文做了这组对照。LoRA 和 Adapter 都是 rank 4、各 256 个可训练参数,和 Core 版的 331 个接近。FOMAML-LoRA 是一种元学习做法:先在前 5 天里切出许多小任务,学一个容易快速微调的 LoRA 初始值,再用 28 日的标注更新。
| 方法(同一批 15 格,0.5% 标注) | 相对冻结模型的 NDCG@10 变化 | 为正的格数 |
|---|---|---|
| target-only LoRA | +0.000172 | 11/15 |
| target-only Adapter | +0.000462 | 12/15 |
| FOMAML-LoRA | +0.000189 | 12/15 |
| 前一天预训练的 LoRA | −0.000372 | 3/15 |
| 前一天预训练的 Adapter | −0.000553 | 4/15 |
| source-pretrained PAIR | +0.028814 | 15/15 |
| SAGE-PAIR (Core) | +0.030407 | 15/15 |
这说明「先在前一天预训练」本身不是万能的。参数量差不多时,LoRA 和 Adapter 预训练后反而略降,PAIR 的修正却在 15 格里全部为正,幅度也大得多。作者的解释是:LoRA 和 Adapter 在推荐模型内部表示上学变换,这个变换和今天的排序隔着几层;PAIR 直接在点击率、点赞率这两个看得见的方向上学修正。论文用对照实验支持了这个解释,但没有直接测量「更新方向可不可识别」。
消融里,路由也换成用 k-means 固定分组的版本,NDCG@10 只到 0.621232,学出来的软路由是 0.628131(参照 0.619675)。去掉门控是 0.628203,去掉搜索画像是 0.627694,几乎没差别。专家数取 4、8、16 时分别是 0.627674、0.627783、0.627890,也很平。这说明 Core 版里真正起作用的是前一天预训练和学出来的路由,门控和搜索画像可以省掉。
连续 12 天滚动时,每天接着前一天的修正项继续校准,平均 NDCG@10 是 0.645916,比每天从 5 月 27 日状态重来的 0.645407 略好,也高于把所有已抽样标注合在一起重估的 PAIR(0.640139)。这说明修正项可以一天天往下接着用。
收益不大,MF 上输给类目分组,推理慢了约 10 倍
第一,绝对提升不大。锁定实验里 NDCG@10 的绝对增量约 +0.0109;用户路由在公平对比里只多 0.25%。如果业务看重的是个性化修正,这篇的证据主要支持全局修正加前一天预训练。
第二,换推荐模型时结论有例外。在 Two-Tower 上,SAGE-PAIR(0.624925)比最强的用户偏好分组基线(0.622833)高 0.34%。但在 MF 上,SAGE-PAIR 是 0.637496,低于一个按物品类目分组的简单基线 0.638137。
第三,标注预算曲线不单调。从 0.05% 到 1% 的五档预算下,SAGE-PAIR 都高于 target-only PAIR,但 0.10% 那一档相对提升最小(0.90%),也只有 22/25 格为正。作者的解释是,在固定的曝光池里,标注条数本身决定不了能看到多少「同一用户既点又不点」的对比。这个「可配对比例」是作者事后用来解释预算曲线的诊断量,不进损失,也不参与训练。这意味着多给标注不一定按比例换来提升。
第四,训练很便宜,推理不便宜。分阶段训练只要 0.606 秒,重训推荐模型要 22.166 秒。
推理的账不一样。论文在 RTX 4090 上对全部 2,255,520 行做一次端到端推理,取多次耗时的中位数:冻结模型是 18.472 ms,加上 SAGE-PAIR 后是 183.201 ms,约是原来的 10 倍。这是整批推理的耗时,不是单次请求的时延。论文称它与毫秒级服务兼容;这意味着要上线的团队得先在自己的服务链路上量一遍这部分开销。
回到 5 月 28 日那 5.8K 条结果:SAGE-PAIR 没让它们去学一个新模型,只让它们微调 331 个前一天已经训好的数。这篇论文最站得住的结论,是这一步「先在前一天预训练」带来了大部分提升;按用户分组的 8 组系数,在此基础上只再加了一小步。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…