目录 · 6 节
1空闲藏在每次解码迭代里面2影子任务记着两件事:已有多少、还缺什么3每次迭代能塞多少影子 token463K 的影子副本放不进小模型的显存5换模型调用的 TTFT 降了约 45%6收益缩水的几种情况
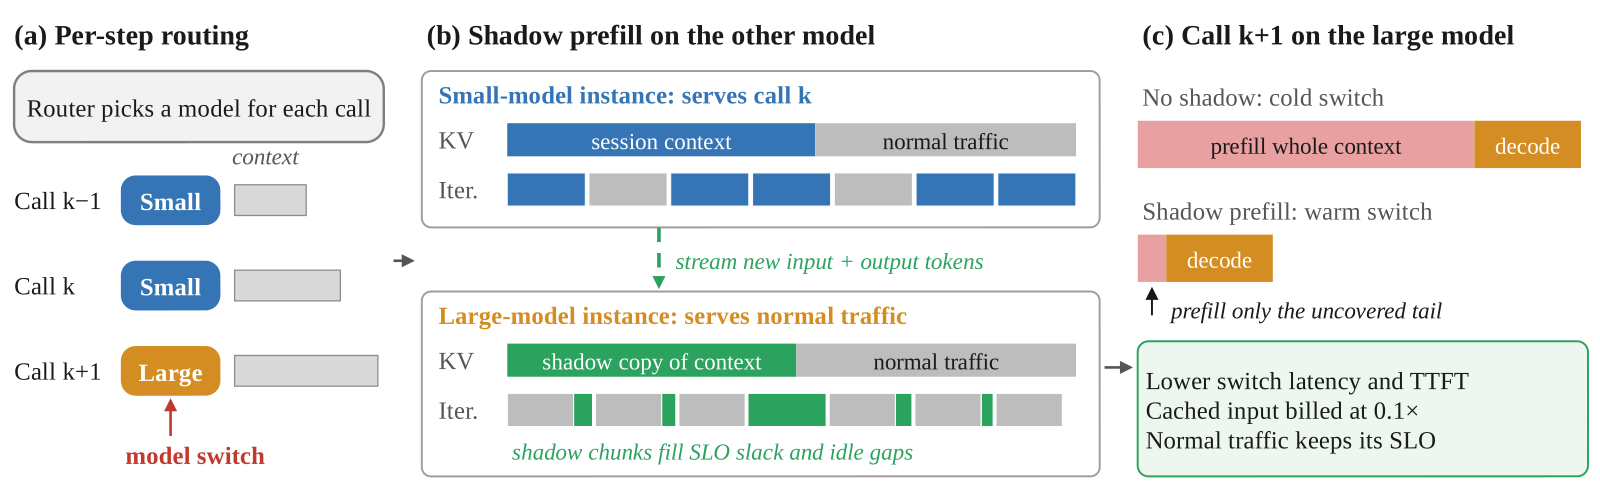
ShadowPrefill 这篇论文要解决的是逐步路由每次换模型时都要重新 prefill 整段上下文的问题,它的办法是在另一个模型服务普通流量的空隙里,提前把这段上下文能算的部分先算掉,没算完的仍由切换调用自己补。
现在的 agent 一次任务要调用几十次 LLM:规划、调工具、读结果、改代码、跑测试。这些调用难度差别很大,于是出现了逐步路由器(per-step router):每次调用到来时,路由器在一个便宜的小模型 S 和一个能力强的大模型 L 之间挑一个。论文用的路由器 LLMRouter 在两个模型之间这样切换,比一直用大模型准 6.6–13.6 个点,花的 token 还更少。这说明逐步路由本身是划算的,值得在服务端为它做优化。
问题出在 KV cache 上。agent 的每次调用都会把整段会话历史再发一遍,后面接上新的工具输出。一直留在同一个模型上时,prefix cache 让新调用只需 prefill 新增的那几千个 token,供应商对命中缓存的输入也只按约一折计费。可 KV 是由模型权重算出来的,S 算的 KV 给不了 L 用。路由器一换模型,L 手里要么完全没有这段会话,要么只有它上次离开时的旧副本,缺口必须先 prefill 完,第一个 token 才能出来。
示意:一个 coding agent 会话,前几次调用都在 S 上,上下文涨到 60K token;L 上一次接手这段会话时只有 40K。第 k+1 次调用路由器切到 L,L 得先把中间缺的 20K 加上这次的新输入 prefill 一遍。论文测到的代价是:同模型调用的 token 加权命中率 80–89%,换模型调用只有 44–65%,耗时是同模型调用的 1.5–3.2 倍,差距主要在首 token 时间(TTFT)。在 GitHub Copilot coding agent 的真实 trace 上,换模型调用平均带 63K token。
现有做法放回这个例子都不太合适。一类是会考虑切换代价的路由器,它看到 60K 上下文就倾向于不切,代价是放弃 L 在这一步上本来更高的准确率。另一类是单模型的缓存预热:把这 60K 当成普通请求发给 L 先算一遍。可 L 的实例本来就在服务别的用户,按普通优先级插队,会拖慢 L 上所有人的请求,论文实测这种做法(后文的 Eager)在路由基准上让 LLM 调用整体变慢 7.0%。
空闲藏在每次解码迭代里面
提前算 KV 需要算力,而换模型最贵的时候恰好是负载峰值。作者先回放了一周的 Azure 推理 trace:集群按峰值配置,代码流量的实例在中位小时有 72% 的时间整机空闲,峰值小时只剩 8%,对话流量在任何时段都没有整机空闲。只等整台机器闲下来,峰值时几乎无事可做。
更细的粒度上还有余量。continuous batching 的一次迭代主要在做解码,解码受访存限制,跑得比每 token 时延上限(TPOT SLO)快得多。峰值小时里,中位迭代只用了大约四分之一的 TPOT 预算,69–79% 的单次迭代时延预算没用上。往这样的迭代里加一段 prefill 会让其中每个解码都变慢一点,但只要整次迭代不超过批内每个请求剩下的余量,就没有请求违反 SLO。
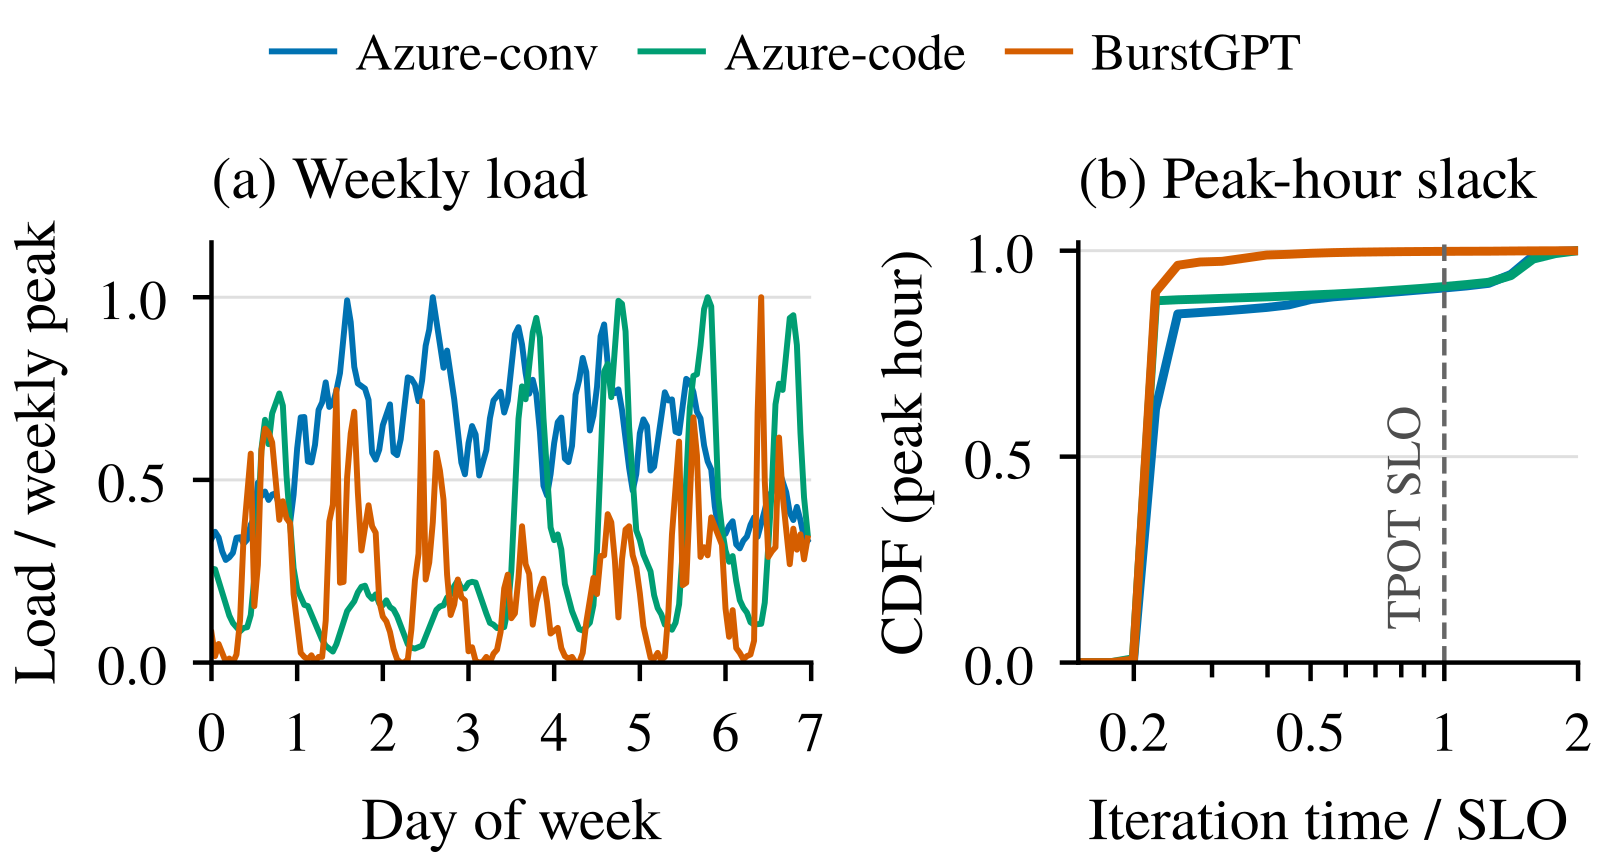
ShadowPrefill 收割的就是这部分余量:大模型实例照常服务普通流量,只把每次迭代里没用完的时延预算借给影子 prefill。
影子任务记着两件事:已有多少、还缺什么
ShadowPrefill 坐在路由器和两个模型的推理引擎之间。每来一次路由调用,它就在没被选中的那个模型上建立或延长一个影子任务(论文叫 shadow job),影子任务做的事就是在那个模型上维护这段会话的一份 KV 副本。沿用上面的示意,第 k 次调用在 S 上跑的时候,L 那边的影子任务大致长这样:
session: s42     目标模型: L     实例: L 的粘性实例 L#2
已覆盖前缀: token 0–40K      待补: token 40K–60K(历史缺口)
                             + 1K(第 k 次调用的新输入,调用到达时立刻追加)
                             + 300(S 的输出,S 生成完后追加)
排序依据: 预测换模型概率 0.3
它为什么要做成增量的,而不是每次把整段历史重算一遍?因为会话会来回切。S 切到 L、又切回 S、再切到 L 时,L 已经持有的前缀不必重算,影子任务只补增量。当前调用的输出要等 S 生成完才追加给影子任务,所以第 k+1 次切换到来时,影子副本至少还差第 k 次调用的那段输出。切换调用自己 prefill 这段尾巴和新输入。 Hoot 说

- 冷切换(示意):L 只有 0–40K,要 prefill 20K 缺口 + 1K 输入 + 0.3K 输出 + 1K 新输入 = 22.3K token。
- 有影子(示意):0–61K 已在 L 的缓存里,切换调用只 prefill 0.3K 输出 + 1K 新输入 = 1.3K token。
- 为什么两次调用之间不一定追平:输出进清单是即时的,补算却排在所有请求之后、只用余量;论文按保守口径说影子至少落后当前调用的输出,所以把这段尾巴算在切换调用头上。
示意数字沿用正文的 60K 会话,第 k+1 次调用的新输入 1K 也是示意。原文写的是 S 的输出 token 随生成流式追加给影子任务(output streaming);补算只在 L 的迭代余量里以最低优先级进行,论文的口径是影子至少落后当前调用的输出。
出处
论文 §3.1 Incremental shadow jobs(输入到达即追加、输出流式追加、影子至少落后当前调用的输出、切换调用自己 prefill 尾巴);§3.2 影子块优先级最低;图 1(b)(c)影子任务跑在 L 的粘性实例上,也就是这段会话在 L 上固定使用的那台实例。路由器选实例时按「只计没缓存的 token」估算 prefill 完成时间,所以切换调用通常就落在持有影子副本的那台上。多个影子任务排队时,按历史会话估出的换模型概率排序,先给最可能切过来的会话算。
每次迭代能塞多少影子 token
影子块排在优先级最后:只有等待队列为空、也没有请求因显存不够被挡住时,引擎才会往迭代里加影子 token。实例完全空闲时,它跑纯影子迭代,但每次最长 0.5 倍 TPOT SLO,新到的请求最多等这么一次迭代。
峰值时用的是 SLO 余量控制器。它只看生产调度器本来就有的信息:请求的到达时间、首 token 时间、已经跑了几次迭代。一个解码请求如果比 SLO 进度超前,就有余量可借;离截止时间近的请求则把预算压低。整次迭代的预算取批内所有请求余量的最小值,再用时延模型算出还能加多少影子 token。
这里的 SLO 按累计进度算:TPOT SLO 为 T、留出安全边际 m 时,请求从首 token 起完成 k 次迭代,只要总耗时不超过 (1−m)·T·k 就算达标。所以进度超前的请求攒下了余量,下一次迭代可以更长。另一方面,每次塞影子的迭代还被限制在 β·T 以内,β=0.5。
示意:T=25 ms,m=0.2,每次迭代摊到的额度是 20 ms,上限 β·T=12.5 ms。批里两个解码请求都已跑完 10 次迭代。请求 A 只用了 100 ms,第 11 次迭代可以长到 220−100=120 ms,但先被上限压到 12.5 ms;请求 B 已用了 212 ms,第 11 次迭代最多 8 ms。预算取最小的 8 ms,而这次迭代本身只需 6 ms,控制器就塞进大约 2 ms 能算完的影子 token。这个例子说明,余量最紧的那个请求决定了能借多少,A 攒得再多也没用。
为什么不对所有忙碌迭代都给一个固定的小额度?论文的 Harvest 就是这么做的,它不看批内请求的余量,在基准上把换模型调用时延降了 6.9%;换成 SLO 余量控制器(Harvest-SLO)后升到 8.8%。还有一处例外:迭代里若有路由调用,控制器就不借余量,因为路由调用每被拖慢一点都直接算进 agent 的时延。这类迭代只能用一笔按纯解码迭代时长 2.5% 累积的小额度,所以路由调用的长期减速最多 2.5%。
63K 的影子副本放不进小模型的显存
影子 KV 要活到切换那一刻才有用,但它不能挤掉让同模型调用变快的缓存。ShadowPrefill 把影子 KV 单独算一类,最多占 KV 池的 25%,只能用空闲块或闲置超过 5 s 的条目,驱逐时先删影子再删普通条目。
对长上下文这还不够。Gemma-7B 每个 token 的 KV 有 458 KB,一个 100K token 的上下文就占满一张 H100 上大半个 KV 池,影子副本在切换前早就被驱逐了。所以被驱逐的会话条目会溢出到主机内存(host DRAM),命中时经 PCIe 读回,读回比重算便宜得多。这一层对同模型调用也有用。
兜底规则很简单:切换调用从不等影子。影子只算了一半,就用已缓存的前缀,再 prefill 剩下的尾巴;影子不在了,就和没有 ShadowPrefill 时一模一样。猜错的代价只是借来的空闲算力和这部分能耗。
换模型调用的 TTFT 降了约 45%
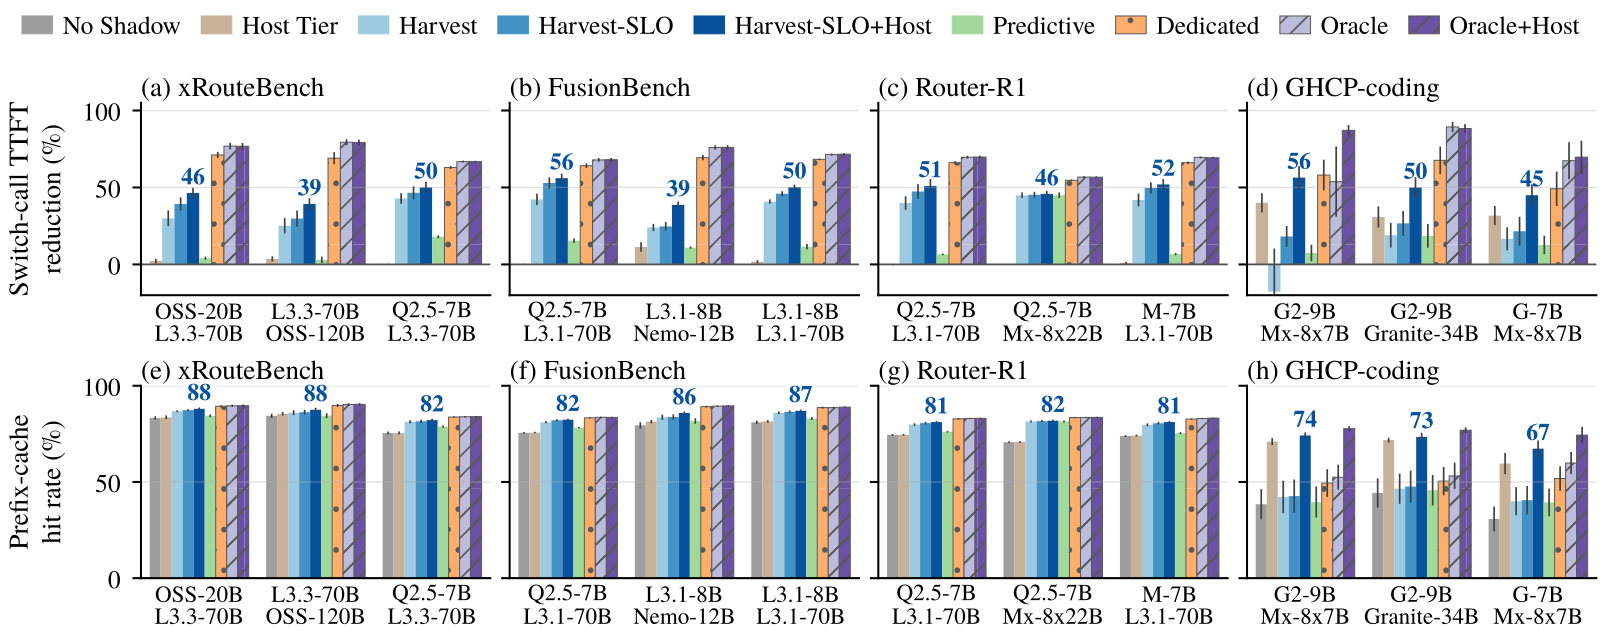
主要结果来自基于 Vidur 的仿真:22 对模型,从 7B 到 141B,每个模型 4 个实例,普通流量回放 Azure 对话 trace,负载 ρ=0.7。下表列出各配置相对冷切换基线 No Shadow 的换模型调用时延降幅,基准指 xRouteBench、FusionBench、Router-R1 三套路由基准的 16 对模型,GHCP 指 Copilot coding trace 的 6 对。
| 配置 | 做法 | 基准 | GHCP |
|---|---|---|---|
| Harvest | 影子任务 + 固定小额度 | 6.9% | — |
| Harvest-SLO | 影子任务 + SLO 余量控制器 | 8.8% | 4.3% |
| Harvest-SLO+Host | 再加主机内存层(完整设计) | 10.4% | 14.3% |
| Predictive | Harvest,只给换模型概率 ≥0.25 的会话做影子 | 3.2% | — |
| Dedicated | 每个模型多加一个实例专跑影子(+25% GPU) | 18.0% | — |
| Oracle | 切换调用的前缀免费在缓存里,作为上限 | 19.3% | 27.4% |
完整设计在基准和 GHCP 上分别拿到 Oracle 上限的 54% 和 52%,单对最高降 21.4%。省下的主要是首 token 前的等待:换模型调用的 TTFT 降 44.1% 和 47.0%。这说明在不加 GPU 的条件下,影子 prefill 能把换模型的大部分 prefill 移出关键路径。
GHCP 那一列说明了主机内存层为什么必需。没有它时 Harvest-SLO 只降 4.3%,因为 63K 的影子副本在小模型的 KV 池里撑不到切换;加上它就到 14.3%。Predictive 只降 3.2%,因为路由器是来了调用才决定,按概率门控会漏掉很多真实发生的切换。Dedicated 接近上限,代价是多 25% 的 GPU 和每请求能耗 +11.7%。
换模型调用占全部调用的 19–33%,摊到所有 LLM 调用上,平均时延降 5.0%(基准)和 9.7%(GHCP)。全部调用的命中率从 75.0% 升到 82.1%,GHCP 上从 55.4% 升到 76.3%。缓存输入按一折计费,路由后的 token 账单因此降 28.5% 和 32.0%,最高 46.1%。开销方面,每个达标请求的能耗只多 0.4%,普通流量的 SLO 达标率没有下降。
收益缩水的几种情况
ShadowPrefill 省的只是 prefill。目标模型小于 15B 时换模型调用时延降 12%,15–50B 降 4%,50B 以上只降 3%,因为大模型的切换调用里解码占了大头。上下文长度的影响方向相反:切换前上下文不到 2K 时只降 0.7%,超过 64K 时降 20.5%。回到 60K 的示意会话,它正落在收益最大的那一档。
负载越高,能借的余量越少。只看 Harvest-SLO,ρ=0.2 时 LLM 调用时延降 4.4%,ρ=0.9 时只剩 0.7%。DeepSeek-R1 的推理输出很长,实例几乎没有余量,只提升 0.2 个点。影子 token 也有很多白做:完整设计算出的影子 token 有 63% 从没用上,因为大多数调用并不切换。
还要分清哪些数字来自仿真。vLLM 原型不改 vLLM 源码,只在请求级别实现了 Harvest,省略了逐迭代额度、SLO 余量控制器、优先驱逐和主机内存层。它在 ρ=0.3 时把换模型调用 TTFT 平均降了 61.9%,但在 ρ=0.5 时,SWE-agent-LM-7B 和 SWE-agent-LM-32B 这一对模型反而慢了 35.1%:等待队列为空时塞进去的影子仍会拉长正在跑的解码迭代。
我的理解是,这篇论文把逐步路由的切换代价从路由器里挪到了服务端:路由器照样按每一步选最合适的模型,切换所需的 prefill 则借另一个模型的迭代余量提前算掉一部分。负载不高、上下文长时,切换调用时延降约 10–20%,约达免费切换上限的一半。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
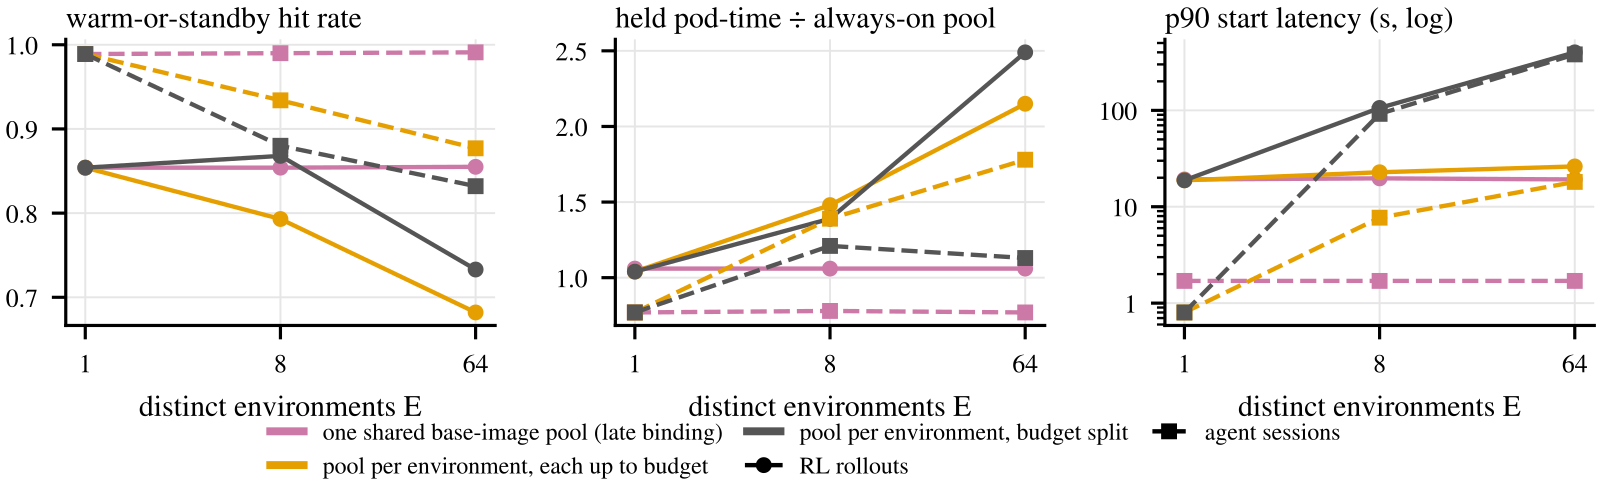 Infra · 2026-11-11Firepool: Brokering Warm GPU Capacity for Agentic and RL Workloads at LinkedInagent 和 RL 训练会连续发出几千个只跑几秒的 GPU 任务,可是起一个 Pod 即使镜像已缓存也要等二三十秒,等待压过了干活。常见解法各缺一块:缓存镜像省不掉调度和初始化,常驻的 Ray 集群在两步之间白占 GPU,备好的空闲 Pod(热池)又常因环境对不上而用不上。LinkedIn 的 Firepool 让同一硬件规格的 Pod 共用一个基础镜像,代码和依赖等任务开始时才装进去,Pod 就能互换。为了隔离,Pod 只复用给上次用它的调用者,换调用者时由同一张卡上不占显存的备用 Pod 接手。线上高峰期 94.7% 的 Pod 请求由热池或备用 Pod 满足。在两张 GPU 的配额下,agent 循环的完成速度是每个任务新建 Pod 的 13 倍,任务一长优势就消失。跑 agent 评测或 RL 时,先量清楚 Pod 等待占了多少时间。
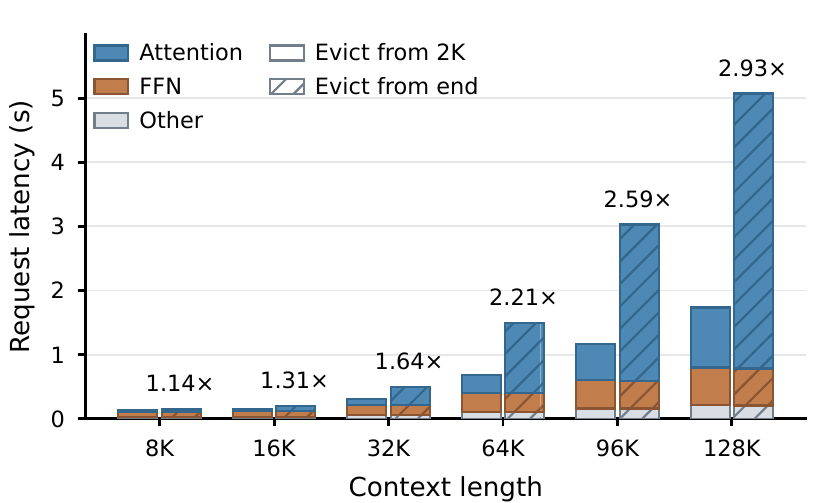 Infra · 2026-11-04Rethinking KV Cache Eviction for Agentic LLM ServingKV cache 放不下时,vLLM 和 SGLang 都从缓存序列的末尾开始删,为的是保住开头那段能被很多请求共用的前缀。但 agent 每一轮都会把很长的历史重新发回来,而越靠后的 token 重算越贵,因为它要和前面所有 token 算注意力。Penelope 反过来做:共享前缀照样保留,剩下的历史从靠前的部分开始删,留住靠后的部分。请求回来时,只重算缺掉的那一段。在 SGLang 上用真实 agent 请求记录测,只用 GPU 缓存时平均首 token 延迟最多降 60%,再加上 CPU 内存做第二层缓存时最多降 76%。该删哪一段,要看重算它要花多少,而不只看它被多少请求共用。
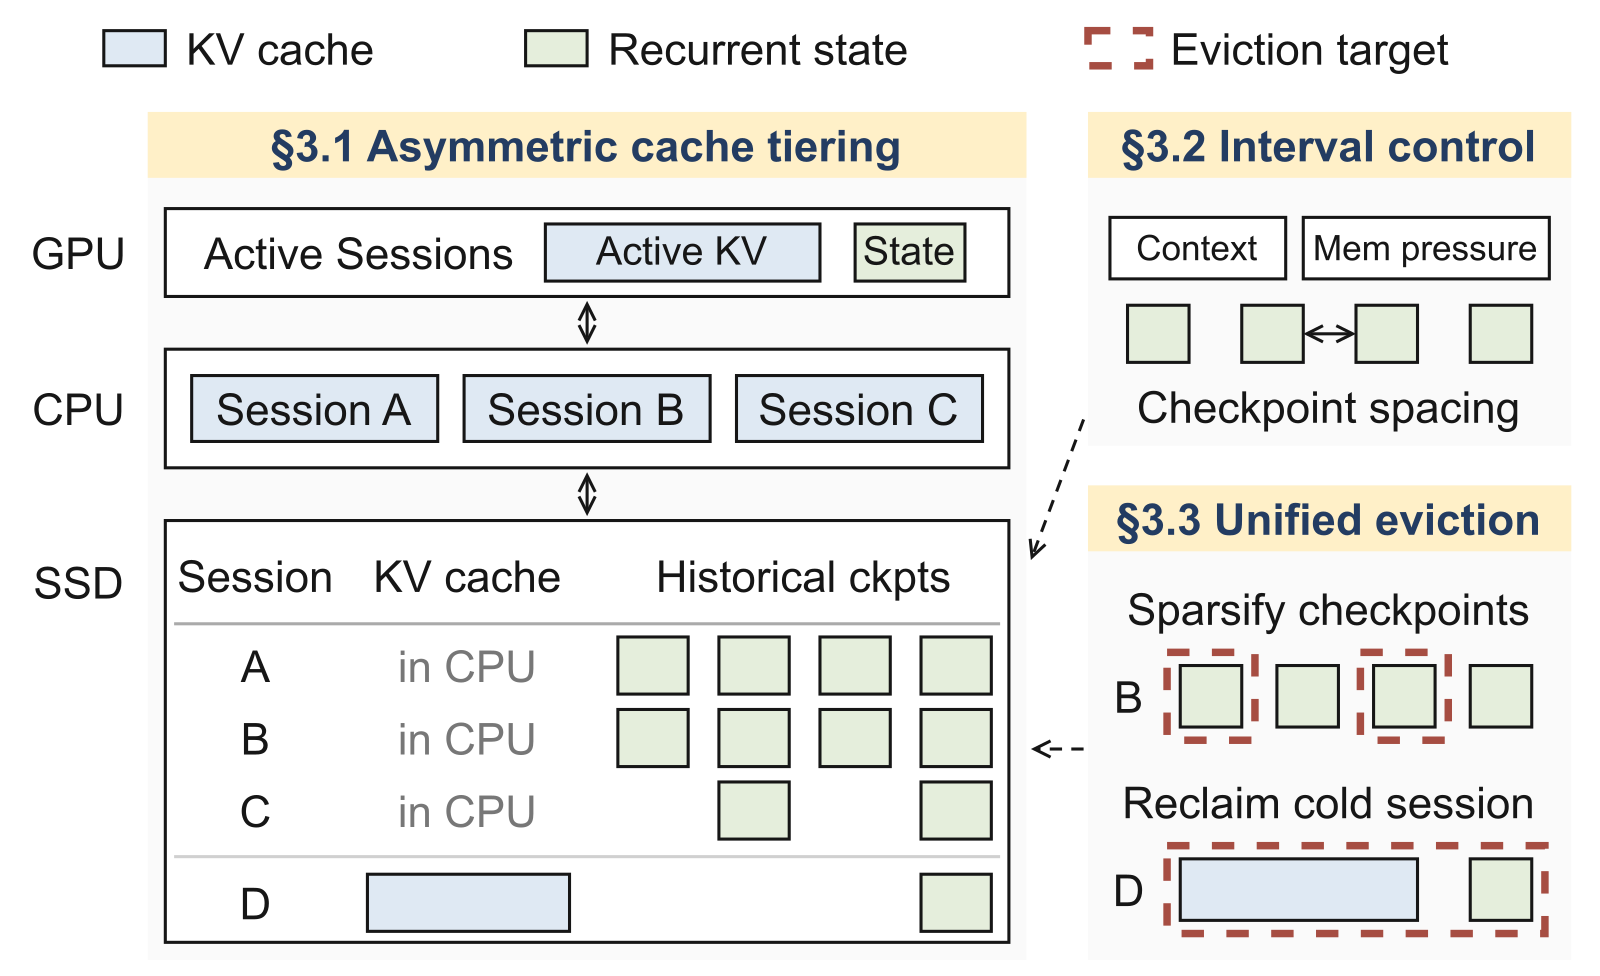 Infra · 2026-11-03HiState: Hierarchical Prefix Cache Management for Hybrid LLM Serving in Agentic Workloads混合模型的循环层会把整段前缀压成一个固定大小的快照,没法截短回更早的位置。所以 KV 明明还在,只要匹配位置的快照没存过或已被淘汰,就要从更早的快照甚至从头重算一大段。HiState 抓住一个不对称:一次缓存命中要读所有匹配的 KV,却只读一个快照,而且快照大小和上下文长度无关。所以它把大量历史快照放到 SSD,把内存留给 KV,并把快照和 KV 放进同一个淘汰队列。队列里每一项的分数是最近访问时间,加上删掉它后要多重算的 token 数除以它能腾出的空间,分数最低的先删。在两份公开的编程 agent 请求记录上,p99 TTFT 相对基于 vLLM 的 Marconi 最多加速 5.73 倍。快照多存不占快内存,每次命中也只从慢存储读一个。
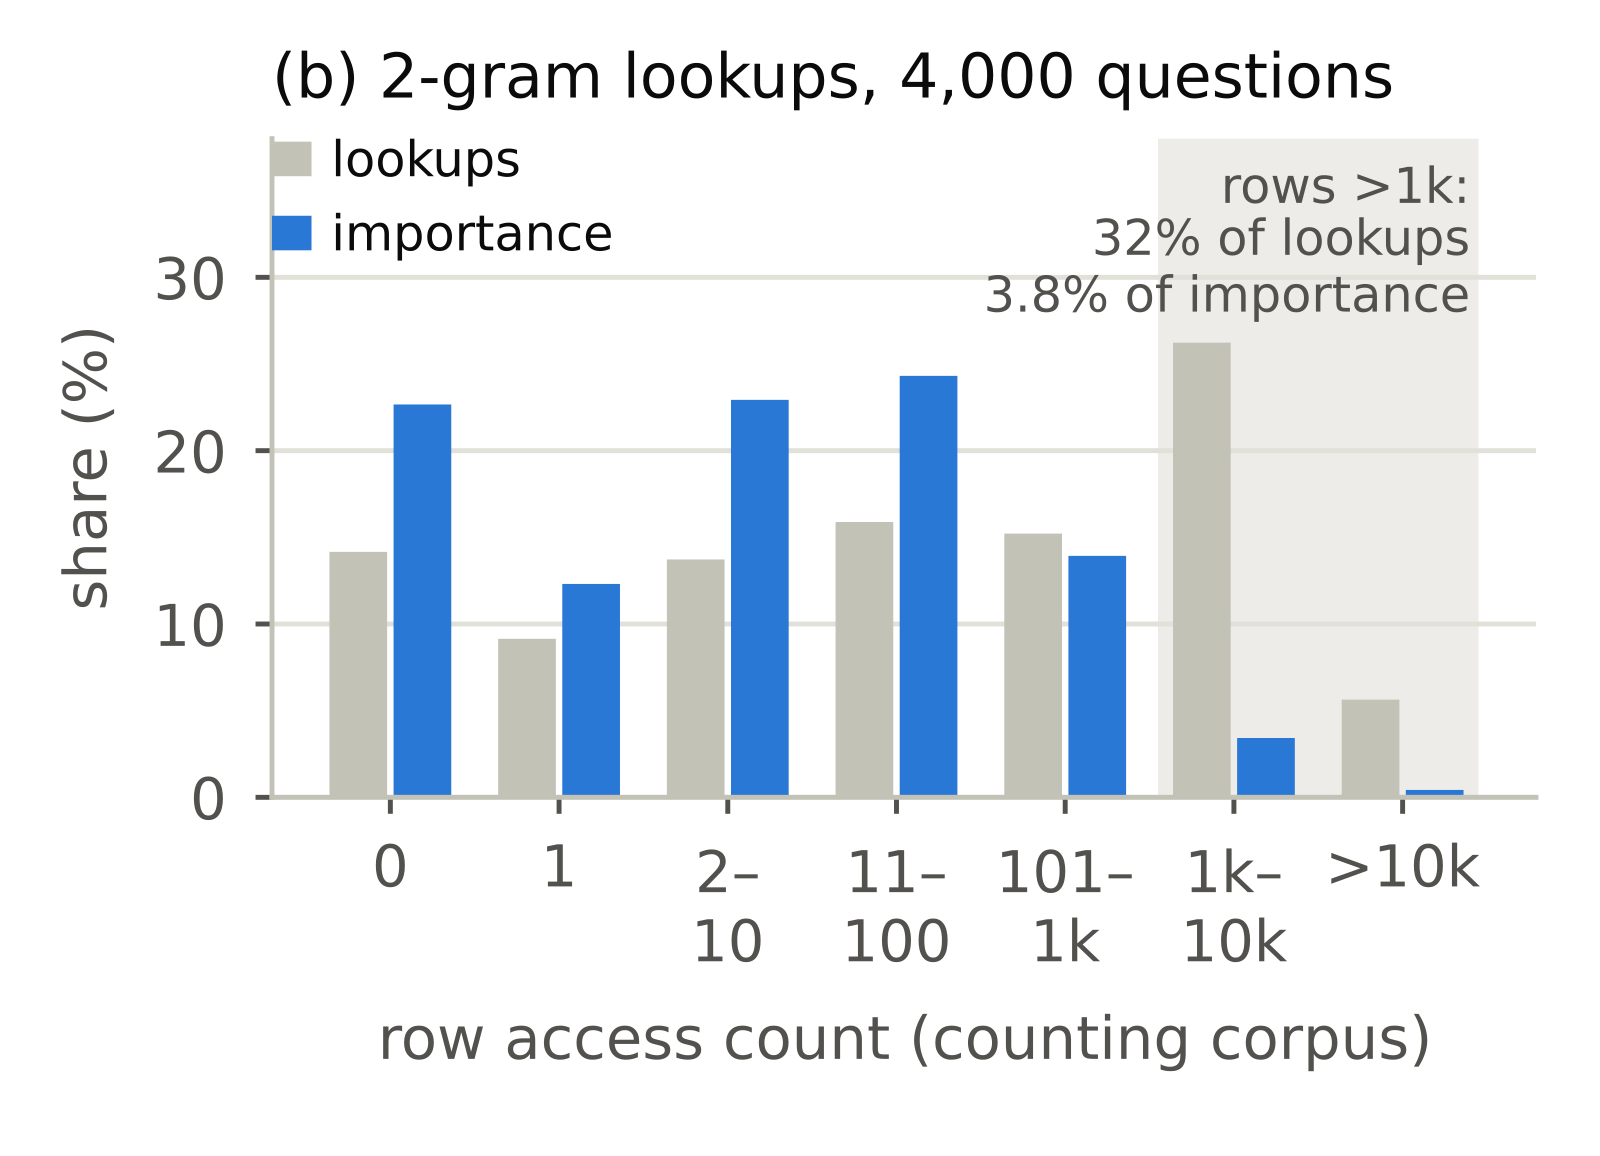 Infra · 2026-10-29Let the Gate Decide: Per-Lookup Precision for Quantized Conditional Memory in LLMs给大模型的 n-gram 记忆表做低比特量化时,把精度留给访问最多的行反而比随机挑还差。原因在门控:DeepSeek 的 Engram 这类条件记忆层查出的向量要乘一个门控,常见虚词的门控很小,罕见实体名的门控很大,量化误差按门控放大。GateRQ 把每行存成几级单比特残差码,每次查表先读第一级算出门控,再在同一个 batch 里按门控估出的重要度排序,排在最前的一小部分读到第三级,其次的读到第二级,其余停在第一级;各级的比例由事先定好的平均读取比特数预算决定。不重训模型,DeepSeek 最新的 Flash 模型每张 GPU 上的表从 23.6 GiB 降到 3.0 GiB,省下的显存让长上下文吞吐比 FP8 表明显更高。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…