目录 · 10 节
1它到底在解决什么问题?2整体流程3主序列:为什么用门控注意力而不是 DIN?4长期历史:为什么要两类 query?5特征交叉:按头混合,再逐 token 变换6高秩注意力:先按场景压缩,再从多个角度看7实验结果8我认为它的局限9一个推荐团队可以怎么试10一句话结论
多数线上排序模型先把用户行为序列压成一个固定向量,再交给特征交叉模块;压完之后,后面的交叉层就再也看不到具体是哪几次点击、哪几次加购。阿里淘宝的 HiRank 把行为序列一直保留到主干的每一层,并且让长期历史的检索 query 从用户最近的行为序列里生成,而不是从年龄、性别这类静态画像里生成。在淘宝首页的 CVR 预估上,它和同等参数量下最强的基线相比,GAUC 从 0.7615 提到 0.7801;线上 A/B 中人均订单数提升 2.27%,人均 GMV 提升 2.86%。
做排序模型的团队值得读这篇,尤其是正在把行为序列和特征交叉合进一个主干的人。它的核心思想一句话:行为序列和其他特征在每一层都互相读写,最后再按流量场景把所有信息压成一个紧凑向量,由多组不同的投影从这个向量里各取一个视角做高阶交互。我认为这篇最有价值的部分是和 OneTrans、HyFormer、MixFormer 在同一套特征和数据上的对比,以及把收益拆到各个部件的消融;论文用“有效秩”讲的理论故事则更像事后诊断,要谨慎看。
它到底在解决什么问题?
用一个淘宝首页的例子说明(示意)。一位用户最近 48 次行为里,有三次在看跑鞋,一次把运动袜加进了购物车;她过去一年的购买记录很长,大部分是母婴用品和厨具,也有两次买过运动服。现在要给一件跑步外套估 CVR。
| 做法(示意) | 用什么去查长期历史 | 查到的主要是 | 问题 |
|---|---|---|---|
| 画像驱动 | 女性、30 岁、高消费 | 母婴用品、厨具 | 画像相近的用户查到的几乎一样 |
| 候选驱动 | 跑步外套本身 | 两次运动服购买 | 只能从候选的角度看,漏掉“她最近在准备跑步”这个上下文 |
| HiRank 的兴趣 query | 最近看跑鞋、加购运动袜的序列 | 运动服购买和跑步相关的浏览 | 这正是想要的证据 |
画像驱动的问题在于,画像特征变化很少,很多用户的 query 向量挤在少数几个方向上。论文用有效秩(eRank)来量化这件事:把一批向量拼成矩阵,看奇异值分得均不均匀,再折算成“实际用到了几个方向”。手算一下:如果四个奇异值是 4、0、0、0,所有信息都在一个方向上,有效秩是 1;如果四个奇异值都是 1,有效秩是 4。HiRank 的实验里,长期检索的输入 query 平均有效秩只有 24.52,检索之后升到 54.88,说明从序列出发的检索确实让不同用户拿到了更不一样的表示。
第二个问题是结构上的。常见的“先编码、再交叉”流水线里,DIN 一类的序列模块先把行为压成一个向量,DCNv2 一类的交叉模块再拿这个向量和用户、商品、上下文特征做交叉。序列一旦被压成一个向量,后面的交叉层就没法回头去取别的证据。第三个问题来自多场景:淘宝首页的购买反馈很稀疏(论文统计首页样本里只有 0.92% 带购买),所以模型用首页、主搜索和几十个小场景的样本一起训练,共享的表示容易把场景之间的差异抹平。
整体流程
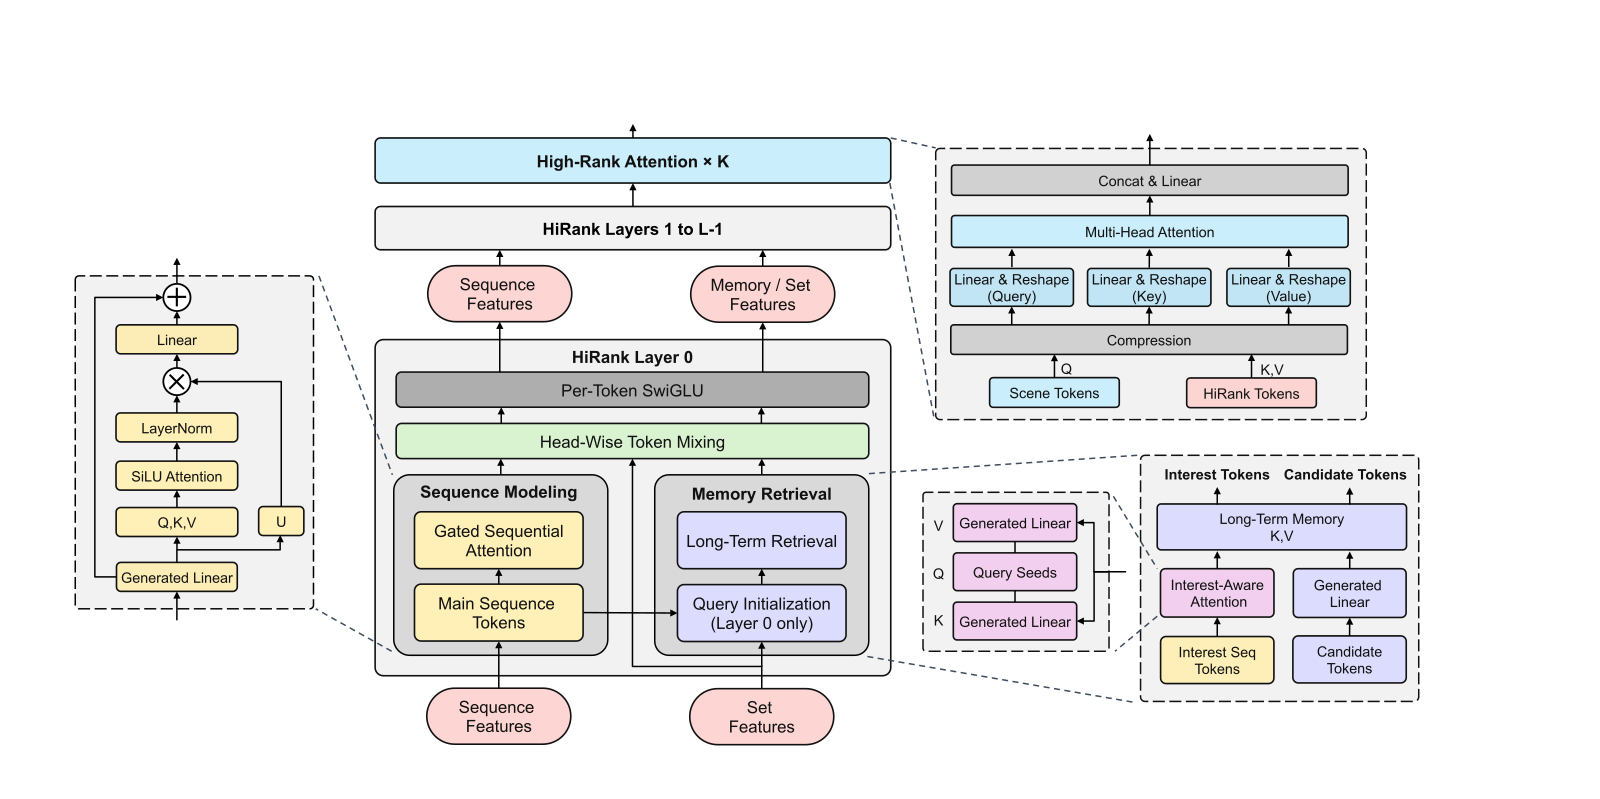
| 阶段 | 输入 | 做什么 | 产出 |
|---|---|---|---|
| 切 token | 用户、商品、上下文特征,行为序列 | 特征按语义分组,每组投成 256 维 token;主序列保留最近 48 个事件;点击、加购、购买等 4 条长期历史各自投影成只读的记忆 | 特征 token、主序列状态、候选 token、4 份长期记忆 |
| HiRank 层(2 层) | 上一步全部 token | 主序列做门控自注意力;两类 query 读长期记忆;所有 token 一起混合 | 更新后的序列状态、检索结果和特征 token |
| 高秩注意力 | 最后一层的全部 token | 按场景压缩成一个 1536 维向量,再投影成 24 个组合 token 做注意力 | 一个紧凑的预测状态 |
| 多任务塔 | 预测状态 | CVR 为主任务,加购为辅助任务 | 各任务的概率 |
关键的分工是:主序列负责“最近在干什么”,长期记忆负责“过去做过什么”,交叉层的输出再反过来决定下一层去查什么。下面拆开讲。
主序列:为什么用门控注意力而不是 DIN?
HiRank 对最近 48 个行为做的是 HSTU 风格的注意力。和标准 Transformer 相比有两处不同:注意力权重用 SiLU 代替 softmax,再除以有效长度;结果还要乘上一路门控信号。每个“查询-键”分数单独过一遍 SiLU 就是权重,不和其他位置的分数比较。
为什么不用 softmax?假设两个用户,一个最近看了三次跑鞋,一个只看了一次(示意),softmax 之后两人“跑鞋相关”这部分的权重都可能接近 1,模型分不出谁的兴趣更强。SiLU 不要求权重之和为 1,但聚合结果仍要除以主序列的有效长度;在有效长度相同、注意力分数和值表示可比时,更多同向的相关项才可能增大聚合信号。门控那一路则让每个位置自己的特征和聚合后的历史相乘,相当于让当前这条行为决定要从历史里取多少。
候选商品也参与进来,但方式受限:它复用主序列这一层算好的 key 和 value,用自己的 query 去读,却不在这一步向序列回写。只有可选的解耦版本进一步通过掩码阻断混合阶段的商品到用户反馈,才能让同一请求内的候选逐层共享用户侧计算。
长期历史:为什么要两类 query?
长期历史很长,不可能全部塞进主序列做自注意力,所以 HiRank 把它们当作只读的记忆,用 query 去检索。两类 query 各管一边。
兴趣 query 来自主序列。第一层里,一组可学习的种子向量先对主序列做注意力,得到若干个兴趣 query。这些 query 事先按长期历史分成 4 组,每组只负责一条历史,用交叉注意力从里面取出相关的行为;与此同时,候选商品自己也作为 query 去查每条历史,两路结果互补。回到开头的例子:种子向量读到“看跑鞋、加购运动袜”,生成的 query 就会偏向运动类,去购买记录里取出那两次运动服。
候选 query 来自候选商品,读的是同一份记忆,回答的是“这件商品和她过去哪些行为相关”。两者互补:前者从用户出发,后者从商品出发。
层与层之间还有一个回路:每一层混合之后,两类检索结果会成为下一层的 query。也就是说,第一层交叉学到的东西会影响第二层去长期历史里查什么。记忆本身始终不变,变的是“拿什么去问”。
特征交叉:按头混合,再逐 token 变换
序列状态、两类检索结果、特征 token 和候选 token 拼在一起后,交叉层分两步做。第一步借用 RankMixer、TokenMixer-Large 的做法:把每个 token 的 256 维切成 32 个头,每头 8 维;然后把所有 token 的第 1 个头拼成一个新 token,第 2 个头拼成另一个,依此类推,各自过一个 SwiGLU,再还原回原来的 token 排列。手算一个小例子:4 个 token、每个 4 维、切成 2 个头,混合后第一个新 token 是 4 个原 token 各自的前 2 维,共 8 维。这一步让不同来源的信息在同一组通道里相互作用。第二步是每个 token 用自己独立的参数做一次 SwiGLU,把通道重新组合。 Hoot 说

混合前:4 个 token × 4 维(2 个头)
- token A
- A1 A2 ‖ A3 A4
- token B
- B1 B2 ‖ B3 B4
- token C
- C1 C2 ‖ C3 C4
- token D
- D1 D2 ‖ D3 D4
每个 token 只装着自己那一路来源的信息。
拼好之后:2 个新 token × 8 维
- 新 token 1(头 1)
- A1 A2 B1 B2 C1 C2 D1 D2
- 新 token 2(头 2)
- A3 A4 B3 B4 C3 C4 D3 D4
- 各过一个 SwiGLU
- 再还原回 4 个 token
还原后,每个 token 的每个头都已经和其他 token 的同一个头相互作用过。
左边每行是一个原 token(A1 A2 是它的头 1,A3 A4 是头 2);右边每行是混合后的新 token。真实模型里每个 token 256 维,切成 32 个头,每头 8 维。 出处: 论文的特征交叉层(借自 RankMixer / TokenMixer-Large):256 维切成 32 个头、每头 8 维,按头重排后各过 SwiGLU 再还原;4 个 token 的小例子是正文的手算
为什么不直接对所有 token 做自注意力?论文的理由是推荐特征很异质,单头注意力的输出秩不会超过 value 的秩,纯注意力堆叠还有让 token 越来越相似的倾向;OneTrans 的消融也显示,每层保留全部 token 会增加计算却不一定提升效果。按头混合不需要学注意力权重,计算便宜,又能保证每个 token 都拿到其他 token 的信息。
高秩注意力:先按场景压缩,再从多个角度看
主干输出很多 token,直接在上面做高阶注意力既贵又杂。HiRank 先用场景 token 做压缩:用样本所属的流量场景(首页、主搜索或其他)生成几个 query,对最后一层的全部 token 做交叉注意力,展平成一个 1536 维的紧凑向量。首页样本和搜索样本因此会从同一堆 token 里取出不同的证据,这是它处理多场景的方式。
然后是 Hiformer 式的组合投影:三套参数独立的组合投影分别生成 query、key 和 value;每套投影都读取完整的 1536 维向量,生成 24 个 256 维 token,再用这三组 token 做一次多头注意力。注意力输出的 24 个 256 维 token 先拼成一个 6144 维向量,再经过一层线性变换压回 1536 维,加回原来的紧凑向量(残差);各个任务(点击、转化等)各有一个小 MLP 塔,读这个更新后的向量,输出各自的预测概率。为什么不把 1536 维直接切成 24 段?切段的话,每个 token 只看得到一部分信息;组合投影让每个 token 都看到全部信息,只是看的角度不同。论文的有效秩诊断显示,经过这一步,平均有效秩从 228.58 变为 224.09,只降了 1.96%,说明高阶交互没有把表示压到少数几个方向上。
实验结果
离线数据来自淘宝全站的 CVR 样本,每天约 24 亿次曝光,首页约 4.38 亿次。所有对比模型用相同的特征、历史和训练数据,按验证集 CVR AUC 调参。下表摘自论文表 2:
| 模型 | 首页 AUC | 首页 GAUC | 主搜索 AUC | 参数量(M) | 每个候选 GFLOPs |
|---|---|---|---|---|---|
| DCNv2 + DIN(线上基线) | 0.9136 | 0.7294 | 0.8748 | 36.98 | 0.428 |
| RankMixer + DIN | 0.9143 | 0.7473 | 0.8755 | 350.15 | 1.002 |
| OneTrans | 0.9154 | 0.7592 | 0.8759 | 345.40 | 1.768 |
| HyFormer | 0.9148 | 0.7615 | 0.8758 | 344.40 | 1.280 |
| MDL(多场景) | 0.9147 | 0.7439 | 0.8756 | 343.62 | 0.990 |
| HiRank | 0.9163 | 0.7801 | 0.8764 | 299.04 | 1.530 |
首页 GAUC 比最强基线 HyFormer 高 0.0186,而全局 AUC 只比 OneTrans 高 0.0009。这个差距说明 HiRank 的收益主要在“同一个用户该先推哪件”,而这正是从用户自己的序列出发做检索想要改善的地方。主搜索流量上(论文表 2 的另一半),HiRank 的 GAUC 比该场景最强的基线只高 0.0009,AUC 只高 0.0005,说明这套设计对首页推荐的帮助远大于搜索,后者有 query 作为强信号,用户历史的边际价值小一些。成本上,HiRank 的参数比 OneTrans 少 46M,每个候选的计算量也低约 13%。
消融(论文表 3,首页 CVR)把收益拆到了各部件:
| 去掉的部件 | AUC | GAUC |
|---|---|---|
| 门控注意力(换成 DIN) | 0.9160 | 0.7623 |
| 两类 query 检索(换成只按候选的 DIN) | 0.9159 | 0.7591 |
| 特征交叉 | 0.9158 | 0.7714 |
| 高秩注意力 | 0.9154 | 0.7685 |
| 特征交叉和高秩注意力都去掉 | 0.9143 | 0.7312 |
| 完整 HiRank | 0.9163 | 0.7801 |
两类 query 检索的贡献最清楚:只用候选去查长期历史,GAUC 掉了 0.021,接近 HiRank 相对最强基线的全部领先幅度。把交叉和高秩注意力同时去掉,GAUC 掉到 0.7312,几乎退回线上基线的水平,支持行为建模与特征交互在该模型中的互补作用。
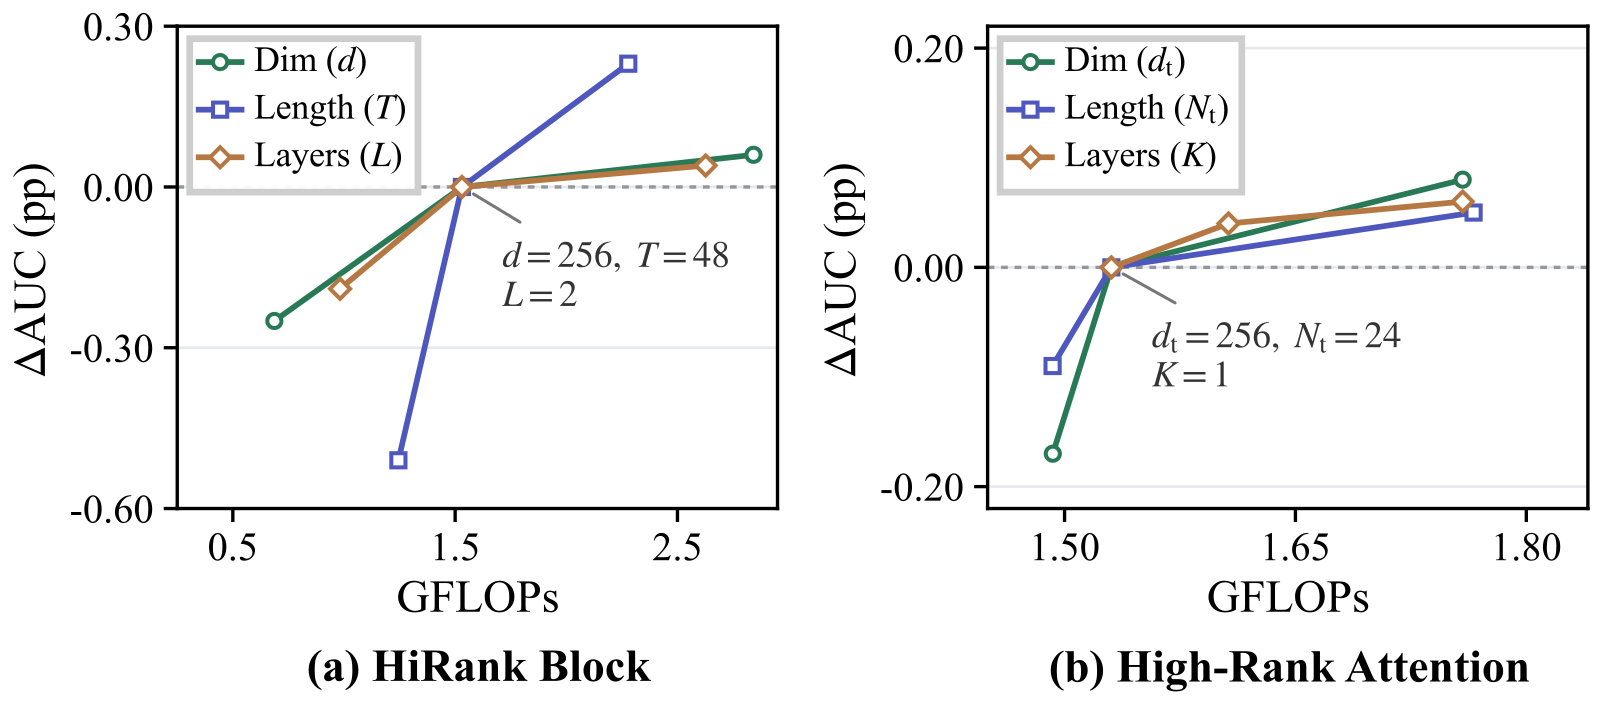
扩展实验给了一个很实用的信号:在这套结构里,加长主序列远比加宽、加深划算。这和“主序列负责生成检索 query”的设计是一致的,序列越长,生成的兴趣 query 越准。
线上 A/B 在淘宝首页流量上按用户分桶,对照是线上排序模型:人均订单数提升 2.27%(p<0.01),人均 GMV 提升 2.86%(p<0.05),每日下单用户数提升 2.13%。曝光量只涨了 0.45%,每千次曝光的订单数涨了 1.81%,说明增长主要来自转化效率,而不是多曝光了商品。
我认为它的局限
第一,有效秩的论证只是相关,不是因果。论文展示了检索前后有效秩从 24.52 升到 54.88,但没有做“压低有效秩、看效果是否下降”这样的对照,也没有比较不同结构的有效秩和 AUC 的关系。标题把有效秩放在最前面,证据却主要来自消融表。
第二,上线成本没讲清。论文提出了一个让同一请求的候选共享用户侧计算的解耦版本,但没有报告它的离线效果和线上延迟,A/B 里也没说用的是哪个版本。每个候选 1.530 GFLOPs 是线上基线 0.428 的 3.6 倍,对没有请求级批处理的团队,这个差距很关键。
第三,基线都是作者在自家数据上复现的。OneTrans、HyFormer 等的论文各自报告过不错的线上结果,而这里几个新基线之间的首页 AUC 最多只差 0.0016,复现和调参的投入是否对等,外人无法判断。主搜索上 HiRank 的全局 AUC 只比最强基线高 0.0005,也提醒我们这套设计的收益和场景强相关。
一个推荐团队可以怎么试
- 先测长期历史检索的 query 来源:保持现有模型不变,只把查长期历史的 query 从画像特征或候选商品换成“可学习种子向量读最近序列”的结果,看 GAUC 是否明显提升。相关消融把整个互补检索模块换成只按候选查询的 DIN,GAUC 从 0.7801 降至 0.7591,反映的是整项替换的影响。
- 同时统计 query 向量的有效秩。如果现有 query 的有效秩很低,说明不同用户查到的东西高度雷同,这一步的收益空间就大。
- 有收益再引入逐层回路:让交叉层的输出成为下一层的检索 query,比较一层和两层的差别,并记录每个候选的计算量。
- 最后考虑场景压缩和组合投影。如果是多场景混合训练,先只加场景 token 的压缩,看各场景的 GAUC 是否分别上涨;同时优先试加长主序列,论文里这是最划算的扩展方向。
一句话结论
让用户最近的行为去决定查哪些长期历史,比让静态画像或候选商品去查更能区分用户,这是 HiRank 里最值得借鉴的一点;整套结构的计算成本较高,适合已经有大模型排序基础设施的团队。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。序列和特征交叉的融合、多场景联合训练,是大规模排序的常见难题 |
| 方法创新性 | 中。多数部件来自 HSTU、RankMixer、Hiformer,新意在于从序列生成检索 query 和逐层回路 |
| 实验证据 | 中高。淘宝真实数据、同条件对比多个新基线、有消融和线上 A/B;有效秩部分只有诊断 |
| 工程成本 | 高。每个候选的计算量是线上基线的 3.6 倍,解耦版本的效果和延迟没有报告 |
| 是否值得尝试 | 值得试其中的“序列生成检索 query”,整套结构按算力预算决定 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…