分享 SHARE

做搜索或推荐排序、在考虑“把模型做大”的团队值得读,因为它给了一个很实用的提醒:参数加到一定程度,瓶颈往往在训练数据,而扩充的数据又必须配上能消化它的结构。淘宝搜索的 UniScale 核心思想一句话:先把未曝光的候选和其他场景(推荐、店铺)的用户行为都改造成搜索样本,让训练数据变成原来的 5 倍;再设计一个按特征类型、按场景分开处理的 Transformer 排序模型来吸收这些数据。离线结果里,同样的扩充数据放到不分场景的结构上,AUC 相对下降 0.43%;放到新结构上,AUC 相对提升 0.32%。10 天线上 A/B 中,购买数提升 1.70%,GMV 提升 2.04%。
它解决什么问题?
排序模型通常只用“被曝光过的搜索结果”训练:曝光后点了是正样本,没点是负样本。作者认为这样会带来三个问题,而且模型越大越明显。
第一是选择偏差。线上排序要在整个候选列表里打分,但训练时只见过排在前面、被曝光的那一小部分,从没见过“明显不相关”的候选。第二是标签稀疏。成交按最后一次搜索点击归因,用户在搜索里看过某件商品、后来在推荐流里买下,这个信号就丢了。第三是场景盲区。用户在推荐流、店铺页的大量点击和购买,因为没有 query、特征格式也不一样,搜索模型完全用不上。
下面用一个示意例子贯穿全文。用户搜“连衣裙”,这次请求的候选列表里有 100 件商品,曝光了 10 件,用户点了其中 1 件。当天她又在推荐流里买了一件曝光过但没点的连衣裙,还在推荐流里点了一件外套。按传统做法,这些信息里只有“1 次点击、9 次未点击”进入搜索模型的训练集。
先看全景
整个框架分两半:全空间样本系统 ES³(Entire-Space Sample System,作者自己起的名字)负责扩数据,HHSFT(异构分层样本融合 Transformer,作者提出的排序模型)负责吸收这些数据。
| 部分 | 做什么 | 训练数据规模变化(相对只用曝光样本) |
|---|---|---|
| 补未曝光样本 | 从每次请求的完整候选列表里随机抽未曝光商品 | 样本 3 倍,点击正样本不变 |
| 分层标签归因 | 把其他场景的点击和成交回填到搜索样本上 | 点击正样本 2 倍 |
| 跨场景样本搜索化 | 把推荐、店铺里的点击补上 query,改造成搜索样本 | 请求 2 倍,样本 5 倍,点击正样本 4 倍 |
| HHSFT 特征交互 | 不同类型特征用各自的投影,再做全局交互 | 不改数据 |
| HHSFT 场景融合 | 共享专家加各场景专家,再按当前场景加权 | 不改数据 |
扩数据全在离线完成,线上只部署搜索这一个出口,所以不增加线上计算,只多一些存储。
ES³:怎么把数据扩到 5 倍
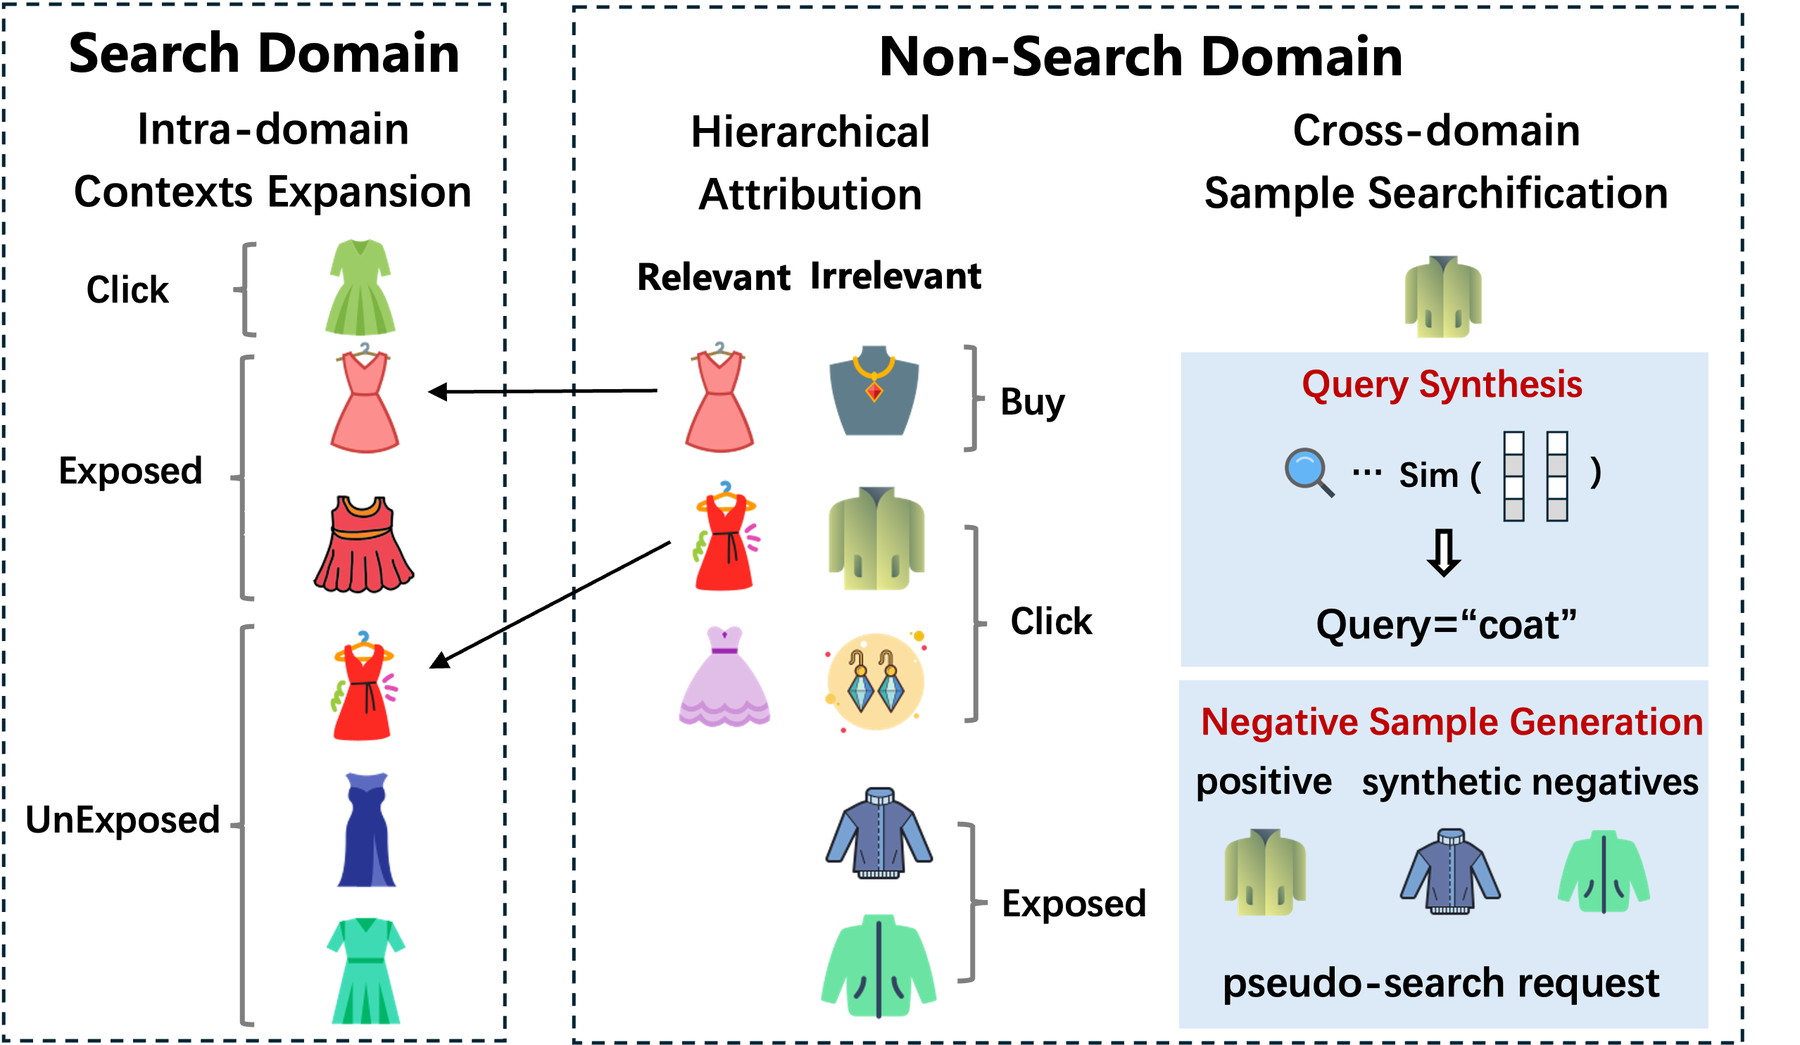
补未曝光样本是为了让训练分布接近线上打分时的候选分布。在示意例子里,从 90 件未曝光商品中随机抽一部分加入训练,样本数从 10 条变成约 30 条。
但未曝光商品不能一律当负样本。它们没被曝光,是因为旧模型没把它们排上来,不代表用户不喜欢;天天这样训练,模型会越来越压低长尾商品,形成自我强化的循环。所以作者用分层归因给这些样本补标签。归因每天离线跑一次,回填的对象是同一用户在搜索里遇到过的同一件商品。论文给出的规则是样本类型之间的优先级,下面的示意按“每次包含这件商品的搜索请求各自判断一次”来理解:其他场景的点击,如果这件商品在搜索里曝光过,就标在曝光样本上,否则标在未曝光样本上;其他场景的成交,依次优先标在搜索点击样本、曝光未点样本、未曝光样本上。在示意例子里,推荐流里买下的那件连衣裙在搜索里曝光过但没点,这条样本的成交标签从 0 变成 1。作者认为当天在商品详情页的购买这类信号来自搜索曝光之外,所以可以当成对用户兴趣的独立观测,用它来纠正“未曝光等于不喜欢”的偏差。这一步让点击正样本变成 2 倍。
跨场景样本搜索化处理那件推荐流里的外套点击。为什么不能直接用?推荐请求里的商品五花八门,同一屏里可能有衣服也有电子产品,直接把没点的当负样本,会混进和 query 无关的噪声;而且推荐样本没有 query 字段。作者分两步补齐。补 query 按优先级:先用这个用户历史上搜到这件商品时用过的 query,没有就看搜索日志里这件商品和哪些 query 经常一起出现,只采用共现次数过了显著性阈值的 query,用来排除偶然碰在一起的组合,再没有就用商品标题的 embedding 在 query 库里做近邻检索(要求最低余弦相似度)。补负样本时,只从同一次推荐请求里挑和被点商品语义相近、但没被点击的商品。最后这些样本走搜索的特征日志流程,特征格式和真实搜索样本完全一致。
数据变成 5 倍后,作者把存储格式改成每行一次请求加它的全部候选,用户和 query 特征只存一次、算一次,存储和 IO 大约省一半。
HHSFT:怎么吸收这些数据
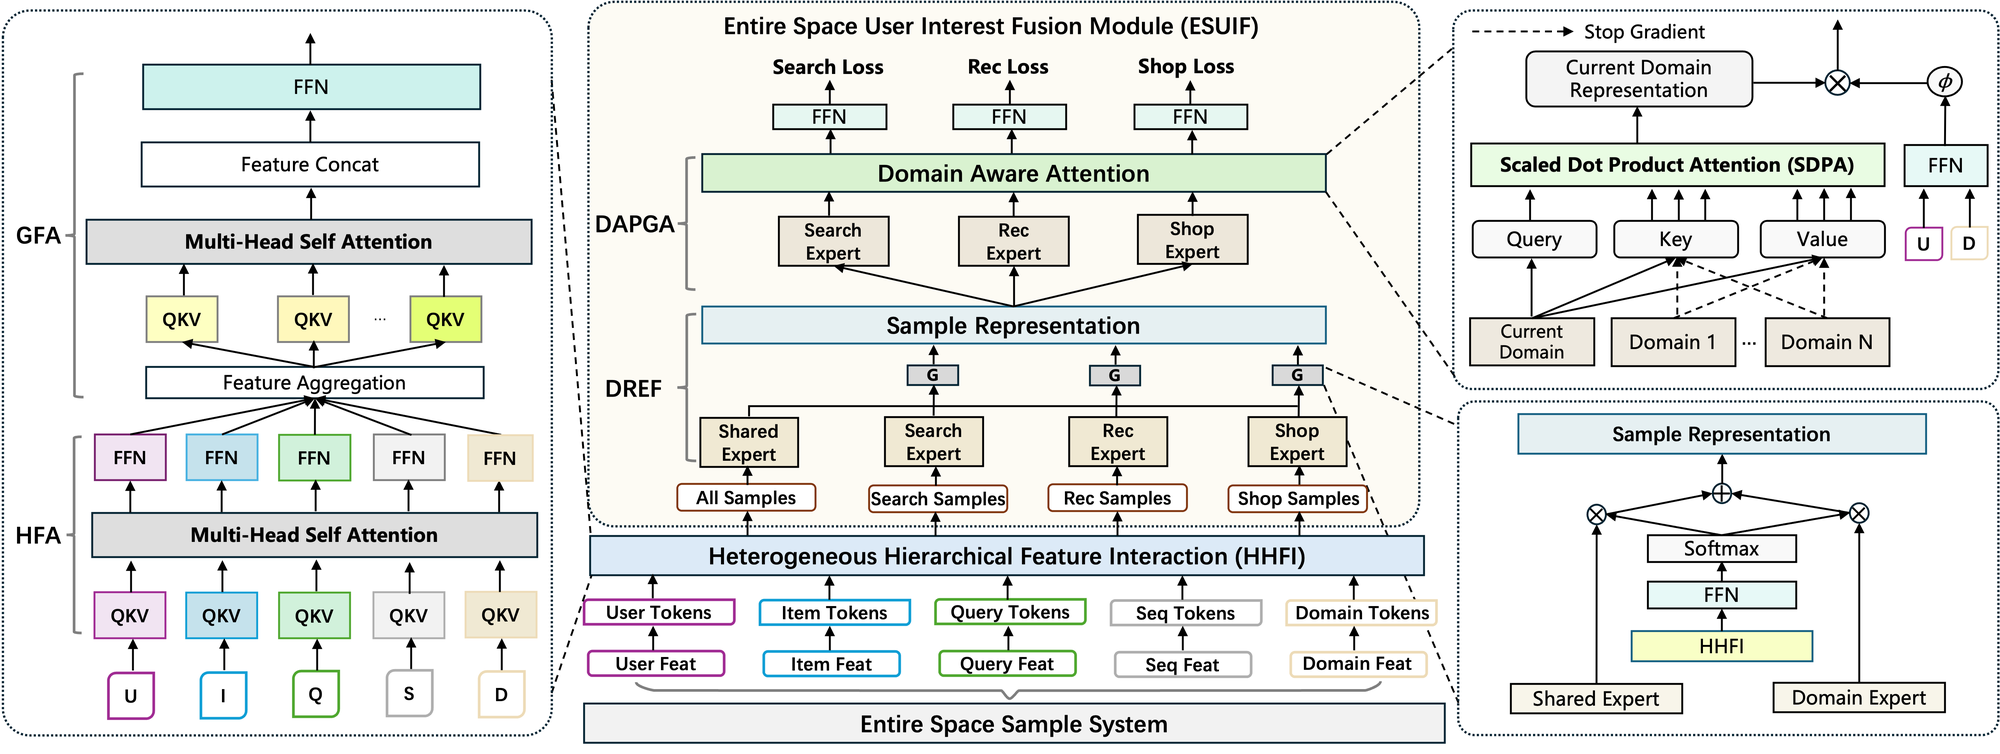
第一层是异构特征注意力(HFA)。为什么需要它?标准 Transformer 让所有 token 共用一套查询、键、值投影矩阵(即 QKV(query、key、value)投影),但用户 ID、价格、行为序列来自完全不同的语义空间,共用投影会把它们搅在一起。HFA 给每个特征块一套自己的 QKV 投影和 FFN,再做普通的多头注意力。
第二层是全局特征注意力(GFA)。为什么还需要这一层?HFA 之后每个 token 仍主要代表自己的特征块。GFA 把所有 token 拼成一个长向量,再用 m 组投影各生成一个新 token,每个新 token 都看得到全部特征。在作者的基础配置里,m=8、每个新 token 256 维。消融里,把 MLP 换成普通 Transformer 带来 0.17% 的 AUC 相对提升,加上 HFA 到 0.41%,再加 GFA 到 0.80%。这说明特征块分开投影和全局交互各贡献了一半左右。论文把 HFA 和 GFA 合起来称为 HHFI(异构分层特征交互)。
特征交互之后是场景路由专家(DREF)。为什么需要它?把推荐、店铺样本直接混进来会产生负迁移。DREF 用一个共享专家处理所有样本,学跨场景通用的模式;每个场景的专家只用本场景样本前向和回传梯度,从优化层面把别的场景的噪声隔开。最后用一个门控按样本给两者分权重,比如示意中共享专家 0.7、搜索专家 0.3,输出就是两者按这个比例加权。
最后是场景感知个性化门控注意力(DAPGA)。为什么需要它?最终只在搜索上线,所以要以搜索为中心吸收其他场景的知识。这一层有自己的一组场景专家(图中上方的搜索、推荐、店铺专家),和 DREF 层只吃本场景样本的专家不是同一组。DREF 的输出会前向经过这一层的所有场景专家。对一条来自某个场景的样本,用它本场景专家的输出做 query,所有专家的输出做 key 和 value 做注意力;其他场景专家那几路只做前向、不回传梯度。每个场景有自己的输出头和交叉熵损失(图中的 Search Loss、Rec Loss、Shop Loss),样本只在本场景的输出上算损失,所以推荐样本只更新推荐那一路,搜索样本只更新搜索那一路,共享部分由所有样本一起更新。上线时只用搜索那个输出。最后用用户静态特征和场景特征算一个 0 到 1 之间的门控向量,逐元素乘到结果上。示意:某一维门控是 0.2,就表示这一维来自融合结果的信息被压到原来的五分之一。
结果
离线主结果,所有数字都是相对 DLRM-MLP 基线的 AUC 和 GAUC 相对提升(论文表 2 节选)。论文给的经验是,相对提升 0.05% 就算可信的改进。
| 模型 | AUC | GAUC | 参数(百万) |
|---|---|---|---|
| DCNv2 | +0.08% | +0.01% | 24 |
| Wukong | +0.21% | +0.13% | 32 |
| AutoInt | +0.26% | +0.14% | 150 |
| RankMixer | +0.38% | +0.32% | 140 |
| HiFormer | +0.54% | +0.49% | 170 |
| HHSFT,只用搜索曝光数据 | +0.82% | +0.62% | 300 |
| HHSFT 加 ES³ | +1.14% | +0.86% | 300 |
只看结构,在同一份搜索曝光数据上,HHSFT 比 HiFormer 多 0.28 个百分点的 AUC 提升。参数量更大的 HHSFT 赢在结构:AutoInt 也有 1.5 亿参数,提升只有 0.26%,这说明给不同特征块独立投影,比单纯加大模型更划算。
关键的是数据和结构的配合(论文表 4,基准是只用搜索数据训练的 HHFI 特征交互部分):
| 训练数据 | 结构 | AUC | GAUC | HR@5 |
|---|---|---|---|---|
| 只用搜索 | HHFI 加 DREF 加 DAPGA | +0.02% | +0.01% | +0.02% |
| ES³ 全空间 | 只有 HHFI | -0.43% | -0.24% | -4.76% |
| ES³ 全空间 | HHFI 加 DREF | +0.19% | +0.25% | +0.39% |
| ES³ 全空间 | HHFI 加 DAPGA | +0.22% | +0.18% | +0.17% |
| ES³ 全空间 | HHFI 加 DREF 加 DAPGA | +0.32% | +0.26% | +0.44% |
这张表说明两件事。第一,扩充的数据如果不配场景融合结构,结果是负的,Top5 命中率还掉了 4.76%。第二,场景融合结构如果没有新数据,几乎没用(+0.02%)。两者只有一起上才有收益。
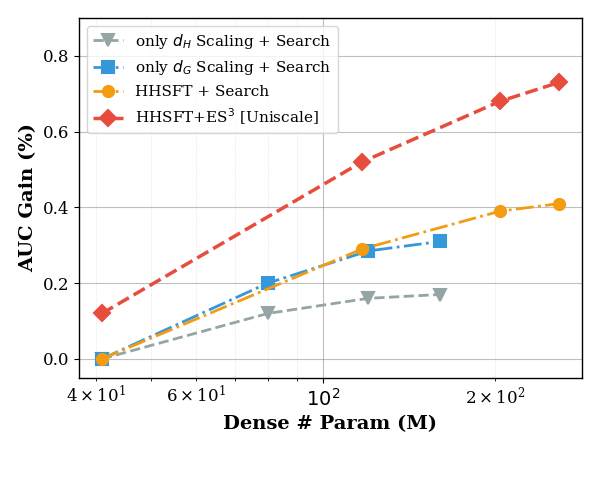
参数量从约 4000 万到约 3 亿,只用搜索数据的 HHSFT 曲线在 1 亿之后明显变平,加上 ES³ 的曲线仍保持上升,两者的差距从 0.12% 扩大到 0.32%。这说明数据越丰富,加参数的收益越能持续。作者也明确说,这只是 7 倍范围内的趋势,不够拟合成 scaling law。
线上 A/B 用 5% 流量跑了 10 天,对照组是生产环境的深度神经网络(DNN)排序模型。实验组购买数提升 1.70%,GMV 提升 2.04%,因为购买比点击更难靠噪声刷高,作者认为这说明回填的跨场景正样本反映的是真实兴趣。另外,特征预哈希、RDMA 通信、FP16 量化和融合注意力算子这些工程优化,让 GPU 推理成本降低一半以上。
局限
第一,离线指标只有相对值。表里全是相对 DLRM-MLP 的百分比,没有 AUC 的绝对值,读者无法判断基线本身的水平。HHSFT 加 ES³ 相对 HHSFT 的 0.32% 提升,在 0.05% 的“可信改进”门槛之上,但论文只报告了单次训练的结果。
第二,线上收益无法拆分。A/B 的对照组是生产 DNN,实验组同时换了结构、换了数据,还有一批工程优化。1.70% 的购买提升里,有多少来自 ES³、多少来自 HHSFT,线上没有分开测。离线看,结构单独贡献 0.82%,数据加融合结构再贡献 0.32%,大部分可能来自结构。
第三,标签回填的风险主要靠结构兜底。未曝光样本被标成正样本后,训练和真实曝光之间存在分布差异,作者的处理是交给 DREF 和 DAPGA 在结构上吸收;不配这两个模块时 HR@5 下降 4.76%,说明这一步对结构的依赖很强。另外,规模曲线最高只到约 3 亿参数,作者自己把结论限定为“趋势”。
一个排序团队可以怎么试
- 先改结构:在现有搜索数据上,把特征按用户、商品、query、序列分块,给每块独立的 QKV 投影和 FFN,再加一层全局注意力。论文里这一步单独就有 0.80% 的 AUC 相对提升,而且不依赖新数据。
- 再补搜索内部的数据:从每次请求的候选里抽未曝光商品,用其他场景的点击和成交按优先级回填标签。这一步工程量小,能把样本和正样本分别扩到约 3 倍和 2 倍。
- 只有当其他场景的用户行为明显多于搜索行为时,才做跨场景搜索化,并同时加上共享专家、场景专家和以搜索为中心的注意力。上线前先在离线确认,同一份扩充数据在旧结构上掉点、在新结构上涨点。
- 观察 Top5 命中率而不只看 AUC。论文里负迁移在 HR@5 上表现得最明显(-4.76%),比 AUC 敏感得多。
结论与评价
这篇论文最有价值的结论是:排序模型扩数据时,跨场景样本不能直接混进去训练,必须配上按场景隔离梯度的结构,否则数据越多效果越差。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。排序模型 scaling 遇到边际收益递减是工业界普遍问题 |
| 方法创新性 | 中。全空间样本、多场景专家、异构特征投影都有先例,新意在数据和结构的配套设计 |
| 实验证据 | 中。消融清楚,有线上 A/B;但只有相对值、单次训练,线上没有拆分数据和结构的贡献 |
| 工程成本 | 中高。需要跨场景日志打通、query 合成和标签归因流水线,以及 3 亿参数模型的训练推理优化 |
| 是否值得尝试 | 值得,按作者建议的顺序先改结构、再补搜索内部数据,跨场景部分视数据量再定 |
| 适用场景 | 有搜索、推荐、店铺等多个入口,且非搜索行为远多于搜索行为的电商平台 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…