目录 · 8 节
1只看距离,会把两种片子当成一样2三个量:差距、周围的了解、最近习惯的跨度3五条公理收成一个公式4走一遍:同一部片,三个人看5问卷:算出来的好奇心和人说的对得上吗6离线和线上,加上它之后变了多少7这对做推荐的人意味着什么8局限
两部离你一样远的片子,为什么只有一部让你想点开?给推荐系统量一量「好奇心」首页给你推了两部没看过的片子。按推荐系统算的距离,它们离你的口味一样远。区别在于,第一部周围堆着很多你看过的同类片,第二部所在的那一片,你一部都没看过。
你多半会对第一部好奇。这类片怎么拍你大概有数,正想知道它哪里不一样。对第二部你很可能没什么感觉,因为你连它缺了什么都看不出来。可推荐里常用的「意外度」一类指标只看距离,会给这两部打一样的分。
这篇是 Li 和 Tuzhilin 的工作论文,要做的是给「这件物品此刻能勾起这个人多大好奇心」算一个分数,并把它用进推荐排序。现有做法有三类。意外度(unexpectedness)按物品离用户预期有多远打分,每个用户有一个固定的最佳距离。求新倾向(variety-seeking)把「爱不爱尝鲜」当作用户的长期性格,用来放大或缩小意外度。Wundt 曲线类方法认为刺激太小没感觉、太大会反感,每个用户估一个固定的最佳刺激量。三者都没管用户在这件物品周围已经知道多少。作者从心理学的信息缺口理论出发,写出五条公理,再加四条形状条件,推出一个只剩一个参数的好奇心公式。在 283 人的问卷里,按设计好的差距计算时,这个分数和人们自报的好奇程度最贴近;更重要的是,最勾人的差距会像公式预测的那样随人移动。把它加到现有相关性分数上,三个离线数据集都超过了这些旧指标和多样性重排;在亚洲一家大型视频平台的一个月 A/B 实验里,点击率提高 2.75 个百分点,这家平台随后上线了这个方法。
最让人好奇的物品离你多远,要看你在它周围看过多少、最近习惯了多大的跨度;线上证据来自一家视频平台、一次用简化公式的实验。
只看距离,会把两种片子当成一样
意外度、求新倾向和 Wundt 曲线有一个共同点:分数主要由物品离用户的距离决定,最佳距离是每个用户一个固定值。
开头那两部片子就是它们的盲区。距离一样,最佳距离也一样,分数自然一样。可人的好奇心需要一点已有的了解。信息缺口理论(Loewenstein 1994)的说法是:你得先知道一部分,才会意识到还缺一部分;什么都不知道的人只会无所谓。
这个理论还有一层意思:缺口是相对的。同样大的缺口,对最近一直在看熟悉内容的人来说太大,对最近一直在换口味的人可能刚好。
所以作者要的分数,得同时看三样东西。
三个量:差距、周围的了解、最近习惯的跨度
第一个量是信息差距 g,就是物品向量和用户状态之间的欧氏距离。物品向量由 AutoEncoder 从标题、类型、导演这些特征压出来。用户状态是一个 GRU 按顺序读完用户看过的物品后的隐状态,训练目标是让这个距离能预测用户会不会点。g 越大,这件物品对他来说越陌生。
第二个量是周围的了解 f,取值在 0 到 1 之间。做法是把用户看过的每件物品按离这件候选的远近给一个权重,越近权重越大,再把权重加起来,压到 0 到 1 之间。所以周围一部都没看过时,f 接近 0;看过的越多越近,f 越接近 1。离这件候选很远的那些历史,几乎不加分。
第三个量是参考差距 τ,就是用户最近遇到的那些差距的平均值,越近的权重越大。一个人上周一直在看熟悉的情景喜剧,每次遇到的差距都小,τ 就小。他这周开始换着看新类型,τ 会跟着变大。τ 可以每看一件就递推更新一次,不用回头扫整段历史。
五条公理收成一个公式
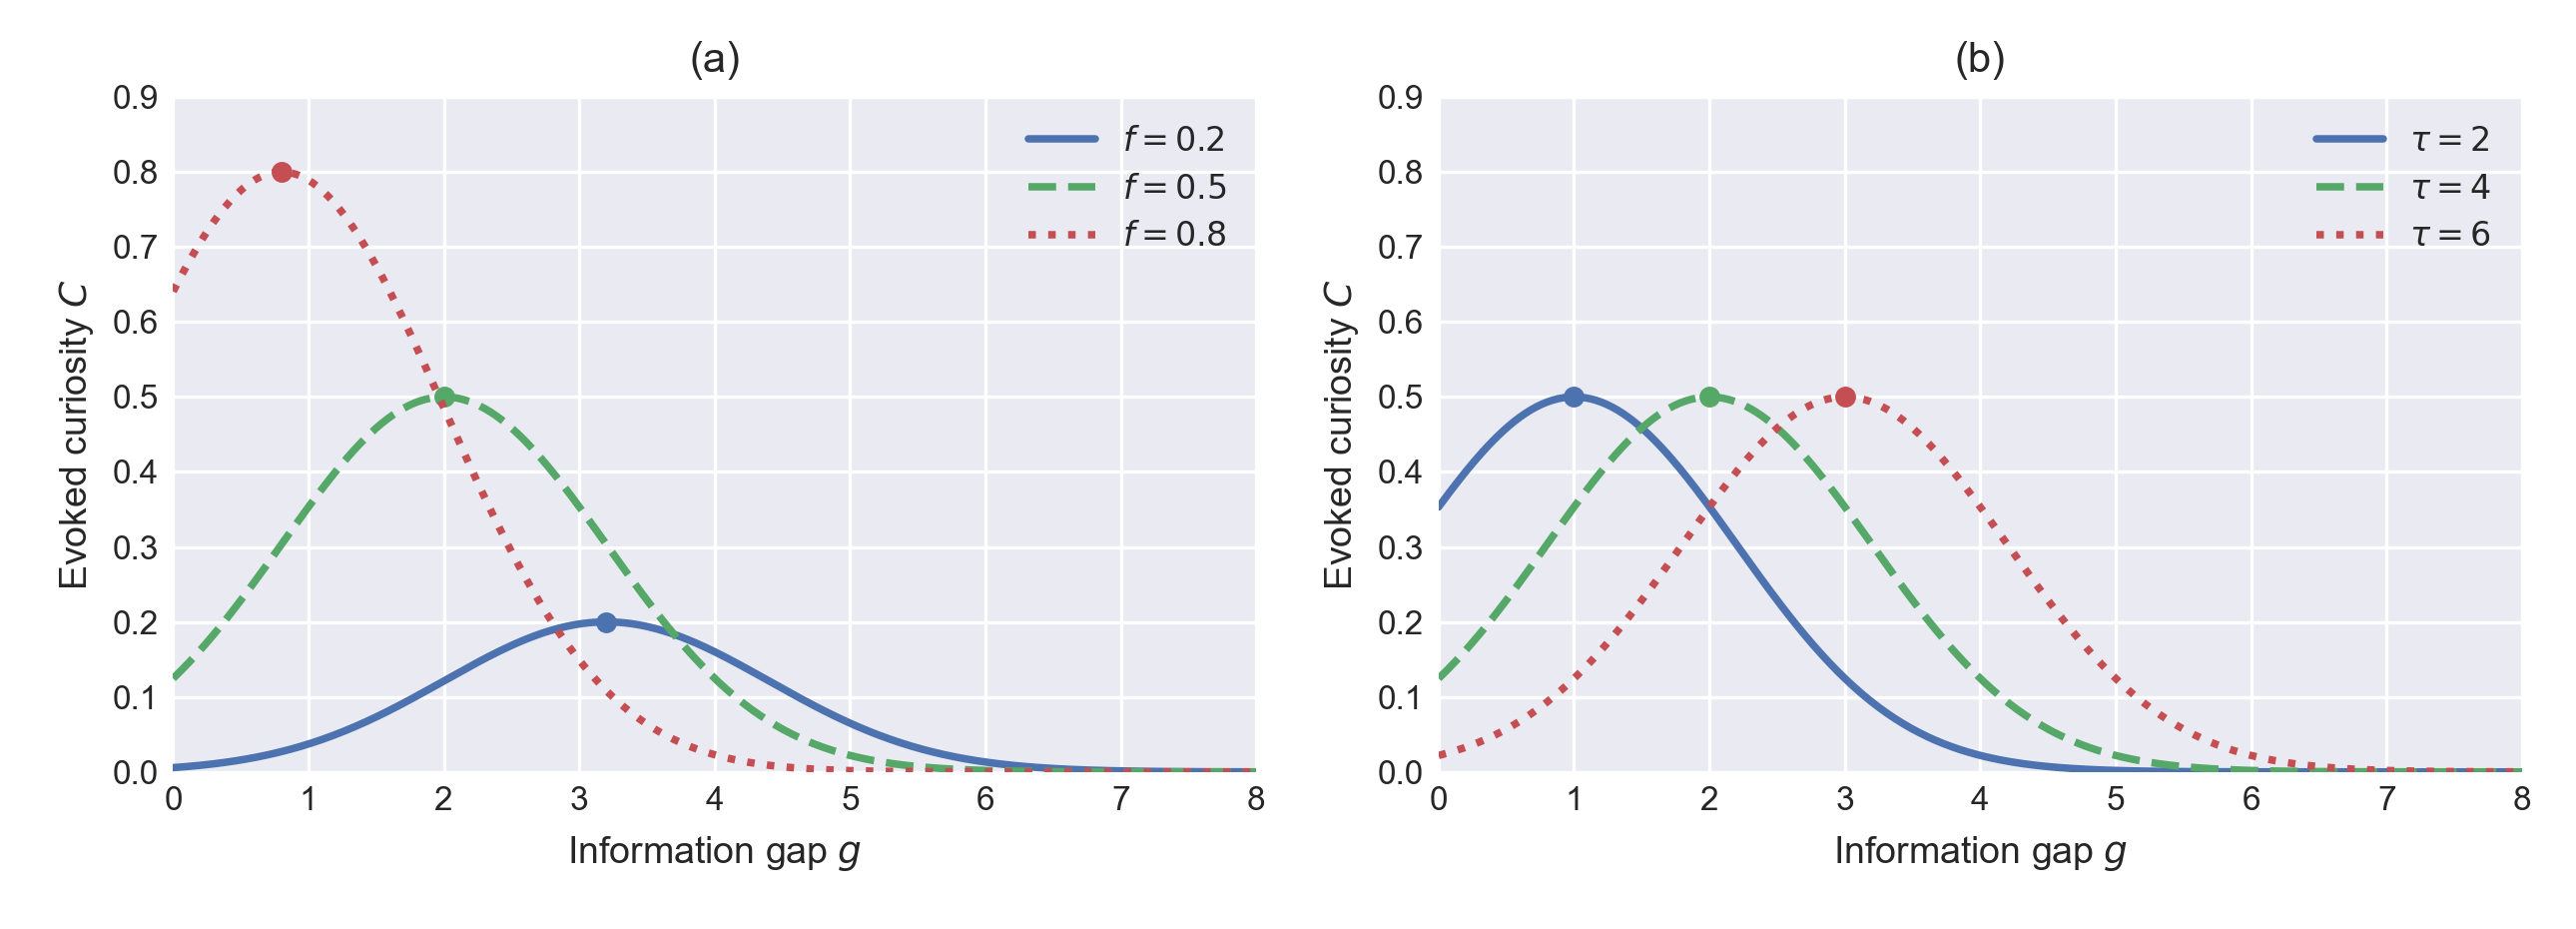
作者把信息缺口理论拆成五条公理。好奇心只由 g、f、τ 决定。周围一点都不了解(f = 0)或差距大到无穷时,好奇心为 0。f 越大,最让人好奇的差距越小,就像影评人会被同一场戏两位导演处理上的细微差别吸引,新手需要大得多的差距才觉得有东西可看。τ 越大,最让人好奇的差距越大。τ 是最近差距的加权平均,越近的权重越大。
五条公理只规定了两头为 0、中间有一个最高点,以及这个最高点往哪边移,没有定下曲线的具体形状,满足它们的函数有无穷多个。推荐系统要的是一个能直接算的公式。作者又加了四条形状条件,比如峰的位置在 f 接近 0 时等于 τ、在 f = 1 时等于 0,中间随 f 均匀移动;峰的高度在 f = 0 时为 0、f = 1 时为 1,中间也均匀变化。论文证明,满足这些条件的公式只有一个: Hoot 说
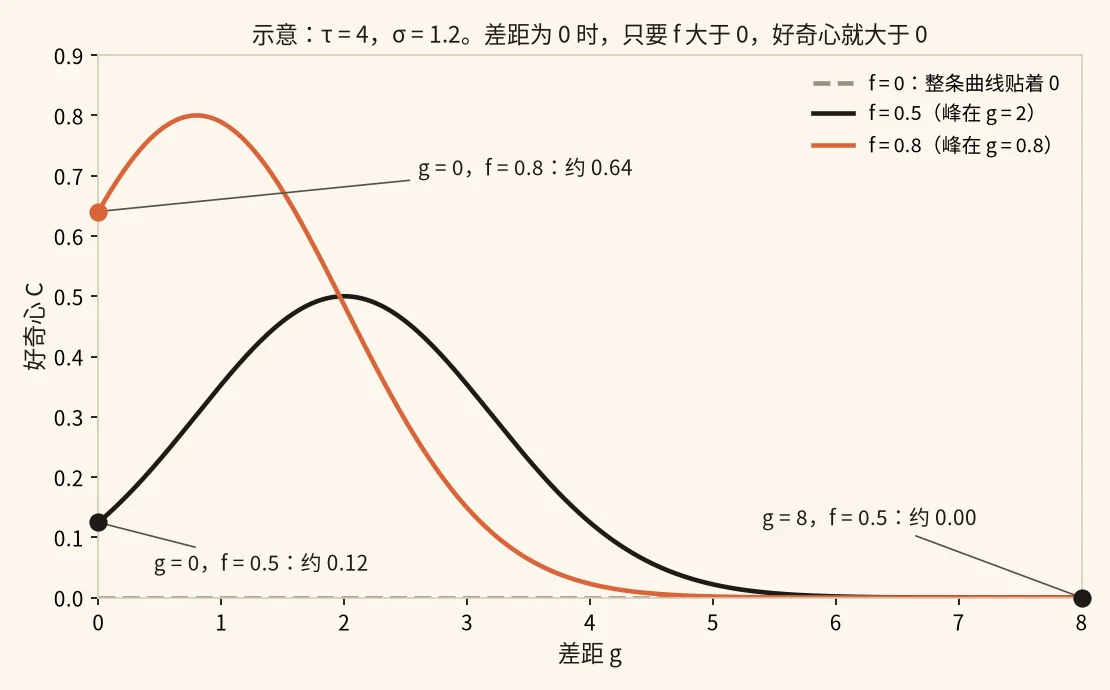
沿用正文的参数 τ = 4、σ = 1.2,公式是 C = f × exp(−(g − τ(1 − f))² ÷ 2σ²)。下面把差距 g 推到两个极端,数字是示意。
f = 0 → 整条曲线都是 0;f > 0 → 差距为 0 处仍有分 → 差距很大才归零
- 周围的了解 f = 0 → 整条曲线f 是公式最前面的乘数,也是峰的高度。f = 0 时,不管差距是多少,好奇心都是 0。0 × exp(…) = 0
- 差距 g = 0 → 甲的好奇心甲的 f = 0.5,峰在 τ(1 − f) = 2。候选片的差距 g 为 0 时,离峰还有 2,好奇心约 0.12,比 0 大。0.5 × exp(−2² ÷ 2.88) ≈ 0.12
- 了解更多 → 零差距处更高乙的 f = 0.8,峰挪到 0.8,离差距 0 只差 0.8。所以差距为 0 的片,好奇心约 0.64,像影评人会被细微差别吸引。0.8 × exp(−0.8² ÷ 2.88) ≈ 0.64
- 差距很大 → 归零把甲的差距推到 8,离峰有 6,指数项几乎是 0。公理说的另一头「差距无穷大时为 0」指的是这里。0.5 × exp(−6² ÷ 2.88) ≈ 0.00
所以「两头为 0」说的是两种条件:周围一点都不了解,或者差距无穷大。差距为 0 只要 f 大于 0,好奇心就大于 0。
出处
论文第 3 节的五条公理和好奇心公式;τ = 4、σ = 1.2 取自论文图 3.3;f = 0.5 和 0.8 沿用正文走一遍里甲和乙的值;差距 g 取 0 和 8 是示意好奇心 C = f × exp(−(g − τ(1 − f))² ÷ 2σ²)
翻成白话:好奇心随差距先升后降,最高点在 g* = τ(1 − f),最高点的高度是 f。σ 只管曲线有多宽,是唯一要调的参数。作者在附录里说明,换掉其中一条形状条件会得到别的公式族,但前面五条公理给出的定性预测不变。
走一遍:同一部片,三个人看
下面用论文图 3.3 的参数:σ = 1.2,τ = 4。线上实验里 f 和 τ 的简化算法来自论文附录 D,具体的看片记录是示意。
第一步,算周围的了解 f。线上版本取用户最近看的 10 部片,数其中有几部离候选片的距离不超过 0.1。甲有 5 部,f = 5 ÷ 10 = 0.5,说明他最近看的片子有一半挨着这部候选。
第二步,算参考差距 τ。线上版本把这 10 部片各自被看时和他的差距取平均。甲最近的平均差距是 4,τ = 4。
第三步,定峰的位置。g* = τ × (1 − f) = 4 × 0.5 = 2。对甲来说,差距为 2 的片子最勾人。
第四步,算候选片的分数。候选片和甲的差距 g 正好是 2,落在峰上,C = 0.5 × exp(0) = 0.5。
第五步,换两个人看同一部片,差距和 τ 都不变。乙是行家,最近 10 部里有 8 部挨着它,f = 0.8,所以峰移到 4 × 0.2 = 0.8。差距 2 比峰多出 1.2,正好一个 σ,曲线降到峰高的 0.61 左右,C ≈ 0.8 × 0.61 ≈ 0.49。
丙几乎是新手,只有 2 部挨着,f = 0.2,所以峰在 4 × 0.8 = 3.2。差距 2 比峰少 1.2,同样差一个 σ,C ≈ 0.2 × 0.61 ≈ 0.12。
同一部片,三个人的分数是 0.5、0.49 和 0.12。只看距离的指标给三人的是同一个距离,差别只能来自每人一个固定的最佳距离。这里的差别来自 f:丙对这一片几乎不了解,曲线整体被压低。乙在这一片太熟,最勾他的是更细的差别,差距 2 对他偏大了。
分数算出来后,排序用的是 V = (1 − α) × 相关性分 + α × w × C,两项都先标准化。w 是这个用户对好奇心有多敏感:拿他过去的互动对 C 做回归,固定相关性分,取 C 的系数,且不小于 0。α 是平台定的权重。相关性分可以来自任何现有模型,DIN、MF 都行,原模型不用改。
问卷:算出来的好奇心和人说的对得上吗
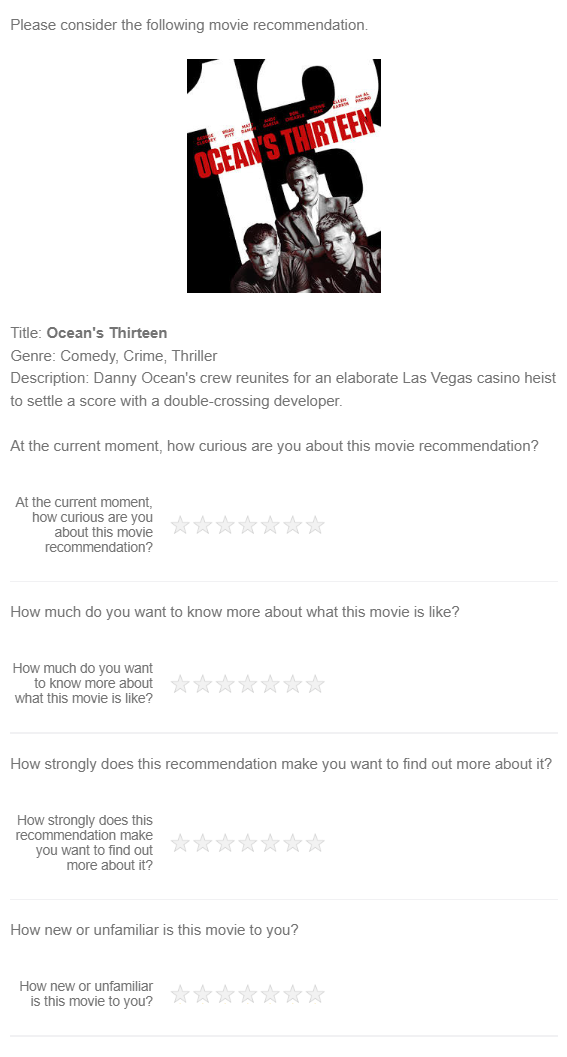
作者从 MovieLens 选电影做了一份问卷。每人依次看 15 张推荐卡,每张卡有海报、标题、类型和简介,看完按 1 到 7 星回答几个问题,其中三个问好奇程度,取平均作为好奇分。电影是按「6 档差距 × 高低两档周围了解」挑的,另加几部几乎没有周围了解的片子,这样每个人都能看到整条曲线。300 人作答,283 人通过注意力检查,共 4,245 条评分。
几项结果如下:
| 检验 | 结果 |
|---|---|
| 和人报好奇分的相关 | 按设计差距 0.636,按模型算的差距 0.598;意外度 0.603、求新倾向 0.589、Wundt 0.611 |
| 控制感知新鲜度和意外度后 | C 让 R² 多出 0.245;新鲜度、意外度最多多出 0.027 |
| 几乎没有周围了解的片子 | 平均 1.41 星,几乎不好奇 |
| 最像自己最爱那部的片子 | 平均 1.48 星,也几乎不好奇 |
| 最勾人的差距 | 低了解时在 2.80,高了解时在 1.87 |
| 按参考差距分三组(低了解) | 峰值依次在 1.72、2.70、3.73 |
(数字来自论文表 5.2 和第 5.2 节)
第一行要分开看。按设计好的差距算,C 比三个旧指标都高;换成模型实际算出的差距,0.598 已经低于 Wundt 的 0.611 和意外度的 0.603。单看相关系数,优势并不稳。
更有说服力的是后几行。控制了新鲜度和意外度之后,C 仍然能解释报告好奇心里 24% 左右的额外方差,那两个指标加进来几乎不增加。两头的片子都几乎不勾人,中间最高,而新鲜度随差距一路上升,只看新鲜度画不出这个形状。峰值的位置也按公式预测的方向在动:了解越多,峰越近;最近习惯的跨度越大,峰越远。旧指标的最佳距离是每人一个定值,解释不了这种移动。
离线和线上,加上它之后变了多少
离线实验用了 Yelp、MovieLens 和 Alibaba-Youku 三个数据集,相关性模型分别用 DIN 和 MF。为了公平,所有方法都用同一套 AutoEncoder 物品向量。意外度等旧指标和 C 一样,按同一个公式和相关性分加权;两种多样性重排方法 MMR 和 DPP(行列式点过程)用各自的重排权衡参数。每个方法的参数都在验证集上用相同的调参预算调到最好。
| DIN 上的 HR@10 | Yelp | MovieLens | Alibaba-Youku |
|---|---|---|---|
| 只用 DIN | 0.409 | 0.422 | 0.113 |
| 旧指标里最好的一个 | 0.491 | 0.477 | 0.163 |
| 加上好奇心 C | 0.512 | 0.495 | 0.216 |
| C 的 f 和 τ 都换成样本中位数 | 0.473 | 0.451 | 0.193 |
(数字来自论文表 6.3 和表 6.4)
按论文表 6.3,加上 C 后,三个数据集的命中率、NDCG、多样性和新鲜度都是所有方法里最高的,换成 MF 也一样;上表只摘了 DIN 的 HR@10。最后一行是消融:把 f 和 τ 都固定成所有人的中位数,C 就只剩差距一个变量,峰对每个人都在同一个位置。这一版在 Yelp 和 MovieLens 上已经不如最好的旧指标。这说明 C 领先旧指标的那部分,很大程度来自「峰随人移动」,单靠「先升后降」不够。只拿掉 τ 的近期加权损失最小,Yelp 从 0.512 降到 0.489。
好奇心的权重 α 也要按平台调。MovieLens 平均每人 151 条记录,命中率在 α 约 0.4 时最高;Yelp 和 Youku 每人只有 34 和 40 条,α 接近 1 时最好。
线上实验在一家月活超过 5 亿的亚洲视频平台,2021 年跑了一个月。516,201 个用户随机分成两组:对照组用线上的 DIN,实验组在同一个相关性分数上加好奇心项,共 26,959,538 条推荐记录。因为线上有延迟限制,实验组用的是走一遍里那种简化算法:f 看最近 10 部片里有几部离得够近,τ 取最近 10 部的平均差距。结果是点击率高 2.75 个百分点,看完率高 1.97 个百分点,每条推荐多看 0.71 分钟,都在 1% 水平上显著。论文没给对照组的点击率基数,所以算不出相对提升。
效果在谁身上大,也和理论对得上。历史每深一个标准差,点击率多涨 0.87 个百分点;最近活跃度每高一个标准差,多涨 1.19 个百分点。60 岁以上用户的交互项是 −13.84 个百分点,大城市用户是 −9.15 个百分点。这两个数是相对未填年龄、未填城市的用户算的,说明这两类人的收益明显低于参照组;论文没给参照组本身的效应,所以算不出他们的净效应是不是负的。
这对做推荐的人意味着什么
想加探索,先算用户在候选周围已经看过多少,再决定离他多远的东西最合适。
这个分数用到的物品向量和用户序列状态,大多数推荐系统本来就有。线上那个简化版只需要最近 10 条历史:数一数有几条离候选够近,再取一下这 10 条的平均差距,计算量很小。想试的话,可以先在离线日志上算出每条曝光的 f、τ 和 C,看点击是不是在 g 接近 τ(1 − f) 的地方最高,再决定要不要放进排序。
第二件事是按人调权重。论文的分组结果显示,年轻用户、付费用户、最近活跃的用户收益最大,60 岁以上和大城市用户的收益明显更低。作者的建议是对前一类人调高好奇心权重,对偏爱熟悉内容的人调低。
局限
线上实验是 2021 年在一家平台上做的,用的是简化版公式,σ 和 α 的线上取值论文没给。对照组的点击率基数也没给,只能看百分点。
问卷是 MovieLens 电影,好奇心是人自己报的,场景和真实刷视频不同。用模型算出的差距时,C 和自报好奇的相关只有 0.598,低于 Wundt 曲线。
公式里只有 σ 由数据决定,峰的位置 τ(1 − f) 和高度 f 都来自作者选的形状条件。换别的形状条件,会得到别的公式。
用户在平台外看过的东西,模型看不到;模型也假设看过的东西不会忘。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…