
AllGather 一跑,旁边的矩阵乘就慢了三成:Zero-SM NCCL 怎么把通信挪走训练一块 B200 的时候,矩阵乘(GEMM)一次会扔出几百个线程块,把卡上 148 个计算核(SM,也就是真正做计算的那些核)排满。可通信库 NCCL 要做一次 AllGather——每张卡交出自己那一份,再收回所有同伴的那一份——默认也要占用一批计算核去搬数据和等旗标。论文在这一节点上测到:一次每卡 144 MiB 的 AllGather,在被它拖慢超过 1% 的那些 Qwen3-30B-A3B 矩阵乘里,中位数大约慢 33%。ETH(苏黎世联邦理工学院) Zurich 和 NVIDIA 提出的 Zero-SM NCCL,就是要把这类集合通信和单边 put 从计算核上彻底挪走,传输过程中不再启动任何计算核上的 kernel。
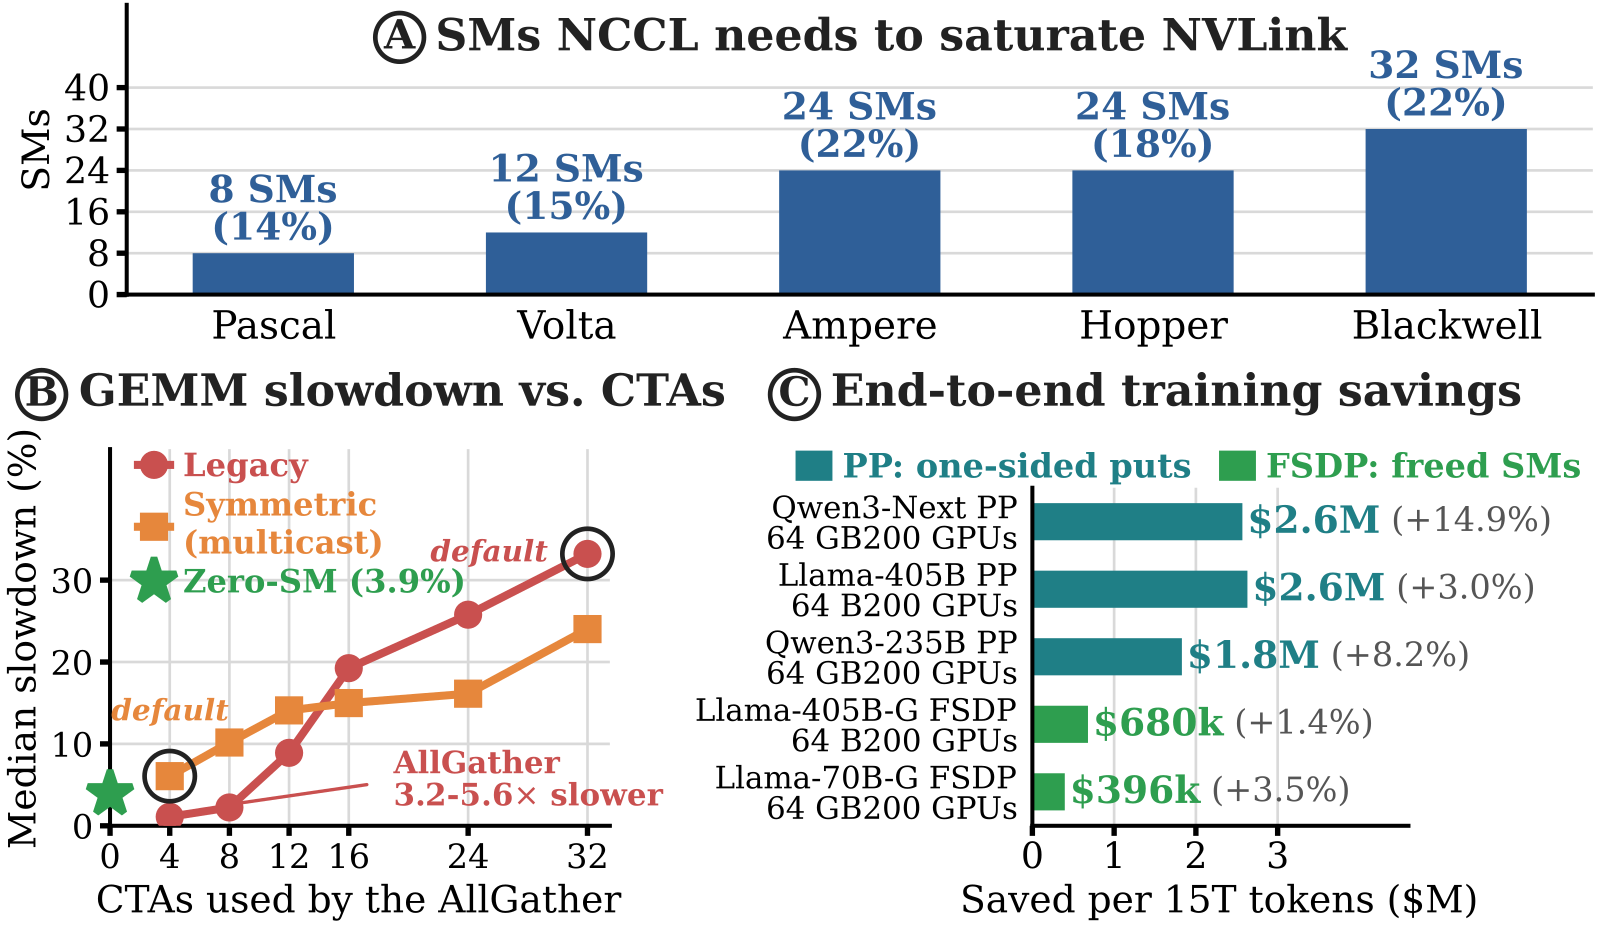
这件麻烦会随互联带宽一起变大。NCCL 为了打满 NVLink,在 Pascal 上要占 8 个计算核,到 Blackwell 已经要占 32 个,大约是整卡计算核的 22%。想少占核,现有的 SM kernel 就得把带宽让出去。
现有做法里,NCCL 的 symmetric kernel 把多段流水协议改成一次完成的 load/store 算法,默认只占几个 CTA(协作线程块),但搬数据和等旗标还是在计算核上做;NCCLX(一套同样面向 GPU 集合通信、可把大宗数据卸载到专用硬件的库)把大宗数据交给专用硬件,同步却仍要启动一个小 kernel。Zero-SM NCCL 用三件事拼出一条完全不占计算核的路径:用 CUDA 的 stream memory operations 做同步,用拷贝引擎在 scale-up 域里搬数据,再用一条按 CUDA stream 顺序工作的 CPU 代理去驱动跨节点的 RDMA。在整机柜 72 张 GPU 同处一个 NVLink 域的 GB200 NVL72(72 卡 NVLink 域),以及单节点 8 张卡的 B200 NVL8(8 卡单节点)上,这条路径的 AllGather 带宽最高达到旧版 SM kernel 的 1.36 倍;按同样口径,被拖慢超过 1% 的那些重叠矩阵乘,中位拖慢从 33% 降到 4%;接到 Megatron-LM 里,FSDP 最高加快 3.5%,用单边 put 做流水线并行最高加快 14.9%。
大消息、而且 GPU 已经跑满的时候,把通信从计算核上搬走能换来更快的训练;消息小,或者主机已经跟不上提交时,这条路会更慢。
通信为什么要占计算核
NCCL 的集合通信是主机发起的:CPU 把操作挂到 CUDA stream 上,GPU 再执行。CUDA stream 是一条有序的工作队列,同一条队列里,后一个操作要等前面的做完才能开始。在一个 scale-up 域里——也就是显存可以互相直接读写的那一组 GPU,通常靠 NVLink 连在一起——旧的 pipeline 协议会拉起几十个 CTA,由线程自己拷数据、做规约、转旗标。跨到 scale-out 网络(节点之间走 InfiniBand 或 RoCE 这类 RDMA 网卡)时,计算核上的 kernel 还要打包数据,把描述符交给 CPU 代理去发 RDMA。两边的同步,包括转旗标、屏障和完成跟踪,都在计算核上做。DMA 引擎会搬字节,但不会写“旗标到了再往下走”这种带条件的控制流。
矩阵乘扔出的线程块远多于卡上的计算核,通信多占一个核,计算就少一个核。图 1 把这件事画了出来。Ⓐ 是各代 GPU 打满 NVLink 所需的核数;Ⓑ 是同一块 B200 上,一次 144 MiB AllGather 占用不同数量 CTA 时,旁边矩阵乘被拖慢多少;Ⓒ 则是作者按 CoreWeave 按需价,把端到端步骤加快换算成 15T token 预训练的估计节省。
不占核的传数怎么拼
Zero-SM NCCL 给自己立了两条规矩。一条是传输过程中不启动 GPU kernel、不占用计算核。另一条是仍然遵守 CUDA stream 的顺序:一次通信必须等同一条 stream 里前面的计算把发送缓冲区写完再开始,后面的计算也必须等数据到齐才能读接收缓冲区。
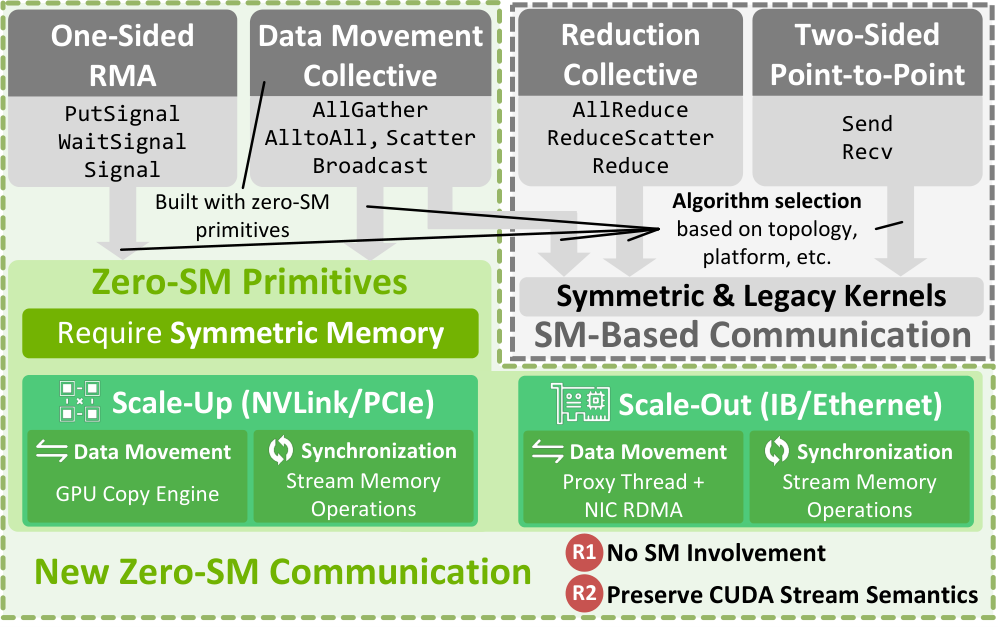
搬数据走两条硬件路径。在 scale-up 域里,拷贝引擎接手,也就是 GPU 上专门跑 cudaMemcpyAsync 这类拷贝的硬件单元,拷贝一旦发出,就不再占用计算核。跨节点时,一条 CPU 代理线程向网卡提交 RDMA 写,网卡自己去读写对端显存。同步则交给 CUDA 驱动里的 stream memory operations,比如在 stream 上写一个 64 位值、或等到某个内存位置达到指定值,这两类操作挂在 stream 里,同样不启动 kernel。发送缓冲区、接收缓冲区和信号位置都做对称注册:每个对等体在注册时就知道别人的地址,拷贝引擎或网卡可以直接写进对端已经注册的用户缓冲区,通信库内部不必再中转拷贝,也不必运行时交换地址。如果应用把数据放在尚未注册的普通内存里,发送前仍要先拷进这块已注册的缓冲区。
作者还加了两个单边接口。ncclPutSignal 把数据写到对端,完成后再更新一个远端信号;ncclWaitSignal 让本端的 CUDA stream 一直等到这个信号到达指定序号。在 scale-up 域里,写信号要拆成两步:先用 stream memory operation 把序号写到本卡的暂存字,再用拷贝引擎把这个字拷到对端。原因很具体:stream memory operation 不能直接写另一张 GPU 的内存,而拷贝引擎只会搬字节、做不了原子自增,所以序号必须先作为立即数出现在本卡显存里,才能当拷贝的源。
跨节点的 put 则由主线程和代理分工。主线程把描述符放进队列,再在 stream 上写下“就绪”旗标、挂上“完成”等待;代理轮询到就绪之后才向网卡提交 RDMA,传完再写“完成”旗标,stream 才放行。这样 CPU 不会在 GPU 还没写完发送缓冲区时就提前发网包,GPU 也不会在网包还没到时就去读接收缓冲区。对端的信号不走发送端这条完成旗标。网络插件提供有序的 put-with-signal(iput_signal),在 payload 传完之后才让远端信号可见;接收方的 ncclWaitSignal 等的就是这个信号。
这些原语能直接拼出纯搬数据的集合通信:AllGather、AlltoAll、Gather、Scatter。需要在数据上做加减的规约,比如 AllReduce 和 ReduceScatter,目前还不能走零计算核路径。跨节点的 AllGather 会把同一本地编号的 GPU 看成一条 rail,先由代理在 rail 上做 RDMA,再由拷贝引擎把刚到的数据在节点内散开,并且按 chunk 边到边散,不必等整次网络交换结束。图 2 是这套分工。
走一遍:144 MiB 的 AllGather 怎么跟矩阵乘抢核
下面用论文重叠基准里的真实例子,说明通信占核会怎样拖慢已经占满卡的矩阵乘。场景是一块 B200 NVL8 节点,8 张卡,每张 148 个计算核。被重叠的是 Qwen3-30B-A3B 的 100 个 MXFP8(微缩放 8 位浮点)矩阵乘,每个会发出 640 个线程块,所以计算已经把卡占满。另一条 CUDA stream 上同时跑一次每卡 144 MiB 的 AllGather:8 张卡各交出 144 MiB,每张再收回另外 7 张的,按 AllGather 的定义,每张卡的输出是 8 × 144 = 1152 MiB。
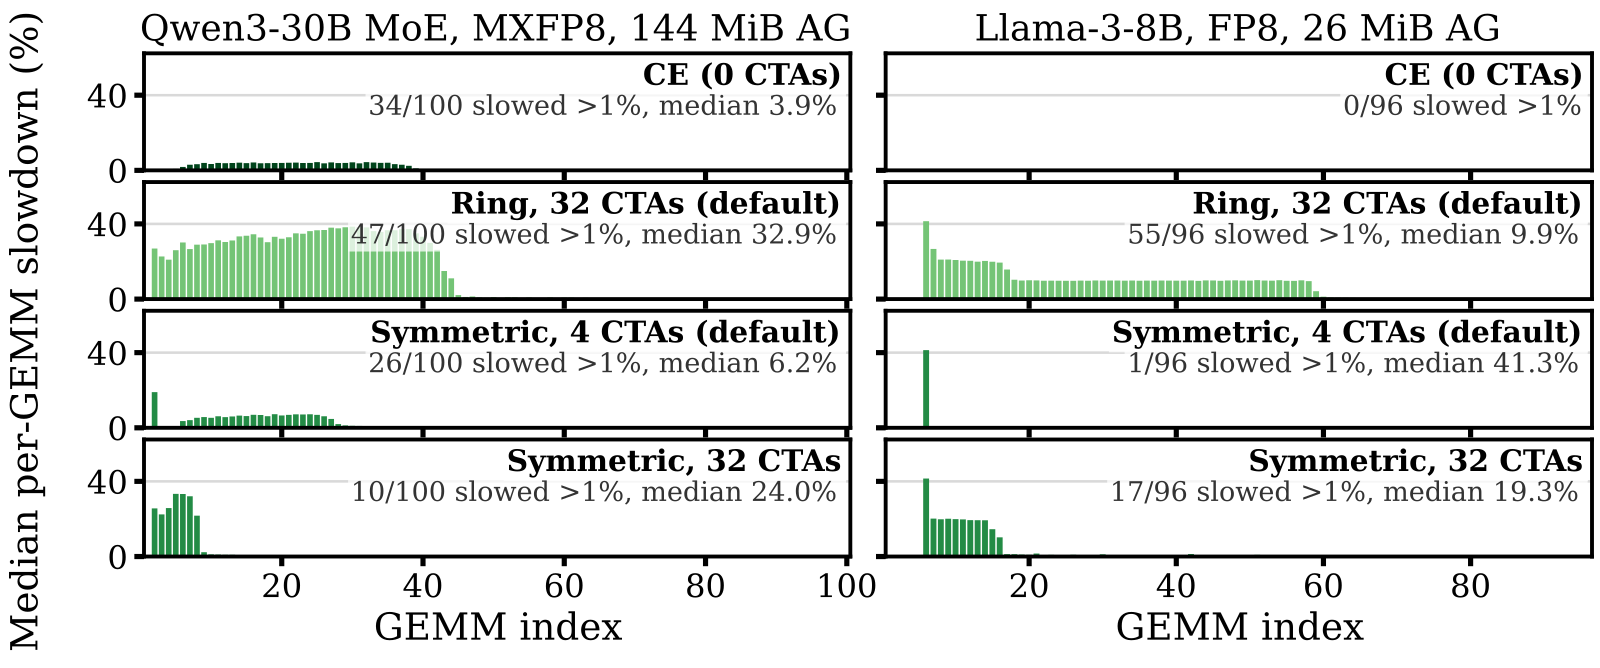
第一步,走 NCCL 旧版 ring,默认拉起 32 个 CTA。图 1Ⓐ 把 Blackwell 上打满 NVLink 所需的计算核画成 32 个,约占这块 B200 整卡 148 个核的 22%;论文把这时通信占用的核对应到这些 CTA,它们在通信进行时做不了矩阵乘。按论文的统计口径,只看被这次 AllGather 拖慢超过 1% 的那些矩阵乘,其中位数变慢 32.9%;100 个里有 47 个落入这个范围。这说明默认占用的通信核已经高到能明显拖慢旁边的计算。
第二步,少给核行不行?把 CTA 降到 4 到 8 个,图 1Ⓑ 里旧版 ring 的拖慢会掉到 Zero-SM 下面。但这时这次 AllGather 本身会比 Zero-SM 慢 3.2 到 5.6 倍。少占核是拿带宽换来的。
第三步,换成 symmetric kernel,也就是前面说的那类一次完成的 load/store 算法。默认只用 4 个 CTA 时,在被拖慢超过 1% 的矩阵乘里,中位拖慢降到 6.2%。强行开到 32 个 CTA,AllGather 更早结束,只有 10 个矩阵乘变慢超过 1%,但这些被命中的矩阵乘反而更痛,中位拖慢 24.0%。这说明多占核对传数更快,对旁边的计算更狠。
第四步,看 Zero-SM 怎么传这 1152 MiB。先做就绪屏障:每张卡用拷贝引擎把“缓冲区已就绪”的旗标抄到另外 7 张卡,再用 stream memory operations 等到 7 面旗都到,然后才允许对端往自己的输出缓冲区写。接着每张卡把自家 144 MiB 用拷贝引擎直接写进 7 个对端对称注册缓冲区的对应槽位。本卡输出里属于自己的那份 144 MiB,也要拷进本地输出缓冲区:普通的设备内拷贝默认会走计算核,Zero-SM NCCL 用 cudaMemcpyFlagPreferOverlapWithCompute 把它强制到拷贝引擎上,以保住零计算核。这份自拷只占输出的 1/8,并且和给对端的拷贝同时进行。最后再做一轮完成屏障,后面的计算才能读这份 AllGather 结果。全程 0 个 CTA。
第五步,看重叠结果。同样只统计被拖慢超过 1% 的矩阵乘,拷贝引擎路径的中位拖慢是 3.9%,作者把它归因于访存争用:数据还是要走同一套显存和 NVLink,只是计算核被让出来了。100 个矩阵乘里仍有 34 个落入这个范围,但幅度已经小得多。同一套基准里,Llama-3-8B 那次更小的 26 MiB AllGather,拷贝引擎路径没有任何一个矩阵乘变慢超过 0.2%;旧版 ring 在被拖慢超过 1% 的那些矩阵乘里,中位拖慢仍有 9.9%。这说明不占计算核之后,大消息还留下一点访存争用,小消息的拖慢则几乎消失。图 7 把一条计算链上每个矩阵乘的拖慢画了出来。
这组数字能证明:通信占住计算核,会明显拖慢旁边已经占满卡的矩阵乘,而且占的核越多,被重叠到的那些往往越慢;把搬数据和同步都挪到拷贝引擎和 stream memory operations 上,就能把这笔拖慢压下来。它不能直接告诉你训练一步会快多少。论文自己也写了,真实训练里,集合通信处在哪一段、旁边在跑哪一种矩阵乘,每一步都在错位,而且常常是好几种通信叠在一起。所以端到端还得另测。
训练一步,什么时候会更快
作者把 Zero-SM NCCL 接到 Megatron-LM 的两条路上。一条是 FSDP(把参数切到不同卡上,用时再 AllGather 回来)的参数 AllGather;另一条是流水线并行里阶段之间的激活和梯度传递,把双向的 Send/Recv 换成单边的 put_signal / wait_signal。评测覆盖 12 个 FSDP 配方和 7 个流水线配方,稠密、MoE 和混合模型从 15B 到 405B,跑在 32 或 64 张卡上,系统是整机柜都在一个 NVLink 域里的 GB200 NVL72,以及每个节点单独成域、跨节点要走分层 AllGather 的 B200 NVL8。实验组之间用同一批节点上的成对区块来比步骤时间,避免不同分配带来的 1% 到 5% 波动。
相对旧版 ring,拷贝引擎路径加快了两边系统上 GPU-bound 的稠密 FSDP 配方,GB200 最高 3.5%,B200 最高 1.9%。这里的 GPU-bound,指主机始终跑在 GPU 前面,GPU 不等待新的 kernel 被提交。相对已经只占几个 CTA 的 symmetric kernel,局面就杂了:在 GB200 的 Llama-70B-G 上赢得比较清楚,其他 GPU-bound 稠密配方多半只是打平或略胜,host-bound 的配方和 B200 上的 Qwen3-235B-G 则会输。作者从剖面里归纳出三个要同时成立的条件。
收益要成立,步骤得先是 GPU-bound。端到端剖面里,通信 kernel 占核会让重叠的计算慢 3% 到 4%。拷贝引擎路径去掉了这笔费用,但每次集合通信都要在主机上多做一些提交。发出一次拷贝引擎 AllGather,在 GB200 上要 26 到 41 微秒,大约是提交 symmetric kernel 所需 11 到 17 微秒的 2 到 3 倍;在 B200 上更是 77 到 86 微秒对 5 到 7 微秒。所以只有主机本来就跑在 GPU 前面时,这笔额外开销才不会落到关键路径上。
固定开销更高,也意味着消息必须够大,摊薄才划算。单节点上,一次 1 KiB 的 AllGather,拷贝引擎路径要 25 到 29 微秒,SM kernel 只要 12 到 18 微秒;带宽要到每卡 128 到 512 MiB,拷贝引擎才追上 symmetric。训练里也是同一道门槛:GB200 上,FSDP 的 gather 大约 240 MiB 及以下时,跟 symmetric 打平或更慢,到 820 MiB 才赢。这说明小消息会把零计算核路径的延迟劣势露出来,大消息才能把带宽优势用上。
路径还要跟当时路上的其他流量匹配。组播是一次注入、按最堵的那个目的地往前走,在 MoE 的 expert all-to-all 这种比较均匀的流量下更合适;单播是多路独立拷贝,在 GB200 上和张量并行流量叠在一起时更不容易被一条堵链路拖住整次 AllGather。Qwen3-235B-G 在 B200 上拷贝引擎路径反而更慢,作者给出的原因是:把连续多次 AllGather 包进同一个同步外壳的 plan fusion,还没有覆盖更快的那几种 rail schedule。
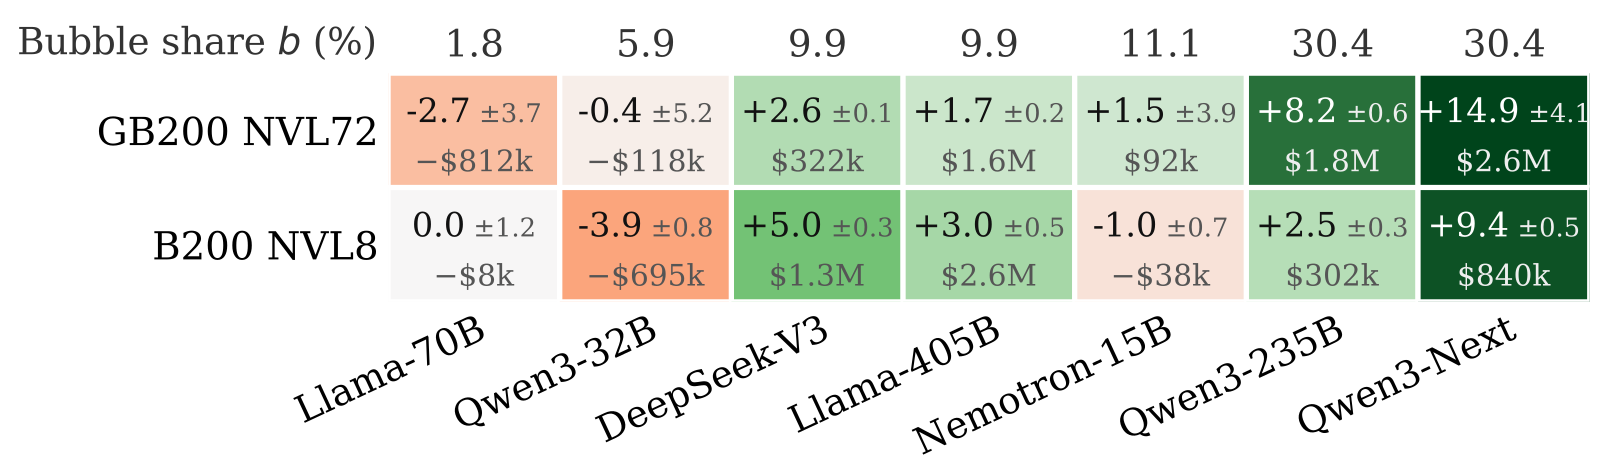
流水线这边,收益主要不是来自腾出计算核——释放 SM 最多只让计算加快 1% 到 2%——而是来自去掉 Send/Recv 的会合。流水线各阶段很少一起算完一个 micro-batch,层切分不均、两端还要做 embedding 和 loss、MoE 的 expert 负载还会晃。双向 Send/Recv 里,快的阶段每个边界都要等慢的邻居;单边 put 写进预先分配好的槽位就可以接着干,只有接收方在真正要用数据时才等。收益因此随气泡变大,气泡份额按 b = (PP - 1) / (GA × VPP(虚拟流水线重数) + PP - 1) 来算,其中 PP 是流水线段数,GA 是梯度累积步数,VPP 是把一段流水线切成几份交错执行的份数。 Hoot 说
正文已经走完一块 B200 上 144 MiB AllGather 怎样跟矩阵乘抢核。这里换一条路:流水线阶段之间的激活传递。下面的配方数字和加快幅度都来自论文,不是示意。
阶段快慢错开 → 双向 Send/Recv 让快的阶段在边界上会合 → 单边 put 只让接收方在要用数据时才等 → 收益随气泡份额变大,但传输太多时会被固定开销吃掉
- 阶段完成时间差 → Send/Recv 会合流水线各阶段很少一起算完一个 micro-batch,层切分不均,两端还要做 embedding 和 loss。双向 Send/Recv 里,快的阶段每个边界都要等慢的邻居。释放计算核最多只让计算加快 1%–2%,所以这边的收益主要不是腾核
- 单边 put → 发送方继续往下做论文把阶段之间的双向 Send/Recv 换成单边 put。发送方把数据写到对端并更新信号后就可以返回;接收方在要用这份数据时,用 wait_signal 等到对应信号。Send/Recv 要两边都到达边界才传得成;put 在发送方写完并打出信号后就可以返回
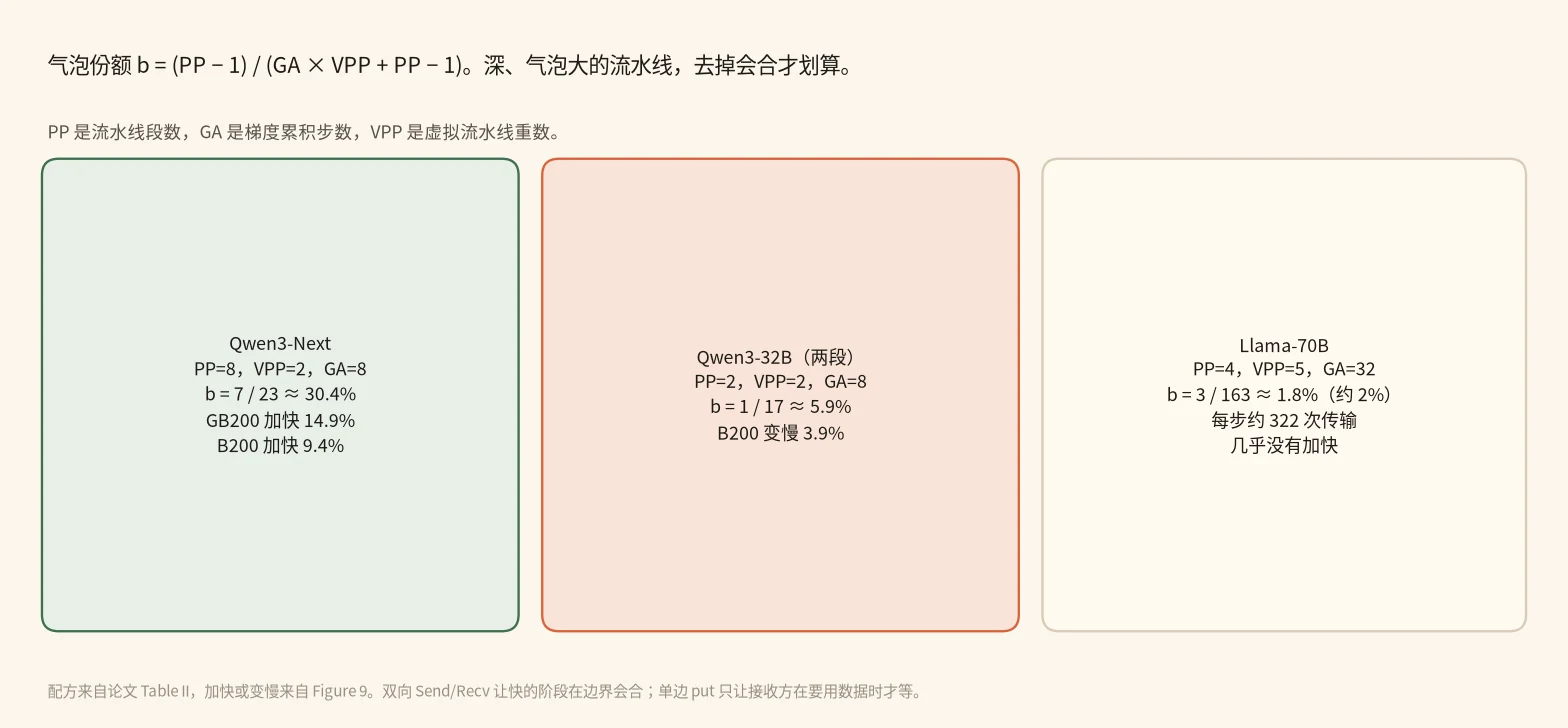
- 气泡份额 b → 步骤加快Qwen3-Next 是 8 段流水线,虚拟流水线重数 2,梯度累积 8 步。气泡份额 30.4%,步骤时间在 GB200 上加快 14.9%,在 B200 上加快 9.4%。b = (8 − 1) / (8 × 2 + 8 − 1) = 7 / 23 ≈ 30.4%
- 两段流水线 → 几乎没有可去掉的会合两段的 Qwen3-32B,虚拟流水线重数 2,梯度累积 8 步,气泡份额只有 5.9%,在 B200 上反而变慢 3.9%。b = (2 − 1) / (8 × 2 + 2 − 1) = 1 / 17 ≈ 5.9%
- 每步 322 次传输 → 固定开销吃掉等待收益Llama-70B 虽然有 4 段,但深度交错,虚拟流水线重数 5,梯度累积 32 步,气泡份额只有约 2%,每步大约 322 次传输。每次 put 的主机固定开销,再加上要把激活拷进已注册暂存区的费用,把省下来的等待吃掉。b = (4 − 1) / (32 × 5 + 4 − 1) = 3 / 163 ≈ 1.8%(正文约 2%)
所以单边 put 划算的条件是:流水线够深、气泡大约在 10% 及以上,而且传输次数不能太多、单次体积要大。
出处
论文 §IV-D2、Table II、Figure 9。气泡份额 b = (PP − 1) / (GA × VPP + PP − 1)。下面这张表只抽出几组对照,完整结果在论文图 8、图 9。美元数字是作者按 CoreWeave 按需价(GB200 每卡时 10.50 美元,B200 每卡时 8.60 美元)把步骤加快换算到 15T token 预训练的估计,作者写明这不是完整的部署成本模型。
| 场景 | 对照 | Zero-SM 怎么变 | 出处 |
|---|---|---|---|
| Qwen3-30B,144 MiB AllGather,被拖慢超过 1% 的矩阵乘 | 旧版 ring 中位拖慢 32.9% | 拷贝引擎路径中位拖慢 3.9% | 图 7,§IV-C |
| FSDP,Llama-70B-G,64 张 GB200 | 相对旧版 ring | 步骤时间加快 3.5%,估计节省 39.6 万美元 | 图 8,图 1Ⓒ |
| FSDP,Nemotron-15B-H,32 张 B200,host-bound | 相对旧版 ring | 步骤时间变慢 4.9% | 图 8 |
| 流水线,Qwen3-Next,64 张 GB200,b = 30.4% | 相对双向 Send/Recv | 步骤时间加快 14.9%,估计节省 260 万美元 | 图 9,图 1Ⓒ |
| 流水线,两段的 Qwen3-32B,64 张 B200,b = 5.9% | 相对双向 Send/Recv | 步骤时间变慢 3.9% | 图 9 |
(数字来自论文图 7、图 8、图 9 和 §IV-C、§IV-D)
图 9 把 7 个流水线配方按气泡份额排开:b 大约 2% 的 Llama-70B,以及两段的 Qwen3-32B、Nemotron-15B,几乎没有加快,有的还会变慢;到 b = 30.4% 的 Qwen3-Next,GB200 上加快 14.9%,B200 上加快 9.4%。作者给单边 put 的条件是:流水线要够深、阶段会彼此错开,并且相当一部分步骤时间耗在气泡里(PP 至少 4 段,b 大约 10% 及以上);同时传输次数不能太多、单次体积要大,否则每次 put 的主机固定开销,再加上发送方要把激活或梯度从 Megatron-LM 的普通 PyTorch 内存拷进已注册暂存区的费用,会把省下来的等待吃掉。FSDP 那边通常不必付这笔中转:Megatron-FSDP 在启用 NCCL user buffer 时,已经从 ncclMemAlloc 的池子里分配参数和梯度缓冲区,只要把这个池子注册成对称窗口,参数 AllGather 就可以直接走零计算核路径。Llama-70B 那种深度交错、每步大约 322 次传输、b 只有约 2% 的配方,就落在这条界的外面。
这对做大模型训练系统的人意味着什么
先看步骤是不是已经被 GPU 算满、消息有没有到几百 MiB、流水线气泡够不够深,再决定要不要打开零计算核通信。
如果 FSDP 的参数 gather 已经很大,而且主机提交始终跑在 GPU 前面,可以把 NCCL 的 CTA 策略切到零计算核路径,先对比旧版 ring 和 symmetric kernel 的步骤时间,不要只看微基准里的带宽。路上要是还叠着 expert all-to-all 或张量并行,组播和单播都试一下:流量比较均匀时组播往往更合适,堵在少数几条链路上时单播更不容易把整次 AllGather 卡住。流水线如果有 4 段以上、气泡份额大约在 10% 以上,值得把阶段之间的 Send/Recv 换成单边 put;两段流水线,或者像 Llama-70B 那样几乎没有气泡、每步要发几百次传输的配方,不要指望它更快。AllReduce、ReduceScatter 这类规约目前还走不了这条路,不要假设整条通信栈都能零计算核。
局限
在 scale-up 域里,小消息的延迟仍高于 SM kernel,因为每次操作都从主机发出,并经过 stream memory operations 同步。单节点上 1 KiB AllGather 是 25 到 29 微秒对 12 到 18 微秒。如果把操作捕获进 CUDA graph 再回放,还要换成回放安全的旗标协议,每次回放多几次置位和应答,开销更大。跨节点同步依赖 CPU 代理线程,会占用主机资源;卡上拷贝引擎的数量,也可能限制扇出很高的并发拷贝。规约类集合通信尚未支持。B200 上 Qwen3-235B-G 的那次回退,作者归到分层 AllGather 的 plan fusion 还没有覆盖全部更快的 rail schedule。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Infra · 2026-11-02The Endgame of FSDP Communication: Layout-Aware Collectives on Copy Engines, RDMA, and NVSwitch可灵团队的 TIDE 把 FSDP2 每一步都要做的布局转换直接做进了通信里。原版 FSDP2 的参数和梯度按每个参数单独存放,NCCL 却只收发按 GPU 顺序排好的一整块缓冲区,所以每一步都要来回拷贝。TIDE 让通信从参数所在的位置读,直接写到参数最终要在的位置,搬数据交给拷贝引擎、RDMA 和 NVSwitch,模型代码和计算 kernel 都不用改。在三种模型上,单步时间最多比原版 FSDP2 少 27.1%。通信快不快之外,数据摆放和抢不抢算力同样决定训练速度。
 Infra · 2026-11-17Compiling Specialized GPU-Initiated Networking机器学习系统常把计算专门化到任务和硬件上,通信却还留在通用库里,设备代码和传输路径高层编译器看不到。作者把由 GPU 发起的通信写进 kernel 的中间表示,和计算一起规划完成时机、同步和批处理,再降到专用的传输代码。它会围绕缓冲区的生命周期来安排完成事件,并在不同 GPU 上优化访存顺序。在 H100 上,小消息发送可比 NVSHMEM 快 3.3 倍。用 vLLM 服务超大专家混合模型时,响应比专用的专家并行通信库最多快 1.29 倍,显存和寄存器占用也更小。通信只有进了和计算同一套编译流程,才能按任务改传输路径。对做大规模训练和推理通信的人来说,这比只调通用通信库更接近计算这边已经习惯的专门化。
 Infra · 2026-11-11Firepool: Brokering Warm GPU Capacity for Agentic and RL Workloads at LinkedInagent 和 RL 训练会连续发出几千个只跑几秒的 GPU 任务,可是起一个 Pod 即使镜像已缓存也要等二三十秒,等待压过了干活。常见解法各缺一块:缓存镜像省不掉调度和初始化,常驻的 Ray 集群在两步之间白占 GPU,备好的空闲 Pod(热池)又常因环境对不上而用不上。LinkedIn 的 Firepool 让同一硬件规格的 Pod 共用一个基础镜像,代码和依赖等任务开始时才装进去,Pod 就能互换。为了隔离,Pod 只复用给上次用它的调用者,换调用者时由同一张卡上不占显存的备用 Pod 接手。线上高峰期 94.7% 的 Pod 请求由热池或备用 Pod 满足。在两张 GPU 的配额下,agent 循环的完成速度是每个任务新建 Pod 的 13 倍,任务一长优势就消失。跑 agent 评测或 RL 时,先量清楚 Pod 等待占了多少时间。
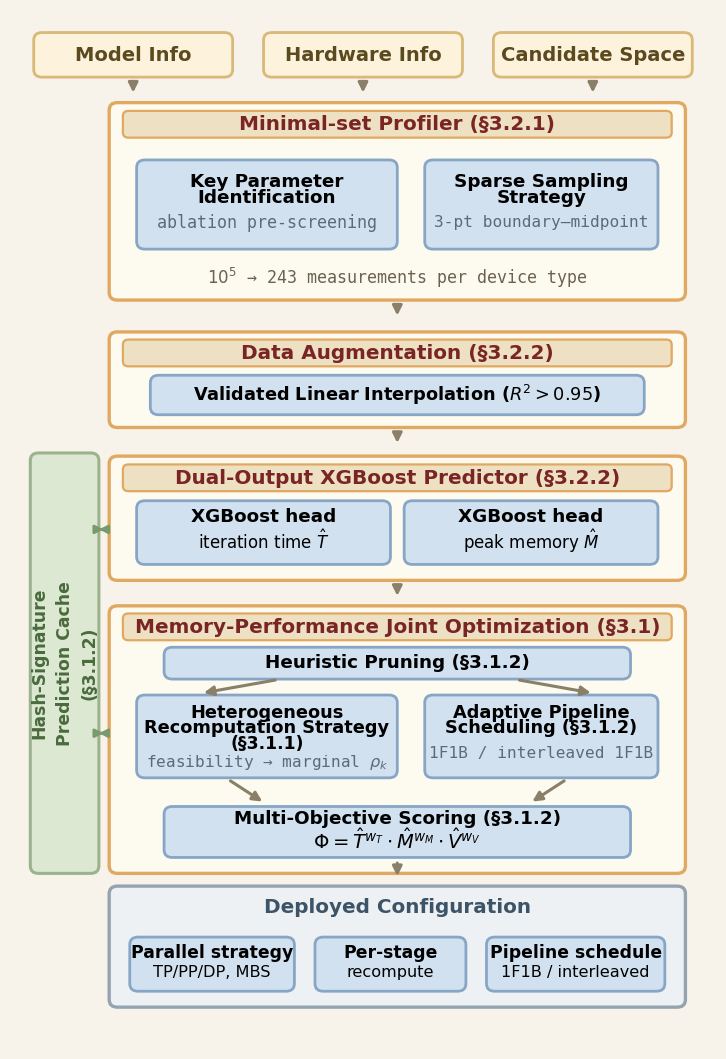 Infra · 2026-11-03MemX: Memory-Aware Automatic Parallelism for Cross-Vendor Heterogeneous GPU Training在多家厂商 GPU 混在一起的集群上训练大模型,MemX 把各卡显存均不均衡也写进搜索目标,并且允许显存小的卡多做重算、显存大的卡不做,从而找到既不 OOM、各卡显存又均匀的并行配置。它给每个候选配置估迭代耗时、峰值显存和各卡显存方差,按权重合成一个分数,分数最小的胜出。在三厂商集群上,按耗时和按显存均衡两种排序,只有它都把真实第一名排在第一;在线搜索 31,240 个配置只要 26.5 秒。它换来的是显存余量,不是更快:实际部署时它挑的配置比最快配置慢 9.3%。混合集群里显存和算力不成比例,搜索目标里必须有显存。
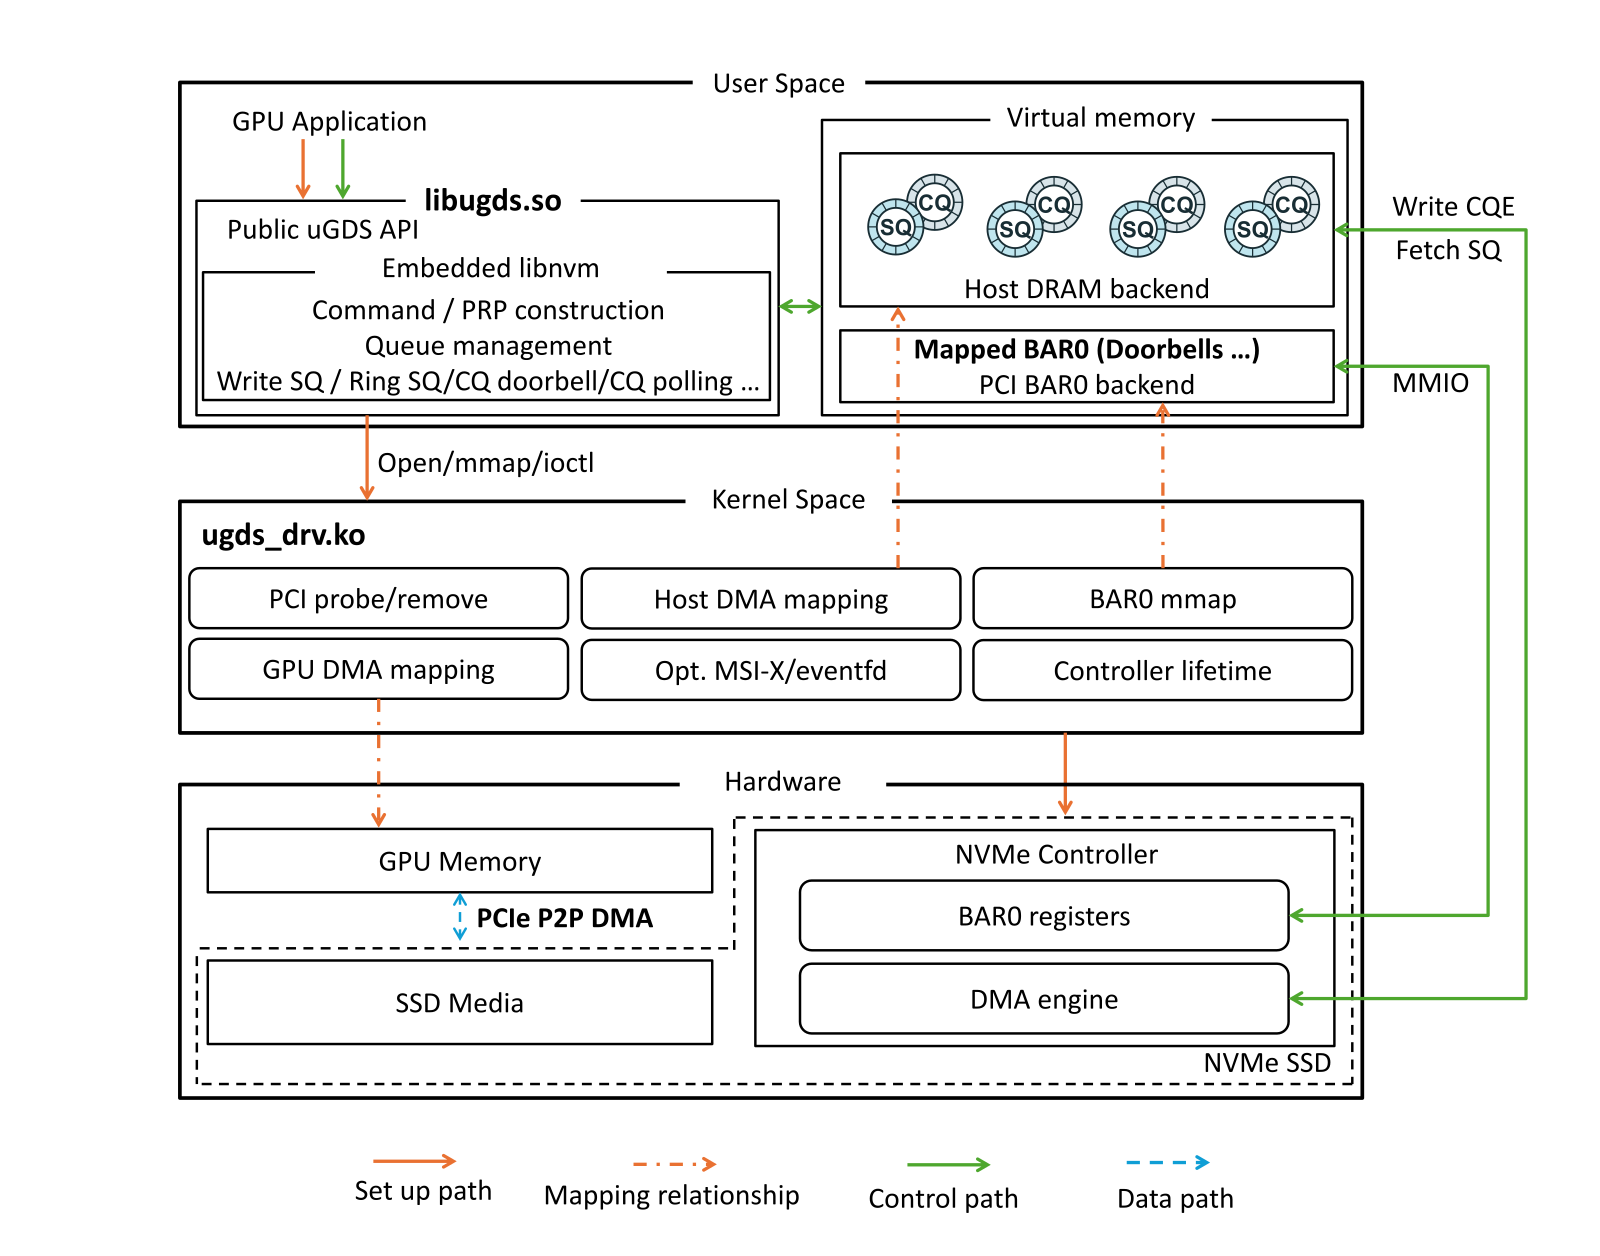 Infra · 2026-10-25uGDS: A User-Space Development Kit for High-Performance GPU Direct Storage用 NVIDIA 的 GDS 把数据从 SSD 直接读进 GPU 显存时,作者实测发现,异步读取 99.6% 的时间都卡在提交请求这一步。大模型推理服务会把算过的 KV cache 存到 SSD 上,下次遇到同样开头的请求就直接读回来,不用重算,这一步的速度直接影响首字延迟。uGDS 把指挥 SSD 干活这件事从操作系统内核搬到普通程序里来做。数据照样从 SSD 直达 GPU,变的是谁来下命令。uGDS 批量读的速度最高是 GDS 的 12 倍;接进开源缓存系统后,长提示的首字延迟中位数从 1.9 秒降到 0.7 秒。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…