 Beihang University
 NTU
Bridging the Topological Divide: Dual-Branch Graph Distillation with Semantic Priors for Robust Cold-Start Recommendation
 HKUST (Guangzhou)📖 有深读 · 8 分钟
新物品没有交互边,图推荐便无法从邻居获取兴趣信号。作者先用文本语义固定协同空间,再让独立学生网络学习表示方向,并在检索时恢复向量长度;Sports冷启动Recall@20比DropoutNet高20.8%。
INSIGHT向量方向与长度承担不同信息。语义能推断商品位置,却缺少交互频次决定的长度信息;分开学习并校准尺度,可减少新内容在混合候选池中因分数偏小被压制。
DualGCN 用文本语义为新物品搭一座桥,让没有交互记录的内容也能进入协同推荐空间。作者没有让一个网络同时学会推荐和补全新物品,而是先学稳定的协同表示,再训练独立映射。理解这篇论文的关键,是区分向量指向哪里与向量有多长。
1. 问题与动机:没有邻居,新物品靠什么定位
图协同过滤把用户与物品之间的点击、购买连接成图。一个物品可以从交互用户及其邻居中收集信息。新物品没有边,便失去了这条学习通道。随机给它一个编号向量,也无法说明它与哪些成熟物品相似。
作者在严格冷启动设置中屏蔽一部分物品的全部训练交互。纯编号模型的推荐指标出现明显坍塌。这里的问题不是少学几次,而是没有任何邻居可以传递信号。文本标题和类别则在物品上线时就可以取得,因此成为替代入口。
但直接把文本编码送进协同空间,也不是完整答案。文本模型按语义组织物品,推荐图按共同交互组织物品,两种空间的几何结构不同。如果教师完全由交互驱动,学生只看到文本,学生就可能被要求恢复文本里根本没有的信息。作者因此从教师端开始调整,让协同学习始终围绕固定语义锚点展开。
2. 方法:先稳定教师,再教学生找方向
教师保留语义锚点
每个物品的标题与类别先经过文本编码器,再用主成分分析压缩到推荐向量维度。主成分分析是在保留主要变化方向的同时降低维度。这部分语义特征训练中保持冻结,避免稀疏交互把内容表征拉偏。
教师把可学习的物品编号向量与归一化语义向量相加。用户仍使用编号向量。随后通过图传播得到协同表示,并用成对排序损失训练:让用户交互过的物品比分数较低的负例更靠前。实验把表示维度设为64,图传播深度为3层。
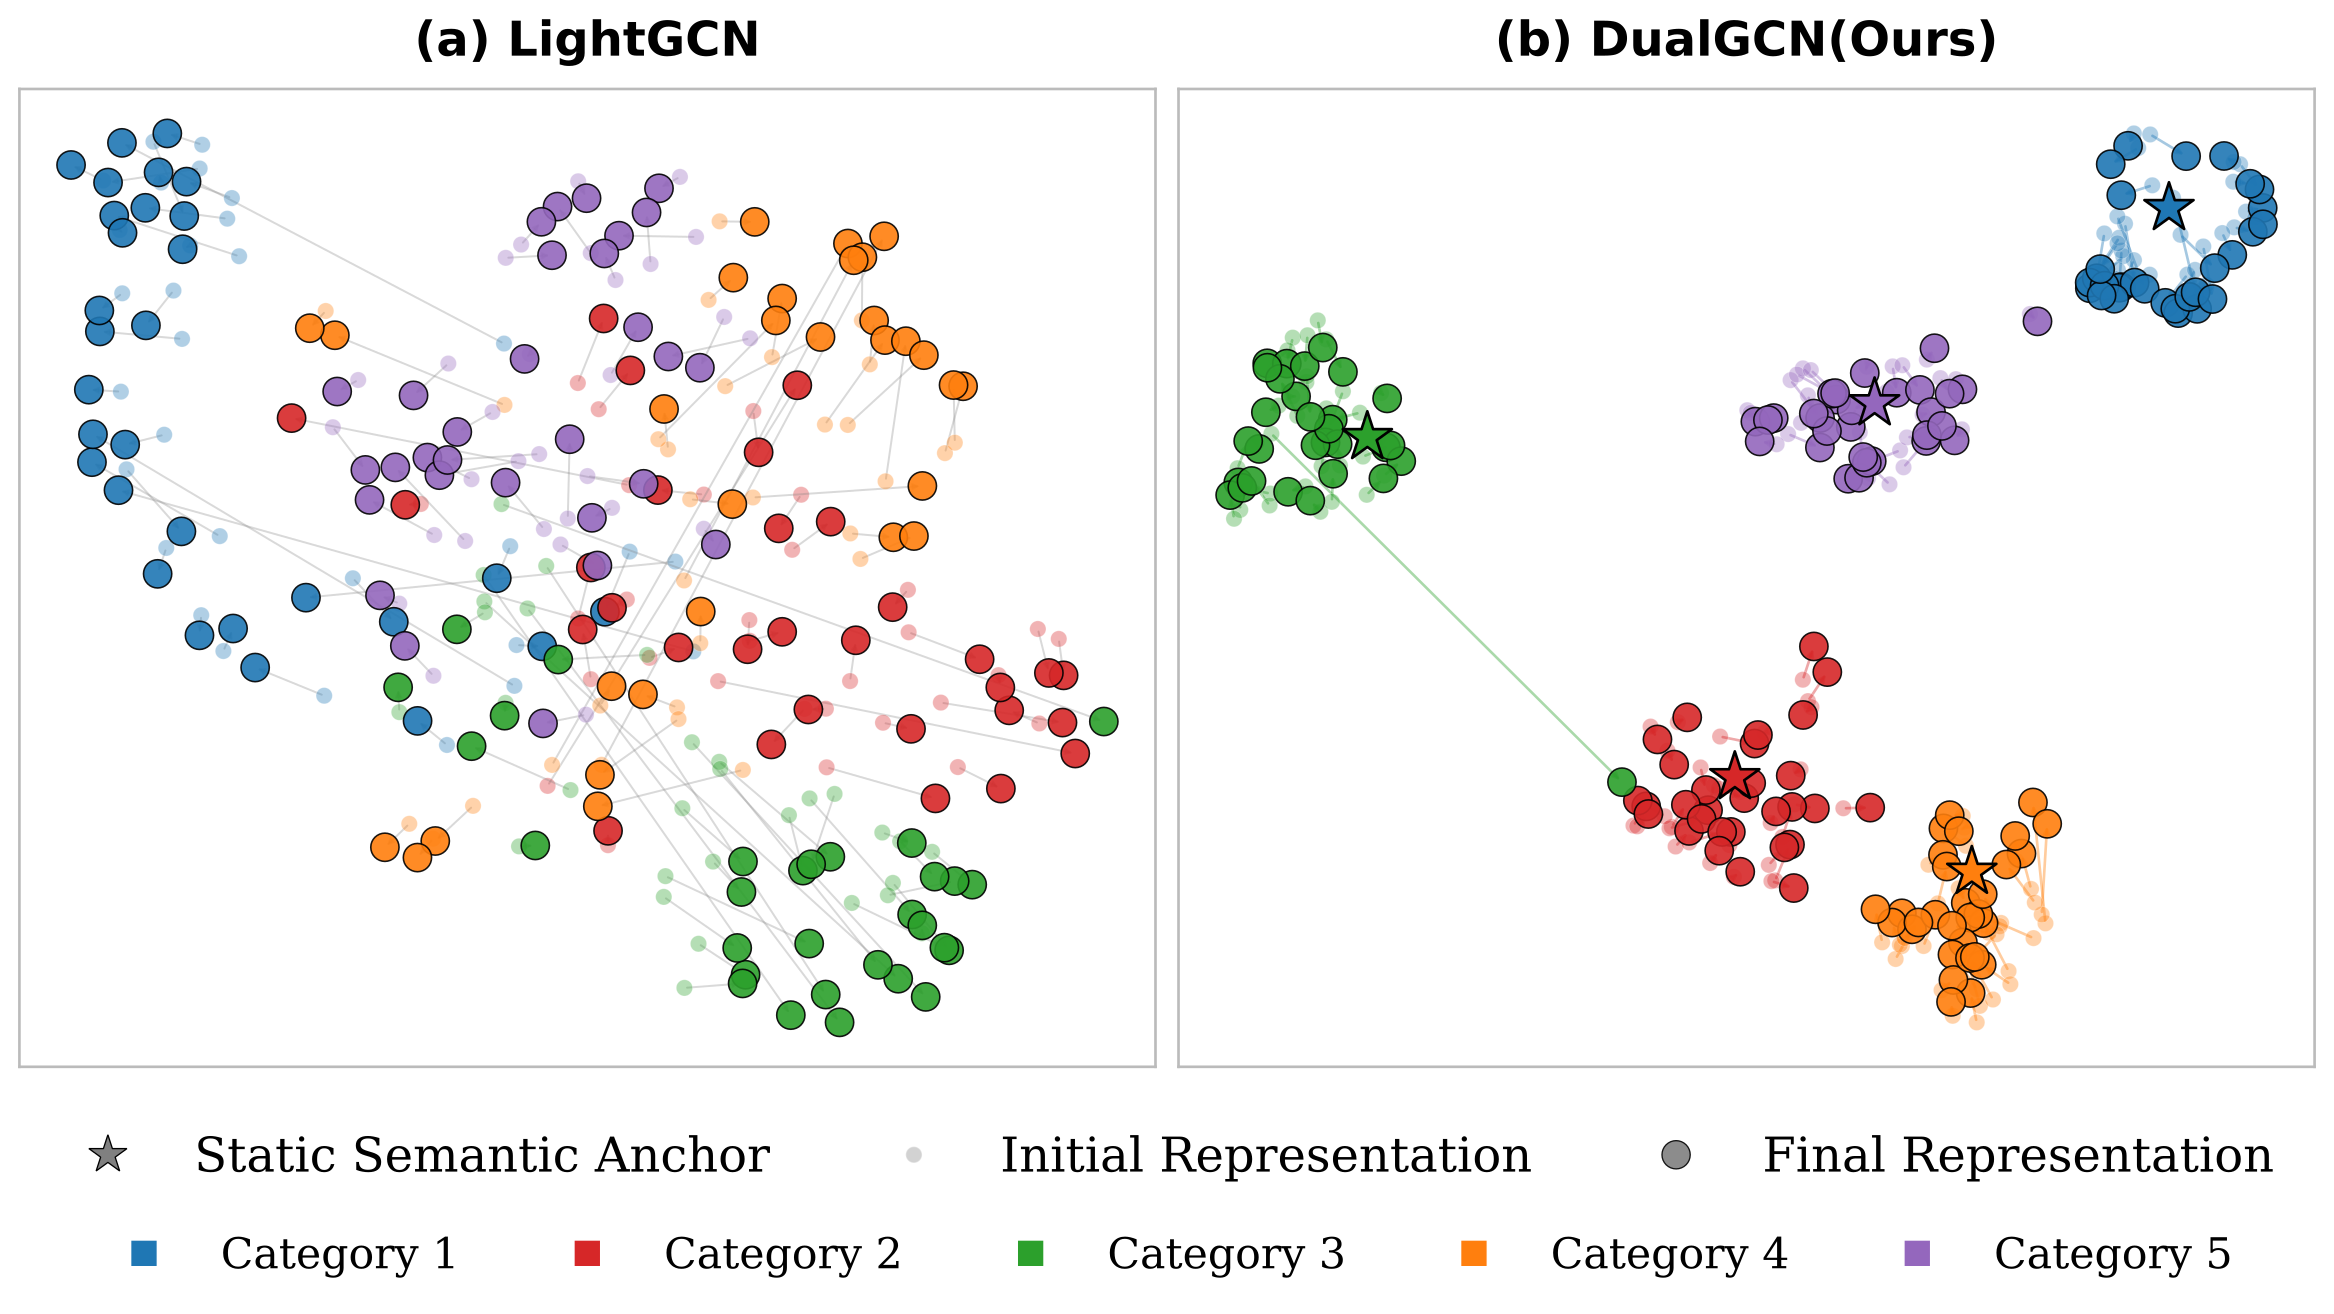
这个安排没有取消协同信号。编号部分仍可以学习语义之外的共同偏好,只是教师不再拥有一个任意漂移的起点。论文把它描述为带有语义锚定的协同空间,并用二维投影展示初始化与训练后表示的关系。
学生只预测缺少的偏移
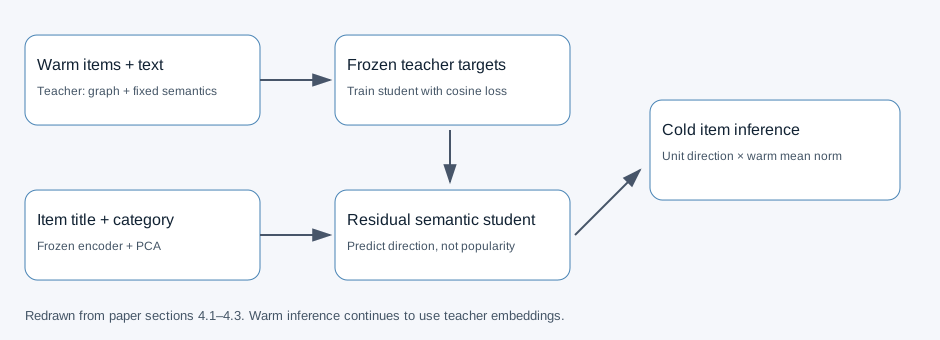
学生不读取交互图。它从归一化语义向量出发,经过小型映射网络预测偏移,再加回语义残差。残差提供原始语义方向,映射网络负责补上语义空间到协同空间之间的变化,而非从零重建整个表示。
两阶段训练把优化任务分开。第一阶段冻结学生,训练协同教师。第二阶段冻结教师,把成熟物品的教师表示作为目标,只训练学生。这样学生训练不会反过来破坏已经学到的成熟物品排序。
关键选择是余弦蒸馏,也就是只对齐向量方向,不要求学生同时复制教师向量长度。作者认为长度含有交互频次信息,而新物品没有这些记录。硬逼文本网络恢复该信息,会把不必要的误差混进语义映射。
检索时补回尺度
只输出单位向量仍有问题。内积排序既取决于方向,也取决于长度。若成熟物品保留原有长度,新物品却全是单位向量,两者分数未必可比。
推理时,作者计算成熟物品表示的平均范数。范数就是向量长度。交互度低于阈值的物品,走学生分支:先归一化学生输出,再乘以成熟物品平均范数。交互充足的物品继续使用教师表示。最后,两类物品都与用户教师向量做内积。
这一步是批次尺度校准,不是为每个新物品推断真实热度。它解决的是两条表示分支的量纲不一致。原文给出混合空间的推理形式,但后面的冷启动主实验采用冷物品专属候选池,两者的证据范围需要分清。
3. 核心贡献:把难以推断的信息从学习目标里拿掉
论文把冷启动问题拆成了两个层面。第一个层面是教师空间是否方便从文本预测,固定语义先验对此提供约束。第二个层面是学生到底应该拟合什么,余弦损失把缺少依据的长度信息移出学习目标。
这使两个常见设计有了连贯解释:为什么不直接端到端联合训练,为什么不使用普通均方误差。联合训练会让协同目标与语义目标互相牵制;均方误差同时约束方向和长度,可能要求学生学习它无法观察的交互统计。
原文的消融与这个解释相符。把默认损失换成均方误差,Books冷启动召回下降;去掉学生语义残差,也会削弱冷启动指标。它们说明方向对齐与残差各有作用,但不意味着所有语义推荐模型都应放弃长度学习。
4. 实验:收益明确,比较口径也很重要
实验来自三个Amazon领域。作者先做交互过滤,再随机留出一部分物品,完全遮住这些物品的训练交互。成熟物品按训练、验证、测试拆分。所有依赖内容特征的基线使用同一组文本特征,减少编码器差异带来的干扰。
下表摘取原文表3的严格冷启动Recall@20。它衡量真实相关物品有多少进入前列,数值越高越好。
| 方法 | Books | Electronics | Sports |
|---|---|---|---|
| DropoutNet | 0.0780 | 0.0225 | 0.0926 |
| DeepMusic | 0.0890 | 0.0279 | 0.0827 |
| DualGCN 第一阶段 | 0.0870 | 0.0206 | 0.0701 |
| DualGCN 第二阶段 | 0.1007 | 0.0248 | 0.1119 |
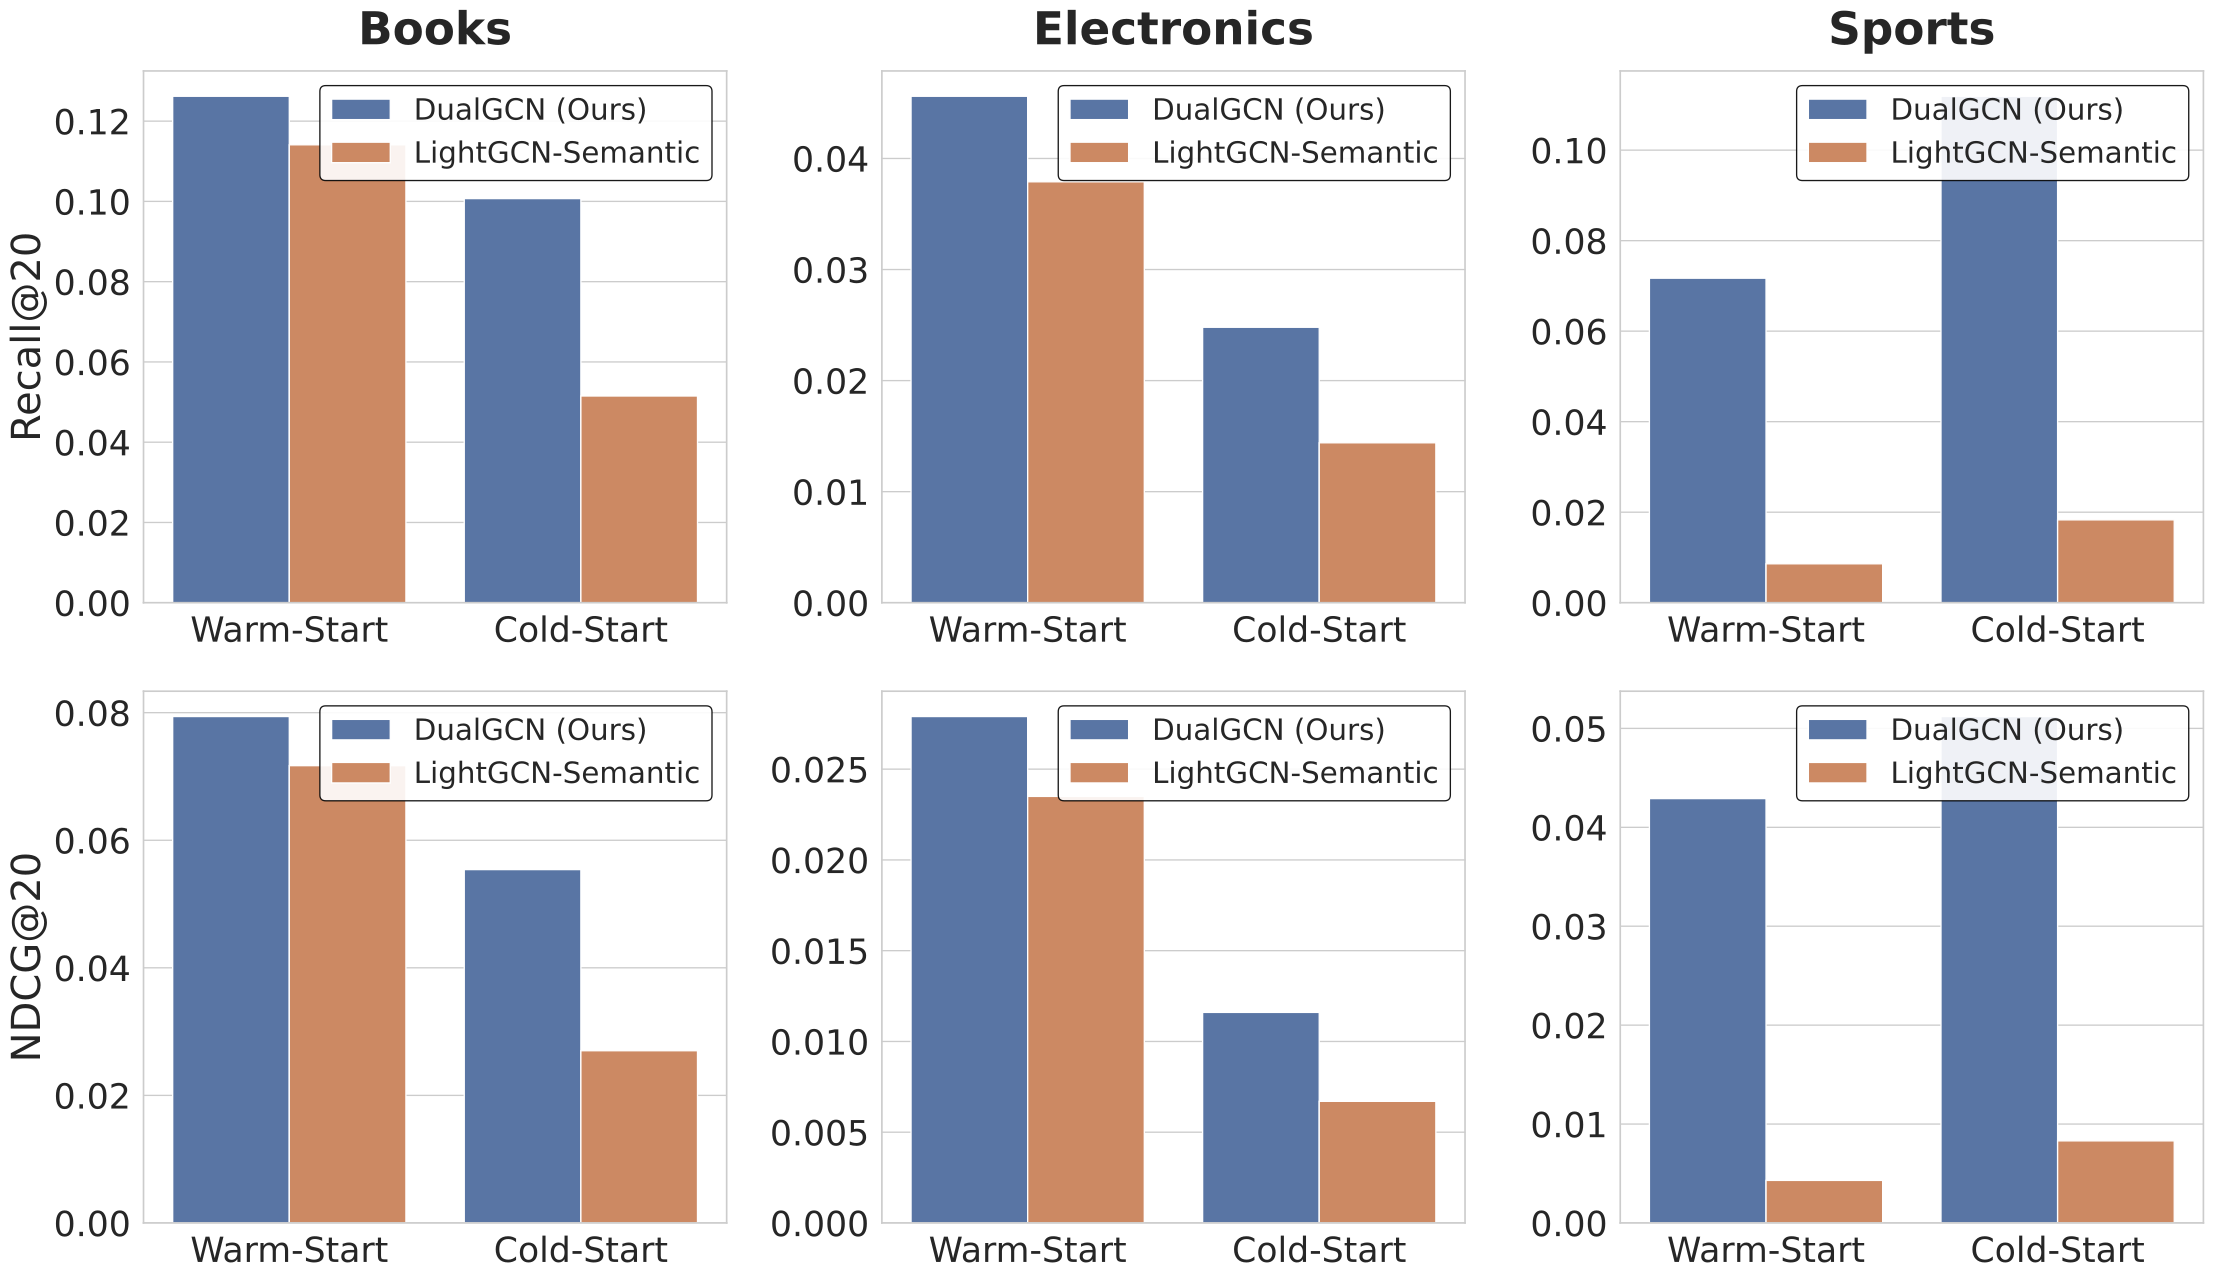
Sports上,第二阶段比DropoutNet高20.8%。但Electronics上,DeepMusic仍有更高的冷启动召回。这里支持的结论是两阶段蒸馏在多个领域有效,并非每个领域的每项指标都最优。
成熟物品的表现也需要观察。学生训练后,教师参数被冻结,成熟物品指标整体接近第一阶段;这与设计目标一致。它说明没有为了补新物品而大幅改动成熟表示,却不等于线上曝光分布一定保持不变。
5. 局限:冷物品池与真实混合列表仍有距离
作者在结尾提出,后续需要扩展到动态图与更丰富的多模态信号。当前实验证据来自静态交互图和标题、类别文本,不包含推荐反馈改变图结构后的长期演化。
另外两个边界直接影响落地判断。第一,冷启动评估只在冷物品集合内部排序;真实内容流通常把新旧物品放在同一列表竞争。论文提出的范数重构针对混合空间,但主表没有单独证明混合列表中的曝光分配和校准效果。
第二,实验随机屏蔽物品交互,且在交互过滤后构造冷启动组。这模拟的是“历史成熟商品突然失去记录”,与自然上线、内容质量参差的新帖子存在差别。时间切分、低质量文本和类别缺失都可能改变文本映射的难度。
6. 工业实践意义:适合内容冷启动支路
对有内容文本和用户交互图的平台,这个方案可作为新内容召回支路。教师按现有图训练;新帖子由标题、类别或正文摘要生成向量,再通过小网络映射到协同空间。向量可以离线计算,主检索仍然使用已有内积索引。
一个具体实验是记录每条候选向量的来源、长度和交互度,在混合候选列表中按新旧内容分桶检查曝光率与相关性。这样能区分“学生方向学得好”与“校准长度让新内容获得更多分数”,避免把量纲修正误读成兴趣预测提升。
另一个实验是按真实发布时间切分新内容,保留文本缺失、短标题及不同类别的结果。对于UGC社区,文本噪声比商品类别更明显;可把纯语义召回、残差学生、长度重构分别作为对照,直接观察各环节在新内容入口的作用。
 Shopify
 Amazon
 UIUC
 UCL
 Tsinghua University
 University of Waterloo
 Shanghai AI Lab
 SJTU
 Fudan University