2026-10-22 周四 · Generative

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 10 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Agentic智能体搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景社区搜索 (UGC 短文本搜索): 用户在社区平台搜索帖子、问答、评论等 UGC 内容。 核心指标是搜索相关性 (nDCG) 和点击率 (CTR)。 关注:语义匹配、query 理解、短文本召回、排序模型、LLM 在搜索中的应用。 — 评分 202 篇,入选 10 篇,分数 3.05 – 4.40

本期目录 · 10 篇
  1. 01Evolving Semantic Indexes for Generative Retrieval
  2. 02LightCRS: Lightweight Multi-Domain Conversational Recommendation System
  3. 03Factual Access States in Diffusion Language Models: From Mechanism to Knowledge Editing and Retrieval
  4. 04Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling
  5. 05Which Model for Which Role? Cost-Efficient Pareto Recommendation for LLM Agentic Workflows
  6. 06DiffuPlan: Editable Planning State for Diffusion Language Model Agents
  7. 07How Data Scales in Agentic Reinforcement Learning: Laws and Synthesis Strategies
  8. 08BERT Is Already a Denoiser: Cheaply Unlocking Iterative Generation in Masked Language Models
  9. 09Training the Whole Agent, Not Just the Model
  10. 10DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
LEAD STORY · 今日必读 · Coupang / Santa Clara University

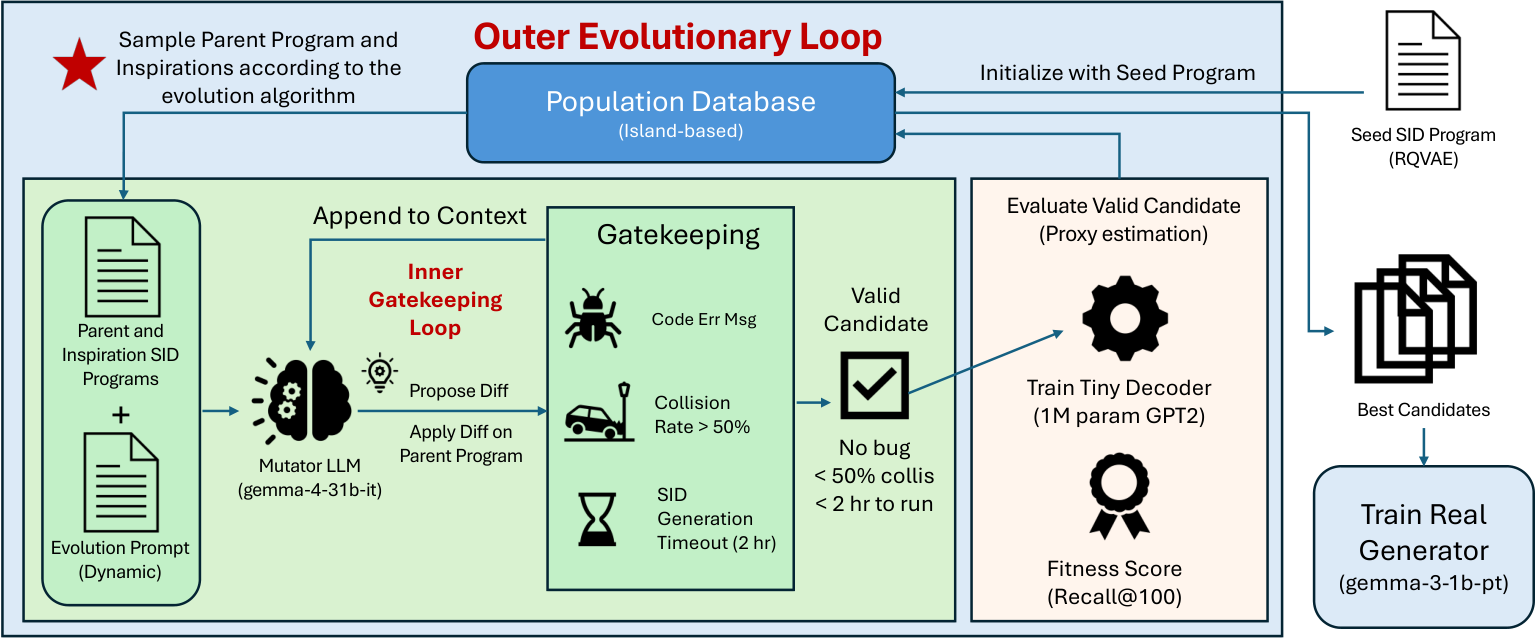
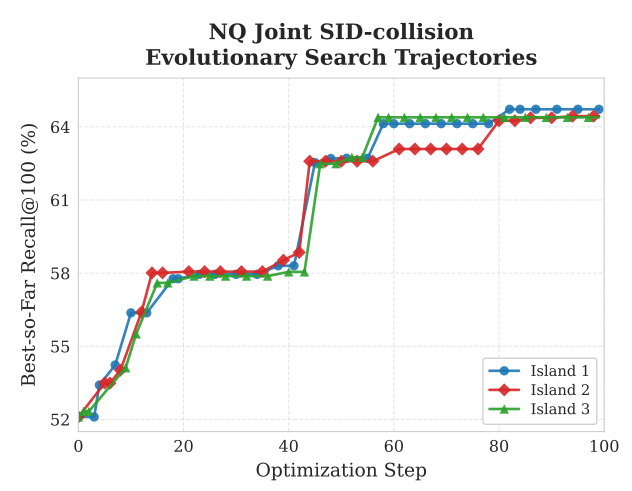
Evolving Semantic Indexes for Generative Retrieval

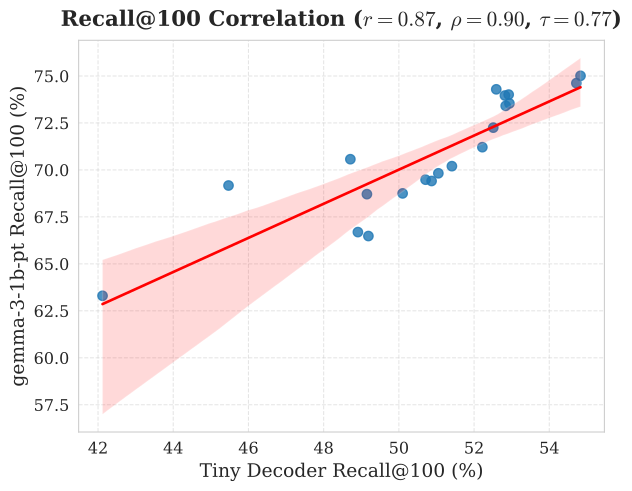
用大模型反复修改文档编码程序,自动寻找更好学的检索索引。小型生成器负责快速筛选,最终再用目标模型检验,训练方法保持一致。NQ320K 的前百条召回率从 85.82% 升至 90.57%。

相关 5新颖 4实用 4证据 4时效 5
4.40
综合分 / 5
偏好调整 4.80
KEY INSIGHT · 对业务意味着什么编码规则决定生成器能否走到正确文档,索引构造和重码处理值得一起优化。小模型的作用是给候选排顺序;搜索范围一旦扩大到训练目标,这种顺序就可能失真。
Jinming Nian, Jyun-Yu Jiang, Henry Tsai, Yi Fang, Zhirong Liang · 2026-10-21 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 4.00

LightCRS: Lightweight Multi-Domain Conversational Recommendation System

跨品类对话推荐不必给每个领域单独部署大模型。商品图文表征离线算好,线上用共享的小模块按对话融合证据,再比较候选商品。论文报告命中率相对最强基线提高 35.4%。

INSIGHT把稳定的商品理解留在离线,把随对话变化的匹配留在线上。跨领域共享的关键不是简单混合数据,而是让当前问题决定该读取哪些商品信息。

He Ma, Lan You, Qiyang Wu, Chen Liu
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
03 3.55

Factual Access States in Diffusion Language Models: From Mechanism to Knowledge Editing and Retrieval

University of TokyoLIGHTSPEED

扩散语言模型检索事实时,实体与关系会很早合成查找线索。作者用多个问法共同修改这片内部状态,也把它读成检索向量。Dream-7B 在 BAKE 上的反向问答正确率由 20.3% 升至 83.6%。

INSIGHT同一事实对应的内部表示会随问法和方向变化。修改一个提示词下的表示并不够,覆盖多个问法的共同区域,才能让改动在反向提问时继续生效。

Yuchen Guo, Zhuoyuan Mao, Yiwen Guo
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
04 3.30

Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling

MetaDuke UniversityNYU

长流程智能体只有最终成败奖励,很难知道哪一步有用。作者让模型在总结中引用关键动作,再对照同组成功与失败轨迹修正这些引用,调整训练权重。8B 模型在 BrowseComp-Plus 上比最强强化学习基线高 8.5 个百分点。

INSIGHT模型自己指出的关键步骤也会认错功劳。把成功和失败轨迹放在一起核对,能过滤仅仅经常出现的动作,把学习信号集中到真正推动答案的证据上。

Fangcong Yin, Ming Yin, Tanvi Bhandarkar, Aashu Singh, Eryk Helenowski
HuggingFace·2026-10-19·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
05 3.30

Which Model for Which Role? Cost-Efficient Pareto Recommendation for LLM Agentic Workflows

已录用 NeurIPS 2026 WorkshopMicrosoftColumbia UniversityCornell University

为多角色智能体选模型,需要同时计算效果和部署成本。作者利用评估成本与部署成本的关联,交替寻找更准确和更便宜的模型组合。八组基准中,约用穷举一成的评估成本即可找回相当一部分最优权衡方案。

INSIGHT选模型应评估完整工作流,因为上游输出会改变下游难度。一次试验同时更新效果与成本判断,比逐个角色独立挑模型更能反映实际部署取舍。

Qian Xie, Wenyue Hua, Yueli He, Sripad Karne, Armaan Agrawal, Nikos Pagonas, Eugene Wu, Kostis Kaffe...
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
06 3.05

DiffuPlan: Editable Planning State for Diffusion Language Model Agents

NYUNYU Shanghai

搜索智能体拿到新证据后,可以直接改写已有计划。作者让扩散模型维护一份可编辑状态,只重建受影响的步骤,并用强化学习训练多轮检索。四个多跳问答基准的平均 F1 为 50.24。

INSIGHT计划应该是能修订的工作状态。追加解释会把旧判断继续留在上下文里;局部重建能让新证据真正替换旧路线,尤其适合实体消歧后的检索转向。

Qisheng Zhou, Zhen Xiong, Qiaoyu Tan
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
07 3.05

How Data Scales in Agentic Reinforcement Learning: Laws and Synthesis Strategies

已录用 NeurIPS 2026

智能体训练的数据预算,不只决定生成多少文本,还决定覆盖多少任务和环境。论文分别拟合任务、环境与轨迹数量的扩展关系,帮助选择数据合成方向。实验同时考察 PPO 与 GRPO 两种强化学习算法。

INSIGHT训练样本数量相同,任务覆盖也可能完全不同。做推荐交互数据合成时,可以把新任务、新环境和重复轨迹分开记账;这里是可迁移的实验设计,并非推荐系统线上结论。

Bowei He, Yankai Chen, Xiaokun Zhang, Changjiang Han, Ye Yuan, Chong Li, Xue Liu
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
08 3.05

BERT Is Already a Denoiser: Cheaply Unlocking Iterative Generation in Masked Language Models

SiftyML

原本只补空缺词的语言模型,也能通过反复补词生成回答。作者按置信度逐步固定预测,不训练扩散过程,只做常规掩码任务适配。适配后的 BERT 在 ARC-Easy 上达到 28.2%。

INSIGHT去噪能力、任务适配和解码规则可以分开研究。已有双向编码器具备部分生成基础,但冻结模型的补词能力并不等于能完成任务,适配数据仍然决定输出内容。

Julio C. Amador Diaz Lopez
arXiv·2026-10-21·Relevance 4 · Novelty 3 · Practical 4 · Evidence 4 · Timely 5
09 3.05

Training the Whole Agent, Not Just the Model

Zhejiang UniversityLIGHTSPEED

训练编码智能体时,模型之外的工具和运行规则也需要更新。作者从失败轨迹提炼修复技能,再迭代工具与钩子,并保留能改善训练表现的改动。SWE-bench Verified 的通过率比 GRPO 高 9.8 个百分点。

INSIGHT训练交付物是一对互相适配的模型和工具。训练时的临时技能可以撤掉,但经过共同演化的工具还在承担能力,部署时只拿走模型权重会遗漏这部分。

Lingxiao Tang, Wei Tao, Yiwen Guo, Lingfeng Bao
HuggingFace·2026-10-19·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
10 3.05

DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems

StartLux

决策模型总分相近,也可能对关键条件有完全不同的反应。这个基准用成组的对照问题,检查选项判断、概率顺序和置信度。参考测试成绩相近的两个模型,对照组正确率分别为 70.1% 和 44.2%。

INSIGHT把一对只改变关键条件的问题一起计分,能发现平均准确率藏住的错误。生成式推荐的规则检查也可借鉴这种设计,例如只改库存状态或用户明确拒绝的属性。

Xialie Zhuang, Mingcong Lei, Zunhai Su, Ri Liu, Jianjin Li
HuggingFace·2026-10-19·Relevance 4 · Novelty 3 · Practical 4 · Evidence 4 · Timely 5

其他赛道今日

点击切换
Personalization
10
个性化推荐 · 篇入选
AI Search
10
AI 搜索 · 篇入选
Agentic
10
智能体搜索 · 篇入选
Infra
10
系统与索引 · 篇入选

开源雷达

GitHub / HuggingFace 热门 · 5 个项目
deepseek-ai/DeepSeek-V4.1-Flashpipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, conversational, license:mit, eval-resultsmodel · ★ 4691 · 2026-09-10 · HuggingFacezai-org/GLM-5.3-Flashpipeline: image-text-to-text; tags: transformers, safetensors, glm5_next, image-text-to-text, conversational, en, zh, arxiv:2602.15763model · ★ 2911 · 2026-08-25 · HuggingFacedeepseek-ai/DeepSeek-V4.1-Flash-1017pipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, license:mit, endpoints_compatible, 8-bitmodel · ★ 2145 · 2026-10-17 · HuggingFacestepfun-ai/Step-5-Previewtags: safetensors, step5_vl, license:other, eval-results, fp8, region:usmodel · ★ 121 · 2026-09-20 · HuggingFaceinternlm/Intern-Decision-4Bpipeline: image-text-to-text; tags: transformers, safetensors, qwen3_5, image-text-to-text, decision-making, multimodal, structured-prediction, decision-modelmodel · ★ 89 · 2026-09-26 · HuggingFace