多观点查询的 RAG 必须在固定上下文预算下保住不同答案与立场。LMVU 学的是「当前选集上再加这篇能带来多少边际观点覆盖」,用开发集观点标注在同一选择状态下对比候选;推理时反复给预算内候选打分。Perspectrum 覆盖率 94.6%,并在 WVS/ESS10 等上达到或接近满覆盖,优于最强基线。多观点检索的排序目标应是边际覆盖,而不是单篇相关性。
1. 问题
按相关性贪心会反复覆盖同一观点,预算耗尽后对立立场缺失。需要显式优化观点覆盖的边际收益。
2. 方法
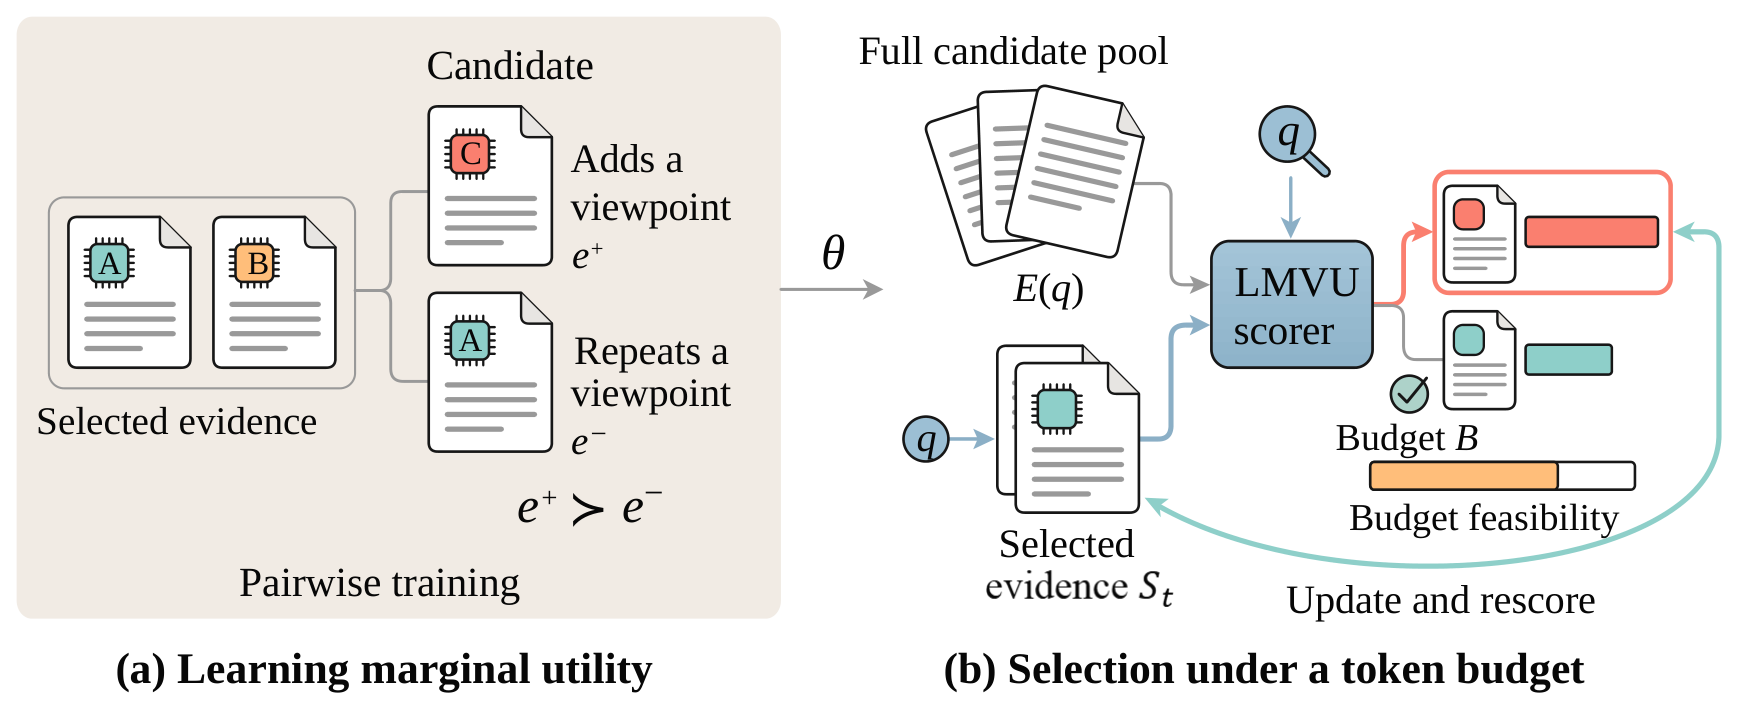
训练:同一选择状态下比较候选的边际覆盖增益(类 AUC/concordance)。推理:算法 1 在预算 B 内贪心选仍装得下且分数最高的证据。可用 MMR 过采样池(如 4×)再精选。
3. 核心贡献
把「多样性」从两两相似惩罚,改成对标注观点单元的边际覆盖效用。相关但不增覆盖的证据应让位。
4. 实验
WVS / ESS10 / Perspectrum / ArgKP 等。Perspectrum 94.6% 覆盖;WVS 上相对 MMR 的 ΔRVC 置信区间常不含 0。开发集 within-state NDCG@5 上 LMVU 型排序优于 MMR 启发式(如 0.6575 vs 更低)。去掉状态特征会让 WVS 开发排序 NDCG@5 从约 0.66 掉到 0.44。
| 基准 | 观察 |
|---|---|
| Perspectrum 覆盖 | 94.6% |
| WVS/ESS10 | 达或近满覆盖 / 优于最强基线 |
| 去状态特征 | NDCG@5 0.66→0.44 量级 |
5. 局限
依赖观点标注;预算与分词器相关;迁移到无标注域需启发式代理。
6. 实践意义
争议/多立场问答的 RAG 选证,把目标从相似度改成边际观点覆盖,并在开发态上做 within-state 对比训练。
补充:数字来自论文实验节与表格;图为 HTML/PDF 原图或页渲染。
补充细节:实验协议与主表数字均按论文正文抄录;若与附录小数有出入,以正文主表为准。配图用于帮助定位架构与主结果,不替代表格中的精确值。
示意走查:预算还剩 200 token,候选 A 与当前集观点重叠高,候选 B 带来一个尚未覆盖的反对立场。LMVU 给 B 更高边际分,即使 A 的单篇相关性更高也会让位。训练时这种「同状态下的成对比较」直接对应推理时的贪心选择。