2026-10-25 周日 · AI Search

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 4 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景Adobe 拆开 agent 检索的归因断层、对话搜索模拟器对齐 NIST、多观点边际覆盖与跨 query 校准的 RCP-nDCG——今天 AI 搜索赛道的主线是:评测与选证都要承认「生成层在用户之前消费检索」,并用可校准、保观点的目标替换点一下就走的 SERP 假设。 — 评分 130 篇,入选 10 篇,分数 3.90 – 4.55

本期目录 · 10 篇
  1. 01When Agentic Retrieval Fails Silently: Framework and Production Evidence from a Creative AI Assistant
  2. 02AutoSim: A Self-Improving User Simulator for Conversational Search Evaluation
  3. 03Learning Marginal Viewpoint Utility for Budgeted Evidence Selection in RAG
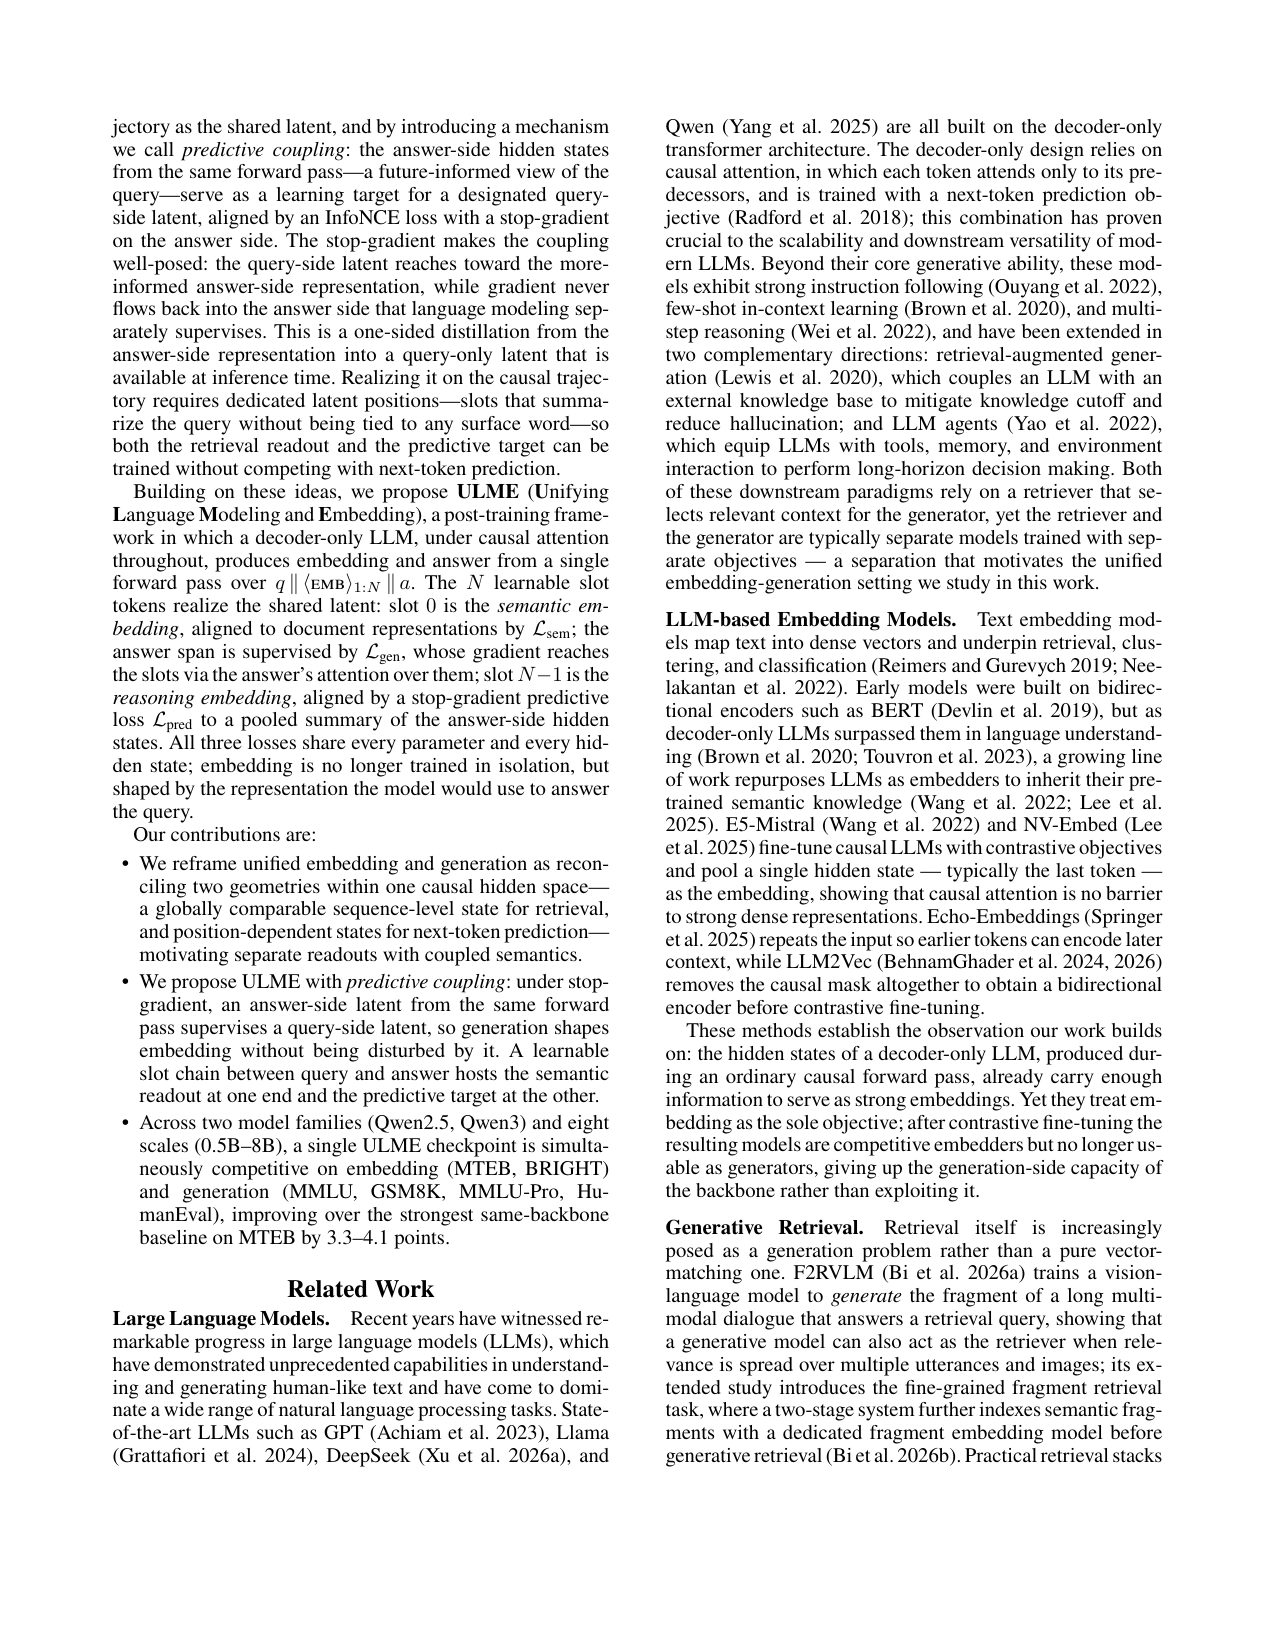
  4. 04ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling
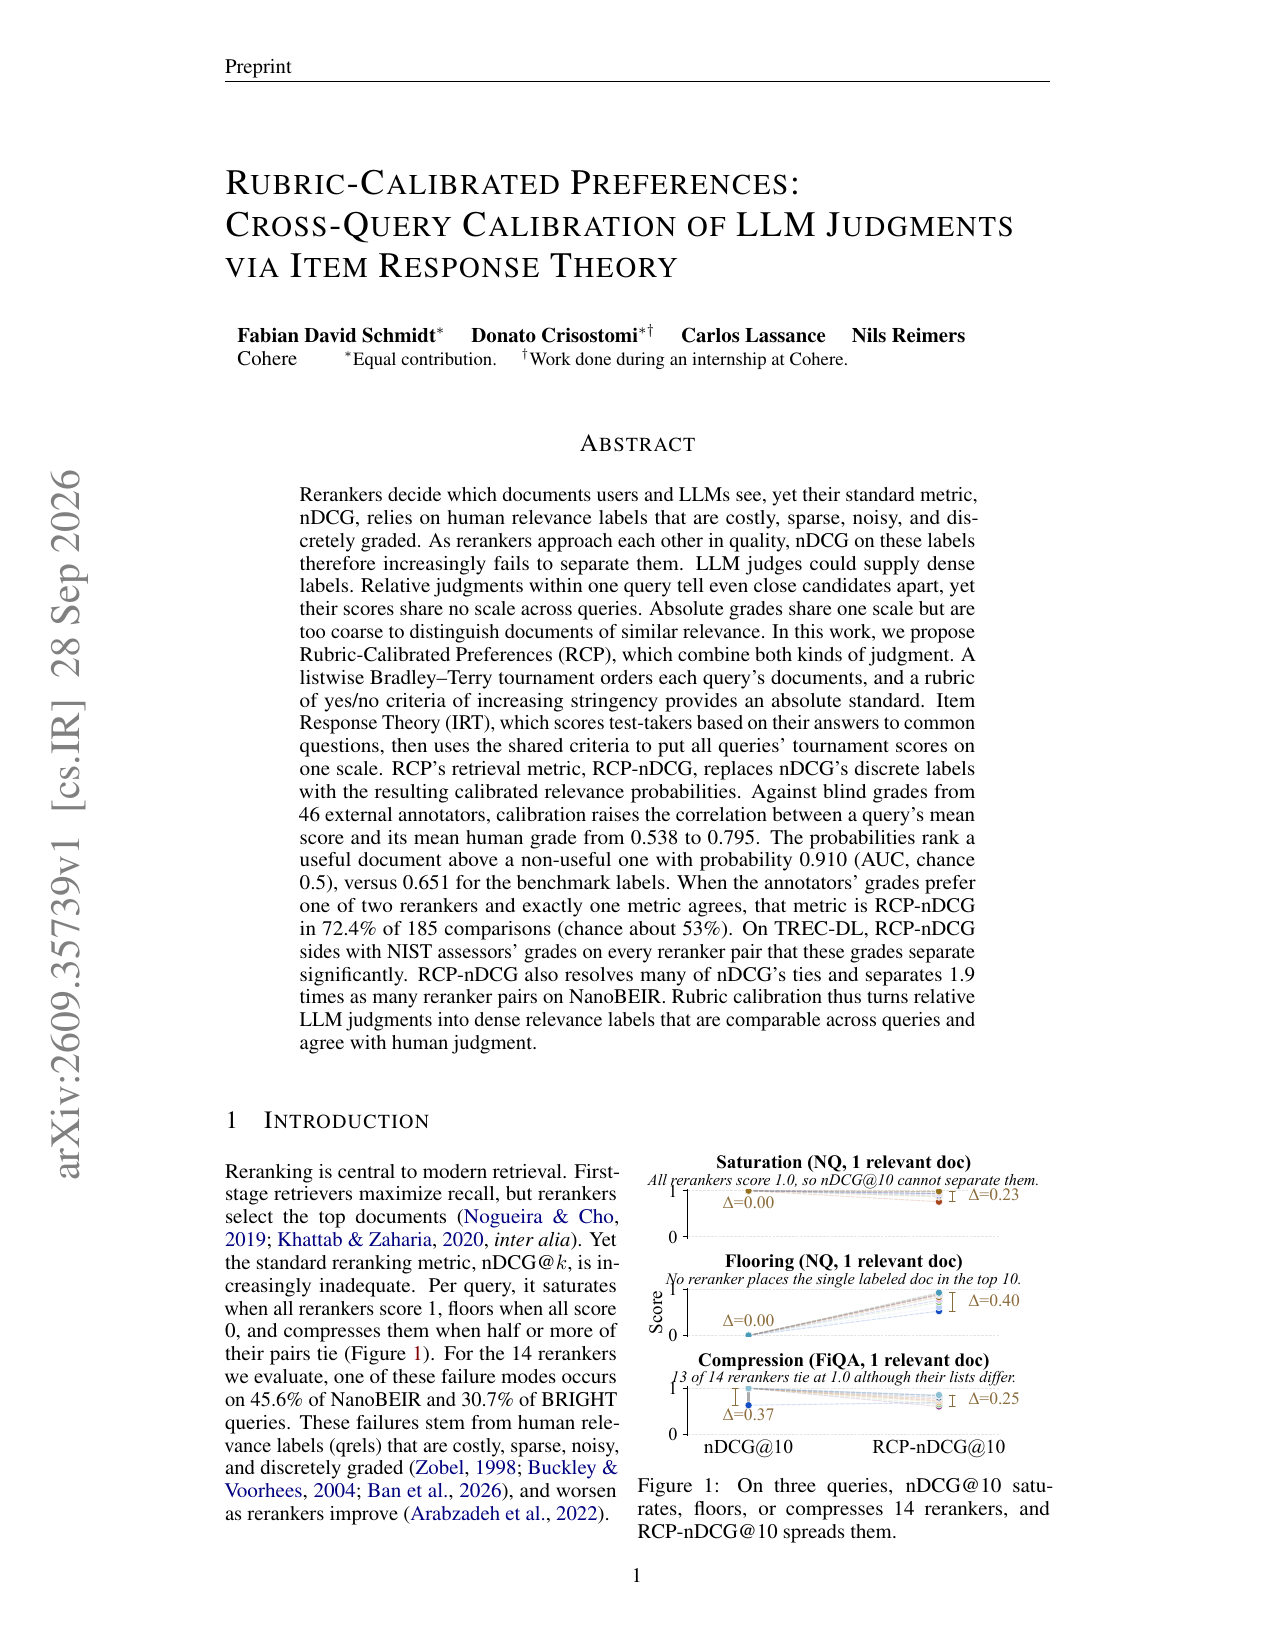
  5. 05Rubric-Calibrated Preferences: Cross-Query Calibration of LLM Judgments via Item Response Theory
  6. 06Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models
  7. 07Graph Topology Meets Energy-Driven Pathfinding: Preserving Contextual Consistency in Retrieval-Augmented Generation
  8. 08ERCLIP: Small-Data Adaptation of CLIP for Free-Length Image-Text Retrieval
  9. 09FlexVDR: Learning to Allocate Matryoshka Representation Budgets for Visual Document Retrieval
  10. 10Unbalanced Optimal Transport for Efficient Visual Document Retrieval
LEAD STORY · 今日必读 · Adobe

When Agentic Retrieval Fails Silently: Framework and Production Evidence from a Creative AI Assistant

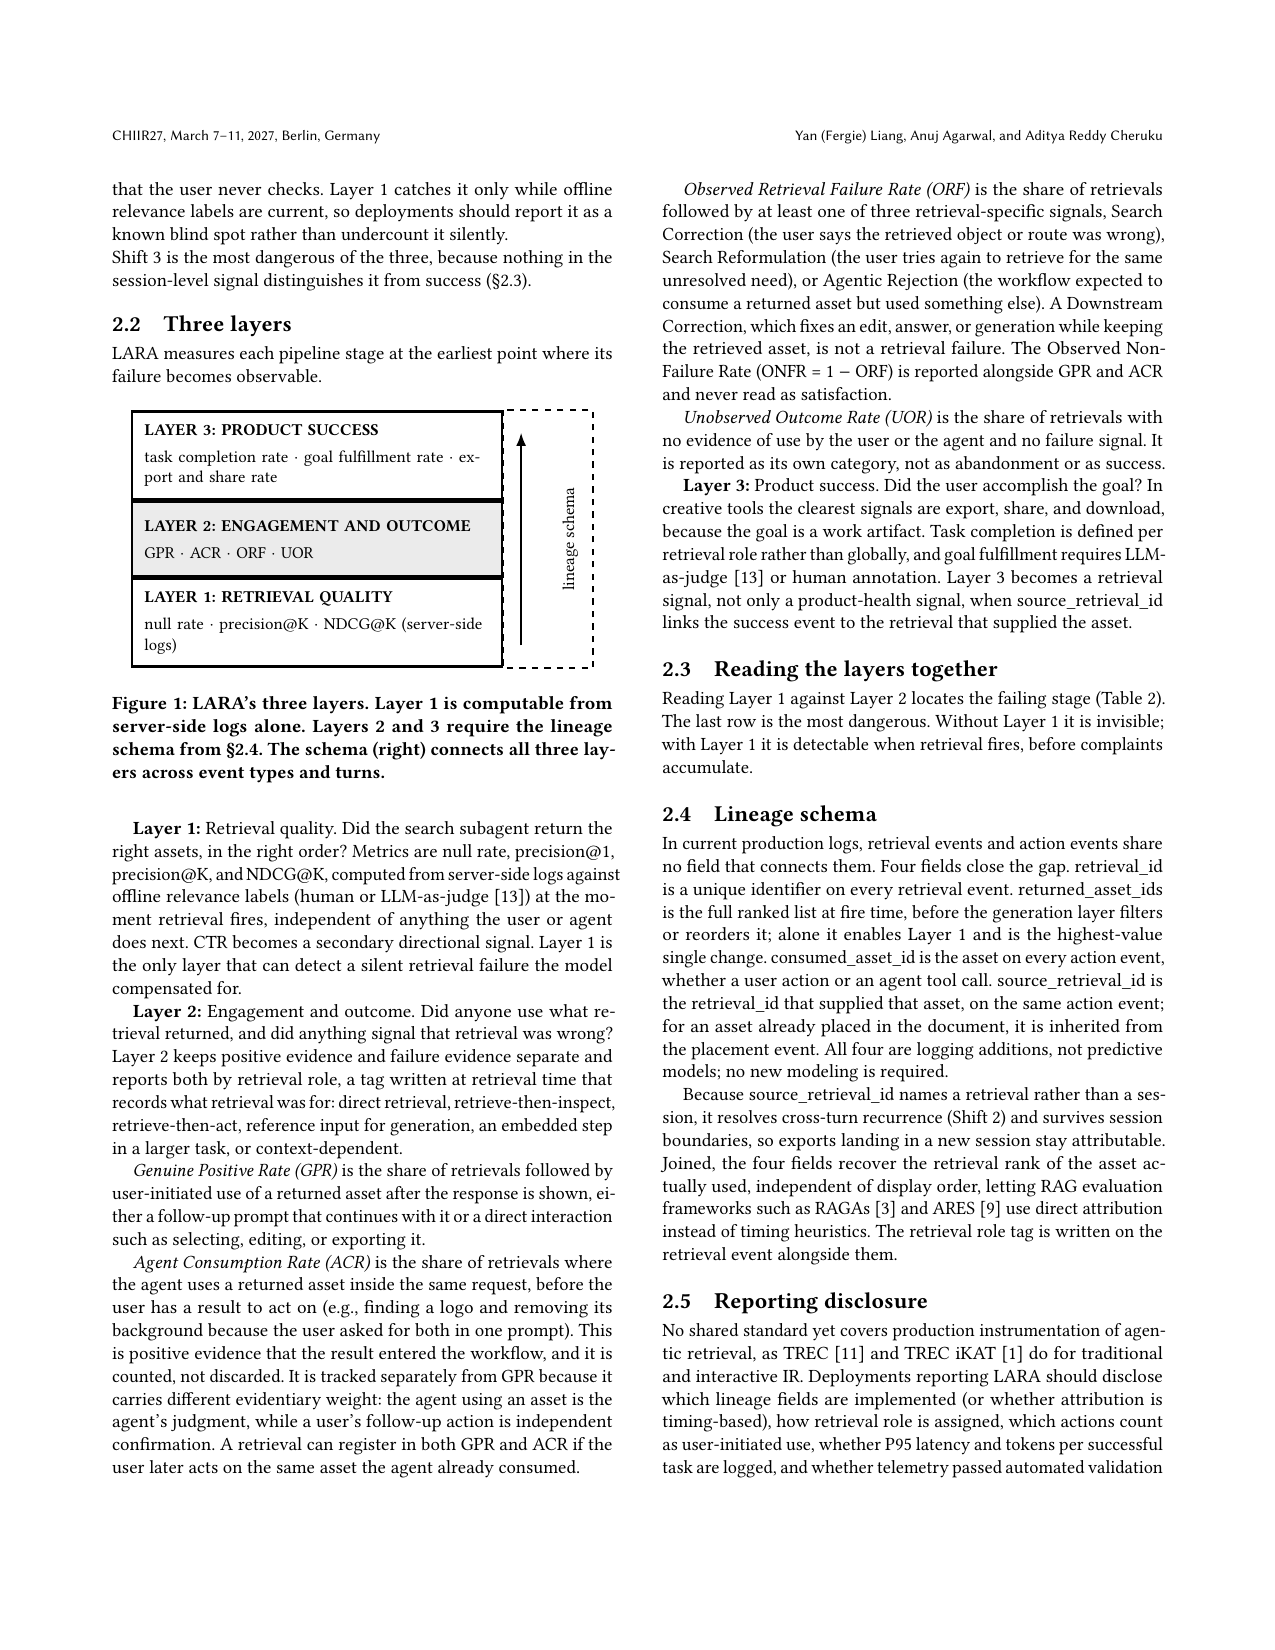
CTR / MRR / 行为 NDCG 默认用户看见并点击排序结果;在 agent 助手里,生成层先消费检索,归因在「谁看过、何时行动、结果由检索还是模型知识造成」三处断裂——Adobe 称之为 attribution gap。LARA(Layered Agentic Retrieval Assessment)分层量检索质量、参与与下游结果;生产助手提示上检索率仅 0.31%,聊天用户比画廊用户更常改写(44.4% vs 33.1%)。Agent 检索评估不能再假装用户直接点了 SERP——要按层拆开归因。

相关 5新颖 4实用 5证据 4时效 4
4.55
综合分 / 5
偏好调整 4.60
Yan, Liang, Anuj Agarwal, Aditya Reddy Cheruku · 2026-10-21 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 4.30

AutoSim: A Self-Improving User Simulator for Conversational Search Evaluation

📖 有深读 · 2 分钟

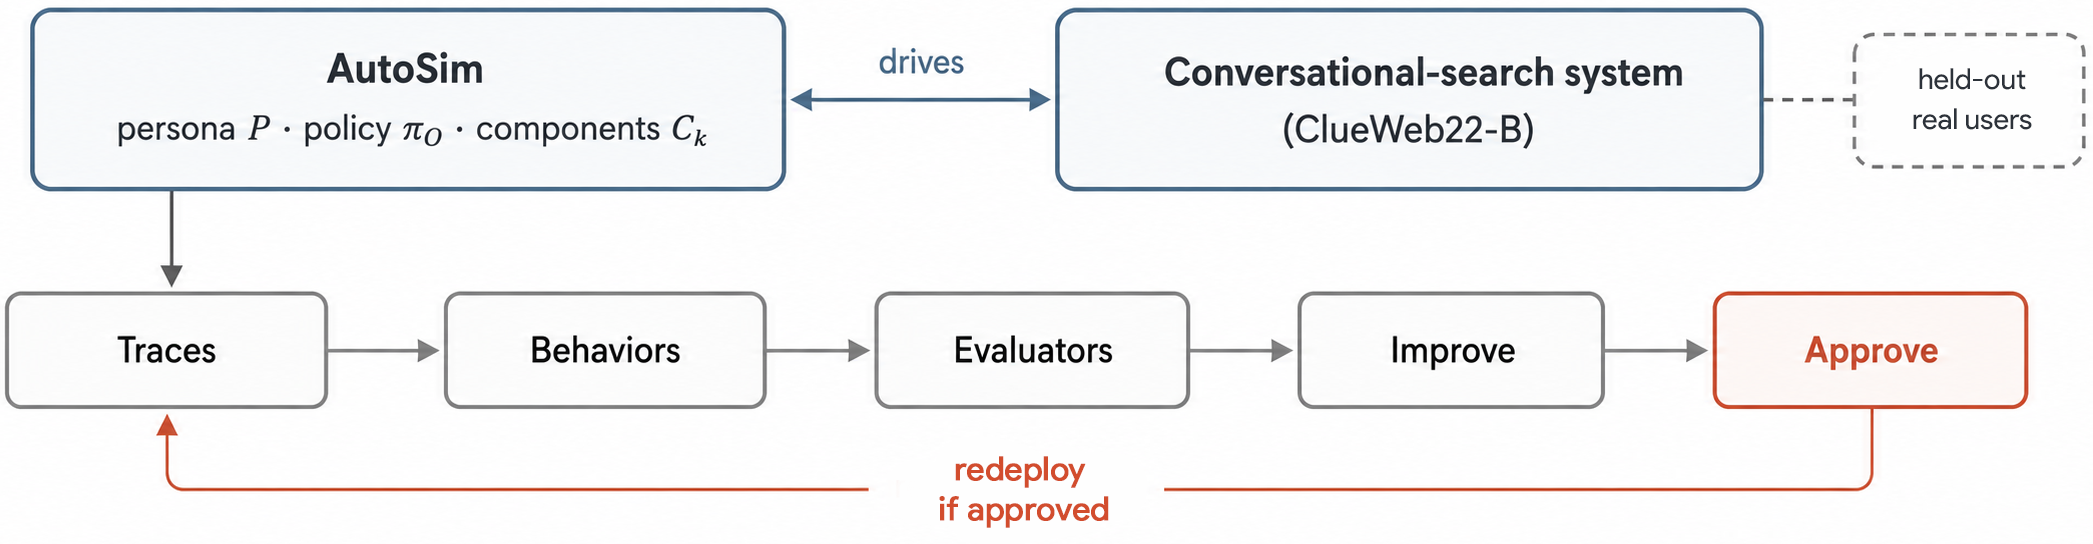
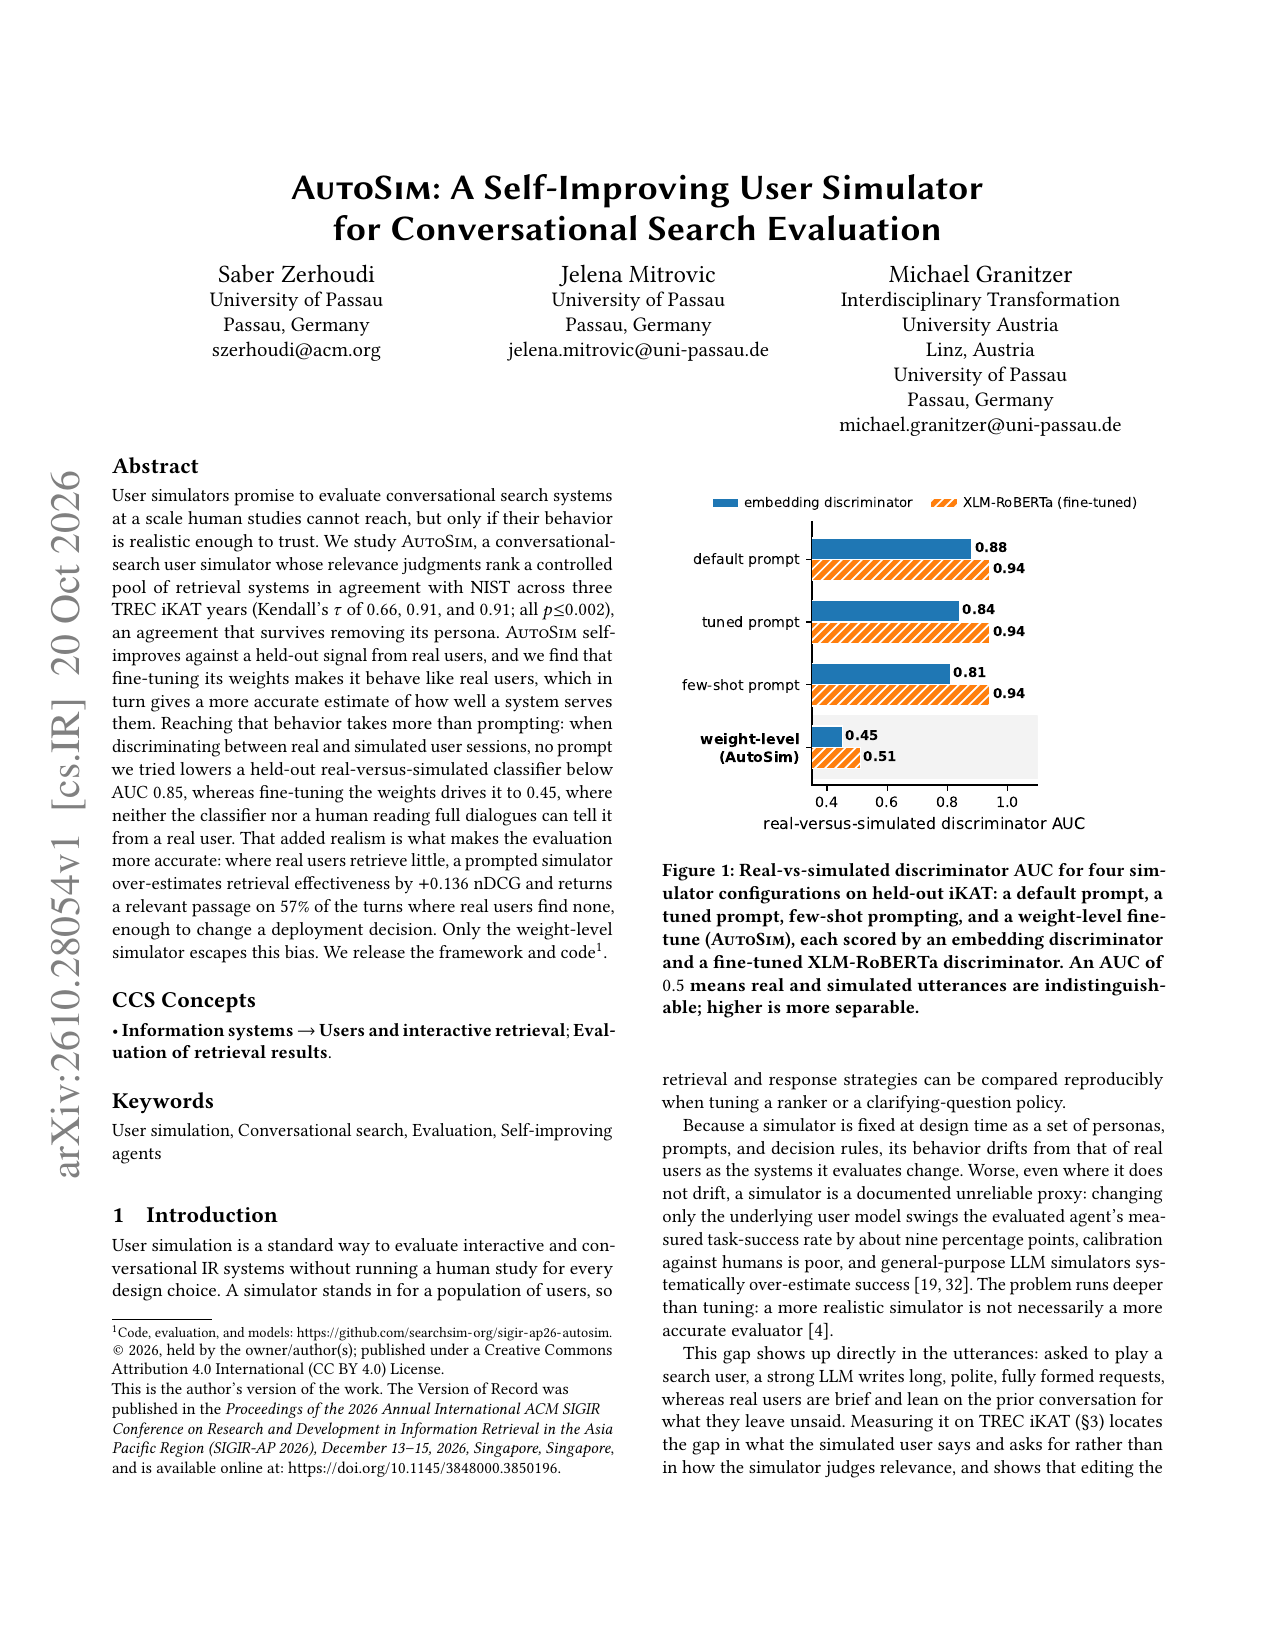
对话式搜索需要可信用户模拟器才能规模化评测。AutoSim 的相关性判断在三年 TREC iKAT 上与 NIST 对受控检索系统排序一致(Kendall τ=0.66 / 0.91 / 0.91,均 p≤0.002),去掉人设后仍成立。相对真人 held-out 信号自改进:权重级自改进把真伪判别 AUC 从约 0.85 压到 0.45,并抬检索效果 +0.136 nDCG,57% 轮次返回相关段落。模拟器可信的标准是「能排出和 NIST 一样的系统名次」,而不只是话说得像人。

Saber Zerhoudi, Jelena Mitrovic, Michael Granitzer
arXiv·2026-10-20·Relevance 5 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
独立页面阅读 ↗
03 4.30

Learning Marginal Viewpoint Utility for Budgeted Evidence Selection in RAG

📖 有深读 · 3 分钟

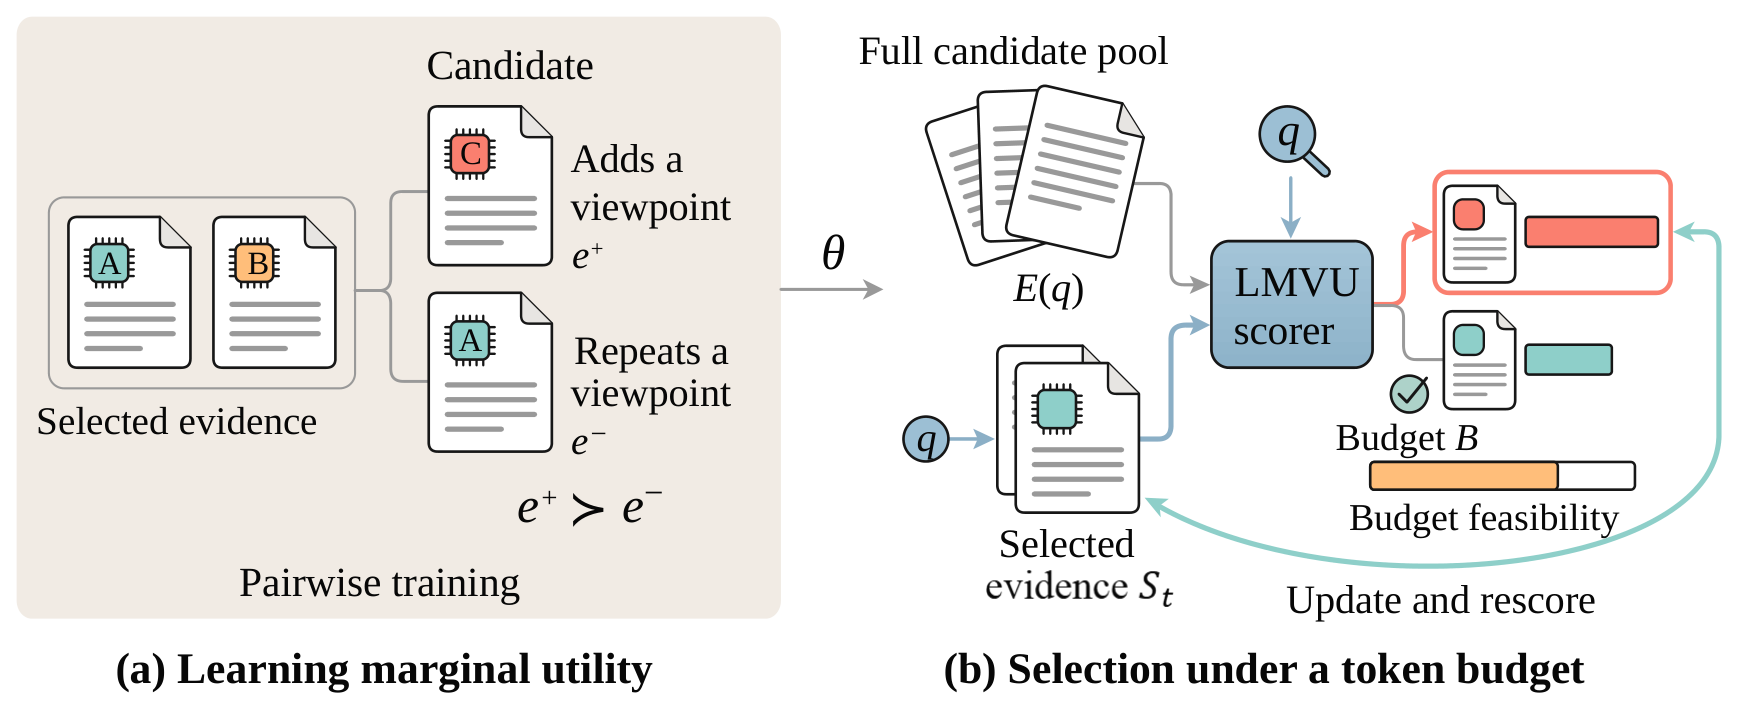
多观点查询的 RAG 必须在固定上下文预算下保住不同答案与立场。LMVU 学的是「当前选集上再加这篇能带来多少边际观点覆盖」,用开发集观点标注在同一选择状态下对比候选;推理时反复给预算内候选打分。在 Perspectrum 上覆盖率 94.6%,并在 WVS/ESS10 等上达到或接近满覆盖,优于最强基线。多观点检索的排序目标应是边际覆盖,而不是单篇相关性。

Yiyang Duan, Ziqi Yu, Tiantong Wu, Yebo Wu, Wei Yang Bryan Lim
arXiv·2026-10-21·Relevance 5 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
独立页面阅读 ↗
04 4.30

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

📖 有深读 · 3 分钟

嵌入与生成常是两个目标不兼容、并排部署的专用模型;GritLM 一类统一模型要么切换注意力模式,要么把两目标当并行损失。ULME 提出预测耦合:让嵌入与语言建模互相强化,而不是模式切换或简单多任务。面向 RAG/agent 里「同一 query 先嵌后生成」的双次处理。统一嵌入-生成的关键是目标耦合,而不是共享权重后再切换模式。

Yang Liu, Zhiqiang Yuan, Shu-Dong Huang, Jiancheng Lv, Liwei Yang, Qiwei Yan, Kailin Lv, Jinchao Zha...
arXiv·2026-10-22·Relevance 5 · Novelty 4 · Practical 4 · Evidence 3 · Timely 5
独立页面阅读 ↗
05 4.30

Rubric-Calibrated Preferences: Cross-Query Calibration of LLM Judgments via Item Response Theory

Cohere📖 有深读 · 3 分钟

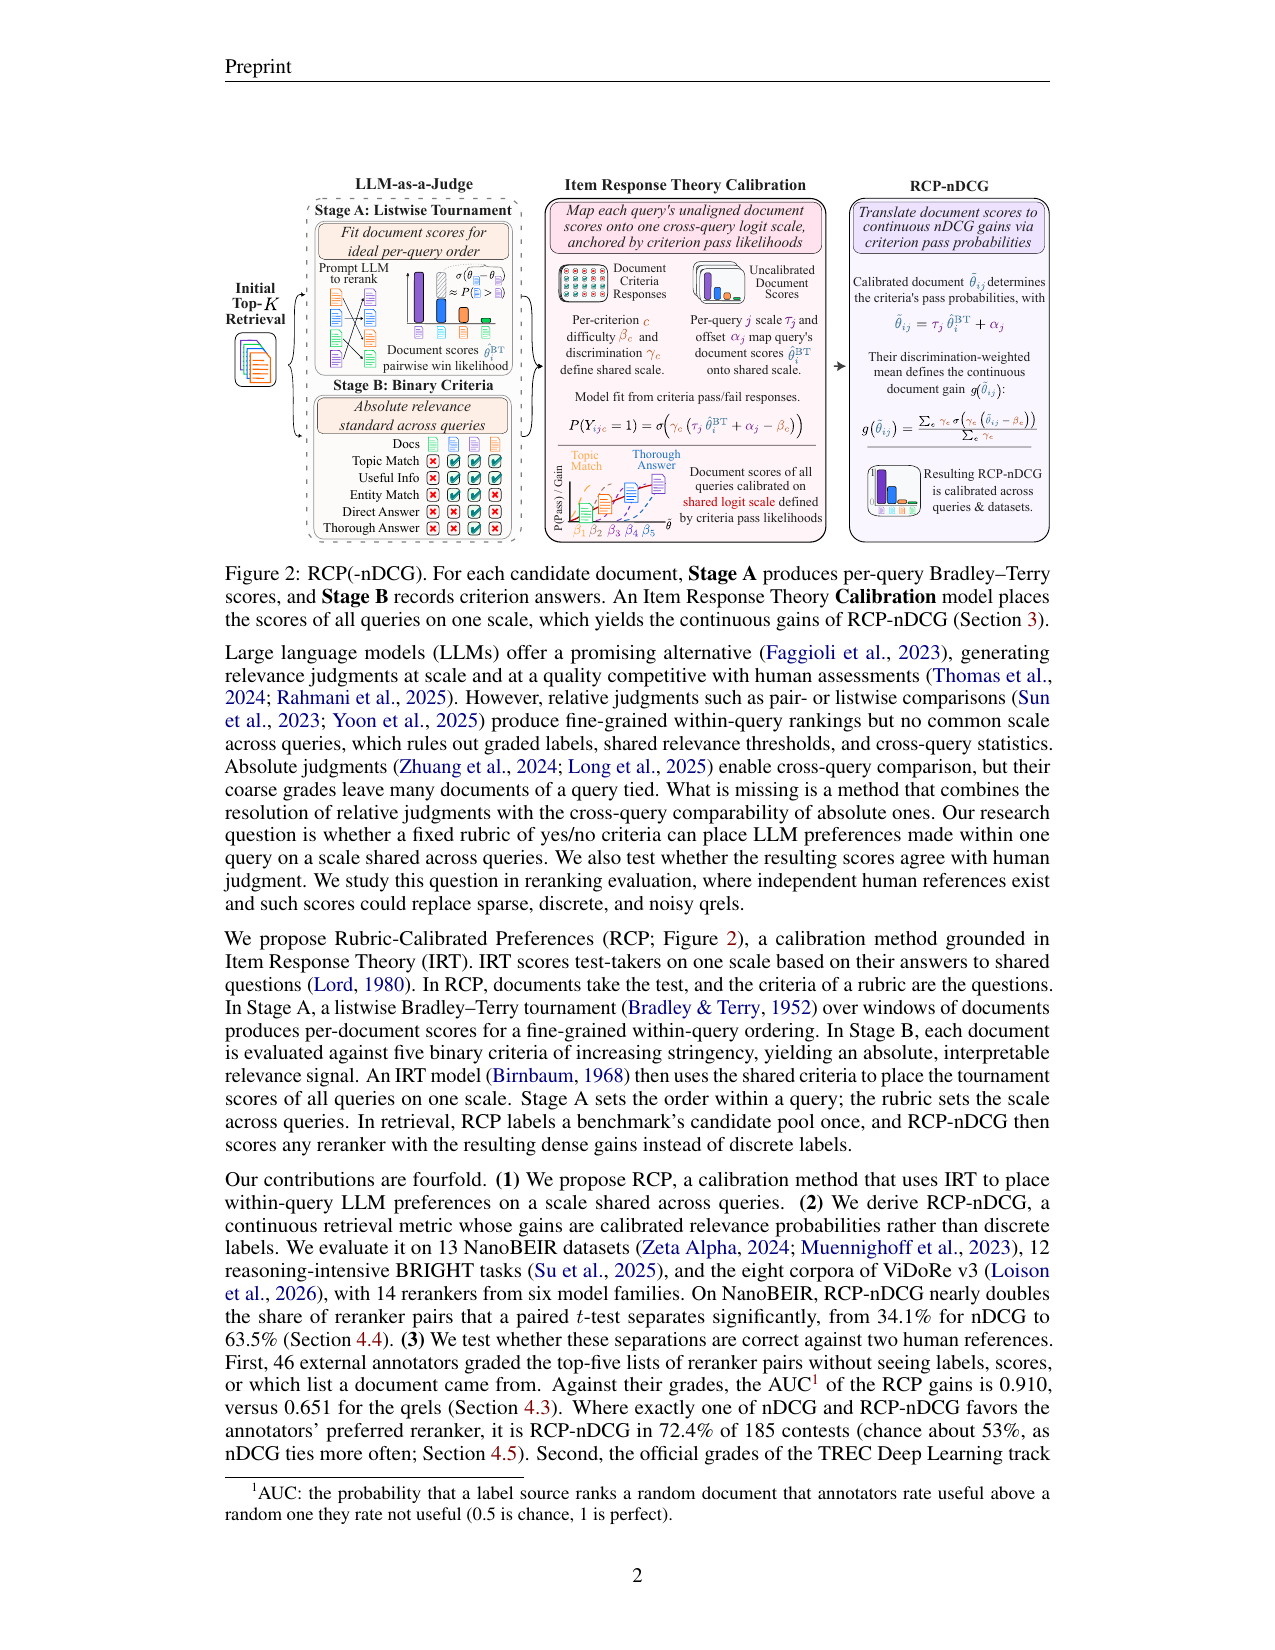
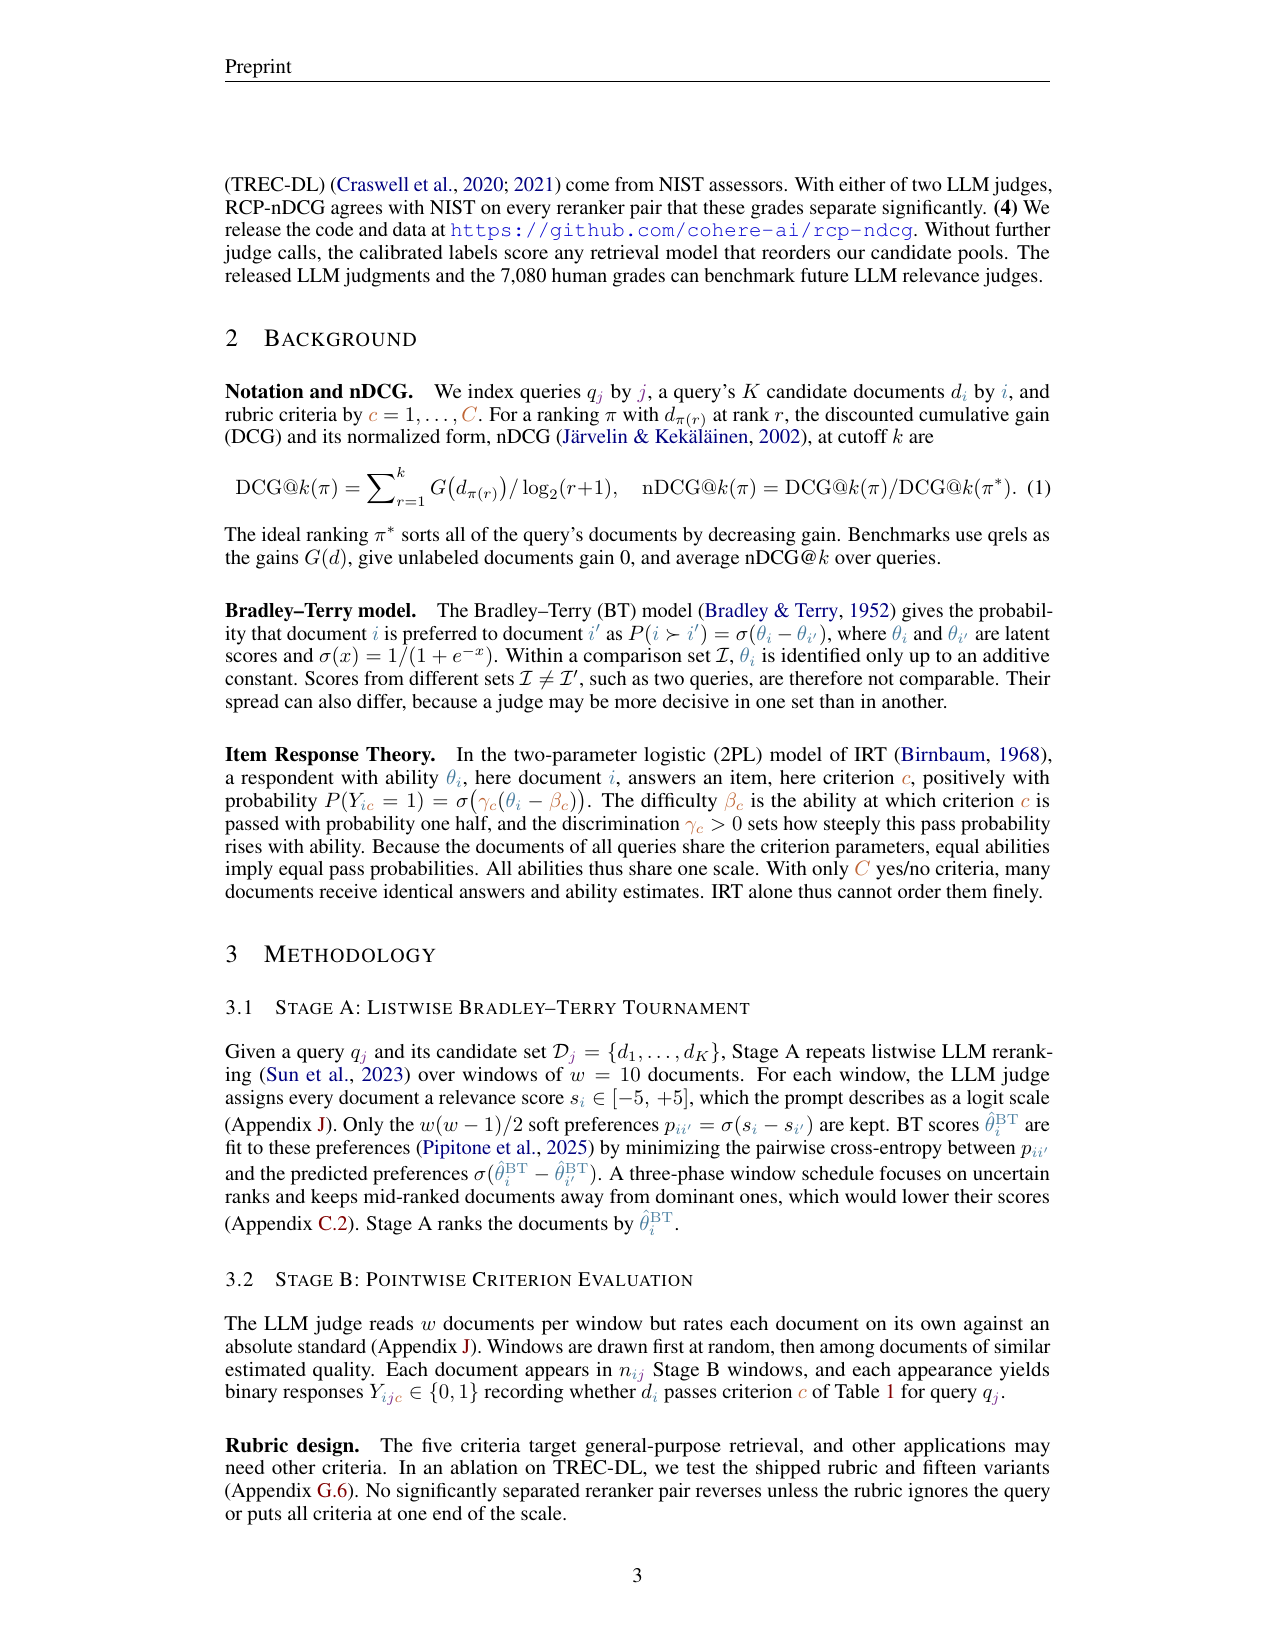
重排器越接近,依赖稀疏离散人工标的 nDCG 越分不开它们;LLM 相对判断能分清接近文档却跨 query 无统一刻度,绝对分又太粗。Cohere 的 Rubric-Calibrated Preferences(RCP)用项目反应理论做跨 query 校准,RCP-nDCG 替换离散标:有用/无用判别 AUC 0.910(基准标签 0.651);185 次对比里唯一同意的一方是 RCP-nDCG 占 72.4%;TREC-DL 上每次都与 NIST 等级站同侧。NanoBEIR / BRIGHT 分别有 45.6% / 30.7% query 落在 nDCG 饱和/触底/压缩失效模式。重排器评测要从「离散 nDCG」换成可跨 query 校准的稠密判断。

['Fabian David Schmidt', 'Donato Crisostomi', 'Carlos Lassance', 'Nils Reimers']
arXiv·2026-09-28·Relevance 5 · Novelty 4 · Practical 4 · Evidence 5 · Timely 3
独立页面阅读 ↗
06 4.05

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

搜索 agent 常缺「搜索状态意识」:分不清已获得什么、还缺什么,导致幻觉推理与过早停搜。SARL(Self-Assessment Reinforcement Learning)让模型学会评估自身搜索状态,在检索增强推理中显式自检后再决定继续搜还是作答。停搜条件应来自对「信息缺口」的自评估,而不是步数用尽或一次命中。

Taewhoo Lee, Minju Song, Jungwoo Park, Chanwoong Yoon, Junha Jung, Hyeon Hwang, Sanghoon Lee, Minbyu...
arXiv·2026-10-21·Relevance 5 · Novelty 4 · Practical 3 · Evidence 4 · Timely 4
07 4.00

Graph Topology Meets Energy-Driven Pathfinding: Preserving Contextual Consistency in Retrieval-Augmented Generation

已录用 EMNLP 2026

图谱 RAG 常把连续文本蒸成离散符号(语义丢失),碎片图结构又与 LLM 预训练的连续文本模态冲突。本文把图拓扑与能量驱动寻路结合,在检索增强生成里保上下文一致性,缓解结构化蒸馏与模态错配。KG-RAG 的瓶颈常在「怎么结构化与怎么走路径」,而不只在检索器分数。

Yufeng Li, Zaijing Li, Fuchen Zhang, Zongzong Wu, Ming Zhao, Fengxiao Tang
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
08 4.00

ERCLIP: Small-Data Adaptation of CLIP for Free-Length Image-Text Retrieval

CLIP 文本侧只有 77 token,长图注会被截断。ERCLIP 小数据适配:训练时把长 caption 按句编码再均值池化或门控残差 Transformer 融合,并加句级对比损失;推理仍是未改动的双塔,测试 caption 仍走 77-token 窗。相对基座 CLIP 提升 6.5–11.2 点,收回相对 Long-CLIP 差距的 62–77%。长图注不必改推理编码器——训练时把句子级信号灌进去即可。

Hoang-Bao Le, Allie Tran, Binh T. Nguyen, Liting Zhou, Cathal Gurrin
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
09 3.90

FlexVDR: Learning to Allocate Matryoshka Representation Budgets for Visual Document Retrieval

视觉文档检索靠多向量细粒度表示,编码与匹配贵;现有压缩/弹性表示给出多种预算,却不告诉「这条 query 该用哪档」。FlexVDR 学在付全量算力前估计各表示预算的检索价值,再按 query 分配 Matryoshka 式表示预算。弹性表示的关键是「按 query 选预算」,而不只是把多档配置摆出来。

Haowen Xiang, Yibo Yan, Xin Zou, Shuliang Liu, Yi Cao, Mingdong Ou, Xuming Hu
arXiv·2026-10-19·Relevance 4 · Novelty 4 · Practical 4 · Evidence 3 · Timely 4
10 3.90

Unbalanced Optimal Transport for Efficient Visual Document Retrieval

已录用 ECCV 2026

VLM 做 OCR-free 视觉文档检索时 token 过多,扩展性差;现有压缩靠孤立启发式,难同时权衡重要性、语义冗余与覆盖。本文将视觉 token 压缩写成非平衡最优传输(UOT),统一重要性、冗余与覆盖,在保检索质量下压 token。视觉文档检索的 token 预算应用传输问题一次性权衡,而不是堆启发式。

Hoyeon Shin, Jeongyeon Kim, Yeong Jun Koh, Yeoneung Kim, Hanul Kim
arXiv·2026-10-07·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 3

其他赛道今日

点击切换
Generative
4
生成式推荐 · 篇入选
Personalization
10
个性化推荐 · 篇入选
Infra
10
系统与索引 · 篇入选