2026-10-25 周日 · Personalization

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 4 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景Premium 人脉检索把「看过谁」写进目标、轮播 bandit 只更新真实浏览深度、快手用多 agent 按人写广告脚本——今天个性化赛道的主线是:把曝光、深度与创意生产从「事后偏差修正」前移到目标与系统结构里。 — 评分 49 篇,入选 10 篇,分数 3.20 – 4.00

本期目录 · 10 篇
  1. 01PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn
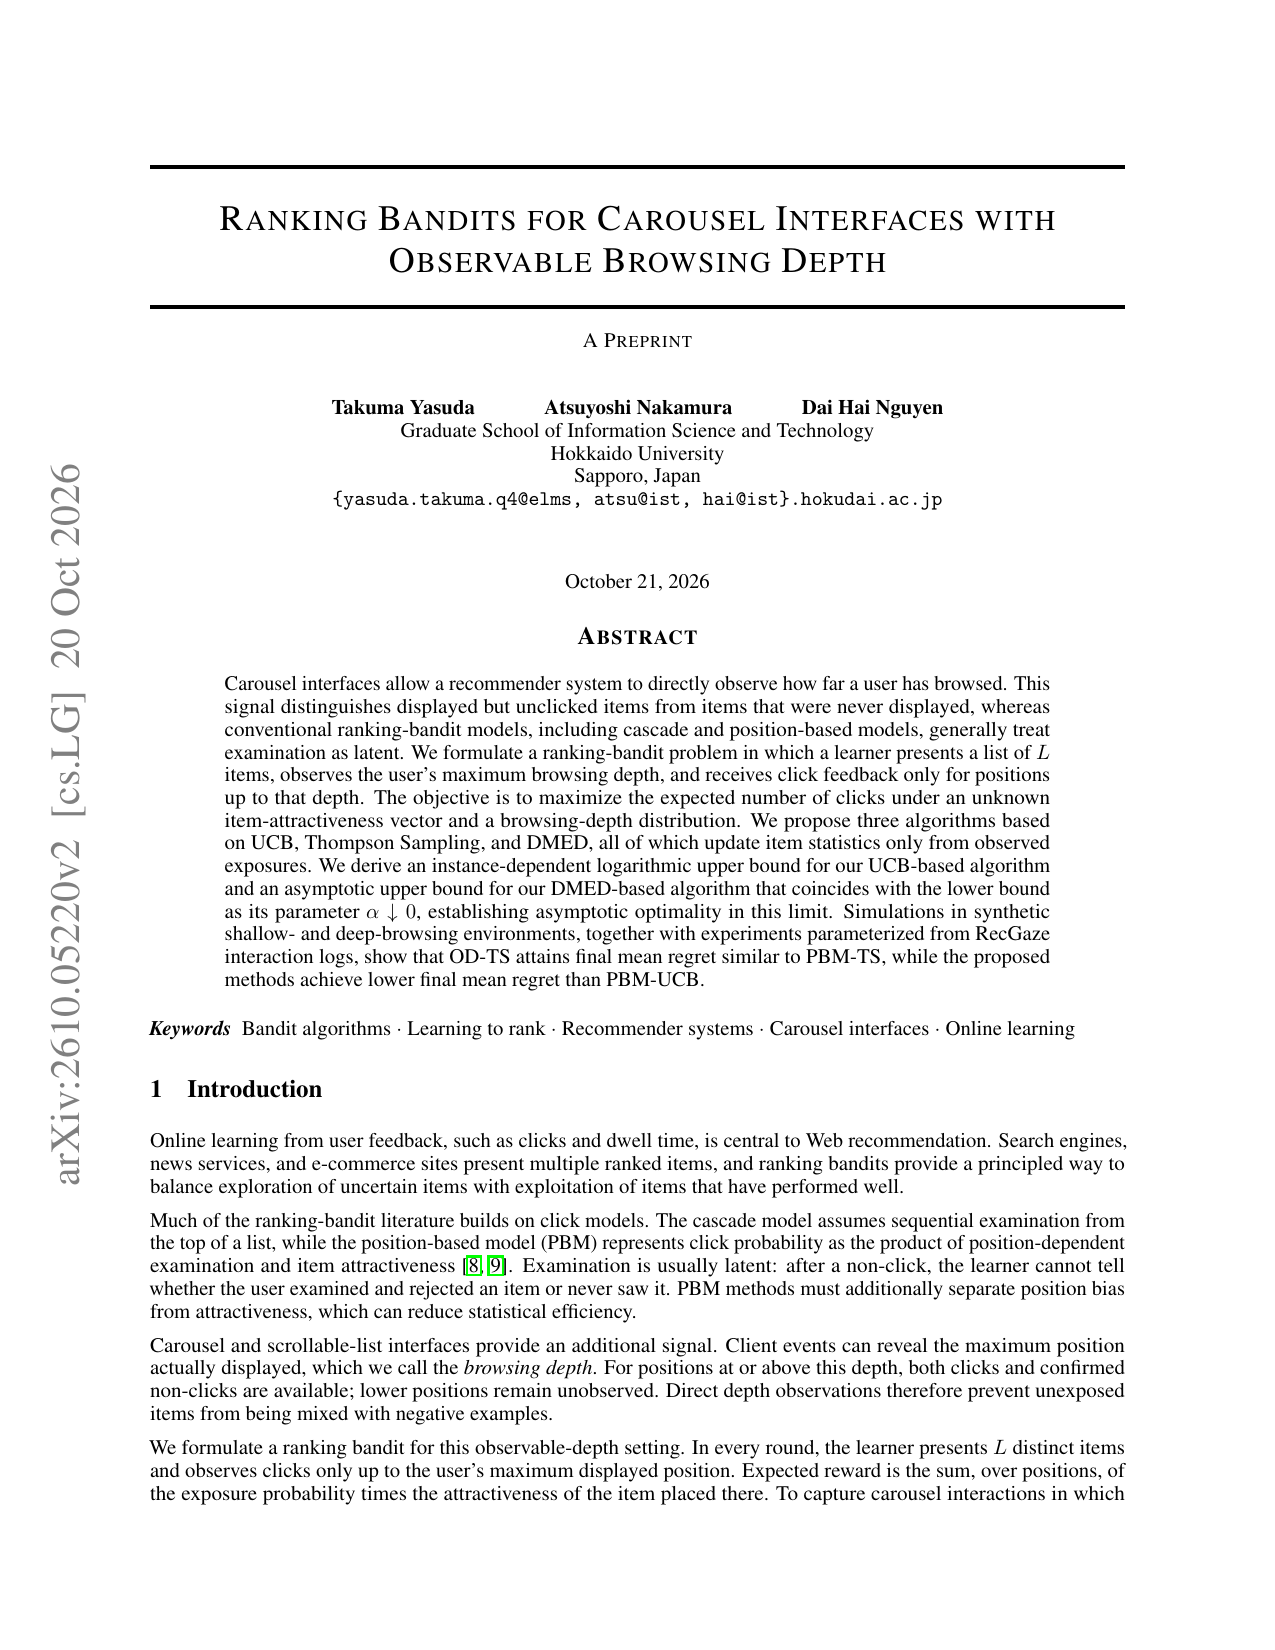
  2. 02Ranking Bandits for Carousel Interfaces with Observable Browsing Depth
  3. 03Bezier-Guided Adaptive Flow for Cross-domain Sequential Recommendation
  4. 04Behavior lifetime modeling uses time sensitive behavioral signals to rank candidate items for purchase in E commerce recommendation
  5. 05MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning
  6. 06UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
  7. 07FairFRESH: A Neuro-Symbolic Framework for Fair and Explainable Household Food Recommendation
  8. 08Truthful by Omission: Click Thinning for LLM-Native Advertising
  9. 09From Scores to Safe Sets: Exact Safety--Constrained Decoding for Medication Recommendation
  10. 10FAIRGate: Agentic Runtime Policy Selection and Verified Repair for Fairer Recommendation Delivery
LEAD STORY · 今日必读 · LinkedIn

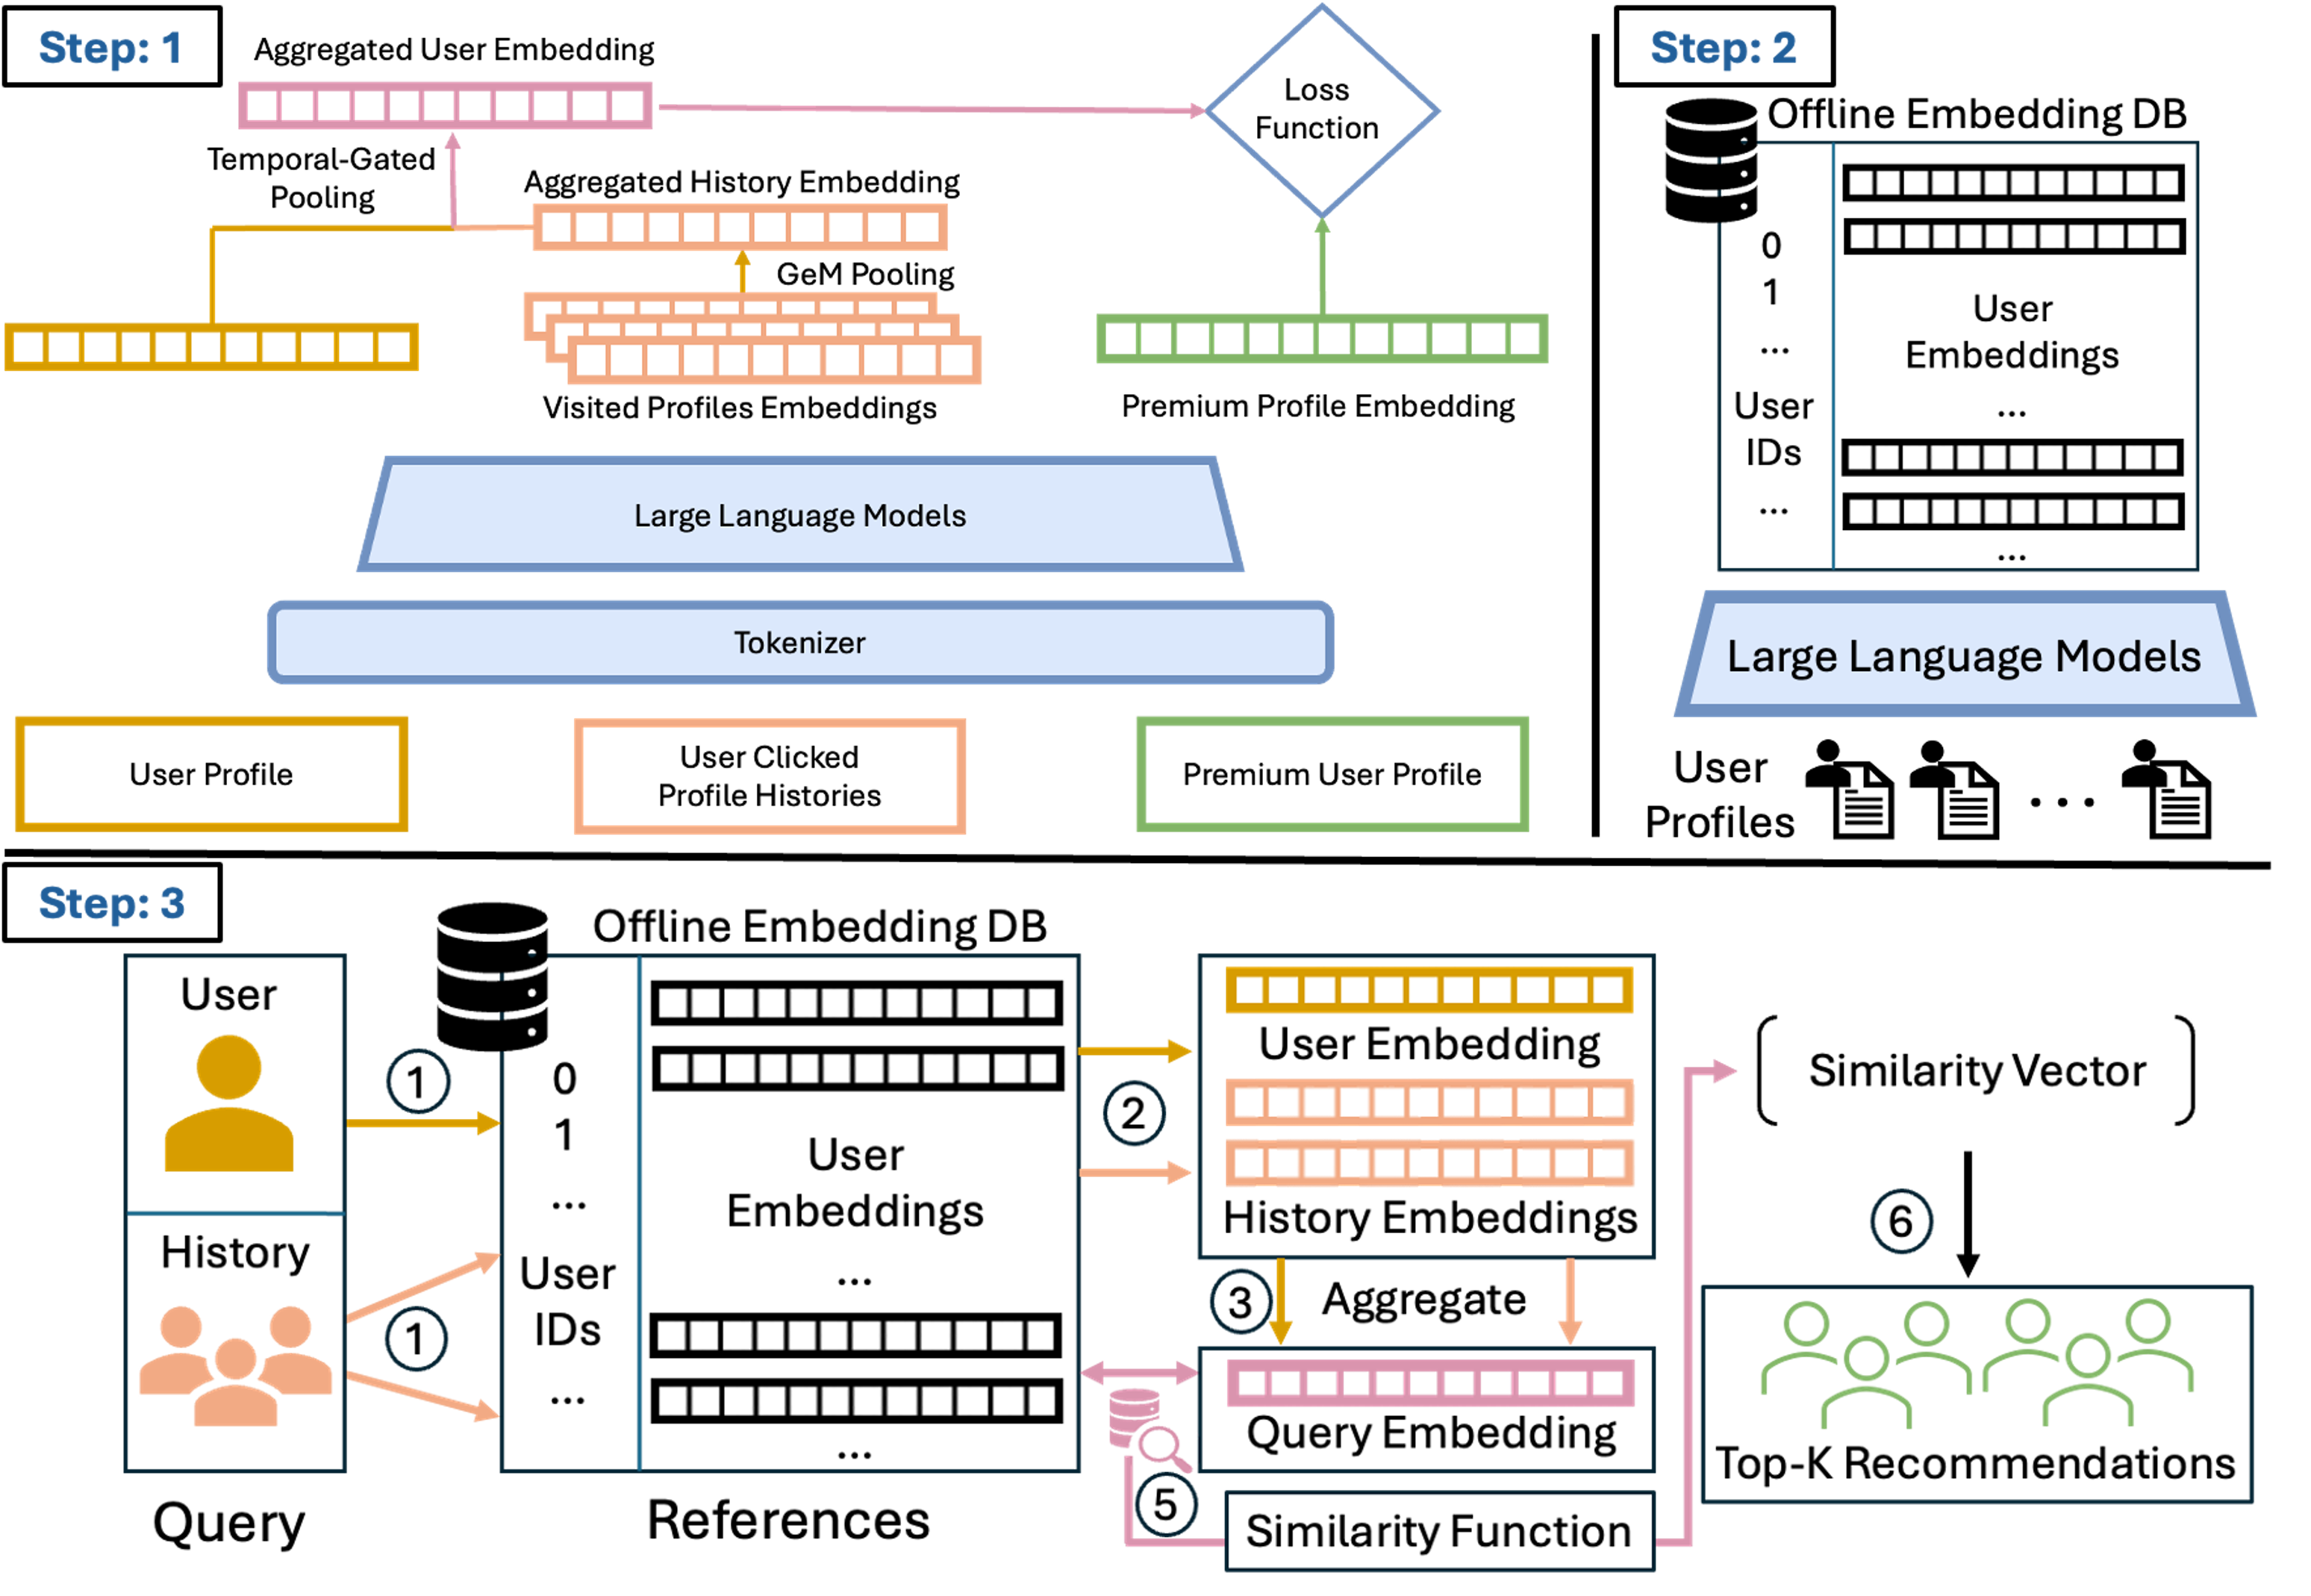
PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn

LinkedIn 发现:面向 Premium 会员的「人脉浏览推荐」里,通用会员向量 Holistic-171 的 MAR@100 只有 0.288,0.6B 开箱 LLM embedding 更低到 0.192——二者都没学过「看过谁」这条曝光条件。PAIR 把曝光当作偏好学习的条件,用同尺度 0.6B 模型把 MAR@100 拉到 0.450(相对 Holistic 提升 56%、相对开箱模型 2.3×);线上 A/B 点击率 +7.5%、Premium 留存 +2.1%,服务延迟无明显回退。人脉推荐的「看过」不是噪声而是偏好信号:把曝光条件写进目标,小模型也能超过大而泛的会员向量。

相关 4新颖 4实用 4证据 3时效 5
4.00
综合分 / 5
偏好调整 4.08
Zhongkai Shangguan, Yanbin Kang, Yihan Cao, Ruijie Jiang, Qiannan Yin, Chang Yue, Zijian Z... · 2026-10-22 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 4.00

Ranking Bandits for Carousel Interfaces with Observable Browsing Depth

📖 有深读 · 4 分钟

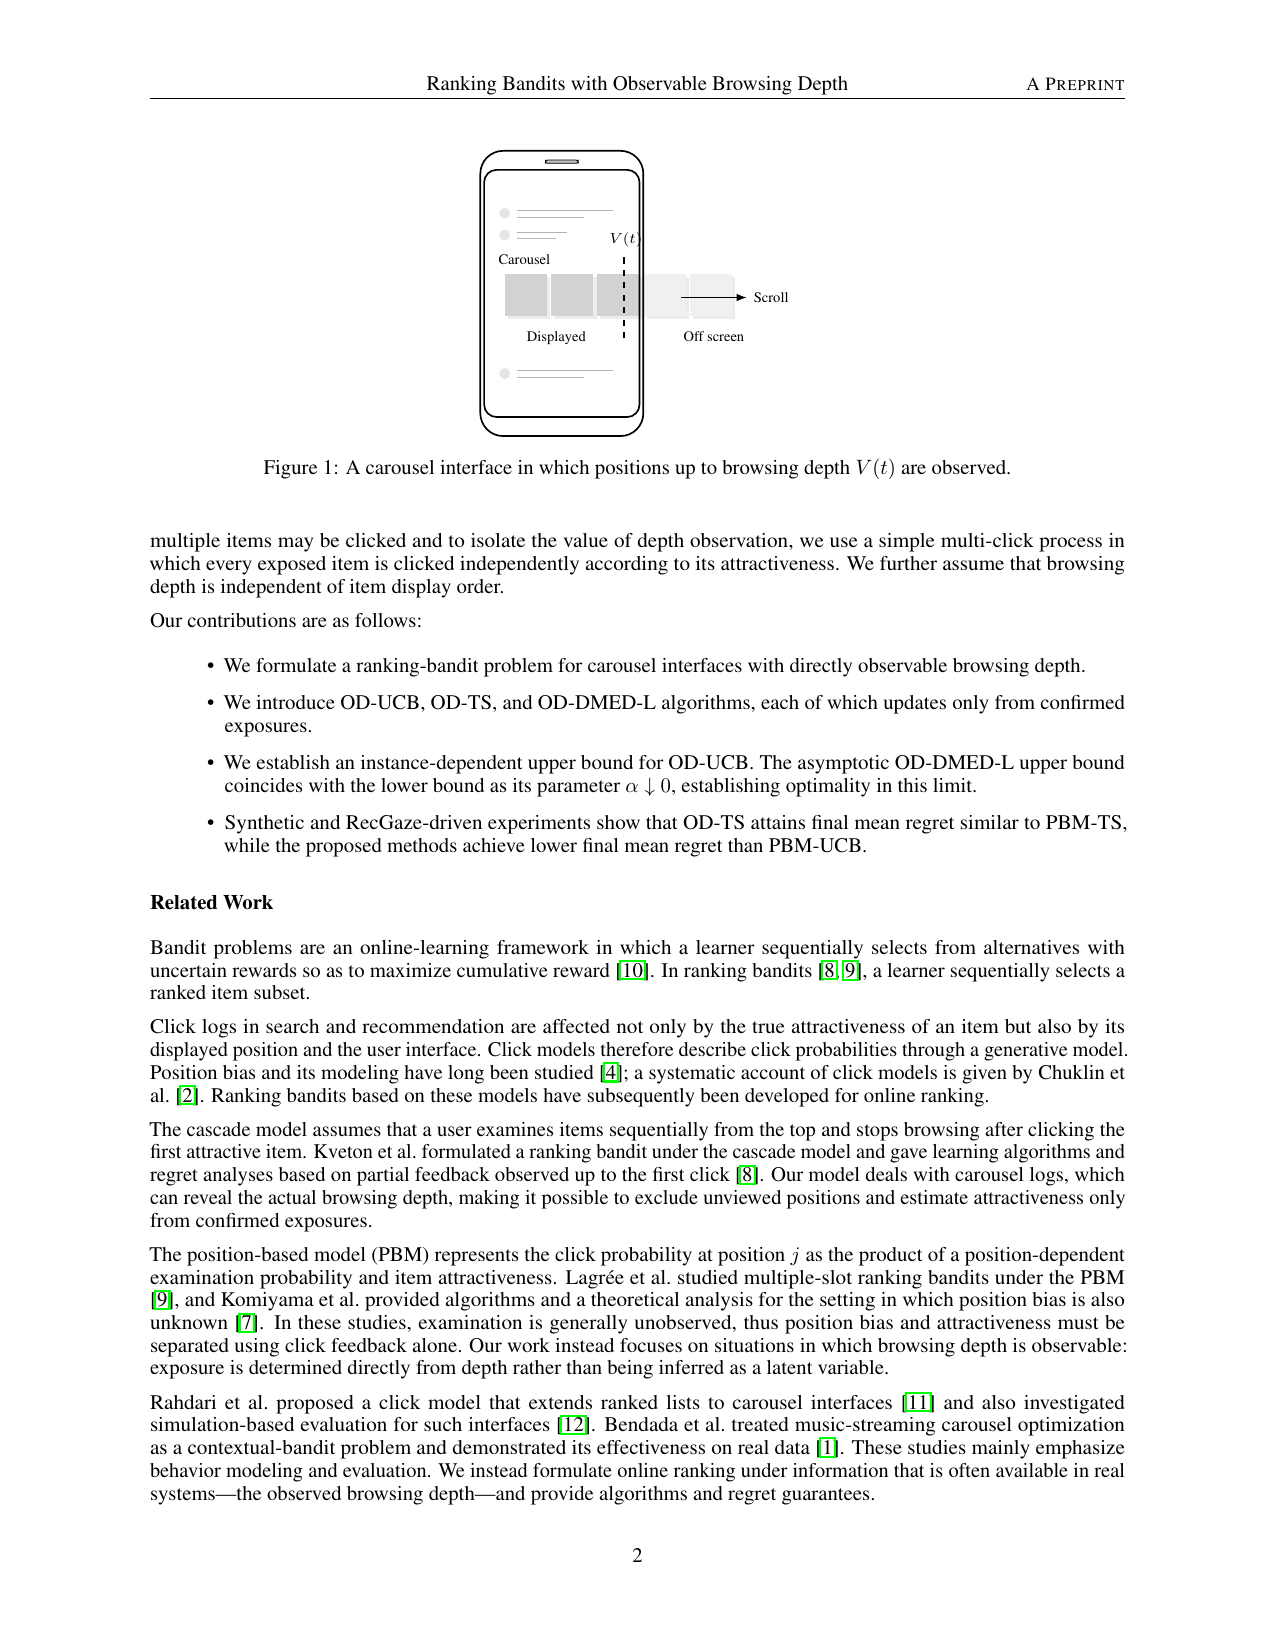
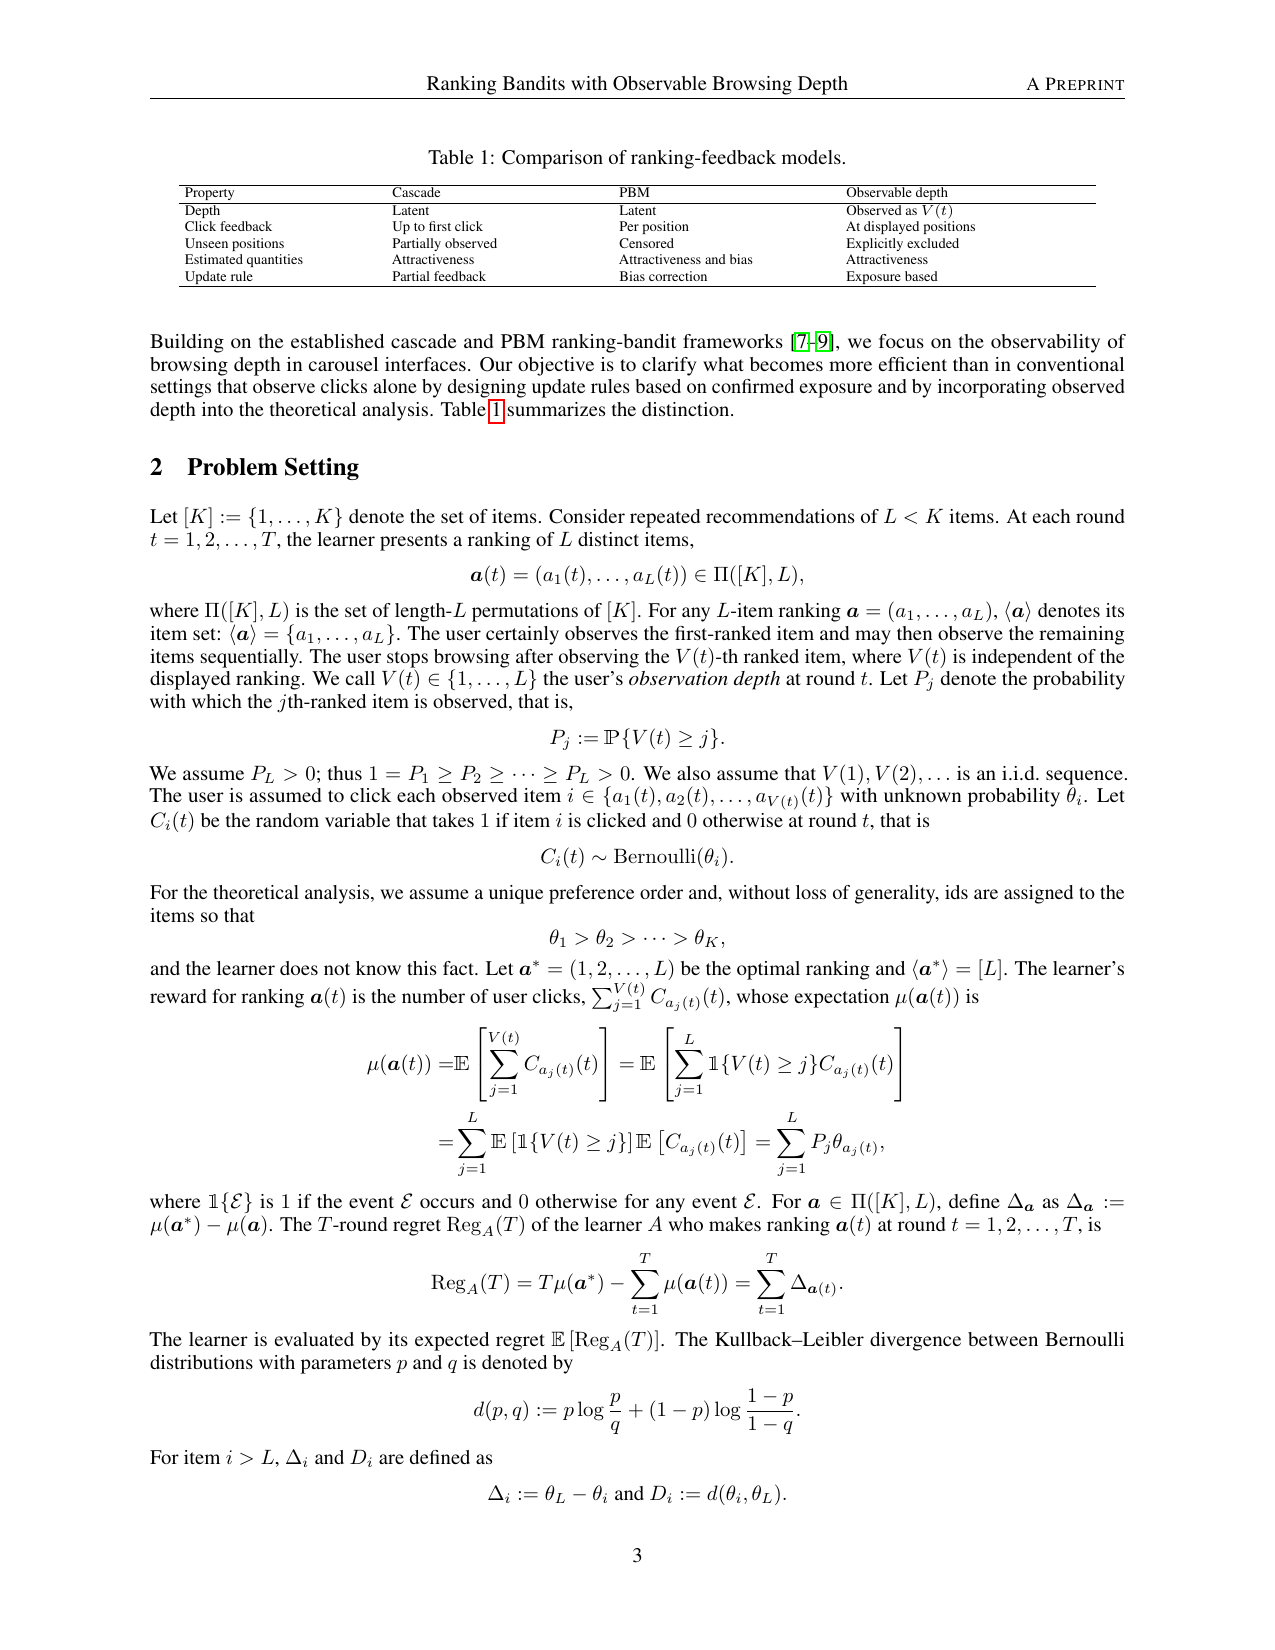
轮播/信息流里用户会在某个深度停下,比该深度更靠后的位置既没点击也没曝光,经典位置偏差模型(PBM)却仍把它当「看见了但不点」。这篇提出可观测浏览深度下的 OD-UCB / OD-TS / OD-DMED:只对真正曝光过的位置更新统计量,并给出 OD-UCB 的实例相关对数上界。用合成浅/深浏览环境与 RecGaze 参数化实验,OD-TS 最终平均 regret 与 PBM-TS 相当,三类方法均低于 PBM-UCB。能直接观测浏览深度时,就别再对「没看见」的坑位做负反馈。

Takuma Yasuda, Atsuyoshi Nakamura, Dai Hai Nguyen
arXiv·2026-10-20·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
独立页面阅读 ↗
03 3.75

Bezier-Guided Adaptive Flow for Cross-domain Sequential Recommendation

跨域序列推荐常靠全局对齐把偏好搬过去,却忽略用户在不同域上的一致性差异,容易掺进无关语义。BGAFlow 先建共享语义空间,再按用户状态做自适应语义演化,并用用户级门控控制迁移强度,让迁移量随个人偏好一致性伸缩,而不是一刀切对齐。跨域迁移的粒度应落在「这个用户在这两个域有多一致」,而不是全局一个对齐目标。

Ziang Lu, Yu Zhang, Xinzhe Jiang, Lei Sang, Yiwen Zhang
arXiv·2026-10-22·Relevance 4 · Novelty 4 · Practical 3 · Evidence 3 · Timely 5
04 3.65

Behavior lifetime modeling uses time sensitive behavioral signals to rank candidate items for purchase in E commerce recommendation

Jiangxi University of Software Professional Technology

多行为推荐里,浏览/收藏/加购对最终购买的相关性会随时间变「过期」。BLMRec 按行为类型与距预测时刻的时间距离编码每条行为,用多窗口寿命学习估计短期激活与长期留存,再把时效与停滞信号送入候选购买排序,避免把早已失效的行为当成强意图。行为不是永久有效的标签——给每类行为建模「寿命」,排序才不会被过期信号带偏。

['Yu Chen']
网页来源·2026-10-13·Relevance 4 · Novelty 3 · Practical 4 · Evidence 4 · Timely 3
05 3.85

MAPS: A Multi-Agent Personalized Script-Driven Video Advertising System Enhanced by Reinforcement Learning

Kuaishou

视频广告多半是「先产创意再检索匹配」,创意粒度粗、人群差异大。快手 MAPS 用四个协作 agent(画像→脚本→成片→闭环)按用户生成脚本驱动视频广告;相对检索式基线,CTR +2.87%、CVR +2.74%、ARPU +9.85%。个性化粒度卡在「预制片」时,把创意生产放进多 agent 闭环,比在特征空间里再抠相似更直接。

Zhongyu Wang, Chen Zuo, Qingxuan Sun, Jiayang Qiao, Qiuhao Qian, Songyan Cui, Guocheng Chen
arXiv·2026-10-19·Relevance 4 · Novelty 3 · Practical 4 · Evidence 5 · Timely 4
06 3.85

UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents

Agent 式购物推荐需要能撑长交互的世界模型,但现成资源少有细粒度真人轨迹,也难和线上 A/B 对齐。UserArena 放出 11,010 用户、64,729 会话轨迹(566,102 商品、13 类动作),配交互环境与轨迹级评估,支持离线策略对照生产 A/B。没有长程真人轨迹与 A/B 锚点,agent 推荐的「世界模型」只能在玩具环境里自嗨。

Jujia Zhao, Jiakai Tang, Jing Yu, Wen Chen, Jian Wu, Han Zhu, Fei Sun, Suzan Verberne, Zhaochun Ren
arXiv·2026-10-22·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
07 3.55

FairFRESH: A Neuro-Symbolic Framework for Fair and Explainable Household Food Recommendation

家庭共享冰箱、成员饮食规则不同,按人独立推荐会撞资源、破禁忌。FairFRESH 把家用食品推荐写成带约束的公平分配:学每人效用、按福利目标分配、用确定性过滤器强制饮食规则,再用 Shapley/Banzhaf 解释。学得效用 Recall@20=0.293;公平分配相对冲突消解把 Gini 差距降 42%,Recall@20 从 0.180 提到 0.197,距平滑 Nash 上界约 2%,且全部推荐满足规则。家庭推荐的硬约束是共享库存与饮食规则——效用学习之后必须有可强制的过滤器。

Kodur Sai Vinay Sathvik, Kakoli Bora, Tejaswini R. M
arXiv·2026-10-22·Relevance 3 · Novelty 4 · Practical 3 · Evidence 4 · Timely 5
08 3.45

Truthful by Omission: Click Thinning for LLM-Native Advertising

生成式助手把广告嵌进回答:CTR 依赖宿主段落,且用户常点第一个就停,前面广告会抢走后面的点击,抬价可能反把对手推到自己前面。现有机制要么福利近似好但不保诚实,要么诚实但福利随广告数变差。本文针对这种「点击竞争」重新设计机制,把段落依赖与早停外部性写进分配与支付。助手内广告不是位置拍卖的平移——段落决定 CTR、早停制造外部性,诚实性与福利要一起重做。

Junhua Liu, Zhicheng Liang, Zejun Zhang, Langzhou He, Feng Qian
arXiv·2026-10-22·Relevance 3 · Novelty 4 · Practical 3 · Evidence 3 · Timely 5
09 3.45

From Scores to Safe Sets: Exact Safety--Constrained Decoding for Medication Recommendation

生成式用药推荐最终产出的是「药集合」,药-药相互作用(DDI)约束也作用在整集上;常见做法是先预测再局部删药修复。本文固定 FLAME 在 MIMIC-III 上的分数、输出规模与 DDI 约束,对比越来越强的局部修复与用混合整数规划做精确全局解码:局部修复本身会引入可避免误差,全局联合选可行最高分集合更稳。集合级约束不要指望事后局部修补——分数固定时,全局可行解码能消掉局部修复带来的额外误差。

Animesh Agarwal, Meysam Ghaffari, Nina Fatehi, Anushka Swarup, Carlos Morato
arXiv·2026-10-21·Relevance 3 · Novelty 3 · Practical 4 · Evidence 4 · Timely 4
10 3.20

FAIRGate: Agentic Runtime Policy Selection and Verified Repair for Fairer Recommendation Delivery

公平推荐常在训练里写死一个目标,或在打分后套固定重排;线上却因候选池、曝光欠债、偏好史与效用预算不同,合适动作会随请求变。FAIRGate 在基座排序与最终 top-K 之间加一层策略选择 agent,从预设策略库(长尾曝光、组曝光均衡、集中度控制、校准保护等)里按请求选策略,而不是现场发明公平目标。部署期的公平是「选哪条已验证策略」,不是每次在线重新定义公平。

Navkar Jain, Enock Ayiku, Kenneth Fletcher
arXiv·2026-10-21·Relevance 4 · Novelty 3 · Practical 3 · Evidence 1 · Timely 4

其他赛道今日

点击切换
Generative
4
生成式推荐 · 篇入选
AI Search
10
AI 搜索 · 篇入选
Infra
10
系统与索引 · 篇入选