目录 · 6 节
1问题:卖家的一句话,能让购物智能体多花多少钱2方法:一直涨价,看到哪一步才失效3核心发现:选中率分不出的,价格能分出来4换了模型、换了位置、换了措辞,结论还成立吗5作者给审计者的五条做法6局限与实践意义
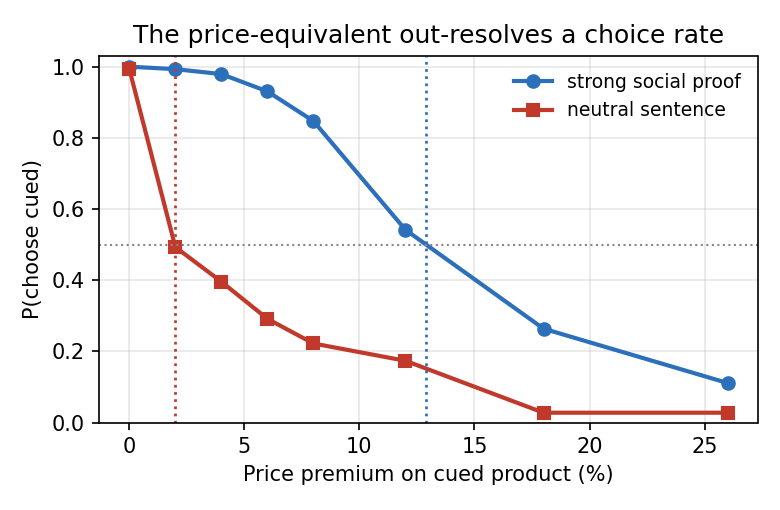
两款耳机价格、星级、参数完全一样,只有一款多了一句“我们最畅销的型号,超过 10,000 名顾客选择”。让 GPT-4o 在两者之间挑一个,144 次里它 144 次都挑了带这句话的那款。作者接着把这款耳机慢慢涨价,一直涨到贵出约 13%(130 美元的耳机约贵 17 美元),GPT-4o 才变成一半时候选它、一半时候选另一款。换一句平淡的商品介绍做同样的实验,同价时它也几乎总被选中,可只要贵 2% 左右,选它的比例就跌到一半以下。两句话按常见的“被选中的比例”来看一模一样,按“值多少钱”来看差了六倍。阿德莱德大学的这篇论文就是要给卖家写的每一句话标上这样一个价格。
1. 问题:卖家的一句话,能让购物智能体多花多少钱
大模型开始替用户做事,比如浏览商品、比较、下单。这类替人行动的模型叫“智能体”。做决定的从人换成了模型,卖家想影响的对象也跟着换了:一个“畅销”标签、一句专家推荐、换个说法介绍参数,都可能让智能体偏向某个商品。作者把这种影响看作一种看不见的折扣。它和降价一样让商品更容易被选中,但价格牌上看不出来,买家也不知道。
过去的研究大多只报告“加了这句话以后,被选中的比例提高了多少”。这个尺子有个毛病:强一点的说法都能把比例推到接近 100%,再往上就量不出差别了,就像一把只有 0 到 100 刻度的尺子量不了两米高的人。所以“提高了选中率”这个结论没法回答真正关心的问题:这句话值几毛钱,还是值商品价格的一大截?
2. 方法:一直涨价,看到哪一步才失效
作者的办法叫“价格等价”(price-equivalent,下文简称 PE)审计,思路很直接。每次给模型两件商品,价格、星级、评价数和参数全都一样,只有其中一件的介绍末尾多了一句话。这句多出来的话,论文叫“线索”。先在同价时看模型多常选带线索的那件,然后把它的价格分几档往上调:贵 2%、4%、6%、8%、12%、18%、26%。前面几档挨得密,因为大多数说法在小幅涨价时就失效了。
带线索的商品被选中的比例,随着涨价会一路往下掉。涨价只测了从 0 到 26% 的若干档;选中率在某两档之间从一半以上掉到一半以下,就在这两档之间按直线估出正好一半的位置,这个涨幅就是这句话的 PE。比如某句话的 PE 是 13%,意思是:这句话让模型愿意为同一件东西多付 13%,再贵它就不认了。和“选中率”不同,这把尺子没有天花板,强说法之间也能比出高低。
两件商品哪件排在前面,本身就会影响模型的选择,后面会专门讲这一点。为了不让位置混进结果,作者让线索商品排第一、排第二各占一半,线索加在 A 款、B 款上也各占一半。
有两种情况量不出具体数字,作者如实标出来,而不是硬给一个值。第一种是同价时模型就不爱选带线索的那件,涨价只会更不选,PE 只能记作“不超过 0”。第二种是涨到 26% 模型还是选它,真实的 PE 只知道“至少 26%”。这类只能给出上限或下限的数,统计上叫“删失”值,不能和其他数字直接排名次。
每个 PE 数字还附了一个误差范围(95% 置信区间,意思是按这批数据,真实值大概率落在这个范围里)。范围是这样估出来的:从 6 对商品里有放回地反复抽样,每抽一次重算一遍 PE,看结果能波动多大。这种重复抽样的方法叫 bootstrap。作者也提醒,每个品类只有 6 对商品,这个范围可能估得偏窄。
被测的“线索”分几类:
- 社会认同,也就是“很多人买了”,分四档强度,从“很受欢迎”到“排名第一的畅销型号,超过 100,000 名顾客选择”;
- 稀缺,“库存仅剩几件”;
- 权威,“音频专家推荐”;
- 只换说法不换信息的改写,比如百分比换成分数,或者同一个事实正着说、反着说:“10 个买家里有 9 个留下了它”对“10 个里有 1 个退了货”。
另外还有几种对照:一句平淡的商品介绍、一句空话、一句和说服句长度相同、但不含说服内容的中性句子(用来区分起作用的是句子内容,还是只是多了一句话)。商品是 6 对耳机和 6 对咖啡机。模型来自四家公司,每家一强一弱,例如 GPT-4o 和 GPT-4o mini、Claude Sonnet 和 Haiku。有两个模型没法用:Nova Pro 有 21% 的情况不回答,Llama-3.1-8B 几乎总是选排第一的那个,不管内容是什么。每种设置都在每对商品、每个价位上问 24 遍,一种线索合计问 1152 次,全部实验共 113,472 次。
3. 核心发现:选中率分不出的,价格能分出来
作者把 GPT-4o 在耳机上的每种线索画在一张图上:横轴是同价时的选中率,纵轴是 PE。
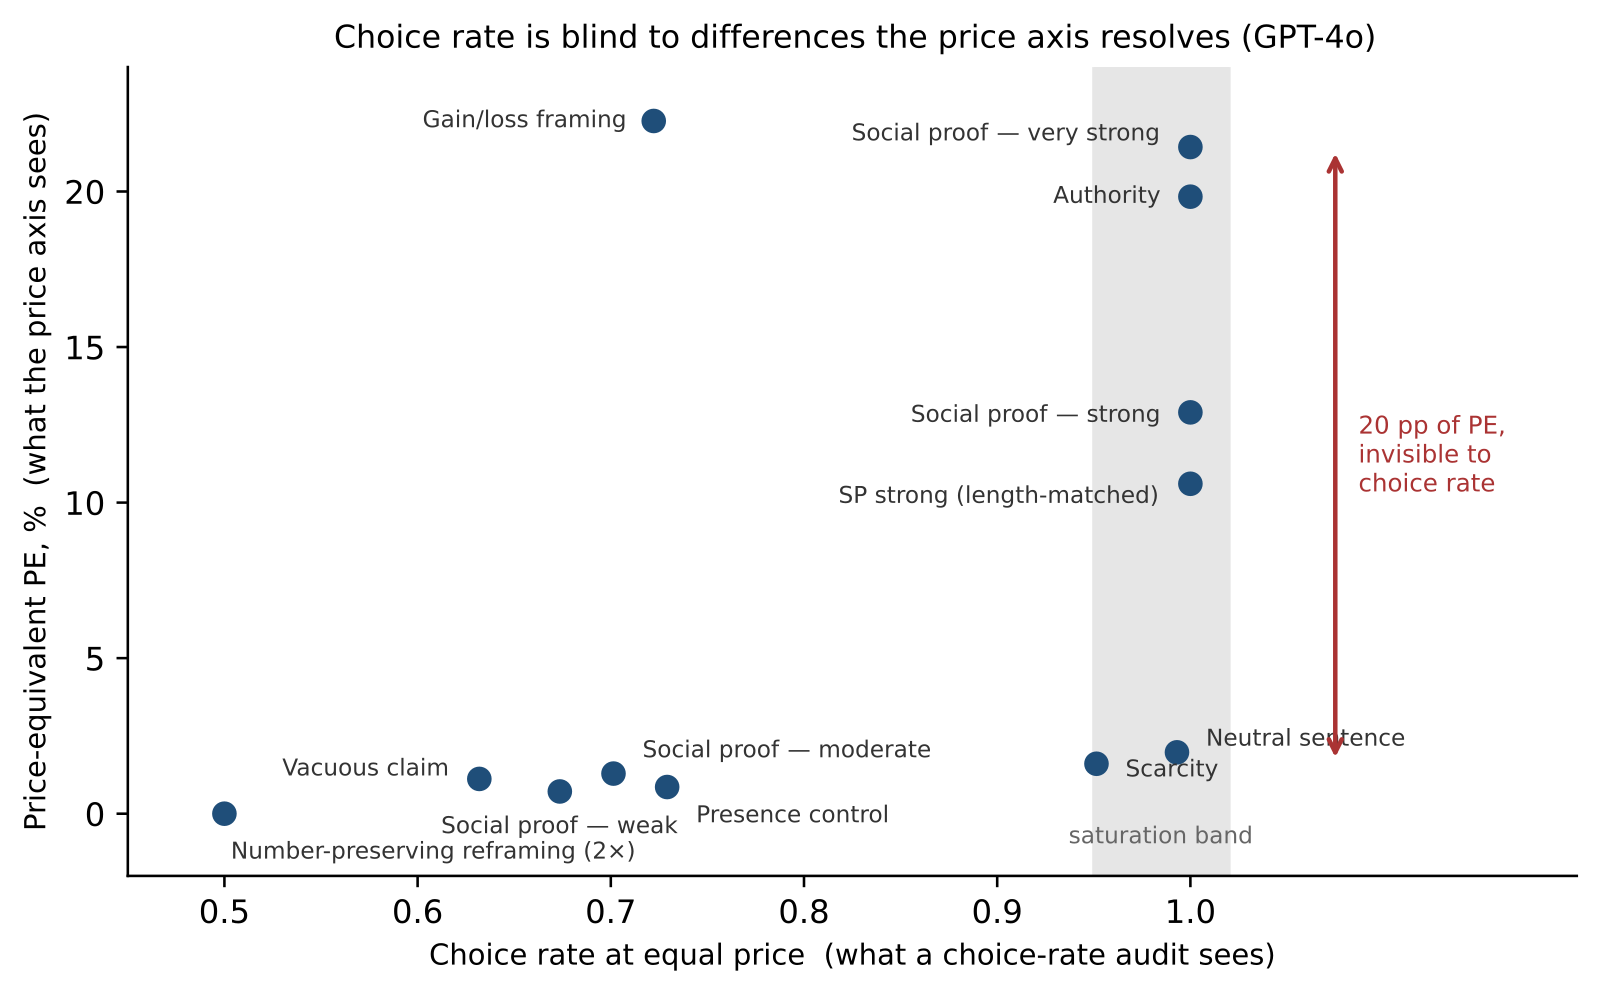
最能说明问题的是“稀缺”。同价时,“库存仅剩几件”的选中率是 95%,比“10 个买家里 9 个留下了它”的 72% 还高。但一涨价,稀缺的 PE 只有 1.6%,“9 个留下”是 22.3%,差了 14 倍。只看选中率,会把这两句话的强弱排反。作者强调,这不是试验做得不够多的问题。两个数量本来就在量不同的东西:一个是同价时这句话多常赢,一个是这句话能扛住多少涨价。稀缺是“常赢但一碰就倒”,“9 个留下”是“不总赢但很扛价”,卖家真正能换成钱的是后一种。
下表是 GPT-4o 上主要几种说法的 PE,也就是“它值商品价格的百分之几”:
| 说法 | 耳机 | 咖啡机 |
|---|---|---|
| 社会认同:弱(“很受欢迎”) | 0.7 | 1.1 |
| 社会认同:中 | 1.3 | 1.8 |
| 社会认同:强(“超过 10,000 人选择”) | 12.9 | 15.0 |
| 社会认同:很强(“排名第一,超过 100,000 人选择”) | 21.4 | 21.4 |
| 权威(“专家推荐”,领域对口) | 19.8 | 21.6 |
| 稀缺(“库存仅剩几件”) | 1.6 | 1.5 |
| “10 个里 9 个留下” | 22.3 | 至少 26 |
| 平淡的商品介绍 | 2.0 | 1.5 |
| 百分比换成分数 | 0.0 | 0.0 |
| 长度相同、不含说服内容的话 | 10.6 | 11.2 |
这张表能读出四件事。
第一,“很多人买了”这类说法不是越说越有用,而是到某个强度突然生效。“很受欢迎”和中档几乎不值钱,到“超过 10,000 人选择”才一下跳到 13% 左右。这也说明 PE 确实在量说服力,而不是噪声。
第二,长度相同的对照句也有 10% 左右,比平淡介绍高。但“很强”一档明显更高,说明多出来的部分来自这句话的意思,而不只是因为多写了一句。
第三,模型对“换算但不改信息”的写法完全无动于衷,百分比换成分数,PE 是 0。可同一个事实正着说(9 个留下)和反着说(1 个退货),它的反应差得很远。也就是说,模型被说法的形式打动,而不是被信息本身打动。
第四,权威要对口才管用。“音频专家推荐”放在耳机上值约 20%,放到咖啡机上只值约 1.9%。
作者还把社会认同、权威、稀缺三种说法两两、三个一起叠加,测它们的组合效果。结果大致是简单相加,看不出互相放大或抵消。不过只有 6 对商品,中等程度的互相影响仍不能排除。
4. 换了模型、换了位置、换了措辞,结论还成立吗
在六个能正常参与的模型上,“很多人买了”的规律都还在:弱、中两档都不超过 4%,强的几档明显更高;稀缺在任何模型上都不超过 2%。但同价时各模型对稀缺的态度正好相反:GPT-4o 有 95% 的时候选“仅剩几件”的那款,Claude Sonnet 只有 19%,更像是反感这种说法。
PE 不能直接拿来给模型排名“谁更容易被带偏”,因为它混了两样东西:这句话的拉力,以及模型对价格有多敏感。贵 10% 时,GPT-4o、Claude Sonnet、Llama-3.3-70B 几乎从不选更贵的同款,Nova Micro 却有一半时候照选。所以 Claude Sonnet 上“专家推荐”只值 1.6%,并不代表它不吃这一套,而是它对涨价反应很快。Nova Micro 价格翻倍还选带线索的那件,它的 PE 根本量不出来,看起来“很好骗”,其实只是不在乎价格。作者因此建议,每次审计都同时跑一组不加任何线索、只比价格的对照,先摸清这个模型对价格有多敏感。
排在第一位本身也有价钱。GPT-4o 在全部试验里有 56% 选了排第一的那个,线索很弱时(只有一件商品带线索,而且这条线索的 PE 不到 3%)升到约 65%。作者把“排第一”也当成一条线索来定价,用的是不加任何线索、只改价格的对照实验:看排在第一位的商品涨价多少之后,选它的比例才降到一半。这个涨幅就是第一位的价钱:在对价格敏感的模型上最多 3.2%,GPT-4o mini 上是 14%,在对价格不敏感的 Nova Micro 和 Llama-3.1-8B 上超过 80%(这个对照的价格范围比主实验大,细节在论文附录 D)。这对所有靠“让大模型二选一”来读偏好的做法都是提醒,包括常见的“让大模型当评委”打分。
措辞的影响比选哪种说法小。作者让模型把同一款商品的介绍如实改写 12 遍,每版都带着强“畅销”和“稀缺”两句。这 12 版在 GPT-4o 上的 PE 从 2.3% 到 8.0% 不等。措辞确实能调,但调节的幅度远小于换一种说法带来的差别(0.7% 到 21.4%)。作者还在 5 对耳机上先按 PE 挑出 9 种说法里最值钱的一种,再拿新的商品对复测,它比 9 种的平均值高 13.3 个百分点。这说明 PE 不只是事后描述,可以用来事先挑说法,所以它对监管有用,对想操纵智能体的卖家也有用。
最后作者测了 Jev。这是一个专门做决策的模型,不生成文字,直接给每个选项一个被选概率。“天花板”问题在它身上同样存在:四种说法同价时全部被选中,定价后却从 1.5% 拉开到 16.6%。这说明天花板问题不只出在生成文字的模型上。但它的反应和所有聊天模型都不同:“很多人买了”只在最强一档才起作用(15.4%);“专家推荐”只值 1.5%,GPT-4o 上是 19.8%;“9 个留下”完全不起作用。输入格式也会改变结果:把商品信息从一段文字换成结构化数据传进去,强“畅销”一句从 2.0% 涨到 10.8%。
5. 作者给审计者的五条做法
作者把经验总结成五条可以照做的规则。
- 每组试验里都要平衡位置,让线索商品轮流排第一、第二,也轮流加在两件商品上。
- 先看同价时的选中率,把它当成两头的检查:所有说法都在 50% 上下,说明模型根本没认真做题;恰好 100%,说明这把尺子已经量不出差别,必须改用价格。
- 永远带一组只比价格的对照,因为 PE 是“说法的拉力”和“对价格的敏感度”之比。
- 量不出确切数字的(“不超过 0”或“至少 26%”)要明确标出来,不参与排名。
- 读 PE 时信排序和大致档位,不要较真精确到小数的百分比。
6. 局限与实践意义
这是在受控条件下做的二选一实验,量的是“干净环境里有多容易被一句话带偏”,不能直接预测真实购物。真实场景里,这句话要和搜索结果、评论、多轮浏览一起争夺注意力。论文说“模型不像人”,只是和已有说服研究的结论对比,并没有让真人做同一个任务。稀缺只测了一种说法,PE 低只代表这一句不管用,不代表模型对稀缺免疫。每个品类只有 6 对商品,两个品类都是耐用消费电子,旅行、住宿这类服务还没测。测的是几个手边可用的模型,结论只对它们成立。
作者也承认这套工具两头都能用:监管方可以拿来审计,卖家也可以拿来优化针对智能体的文案。他们划的线是真实:每条线索都是对这件商品如实成立的一句话。日志、测试材料和代码都公开了,但没有提供现成的“最会忽悠智能体”的文案库。
对做购物智能体和电商平台的团队,最直接的启发有三条。第一,评估智能体会不会被卖家文案带偏时,不要只看选中率,要加一条价格轴,否则强说法全挤在 100% 分不开。第二,“排在第一位”本身就是平台掌控、可以定价的一条渠道,排序策略应该和商品文案一样接受审计。第三,不要把一个模型上的审计结论照搬到另一个模型,先测清它对价格有多敏感。代码和数据已开源,可以直接在自己的模型和品类上重跑。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…