
用大模型做 listwise 重排效果好,但要逐个生成文档编号,很慢。只看第一个 token 上各文档编号的分数、一次排完要快得多,难点是怎么把大模型老师的排序能力教给这种学生。DecisionRank 让学生先按自己的分数排出列表,老师在每一位上看:前面几位已经定了,剩下的文档里谁该排下一位,给出一个概率分布;学生在剩下文档上的分数也换算成分布去贴近它。结果 1.7B 的学生在 TREC DL 上超过了 27B 的老师(63.89 对 62.97,表 3、表 5);8B 学生在 TREC DL 上比同尺寸的生成式 listwise 重排 DirectRank-8B 更准,还快 24.5 倍(表 1、§3.2.2)。
做搜索精排、正在为 LLM 重排的延迟发愁的团队值得读。它真正新的地方是一种训练信号:让老师对“学生自己排出来的顺序”逐位打分,而这个信号直接落在推理时用的那组分数上。不过要看清两点:已有的离线蒸馏单独用也能拿到差不多的提升,新信号叠加在离线蒸馏之上只再加 0.5–0.9 分;在医学推理检索基准 R2MED 上,学生比老师低 3 分多,在需要推理的检索基准 BRIGHT 上也小幅落后。
先说清楚:什么是“只看第一个 token”的重排
生成式 listwise 重排(RankGPT 一类)的做法是把查询和 100 篇候选一起喂给模型,让它按相关性从高到低一个编号一个编号地写出排序。排 100 篇就要解码几百个 token,还常常要滑窗多次调用。
单 token 重排方法 FIRST(2024)换了一种读法,本文的学生沿用它:每篇候选分配一个两字母编号,每个编号在词表里正好是一个 token,共 100 个,模型读完全部候选后,只做一次前向,看输出第一个位置上这 100 个编号 token 各自的 logit。logit 越高,说明模型越想把这篇排第一;把 100 个分数从高到低一排,就是完整排序(§2.1,式 1)。论文把这种直接输出分数、不生成文本的模型叫 decision model。这种读法不是本文提出的,本文新的是怎么训练这组分数。
这样做快,但有个训练上的错位。老师是生成式模型,它的排序偏好体现在“已经排了 A、B,下一位该选谁”这样一连串的条件选择里;学生却只有第一个位置的一组分数。一个示意:
| 示意 | 老师怎么表达偏好 | 学生手里有什么 |
|---|---|---|
| 第 1 位 | 在 100 篇里选 A | 100 个分数,A 最高 |
| 第 2 位 | A 已选定,在剩下 99 篇里选 C | 还是那 100 个分数,只是去掉 A |
| 第 3 位 | A、C 已选定,在剩下 98 篇里选 B | 还是那 100 个分数,去掉 A、C |
只学老师第一位的分布,后面的条件选择就浪费了;让学生也学着逐个生成编号,训练方式又和推理时只看第一位分数对不上(§1)。
核心机制:让老师给学生自己的排序逐位打分
DecisionRank 的训练把论文提出的新信号和一个已有的离线信号相加,两者作用在同一组第一位分数上(图 2)。
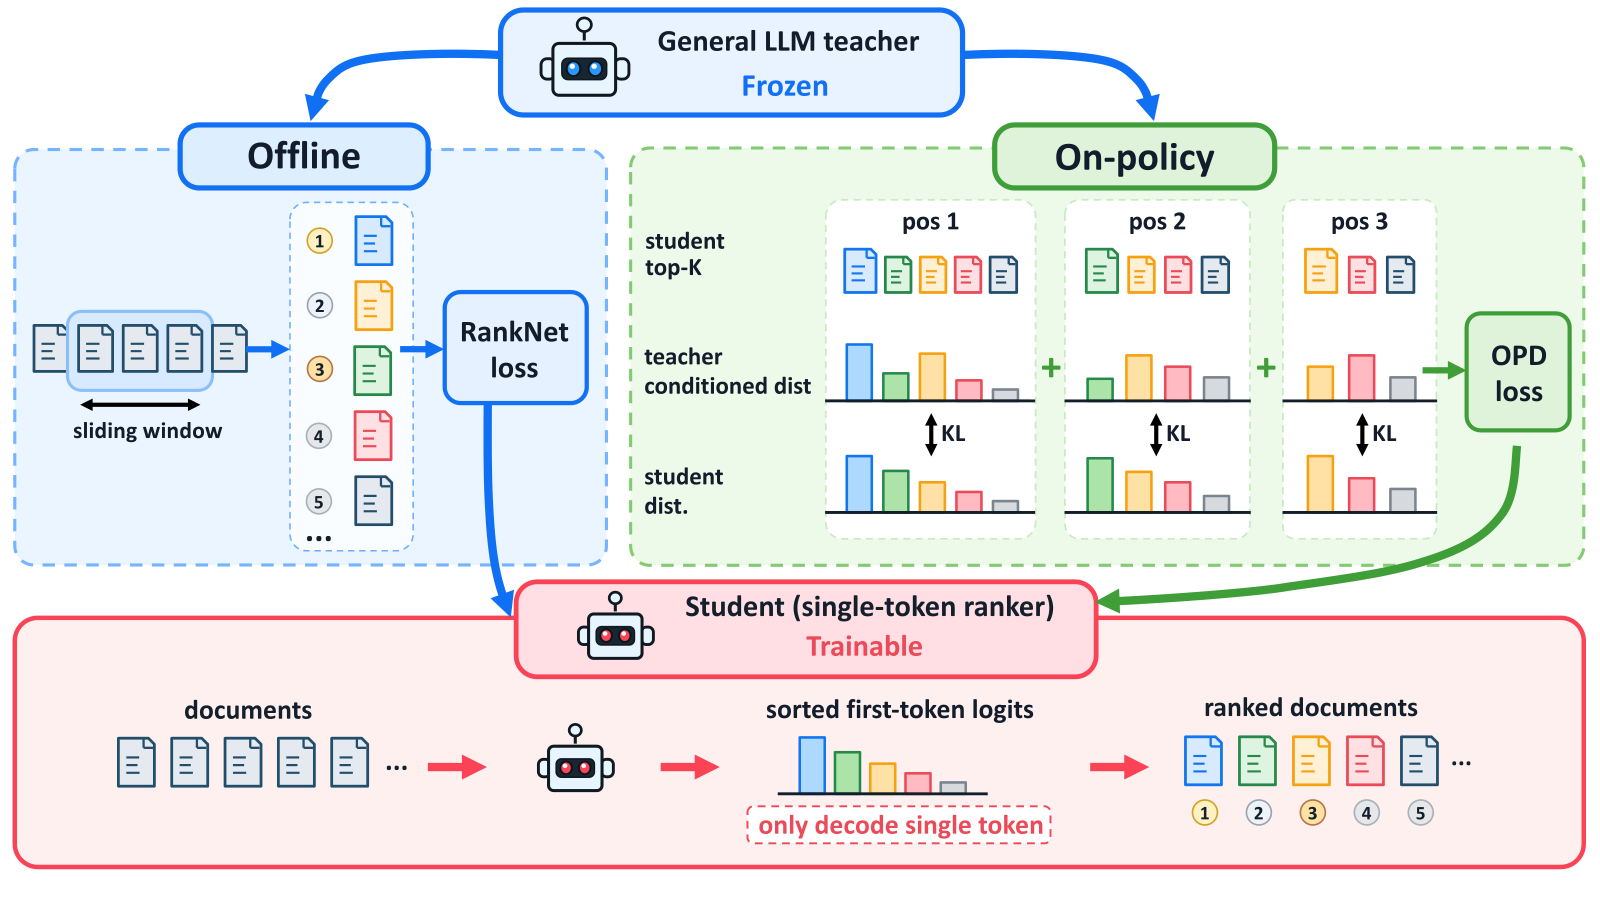
新信号是论文的贡献,叫 item-space OPD(OPD 即 on-policy distillation:用学生自己当前的输出去请老师打分,再按老师的反馈训练),item-space 指对齐发生在候选文档这一层。每一步训练按下面四步走(§2.2):
- 学生用当前分数排序,取前 K=20 篇,得到自己的列表,比如 A、C、B、……
- 把这 20 篇和查询交给老师,老师用自己的数字编号,学生的列表也换成这些编号,当作老师“已经写出的答案”塞进去(teacher forcing)。老师只做一次前向,就能读出每一位的条件分布:第 2 位时 A 已定,剩下 19 篇里该选谁;第 3 位时 A、C 已定,剩下 18 篇里该选谁……在第 t 位,老师对每篇剩下的文档给出一个大于 0 的条件分数 a,再只在剩下的文档上除以总和,归一化成分布(式 3)。两边的编号不同,但都指向同一批文档,所以比较是在文档层面而不是 token 层面做的(§2.1)。复现时要注意一点:论文没有写出老师的数字编号占多个 token 时,a 是怎样从 token 概率算出来的,这一步需要自己补。
- 学生这边不需要再生成任何东西:把同一组第一位分数只在剩下的文档上重新做一次 softmax,就是它在这一位的选择分布(式 2)。
- 两个分布都落在同样那几篇剩余文档上,逐位算反向 KL,平均第 2 到第 19 位(式 4、5),与下面的 RankNet 相加,权重 λ=0.1(附录 A)。
另一部分是已有的离线排序监督,沿用 FIRST 的做法:训练前,老师先用生成式排序把每个查询的候选完整排好一遍,得到一份固定的排序;训练时用 RankNet 让学生的分数遵守这份排序里的两两先后。每一对的权重是两篇文档名次折扣之差,折扣按 1/log2(1+名次) 算,和 nDCG 的折扣同式,所以学生会优先把头部排对(§2.3,式 6)。
打个比方:离线监督像拿一份标准答案让学生对照;item-space OPD 像老师坐在旁边看学生自己排的这一版,每一位都告诉他“在你已经定下的前几位之后,我会这样选”。学生排法变了,下一步老师看到的就是新的排法,反馈跟着变。
因为对齐的是“哪篇文档”,而不是词表里的 token,老师用数字编号、学生用字母编号也没关系,所以老师可以换成另一家族的 Gemma-4-31B,或基于 Qwen2.5 的 ReasonRank-32B(§2.1、§3.5)。训练数据只有 1 万条 MS MARCO 查询加 6 千条 ReasonEmbed 合成查询(§3.1.1)。
结果:又准又快,但新信号的增量不大
主结果在表 1。四个基准都是重排 100 篇候选,指标 nDCG@10×100:
| 方法 | TREC DL | BEIR | BRIGHT | R2MED |
|---|---|---|---|---|
| Qwen3.8-27B 老师(滑窗生成) | 62.97 | 57.26 | 37.42 | 46.66 |
| DirectRank-8B(生成式 listwise) | 62.92 | 55.78 | 35.87 | 44.50 |
| ERank-32B(pointwise) | 59.06 | 54.78 | 35.33 | 41.20 |
| DecisionRank-1.7B | 63.89 | 56.65 | 34.08 | 38.45 |
| DecisionRank-8B | 64.34 | 57.98 | 36.86 | 43.55 |
(老师一行取自表 3,只作参照;其余取自表 1。)通用检索上,最小的 1.7B 学生已经超过表 1 里所有对比的重排模型,包括 32B 的模型,说明一次前向的打分方式本身并不吃亏。需要推理的检索上情况不同:8B 学生在 BRIGHT 上是表 1 所有重排模型里最高的,但在 R2MED 上比 DirectRank-8B 低近 1 分,比老师低 3 分多,说明老师的推理能力没有完全传过来。
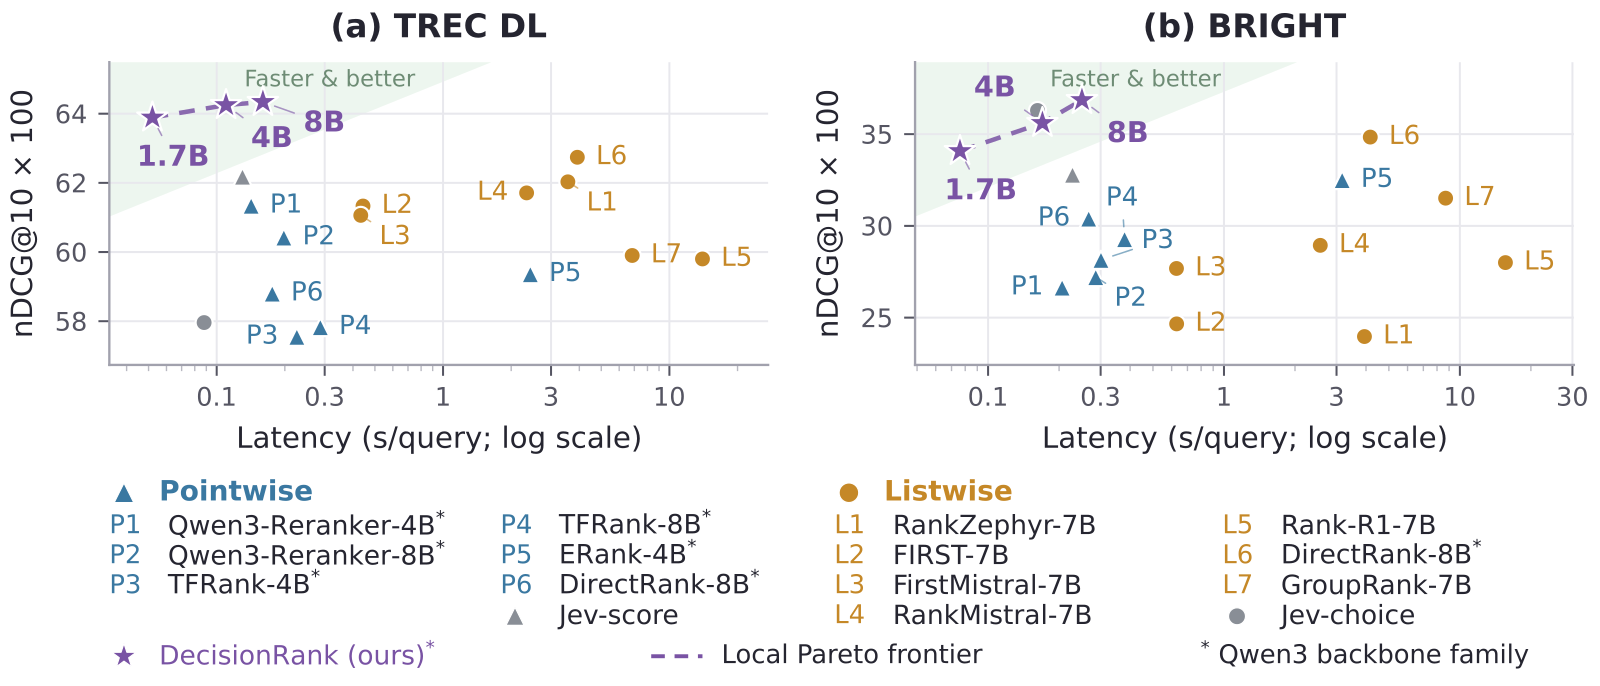
速度上,在 B200 上重排 100 篇候选,8B 学生比 DirectRank-8B 快 24.5 倍(TREC DL)和 16.7 倍(BRIGHT),三个学生构成了本地模型里“效果—延迟”的最优边界(图 3)。正文只给出倍数,绝对毫秒数要从图上读。
真正能说明 item-space OPD 价值的是表 2 和表 3。表 2 在同一个 RankNet 基础上加五种不同的老师信号,只有 item-space OPD 在四个基准上都涨:TREC DL +0.90、BEIR +0.59、BRIGHT +0.80、R2MED +0.49。其他四种各有各的毛病。只学老师第一位分布的 Offline KL 训的也是第一位分数,但只用到老师的第一个选择,TREC DL 反而掉 1.45。让学生学着逐个生成编号序列的两种做法(论文叫 AR SFT 和 AR OPD)同样保留第一位分数上的 RankNet,但额外加的监督是逐个生成编号的序列目标,和推理时只看第一位分数的用法对不上,在通用检索上都小幅下降。用 nDCG@10 当奖励的 Listwise GRPO 只给整份排序一个总分,不告诉学生哪一位选错了,在 R2MED 上掉 0.33。这四种做法在 BRIGHT 上都有提升,比如 Offline KL +0.79,但在两个推理型基准上都涨的只有 AR SFT 和 AR OPD;item-space OPD 的优势主要在于四个基准都稳定上涨。
表 3 把两种信号拆开看:8B 学生零样本只看第一位分数,TREC DL 只有 47.23;只用 RankNet 涨到 63.44,只用 item-space OPD 涨到 63.80,两者合用到 64.34。也就是说,两种信号单独用都能拿到十几分的大头,item-space OPD 单用在 TREC DL 和 BEIR 上还略好于 RankNet 单用,但在 BRIGHT 和 R2MED 上略差;合在一起四个基准都最好,说明两者互补。表 4 用三个随机种子复核,8B 学生在 TREC DL 上从 63.40±0.06 到 64.21±0.14,BRIGHT 从 36.08±0.11 到 36.85±0.08,增量比波动大得多,不是噪声。
还有一个附带结果关于置信度是否可信。论文分别用 Qwen3.8-27B 和 Gemma-4-31B 当老师,各训了一个 8B 学生。做法是取同一查询下相关性标注不同的两篇文档,把学生两个分数之差过一次 sigmoid,当作“这篇比那篇更相关”的概率。老师这边取它在第一位上给两篇文档编号的概率,用其中一篇所占的比例(这篇的概率除以两篇之和)当偏好概率,不用它的完整排序结果。再把这些概率和标注给出的真实先后对比,看概率高的判断是否真的更常对,偏差用校准误差 ECE 衡量(附录 C.2)。8B 学生在 TREC DL 和 BRIGHT 上的 ECE 都比各自的老师低(图 4),训练里并没有专门的校准目标。具体数值只在图中给出。
我认为它的局限
- 推理型检索仍落后老师。 R2MED 上 8B 学生 43.55 对老师 46.66,BRIGHT 上 36.86 对 37.42(表 3);换成 Gemma-4-31B 当老师,BRIGHT 上差得更多,37.28 对 39.94(表 5)。这说明“小模型学生超过大模型老师”主要出现在 TREC DL 这类通用检索上;推理型检索上只有一个例外,以 ReasonRank-32B 为老师时,4B 和 8B 学生在 BRIGHT 上超过了老师(表 5)。
- 一次前向要读完 100 篇。 编号池只有 100 个单 token,候选上限就是 100;为了装进上下文,TREC DL 每篇截到 128 token,其他基准截到 384 token(附录 A)。长文档场景要么截断更狠,要么先粗排,论文没有测截断带来的损失。
- 训练成本没报告。 item-space OPD 每一步都要让 27B–32B 的老师做一次前向,论文没给训练耗时或算力,也没给离线蒸馏和联合训练的成本对比,没法判断叠加 item-space OPD 带来的这不到 1 分值不值。
一个搜索团队可以怎么试
- 先做最便宜的一步:拿现有的 LLM 精排当老师,离线排好一批查询的候选,用 RankNet 训一个只看第一位分数的学生。按表 3,这一步单用就能拿到大部分提升,不需要训练时在线调用老师。
- 在同一批数据上加 item-space OPD:取学生前 20 名,交给老师做一次 teacher-forced 前向,逐位算反向 KL,λ 从 0.1 起调。记录每步训练额外多花的老师算力。
- 离线对比 nDCG@10 和单查询延迟,同时看两组:常规查询,以及需要推理的长尾查询。需要推理的长尾查询最可能出现学生落后老师。
- 检查候选篇数和截断长度:如果线上候选超过 100 或文档很长,先测截断到 128/384 token 的效果损失,再决定要不要上线。
结论
| 维度 | 判断 | 理由 |
|---|---|---|
| 新意 | 中高 | 把 on-policy 蒸馏改成在候选文档上逐位对齐,信号直接作用在推理用的分数上 |
| 证据 | 较扎实 | 五种训练目标同底对比、三种子复核、三种老师家族都成立 |
| 增量 | 不大 | 两种信号单用都有大幅提升,item-space OPD 叠加在离线蒸馏之上只再加 0.5–0.9 分 |
| 落地价值 | 高 | 一次前向排 100 篇,比 DirectRank-8B 快 16.7–24.5 倍 |
| 主要风险 | 推理型查询和长文档 | 两个推理基准仍落后老师,候选上限 100、需截断 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
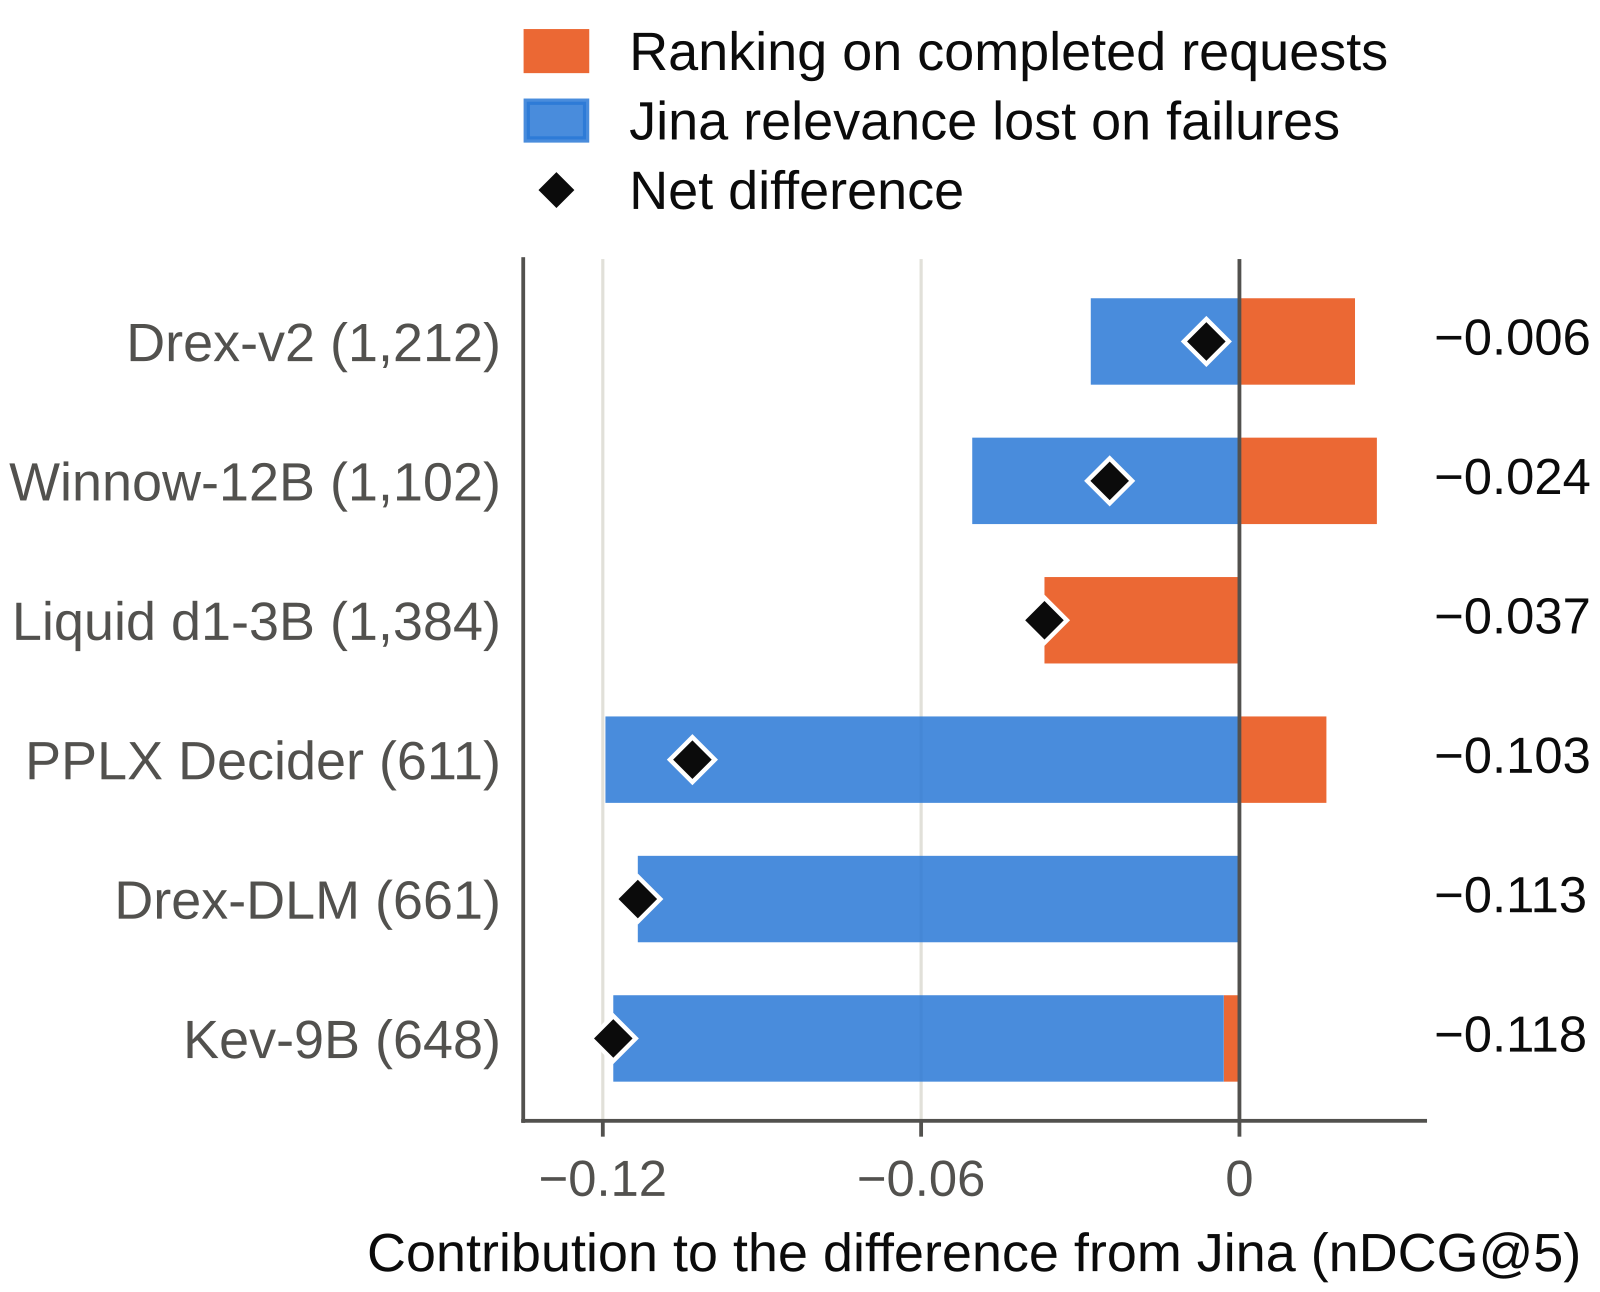 Retrieval · 2026-10-28Can System-1-Style Decision Models Replace Dedicated Rerankers in RAG? A Systems Evaluation想用大模型替换 RAG 里的 reranker,这篇的结论是先把现有 reranker 调好。作者在相同候选上比较 27B 决策模型 PPLX Decider 和 0.6B 的 Jina v3.5:默认设置下 PPLX 只有 44.1% 的请求能正常返回,只看成功请求它更好,把失败算进来就明显落后。把输入预算平均分给每篇候选、只保留开头部分后,它能追平 Jina;可 Jina 用同样的截断方式,延迟就降到 245 ms,显存也只有它的零头。
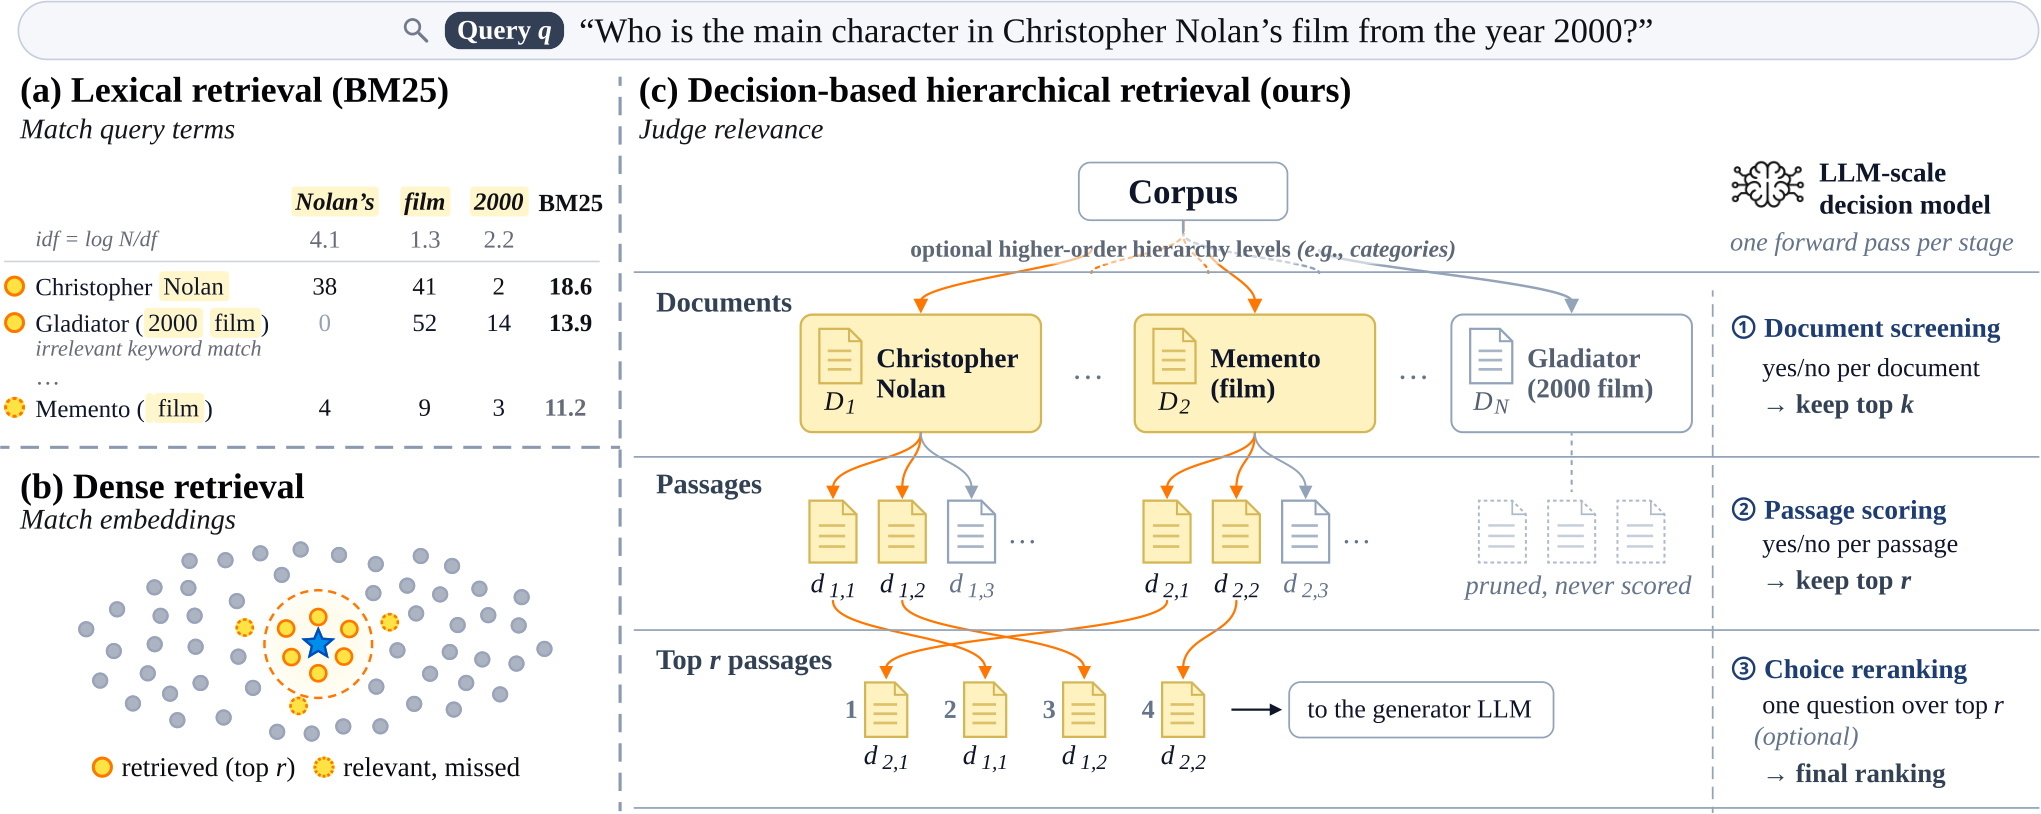 Retrieval · 2026-10-28Retriever-Free Retrieval: Navigating Documents with Decision Models多数 RAG 的召回仍靠 BM25 或向量相似度,召回漏掉的证据,生成模型再强也找不回来。DecisionRAG 不用召回模型,而是让一个决策模型像人逛图书馆一样,从主题到页面再到段落逐层往下找,每层的候选放进同一个上下文一起判。在 268 万个维基百科段落上,它的 Hit@1 比 Qwen3-Embedding-8B 召回加 reranker 高 17.4 个点,每个 query 检索约 1.7 秒。
 Retrieval · 2026-10-27System One models Are Not Better Rerankers拿新出的决策模型给检索结果重新排序,并不比专门微调的重排序模型好,这是帕绍大学这篇论文的结论。决策模型也叫 System One 模型,对一个问题直接给出校准过的“是”的概率,不生成文字,刚发布几周就被拿去做重排序。论文用同一个底座比较两种微调:决策微调用各类是非题训练模型给出准确的概率,重排序微调则只用 MS MARCO 的查询和段落训练模型判断段落是否相关。在六个不同大小的 Qwen 底座和十个 TREC DL、BEIR 数据集上,中小规模时重排序微调在每个底座上都赢,9B 及以下 nDCG@10 高出 5 到 29 分,到 27B 两者打平。这个规模以下,决策微调并不比直接问未微调的原模型更好。作者的结论很直白:需要重排序模型,就按重排序来微调。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…