目录 · 6 节
1一份 PDF 经过三步离线处理变成目录树2索引文件是地图,关系文件是连线3四个现成命令走完这道题4比最强基线高 2.9 和 4.3 个点,但不是每类题都赢5去掉 grep 掉得最多,DeepSeek 上删减变体都不如不建6推理快约 8 倍,建库的 token 另算
DocFS 没有给 agent 设计新的检索接口,它把一份长 PDF 改造成目录和文件,让 agent 用 ls、grep、read_file 这几个现成命令先定位、再顺着关系扩展、最后回原 PDF 核对。
这篇论文做的是长篇多模态文档问答:给 agent 一份几十页的 PDF 和一个问题,让它从里面找证据作答。论文用的两个评测集里,MMLongBench-Doc 是报告、手册一类文档,平均 47.5 页;FinRAGBench-V 是 301 篇财报,平均 76.1 页。证据可能是正文里的一句话,也可能是某张表里的一格、某张图里的一根柱子。
下面用一道题贯穿全文(示意,结构取自论文的一个真实案例):问一份 76 页的财报「公司 2019 年的股东权益是多少」。直觉上答案在资产负债表里,可这份资产负债表只列了最近两年,没有 2019 列;2019 年的数字在后面另一张股东权益表里。要答对,agent 得知道表在哪一章,知道表是截图还是文字,还要知道这两张表彼此相关。论文把这三样概括为章节层级、不同类型的内容元素和跨模态关联。
一类做法把文档编码成页面级视觉表示或扁平内容单元,再通过检索或迭代探索取证据。拿这道题检索「股东权益 2019」,排在最前的很可能是资产负债表那一页,因为整页都在讲股东权益。agent 读完发现没有 2019 列,只能换个说法再检索,这类表示里没有章节层级和跨模态关系可以顺着走。另一类方法先建内容树或多粒度索引,可这些结构多半只在检索时用上,最后交给 agent 的仍是检索结果;也有方法给结构配一套专用操作接口,每个系统各做一套。论文的概括是:结构有了,缺和结构对齐的工具。
DocFS 的回答是直接用文件系统:目录天然表达层级,ls、grep、read_file 天然就是和目录对齐的工具。用 Qwen3.5-Plus 做骨干时,它在两个评测集上的准确率是 71.6% 和 82.3%,比最强的免训练基线 DocLens 高 2.9 和 4.3 个点,推理快约 8 倍。消融里去掉 grep 掉分最多。
一份 PDF 经过三步离线处理变成目录树
全流程分四步,前三步每份文档离线做一次,只有最后一步在答题时运行。
| 步骤 | 输入 | 做什么 | 产出 |
|---|---|---|---|
| 解析 | 原 PDF | MinerU(开源 PDF 解析工具)按页切出文字、标题、图、表、公式,记下页码和坐标 | 一串带页码的元素 |
| 修正 | 解析结果 | 大模型重排标题层级;VLM 对照截图修正公式的 LaTeX 和表格的 HTML | 正确的章节树和表格内容 |
| 建库 | 修正后的元素 | 章节变目录,内容按类型存文件,写索引、关系和图片描述文件 | 文件系统,外加原 PDF |
| 答题 | 问题和文件系统 | agent 用四个文件工具定位、扩展、核对 | 答案 |
修正这一步是为了让目录真的有层级。示意:解析器常把「5 财务报表」和「5.2 合并资产负债表」都标成一级标题,直接建目录就会得到二十几个平铺的文件夹,层级等于没建。大模型还会把误判成标题的正文改回正文。
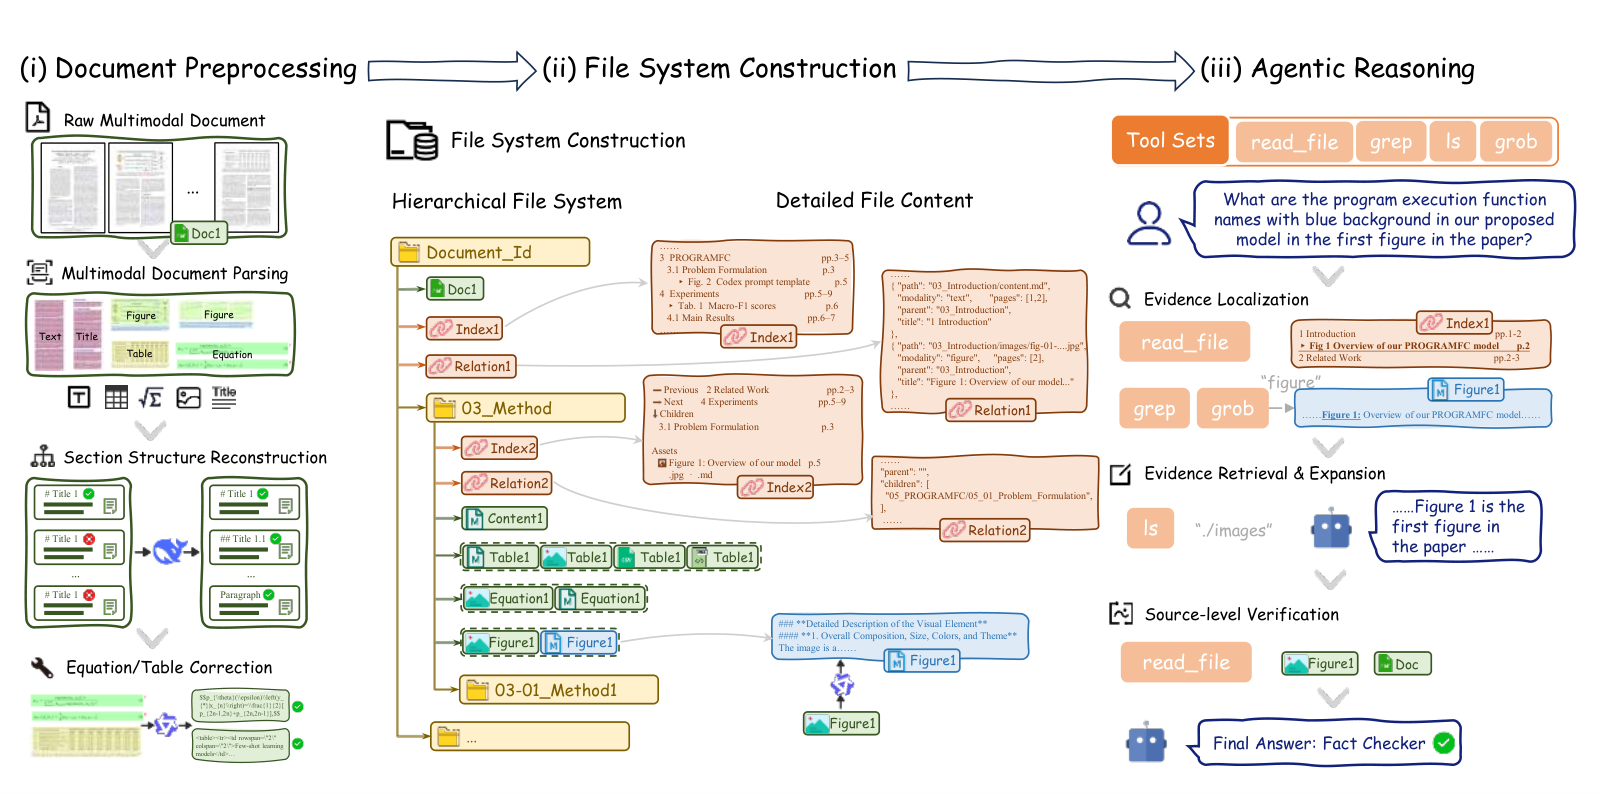
建好后,这份财报大致长这样(示意)。正文存 Markdown,表格同时存截图、CSV 和 HTML,原 PDF 留在根目录供核对:
annual_report/
├── index.md          ← 全书索引
├── relation.json     ← 全书关系
├── source.pdf
└── 05_财务报表/
    ├── index.md      ← 本章索引
    ├── relation.json
    ├── 05-02_合并资产负债表/
    │   └── content.md  table1.jpg  table1.csv  table1.html
    └── 05-04_股东权益表/
        └── content.md  table1.jpg  table1.csv  table1.html
索引文件是地图,关系文件是连线
只有目录还不够。示意:一份文档有 8 章、每章 5 节,agent 想看清全书结构,要先 ls 根目录、再逐章 ls,一共 9 次调用。根目录的 index.md 把 40 个小节和页码写在一个文件里,读一次就够了。按论文图里的格式,它长这样(示意):
5 财务报表                  pp.70-80
  5.2 合并资产负债表        p.75
    ▸ Tab. 合并资产负债表    p.75
  5.4 股东权益表            p.77
    ▸ Tab. 股东权益表        p.77
关系文件记录章节之间、章节与图表等素材之间、不同模态素材之间的关系。它的一条记录大致如下(示意):
{"path": "05_财务报表/05-04_股东权益表/table1.jpg",
 "modality": "table", "pages": [77],
 "parent": "05_财务报表", "title": "股东权益表"}
根目录和每个章节目录各放一份 index 和 relation,前者管全书,后者管本章。章节里的 index 还会列出上一节、下一节、子节和本节素材。论文把这两类文件合称结构描述文件。
图片还需要一样东西。grep 只能搜文字,一张「2017–2021 年营业收入」柱状图存成图片文件后,grep 搜不到它。DocFS 让 VLM 给每张图写一段文字描述,存在图旁边。描述只负责让 grep 命中这张图;具体数值仍要打开原图读,因为描述可能漏掉细节。
四个现成命令走完这道题
agent 只有四个工具。read_file 读文本、读图片,读原 PDF 时可以指定起止页;grep 按关键词搜全部文件,返回命中内容和路径;ls 列出目录;glob 按模式匹配路径。agent 搭在开源框架 DeepAgents 上,沿用它的官方工具集,只做了少量改造,没有为这项任务写专用接口。
财报那道题的过程大致如下(示意,结构取自论文 Figure 4 的案例):
read_file("index.md")          → 第 5 章是财务报表
grep("2019 股东权益合计")       → 无命中
read_file(".../05-02_合并资产负债表/table1.jpg")
                               → 只有 2020、2021 两列
grep("2019")                   → 命中 05-04_股东权益表/content.md
read_file(".../05-04_股东权益表/table1.jpg")
                               → 读到 2019 年末余额
read_file("source.pdf", page_start=75, page_end=77)
                               → 对照原页,两张表数字一致,作答
前两行是定位,中间三行是取回候选表格:第一张缺 2019 列,再 grep 一次换到股东权益表;最后一行是核对。核对不能省,因为 CSV 和描述都来自解析,可能有错。示意:解析时表格列错位,CSV 里 2019 的数字落到了 2020 列下,只看 CSV 就会答错;原页截图不受这种错误影响。
比最强基线高 2.9 和 4.3 个点,但不是每类题都赢
两个评测集的打分方式不同。MMLongBench-Doc 有 1,082 题,20.6% 是文档里找不到答案的题,按规则打分;FinRAGBench-V 有 1,394 题,用大模型评判。对照里最强的是 DocLens,一个免训练方法,先从整份文档缩到相关页,再缩到页内的图表元素。作者用同样两个骨干重跑了 DocLens,其余基线取自别人报告的分数,骨干各不相同。
| 方法 | 骨干 | MMLongBench-Doc 准确率 | F1 | FinRAGBench-V 准确率 |
|---|---|---|---|---|
| DocLens | Qwen3.5-Plus | 68.7 | 66.1 | 78.0 |
| DocFS | Qwen3.5-Plus | 71.6 | 70.0 | 82.3 |
| DocLens | DeepSeek-V4.1-Flash | 67.8 | 66.1 | 74.4 |
| DocFS | DeepSeek-V4.1-Flash | 69.7 | 67.5 | 82.3 |
这说明换一个骨干,提升仍然在,财报上的提升更大(DeepSeek 上 +7.9)。直接输入页面截图和 OCR 文本的 Qwen3.5-Plus 基线,MMLongBench-Doc 准确率是 66.6,DocFS 比它高 5 个点。
按证据类型拆开看,Qwen3.5-Plus 在 MMLongBench-Doc 上提升最大的是图表题(68.0 对 58.7,+9.3)和文字题(+6.9),说明收益集中在要从图表和正文里找证据的题上。
DocFS 也有输的类别:找不到答案的题 73.7 低于 DocLens 的 75.4,版面题 68.4 低于直接输入页面截图和 OCR 文本的 Qwen3.5-Plus 基线(71.3),FinRAGBench-V 的表格题 79.9 低于 DocLens 的 83.3。这说明它不是在每类题上都更强,判断「文档里没有答案」和读版面仍是短板。
去掉 grep 掉得最多,DeepSeek 上删减变体都不如不建
消融分两组:拿掉文件系统的某个部件,或者拿掉某个工具。「不建文件系统」指直接用解析结果答题。
| 变体 | Qwen:MMLongBench-Doc / FinRAGBench-V | DeepSeek:MMLongBench-Doc / FinRAGBench-V |
|---|---|---|
| 完整 DocFS | 71.6 / 82.3 | 69.7 / 82.3 |
| 不建文件系统 | 66.6 / 78.8 | 64.4 / 71.9 |
| 无预处理(不修层级和表格) | 66.7 / 80.6 | 58.7 / 81.6 |
| 无结构描述文件 | 66.3 / 79.8 | 59.3 / 79.8 |
| 无图片描述 | 66.9 / 79.8 | 58.7 / 81.9 |
| 无 grep | 62.0 / 74.0 | 56.6 / 79.8 |
| 无 ls | 66.6 / 80.9 | 58.9 / 81.8 |
Qwen 上去掉 grep,MMLongBench-Doc 掉了 9.6 个点,是所有变体里最多的。作者的解释是:没有全局搜索,agent 只能一层层往下翻目录,猜哪个文件有答案,散在远处章节的证据容易漏。放回财报那道题,第二次 grep("2019") 就没法做了,agent 得自己猜到 2019 的数在 5.4 节。
去掉图片描述,损失集中在需要看图的题上:Qwen 的图表题掉 11.3、插图题掉 7.3,DeepSeek 掉 15.8 和 10.8。这和作者加描述的初衷一致:描述让 grep 能找到图,原图再负责给出数值。
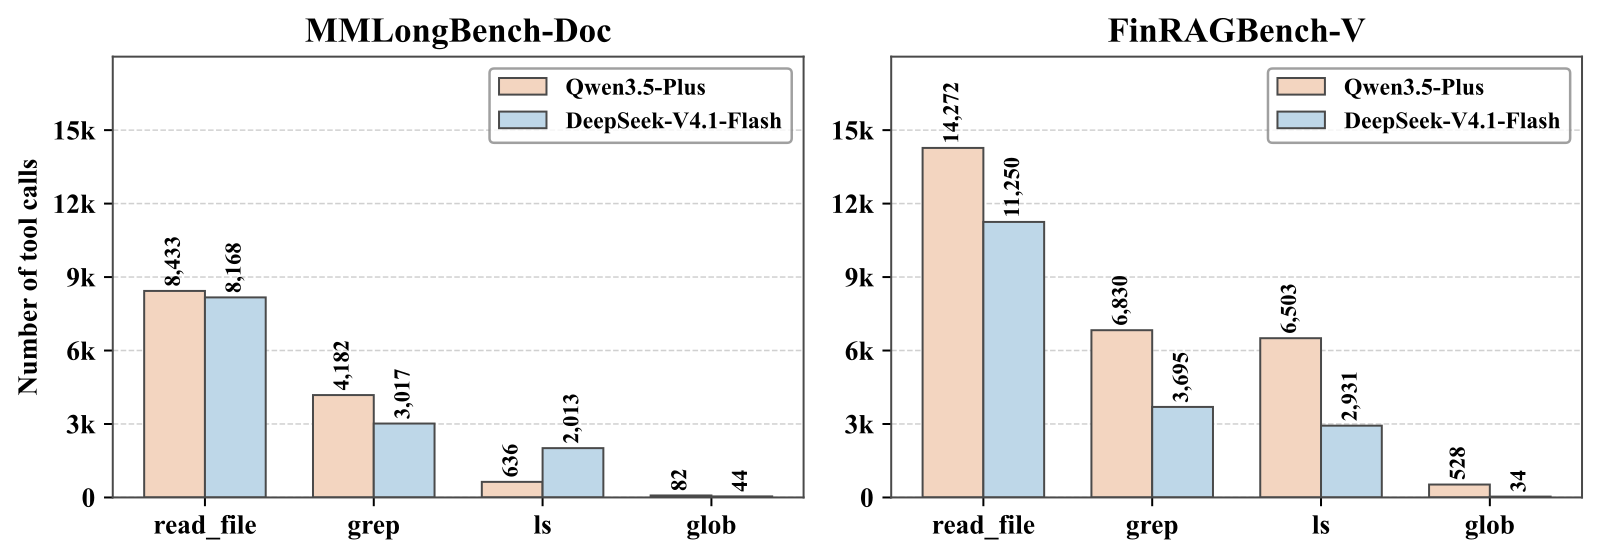
工具调用次数和消融一致:read_file 最多,grep 第二,glob 几乎没用到。
DeepSeek 那一列有个现象是我对照表格读出来的。MMLongBench-Doc 上,去掉任何单个部件或工具,准确率都落在 56.6 到 59.3 之间,比完全不建文件系统的 64.4 还低。我的理解是,对这个骨干来说,缺了一块的文件系统可能比直接给它解析文本更难用。
Qwen 上去掉 grep 同样更低(62.0 对 66.6、74.0 对 78.8),去掉结构描述在 MMLongBench-Doc 上也略低(66.3 对 66.6),其余变体与不建文件系统接近。这说明在两个骨干上,缺了 grep 的文件系统都不如直接用解析结果。
推理快约 8 倍,建库的 token 另算
和 DocLens 比推理阶段,Qwen3.5-Plus 在 MMLongBench-Doc 上每题平均耗时从 359.9 秒降到 43.9 秒,token 从 217.9K 降到 142.9K;FinRAGBench-V 上从 436.1 秒降到 52.7 秒,token 从 602.4K 降到 185.0K。DocLens 在更密的财报上 token 涨到 2.8 倍,DocFS 的开销在两个评测集间变化不大。这说明在这两个评测集上,DocFS 的平均推理耗时和 token 用量变化较小。
这张账没算建库。建库用了另外几个模型,摊到每题是 14.5K(MMLongBench-Doc)和 122.5K(FinRAGBench-V)token,全算进去后,Qwen3.5-Plus 每题 token 用量是 157.4K 和 307.5K,DocLens 的 217.9K 和 602.4K 约为它的 1.4 至 2.0 倍。建库时间受解析并发影响,所以作者只比了推理阶段的耗时。
摊销的前提是一份文档答好几题,FinRAGBench-V 每篇平均 4.6 题。按我的估算,一篇财报如果只问一题,建库约 567.3K 加推理 185.0K,会超过 DocLens 的 602.4K,意味着 DocFS 更适合同一份文档被反复提问的场景。
回到开头那道题:DocFS 没有换掉检索。第一次 grep 落空后,agent 再用 grep("2019") 找到股东权益表,然后翻回原 PDF 第 75、77 页核对。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
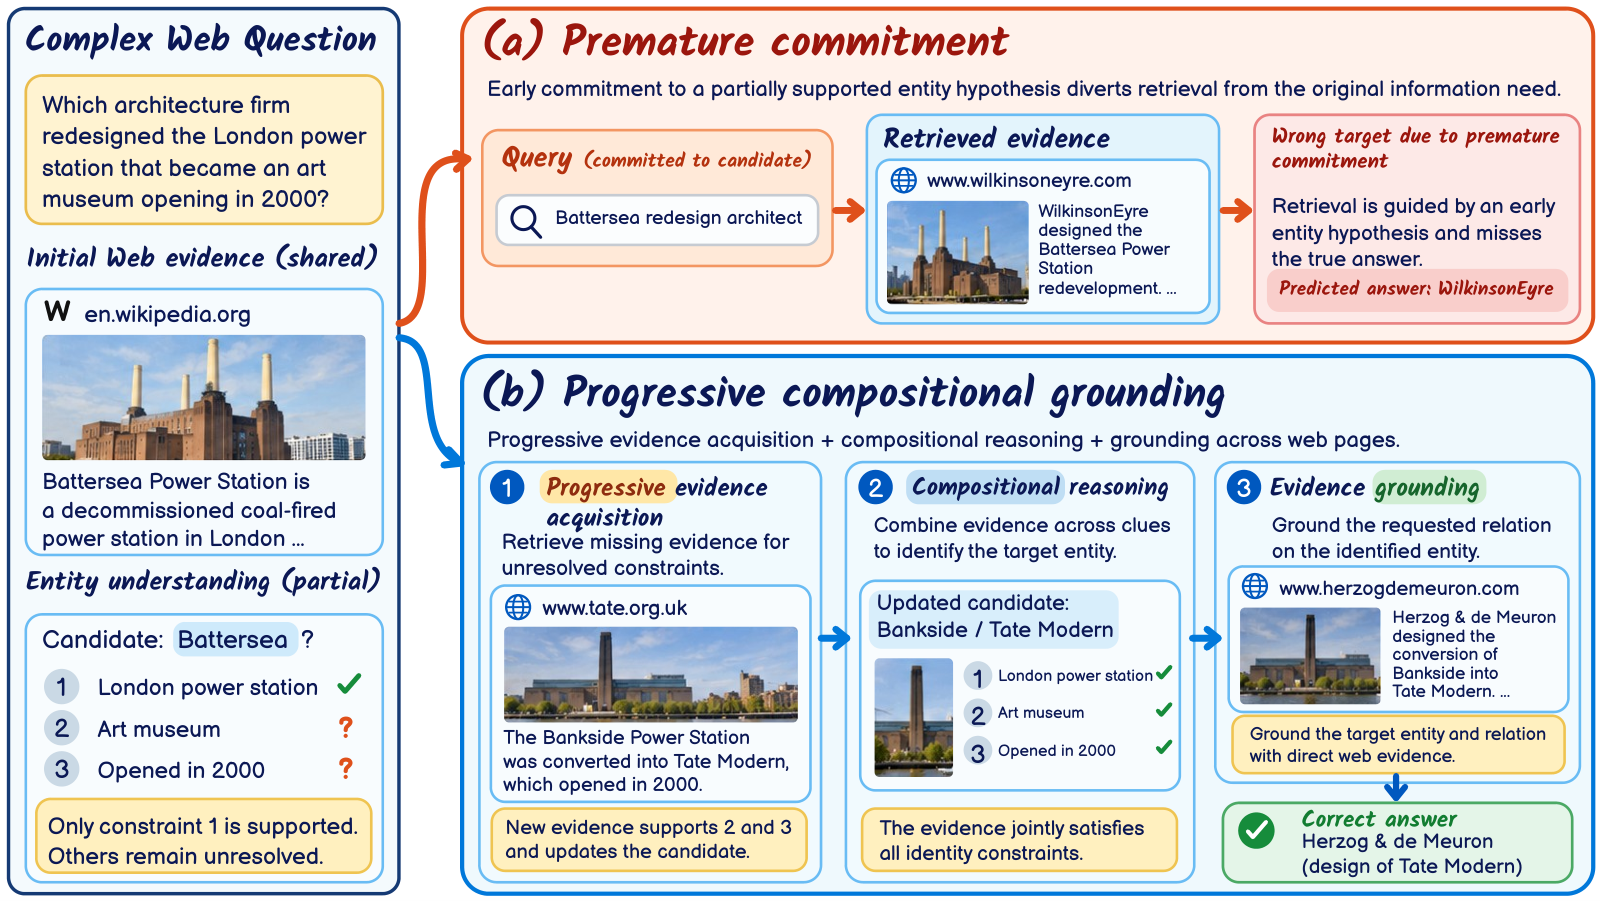 Retrieval · 2026-11-13PCG-RAG: Progressive Compositional Grounding for Retrieval-Augmented Generation in Complex Web Question Answering复杂网页问答常常要先从几条线索里认出说的是谁,再去查它的某个属性,而常见的错法是只对上一条线索就把名字当成定论。论文里的例子是一座改建成美术馆的伦敦发电厂,系统只凭伦敦和发电厂就认定是 Battersea,接着查到的建筑师其实属于另一座楼。PCG-RAG 把这种只对上部分线索的名字当作搜索线索,用它去补查还没对上的条件,确认之后才让后续问题依赖它。最后生成答案时,它把确认身份的段落和回答属性的段落一起放进上下文。在 BrowseComp-Plus 上,它的准确率比最强基线高 5.43 个百分点,token 用量还少了 82.98%。先认准对象再查属性,比一次堆更多检索结果更有效。
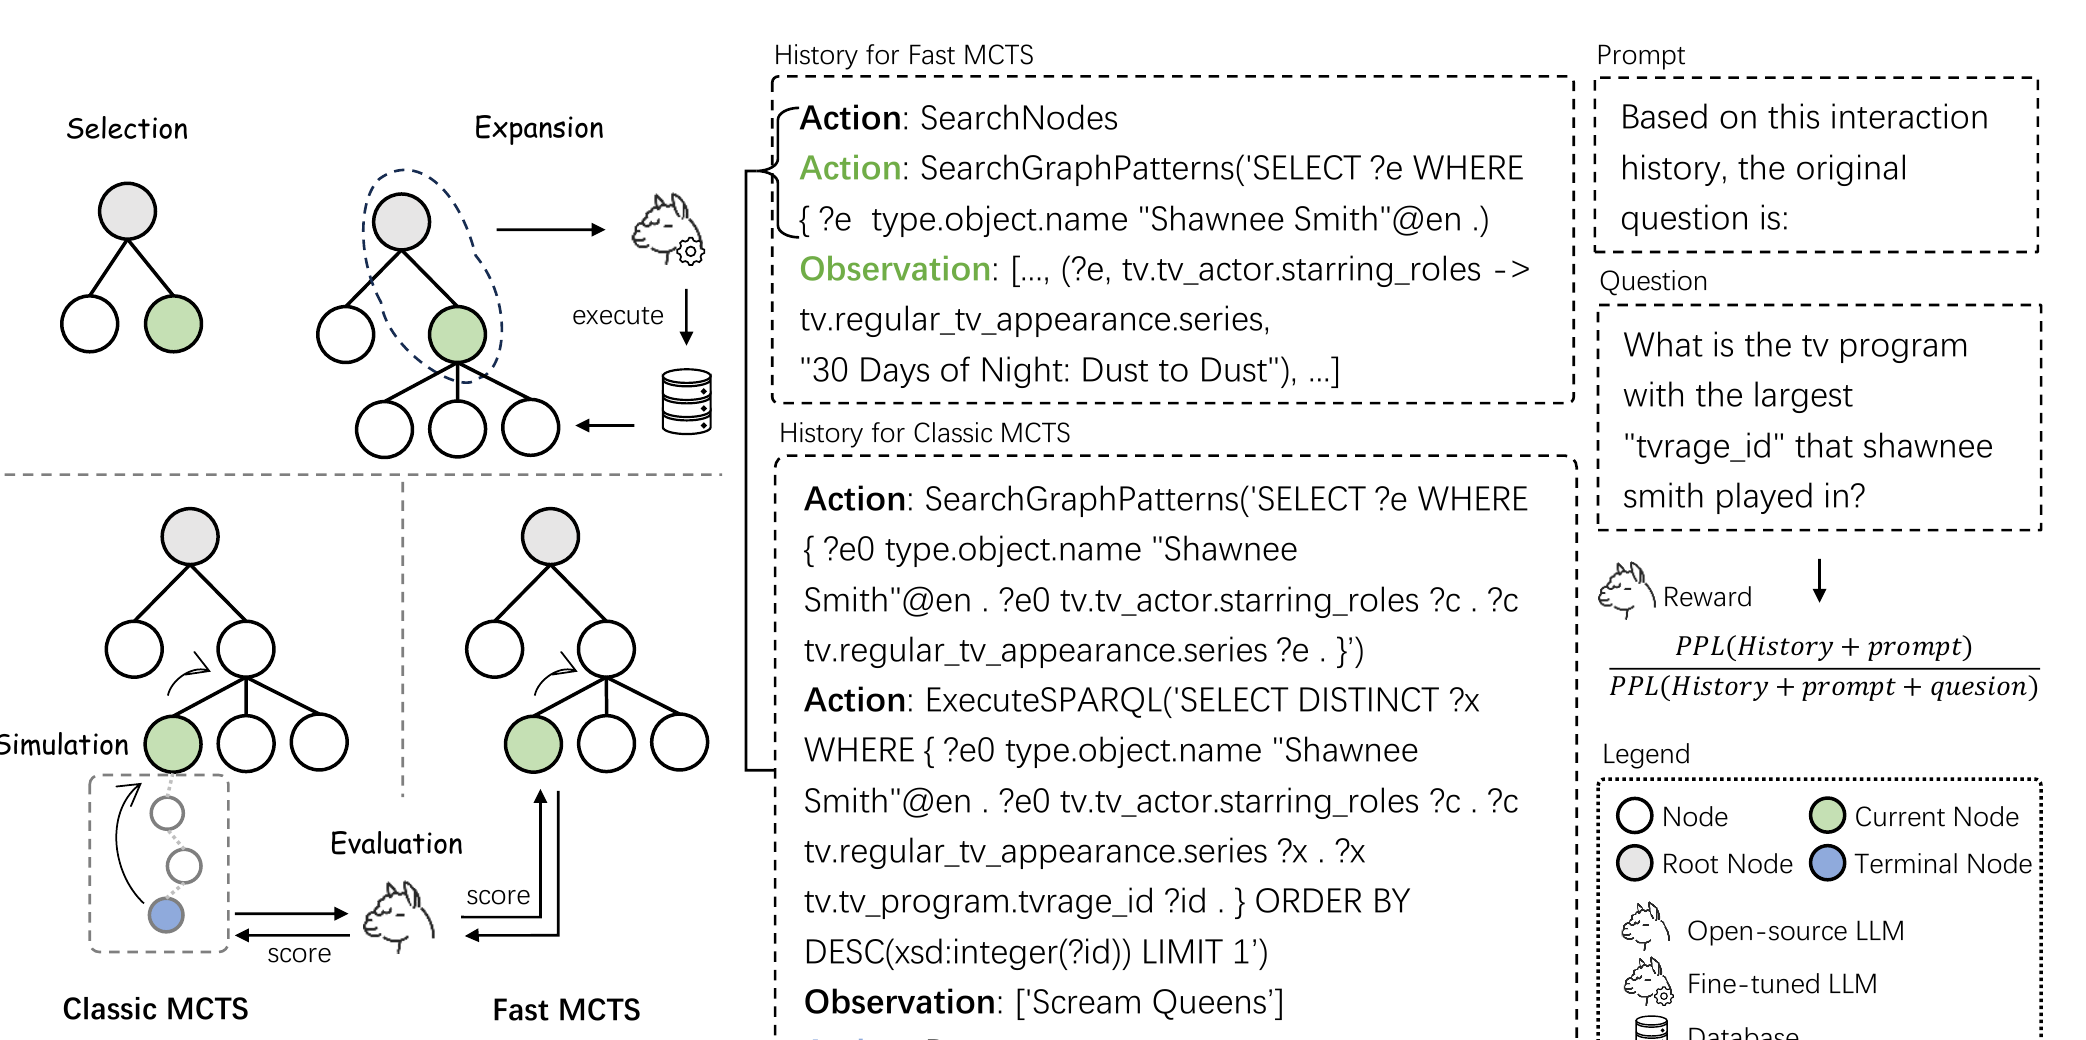 Retrieval · 2026-11-04MCTS-KBQA: Monte Carlo Tree Search with Information Gain Rewards for Knowledge Base Question Answering用 MCTS 帮大模型在知识库上一步步查答案时,中间步骤可以不训练奖励模型、也不模拟到底,就打出有用的分。办法是把截至这一步的查询记录交给一个开源指令模型,分别算带上原问题和不带原问题时这段记录的困惑度。带上问题后困惑度降得越多,说明查到的东西和问题越相关,这一步的奖励就越高。以往要么每一步都模拟到底、再给最终状态打分,代价很高;要么另训一个奖励模型,需要大量数据。新办法每个新节点只要两次前向计算。在 4 个 KBQA 基准上,它稳定好于只走一条路径、不做搜索的方法;和模拟到底的经典树搜索比,准确率和成本的权衡一般更好。
 Retrieval · 2026-10-27Beyond Post-Hoc Rewards: Privileged Reasoning Exploration for Multimodal Embeddings一些多模态向量模型会先让模型针对输入写一段推理,再把推理一起编码,得到信息更多的向量。但训练数据只告诉模型哪两样东西相关,从不告诉它该写什么推理,只看输入去摸索,很难找到对检索真正有用的推理。PILOT 让同一个多模态大模型扮演两个角色:一个只看输入写推理,另一个在训练时还能看到配对的正确答案,因而更容易写出有用的推理。后者写出的推理会挑一部分教给前者:一看用这段推理生成的向量检索效果好不好,二看前者只凭输入写出这段推理的概率高不高,两者都高的权重才大。上线时只用前者。在含 78 项任务的 MMEB-V2 上,2B 和 7B 模型总分分别提高 3.2 和 3.3 分,视觉文档检索提升最大。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…