目录 · 7 节
1三个是/否问题,把每个测试事件放进一格2每格至少 1,000 个用户,才拿来排模型359 个公开数据族里,19 个连能排序事件的日历时间都没有4五个数据集没有共同日期,只能共用一条切分规则5哪一格决定了谁最好6用 repeat-last 量一量,跨时间掉的分算谁的7回到 7 月那家咖啡店
INTENT(作者发布的一个公开基准)把用户事件序列模型的测试切成七格,再拿一个什么参数都不学的「重复上一个物品」做对照。作者据此认为:在三个数据集上,跨过训练截止日期后丢掉的分,大多来自用户行为本身变了,不全是模型的问题。
银行和支付网络开始在客户事件序列上训练基础模型,这些事件包括刷卡交易、App 会话和授权记录。模型读一位客户按时间排好的事件,预测这位客户下一步会做什么,比如下一笔交易落在哪个商户。
难处在于,部署后的模型总是在往未来预测。举一个贯穿全文的例子(示意):一家银行用截至 6 月 30 日的交易训练好模型,7 月来了一位新开户的客户小周,在一家 7 月才开张的咖啡店刷了卡。这一笔交易同时撞上三件模型没见过的事:客户是新的,时间在训练期之后,商户也是新的。可是每家银行都在自己的私有数据上评测,用的指标也各不相同,外人没法比较两个模型谁更能应付这种情况。
公开的序列推荐基准本来可以补上这个缺口,但它们的切分方式测不到「未来」。近期 77% 的序列推荐论文给每个用户留出最后几个事件做测试。放回例子里:老客户老王最后一次刷卡在 6 月 10 日,这一笔被留作测试;老李 7 月的交易却都进了训练,里面也包括老李在那家新咖啡店的消费。于是模型在测老王之前,已经从老李身上看过 7 月的世界,分数就可能偏高。更麻烦的是,小周这种「新客户在新商户」的情形混在总平均里,单独拎不出来。
三个是/否问题,把每个测试事件放进一格
INTENT 的做法是对每个测试事件问三个是/否问题:这个用户在训练里出现过吗?事件发生在截断日期之前还是之后?要预测的目标物品在训练里出现过吗?在银行场景里,用户就是客户,物品可以是下一笔交易的商户。新物品主要出现在商户这一层,因为商户不断开张,而交易类别代码很少变。
用户那一问来自留出:作者随机拿出 10% 的用户,完全不让他们进训练。时间那一问来自截断日期:截断前的事件可以训练,截断后的只用来测。物品那一问在测试时才判断。
三个二值问题本该切出八格,INTENT 只有七格。原因是「已知用户、截断前」这一格测的就是训练事件本身,目标物品全都见过,没有新物品可分。下表把例子里的几笔交易放进对应的格子(示意):
| 示意交易 | 用户 | 时间 | 目标物品 | 落在哪格 |
|---|---|---|---|---|
| 老王 5 月在常去的超市刷卡 | 已知 | 截断前 | 见过(不再细分) | 已知用户·截断前 |
| 老王 7 月在常去的超市刷卡 | 已知 | 截断后 | 见过 | 已知用户·截断后·见过物品 |
| 老王 7 月在新咖啡店刷卡 | 已知 | 截断后 | 新 | 已知用户·截断后·新物品 |
| 留出用户小陈 5 月在超市刷卡 | 新 | 截断前 | 见过 | 新用户·截断前·见过物品 |
| 新客户小周 7 月在新咖啡店刷卡 | 新 | 截断后 | 新 | 新用户·截断后·新物品 |
表里没列的两格是「新用户·截断前·新物品」和「新用户·截断后·见过物品」。每一行就是 INTENT 给一个测试事件打上的标签,最后的分数按格汇总,不再混成一个总平均。
「已知用户·截断后」这一格最接近常见的留最后一个事件的做法,区别是没有任何训练事件晚于测试事件,老李 7 月的交易不会再漏进训练。
打分时,模型要对数据集里的全部物品排序,不抽样负例,因为抽样负例本身就可能把模型的先后顺序颠倒。主指标是 NDCG@10,先算每个用户的分,再对用户求平均。
每格至少 1,000 个用户,才拿来排模型
格子切细了,有些格可能人太少。INTENT 规定一格至少有 1,000 个不同用户,才用它来排模型。单位用用户而不用事件,是因为同一个人的多次刷卡彼此相关,算不上独立证据。
1,000 这个数可以心算出来:每用户 NDCG 的标准差取 0.3,除以 √1000(约 31.6)得 0.0095,再乘 1.96 约等于 0.019。作者给的是:每用户 NDCG 标准差在 0.2 到 0.3 时,1,000 个用户的均分 95% 区间半宽约 0.012 到 0.019。排名时,一个模型的 95% 区间要和其他模型都不重叠,才算这一格的领先者。
59 个公开数据族里,19 个连能排序事件的日历时间都没有
INTENT 只预测下一个物品,所以任何有用户、物品和有序事件的数据集都是候选。作者检查了 101 个公开发布,同源的变体合成一个族(比如 Amazon Reviews 的各个品类算一个),共 59 个族。
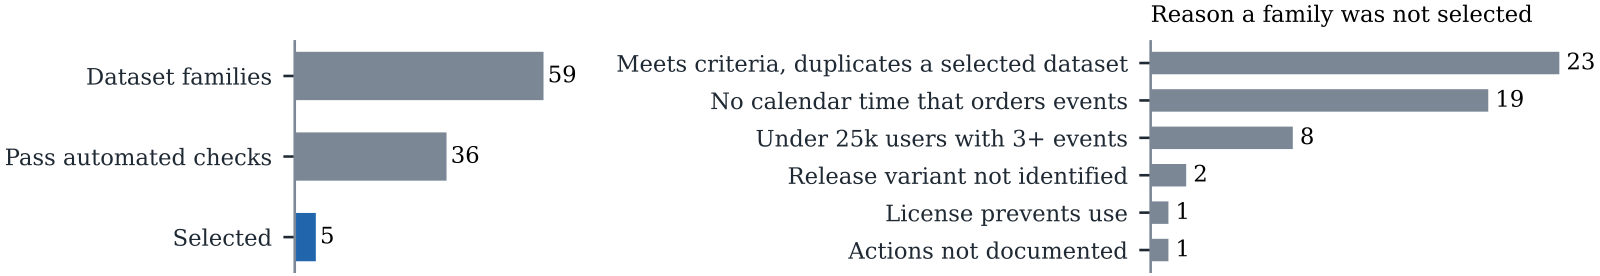
入选要过五条标准,最卡人的一条是日历时间戳。只有订单序号或会话内位置,可以排好一个用户自己的事件,却没法把两个用户放到同一条时间线上。截断日期正需要这条共同的时间线:老王 6 月 10 日的那笔和老李 7 月 2 日的那笔,必须分得清谁在截断前。
这条标准还排除了最大的公开银行数据集,它有 9.5 亿笔交易、200 多万家企业客户。为了匿名化,这份数据给日期加了随机噪声,原作者自己也说这可能打乱客户事件的顺序。
最后留下的五个数据集各补一个别处没有的条件:
| 数据集 | 补的条件 | 截断 | 测试期天数 | 事件数 |
|---|---|---|---|---|
| Amazon H&K | 稀疏长尾,跨 25 年 | 2022-09 | 377 | 67.4M |
| KuaiRand | 8 种动作,随机曝光 | 2022-05-06 | 2 | 323.5M |
| MicroLens | 视频带图像、文本、音频 | 2022-09 | 11 | 9.1M |
| H&M | 客户画像和价格 | 2020-07 | 83 | 31.8M |
| REES46 | 金额,浏览到加购到购买 | 2020-04 | 29 | 411.7M |
其中两个离银行最近。REES46(多品类电商的浏览、加购、购买日志)每个事件都带价格和购买漏斗,是最像「带金额的交易流」的公开数据;H&M 把静态客户属性接到购买历史上,就像银行把客户画像接到账本上。
五个数据集没有共同日期,只能共用一条切分规则
最自然的想法是所有数据集用同一个截断日期,让测试覆盖同一段日历时间。但这五个数据集做不到:H&M 和 REES46 在 2020 年结束,KuaiRand 在 2022 年才开始。
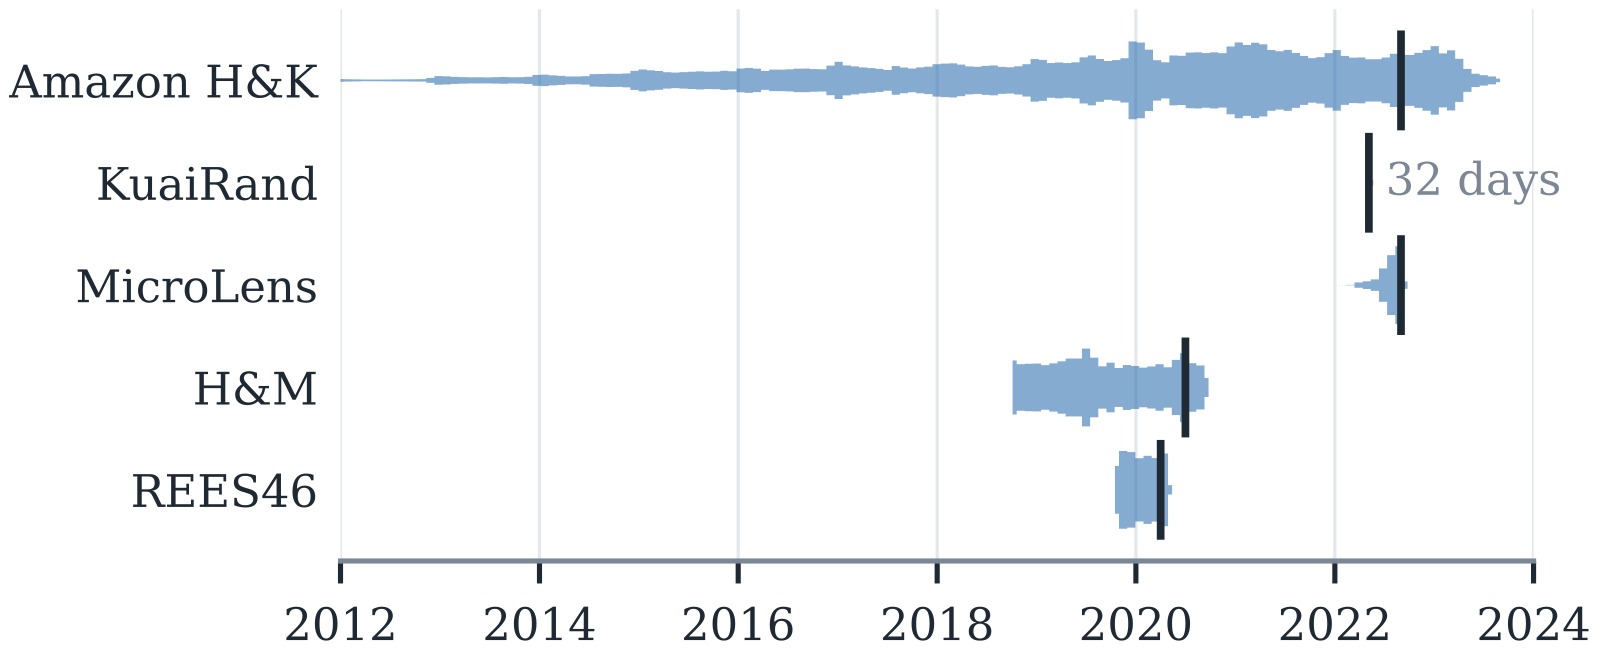
作者扫了 1998 到 2023 年的 9,238 个日边界,没有一个能让五个数据集两边都有事件。比如选 Amazon 和 KuaiRand 都覆盖的 2022-05-04,H&M 和 REES46 就没有未来事件可测,MicroLens 也只有 5% 的数据能进训练。
于是可比性改由一条共同规则来保证,而且这条规则在看任何模型分数之前就定死了。规则的目标是 80% 的行进训练,允许 75% 到 85%。留出的 10% 用户从不进训练,所以约 89% 的事件得落在截断之前,才能凑够 80%(粗算:0.8 ÷ 0.9 ≈ 0.89)。候选截断取月边界,跨度不超过 62 天的数据集改用日边界;在所有可行候选里取中点。
规则定死在先,是为了防止「换个截断日期,让自己的模型好看一点」。代价是测试期长度差得很远:KuaiRand 只有 2 天,Amazon 有 377 天。所以两个数据集之间的差别,可能来自测试期长短,不一定来自平台。INTENT 因此要求每个结果都附上截断日期、训练历史长度、见过的用户和物品比例以及测试期长度。
按这条规则切完,五个数据集合计,最小的一格(新用户·截断前·新物品)有 111,769 个用户,最大的一格(已知用户·截断前)有 1,590 万。只有 H&M 和 MicroLens 在那个最小格里低于 1,000,它们在这一格的结果只报区间,不参与排名。
哪一格决定了谁最好
作者放了四个参考模型,超参数都在看测试分之前定好:
- Popularity:把用户自己的物品频次(权重 0.7)和平滑后的全局物品分布混在一起打分。
- repeat-last:把用户上一个物品排第一,其余物品并列排在后面,什么参数都不学。
- SASRec:2 层、64 维、看最近 50 个事件的因果 transformer,只能给训练里出现过的物品打分。
- SASRec-F:每个物品的向量由两部分相加:元数据词(标题、类别、品牌里的词)embedding 的均值,加上训练里见过的物品才有的 ID embedding。训练时以 0.5 的概率丢掉 ID embedding,让模型学会只靠元数据排序;评测时把 ID embedding 乘 0.5,也就是它在训练中的期望值。新物品没有 ID,只用元数据词打分。
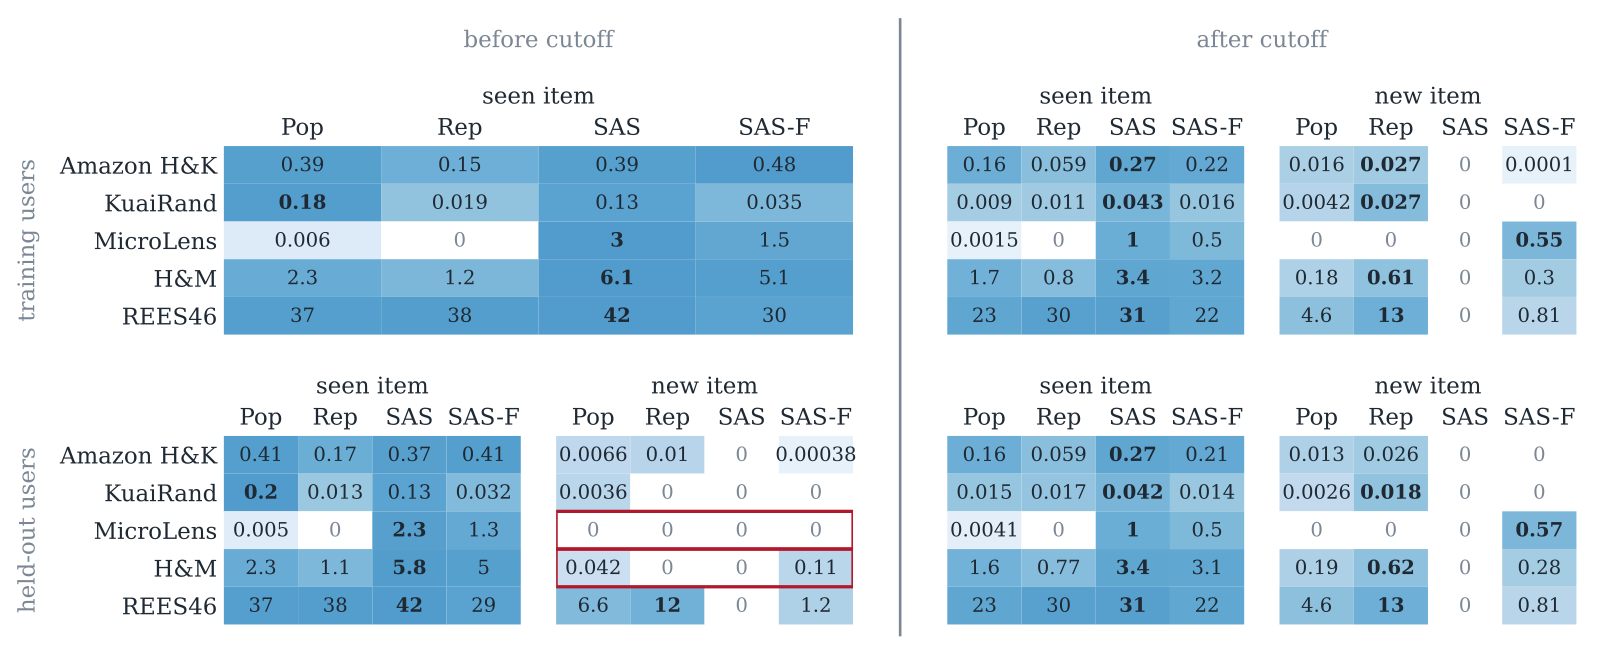
看「已知用户·截断后·见过物品」这一格,SASRec 在每个数据集都领先,在 H&M 上是 Popularity 的两倍(3.4 对 1.7)。同一批用户换成选新物品,SASRec 直接得零分,因为它根本没有新物品的向量。这时领先的是 repeat-last,五个数据集里四个都是它赢;唯一的例外是 MicroLens,那里只有 SASRec-F 得分大于零。新用户在截断后也是同样的反转。 Hoot 说

示意:每个 embedding 缩成一个数,物品和词的数值都是编的;0.5 的丢弃概率和评测缩放来自论文。元数据词取自训练物品的标题、类别和品牌。
出处
论文 §5 SASRec-F:物品向量 = 元数据词 embedding 均值 + 训练物品的 ID embedding;训练以 0.5 概率丢 ID;评测时 ID 乘 0.5;新物品凭元数据词打分这说明只报一个总分会把两种能力混在一起:SASRec 擅长记住见过的物品,对新物品却毫无办法。对小周的那家新咖啡店,SASRec 给出的分是零。
用 repeat-last 量一量,跨时间掉的分算谁的
先比用户和时间哪个更贵。截断后,SASRec 对新用户的分数在每个数据集上都和已知用户相差不到 4%;四个模型各自在新用户和已知用户这两格之间,也都没有显著差别。原因很直接:四个模型都没有每个用户专属的参数,新用户的历史和老用户的历史一样好用。所以作者也承认,用户这一维其实还没被真正检验。
跨过截断就不一样了。在新用户上量(这样截断前后两期都在样本外),SASRec 在见过物品上丢掉 25% 到 68% 的分。
这些分丢在哪里?作者在这里用上了 repeat-last。它不学参数,不会对训练期过拟合,可它在 Amazon、H&M、REES46 上跨截断仍丢了 21% 到 64%。作者据此认为,截断后的行为本身更难从历史预测,并把一个模型超出 repeat-last 的那部分掉分算作模型自己的。这个算法有一个前提:repeat-last 的掉分能代表行为变化对所有模型的影响。
一个示意的小算账:repeat-last 截断前 0.10、截断后 0.05,保留 50%;某模型截断前 0.30、截断后 0.15,也保留 50%。这个模型掉了一半分,但按作者的口径,它没有比 repeat-last 多丢,掉分全算在行为变化上。
真实数字里两种情况都有。SASRec 在 Amazon 上保留 73%,repeat-last 只保留 36%,SASRec 比对照少丢了很多。在 H&M 上 SASRec 保留 59%,repeat-last 保留 71%,SASRec 多丢了一截,按作者的口径这部分算在模型头上。KuaiRand 又是另一种情况:Popularity 只保留 8%,repeat-last 没有显著变化。作者的解读是,训练期热门的视频不再是截断后被看的视频。
「掉分大多来自行为变化」这个判断只针对 Amazon、H&M、REES46 三个数据集,也依赖上面那个前提。再加上测试期从 2 天到 377 天不等,测试期长短和平台差异也搅在一起。
回到 7 月那家咖啡店
小周在新咖啡店的那一笔,落在「新用户·截断后·新物品」格。只认物品 ID 的模型在这一格得零分。repeat-last 也帮不上第一次:它只能找回用户在测试期早些时候已经碰过的新物品,所以在 Amazon、H&M、REES46 的新物品上仍丢 20% 到 57%。用户第一次选一个新物品,光看历史是猜不出来的。
元数据能补多少,要看物品描述有多丰富。已知用户截断后,SASRec-F 在新物品上的分数是它见过物品分数的 112%(MicroLens)、10%(H&M)和 4%(REES46)。在 Amazon 上接近零,在 KuaiRand 上为零,因为那里的元数据太粗,新视频大批并列。代价是 SASRec-F 在见过物品上比 SASRec 低 7% 到 66%。
作者给银行的建议可以直接搬到自己的账本上:截断规则事先定好,留出一部分客户,每一格数清有多少用户,再放一个 repeat-last 这样免训练的对照。作者认为,只要它的掉分能代表行为变化的影响,就能用它把「客户行为漂移了」和「模型没跟上」分开。
这些参考模型都没调参,只能当每一格的下界;五个数据集里也没有一份来自银行,能找到的公开银行数据都因日期加噪被挡在门外。INTENT 给的是一把量具,量出来的数字还要银行拿自己的数据去填。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
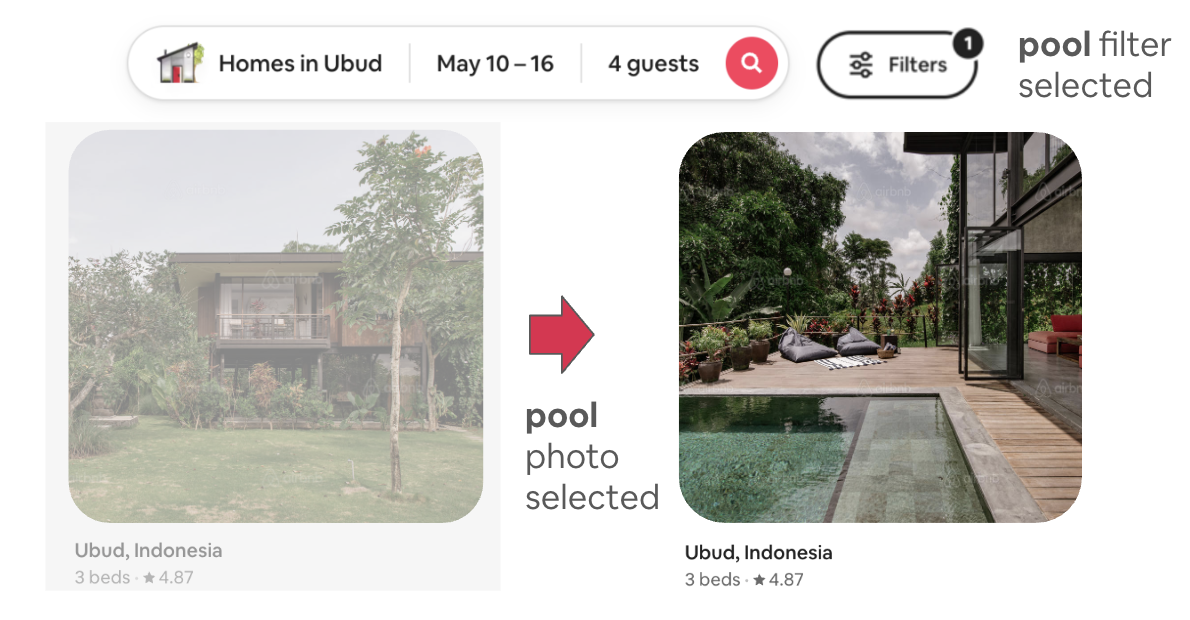 Personalization · 2026-11-11OptiCover: A Scalable and Multi-Surface Framework for Cold-Start Visual Optimization under Semantic ConstraintsAirbnb 想替房东挑封面图,难点有两个:超过 90% 的房源照片从没当过封面,没有点击数据可学,最吸引点击的图又可能拍的是附近景点,并不代表房源本身。作者先用几类间接线索筛出候选图,用 VLM 对照房源描述核对照片,再按预测 CTR 选图,首页 CTR 提高 1.5%。更有意思的是搜索页的两组实验。直接选预测点击最高的图,CTR 显著上涨,预订人数却没有显著变化,多出来的点击主要是把预订从一个房源挪到另一个房源。先按用户的筛选条件(比如泳池)收窄候选再选图,CTR 没有显著变化,预订人数却显著提高 0.35%,只是置信区间的下沿几乎贴着零。在搜索页,按用户意图收窄候选比推高点击率更能带来预订。做素材优化不能只看点击率。
 Personalization · 2026-10-16Bridging the Topological Divide: Dual-Branch Graph Distillation with Semantic Priors for Robust Cold-Start Recommendation新物品没有交互边,图推荐便无法从邻居获取兴趣信号。作者先用文本语义固定协同空间,再让独立学生网络学习表示方向,并在检索时恢复向量长度;Sports冷启动Recall@20比DropoutNet高20.8%。
 Personalization · 2026-09-01Personalized and Multi-View Representation for Federated Cold-Start RecommendationPMFRec 面向服务端看不到用户交互、客户端又看不到专有物品属性的双边约束,解决零交互新物品的联邦冷启动。它用用户专属表示生成器、多视图编码器、物品自适应门控与正交约束融合协同和属性知识;在 CiteULike 与 3 个 XING 规模设置共 4 组数据上评估,覆盖 Recall、Precision、NDCG 的 @5/@10/@20 指标。
 Personalization · 2026-11-03BrowseFlow: Sparse Event Flow Matching for Generative User Simulation同一个用户面对同一页推荐,这次可能刷到第 20 条点了两件,下次刷到第 8 条就走了;日志只记下其中一次。BrowseFlow 认为用户模拟器该学的是这种结果的分布,而不是复刻那一条日志。它把一次浏览拆成两件事:刷到多深,以及在哪几个位置点击或点赞,直接生成这几个关键事件,而不是一步步预测大量的下滑动作。这一点很重要,因为在淘宝的浏览数据里只有 5.48% 的动作是点击这类正反馈。在三个数据集上,它生成的浏览结果整体分布和点击次数分布都最接近真实。
 Personalization · 2026-10-25PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn在 LinkedIn 上,一个开始找工作的软件工程师,想点开的往往不是另一位工程师,而是招聘官、招聘经理和 HR。职业社交里该推荐谁常常是互补的,而不是相似的。可大多数推荐系统用的是资料越像越该推荐的思路,于是总把同行推给他。PAIR 换了一个训练目标:不再学谁和谁像,而是从真实日志里学用户在看到的几个人里点了谁。上线做对比实验后,推荐的点击率提高 7.5%,付费会员的续订率提高 2.1%,页面速度没有变慢。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…