 已录用 RecSys 2026 Workshop
目录 · 7 节
1一次打分请求经过的七步2两路检索各自挑到的历史3为什么要把候选商品写进每一条旧行为4序列最前面的两个位置带进 query,也汇总整段历史5辅助任务要求 attention 只能单向流动6离线消融:拿掉 early fusion 跌得最深7上线五周:每次曝光订单多 11.5%,延迟增加约 12%
搜索广告排序时,该挑用户的哪些旧行为,取决于这次搜的词和正在打分的商品两样东西;Wayfair 按这两样东西各挑 50 条,离线和线上指标都涨了,而最不能丢的,仍是让每条旧行为都带上候选商品的信息。
Wayfair 的搜索结果页上有广告位。用户搜一个词之后,排序模型要给每一件候选广告商品预测点击率(看到广告后点进去的比例)、转化率(点进去后下单的比例)等指标,预测值校准后交给下游的排序和竞价。下面用一个示意场景贯穿全文:用户搜「户外餐桌椅」,模型正在给一张柚木餐桌打分。这位用户过去一年有 1000 条行为,最近两周几乎都在看床头灯,八个月前看过一把庭院遮阳伞,十个月前看过一个室内柚木边柜。
难处在于用户的历史太长。这篇论文提到,原始行为可以多到几万条,竞价时的延迟预算不允许模型全部处理,而且对某一次打分来说,大多数旧行为都用不上。所以 Wayfair 线上的序列模型只读最近 100 条行为。放到这个例子里,最近 100 条全是床头灯,遮阳伞和柚木边柜都进不了模型的输入,输入里没有任何信息能说明这位用户在布置户外、偏好柚木。
长序列模型的常见做法,是先按正在打分的商品从长历史里挑出一小批相近的行为,再用模型细读这一小批。这种只按候选商品挑的办法,在搜索场景里会漏东西。给柚木餐桌打分时,柚木边柜和它相近,能被挑中;遮阳伞和餐桌不像,很可能挑不中,可遮阳伞和用户搜的「户外餐桌椅」直接相关。
反过来只按 query(这次搜的词)挑也不够。遮阳伞能挑中,柚木边柜和「户外餐桌椅」离得远,挑不中。而且同一次搜索里,柚木餐桌和铝合金餐桌拿到的是同一批旧行为,这批行为无法告诉模型:用户过去的柚木偏好只支持前一件商品。
这篇论文的改动很直接:最近 100 条照旧保留,再从更早的行为里按候选商品挑 50 条、按 query 挑 50 条,一起送进 Transformer(一种让序列里每个位置互相参考的神经网络)。在五周的线上 A/B 实验里,实验组每次曝光(广告被展示一次)带来的订单比对照组多 11.5%,代价是模型服务延迟增加约 12%。
一次打分请求经过的七步
继续看柚木餐桌这一次打分。下表是序列模块从输入到输出的全过程,前六步线上和训练都走,最后一步只在训练时存在。
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 1 拆历史 | 用户一年内的行为 | 取最近 100 条,其余放进检索池 | 最近序列、检索池 | 否 |
| 2 候选路 | 检索池、柚木餐桌 | 找出商品和柚木餐桌最相似的 50 条行为 | 50 条旧行为 | 否 |
| 3 query 路 | 检索池、「户外餐桌椅」 | 找出商品和这个 query 最相关的 50 条行为 | 50 条旧行为 | 否 |
| 4 组序列 | 三批行为、query、候选商品 | 去掉重复行为,把候选商品拼进每条历史 token(序列里的一个位置),序列最前面再放两个 token | 最多 202 个 token | 否 |
| 5 编码 | token 序列 | 过 2 层 Transformer | 每个位置的输出 | 否 |
| 6 汇总 | 每个位置的输出 | 拼接 query 位置、候选位置的输出和三种全序列汇总(可学习投影、按候选商品加权的 attention pooling、max pooling),压成一个序列向量 | 给点击、转化等预测头的输入 | 否 |
| 7 辅助任务 | 第 1 层的最近序列表示 | 预测用户下一条行为的商品 | 一项辅助 loss | 是 |
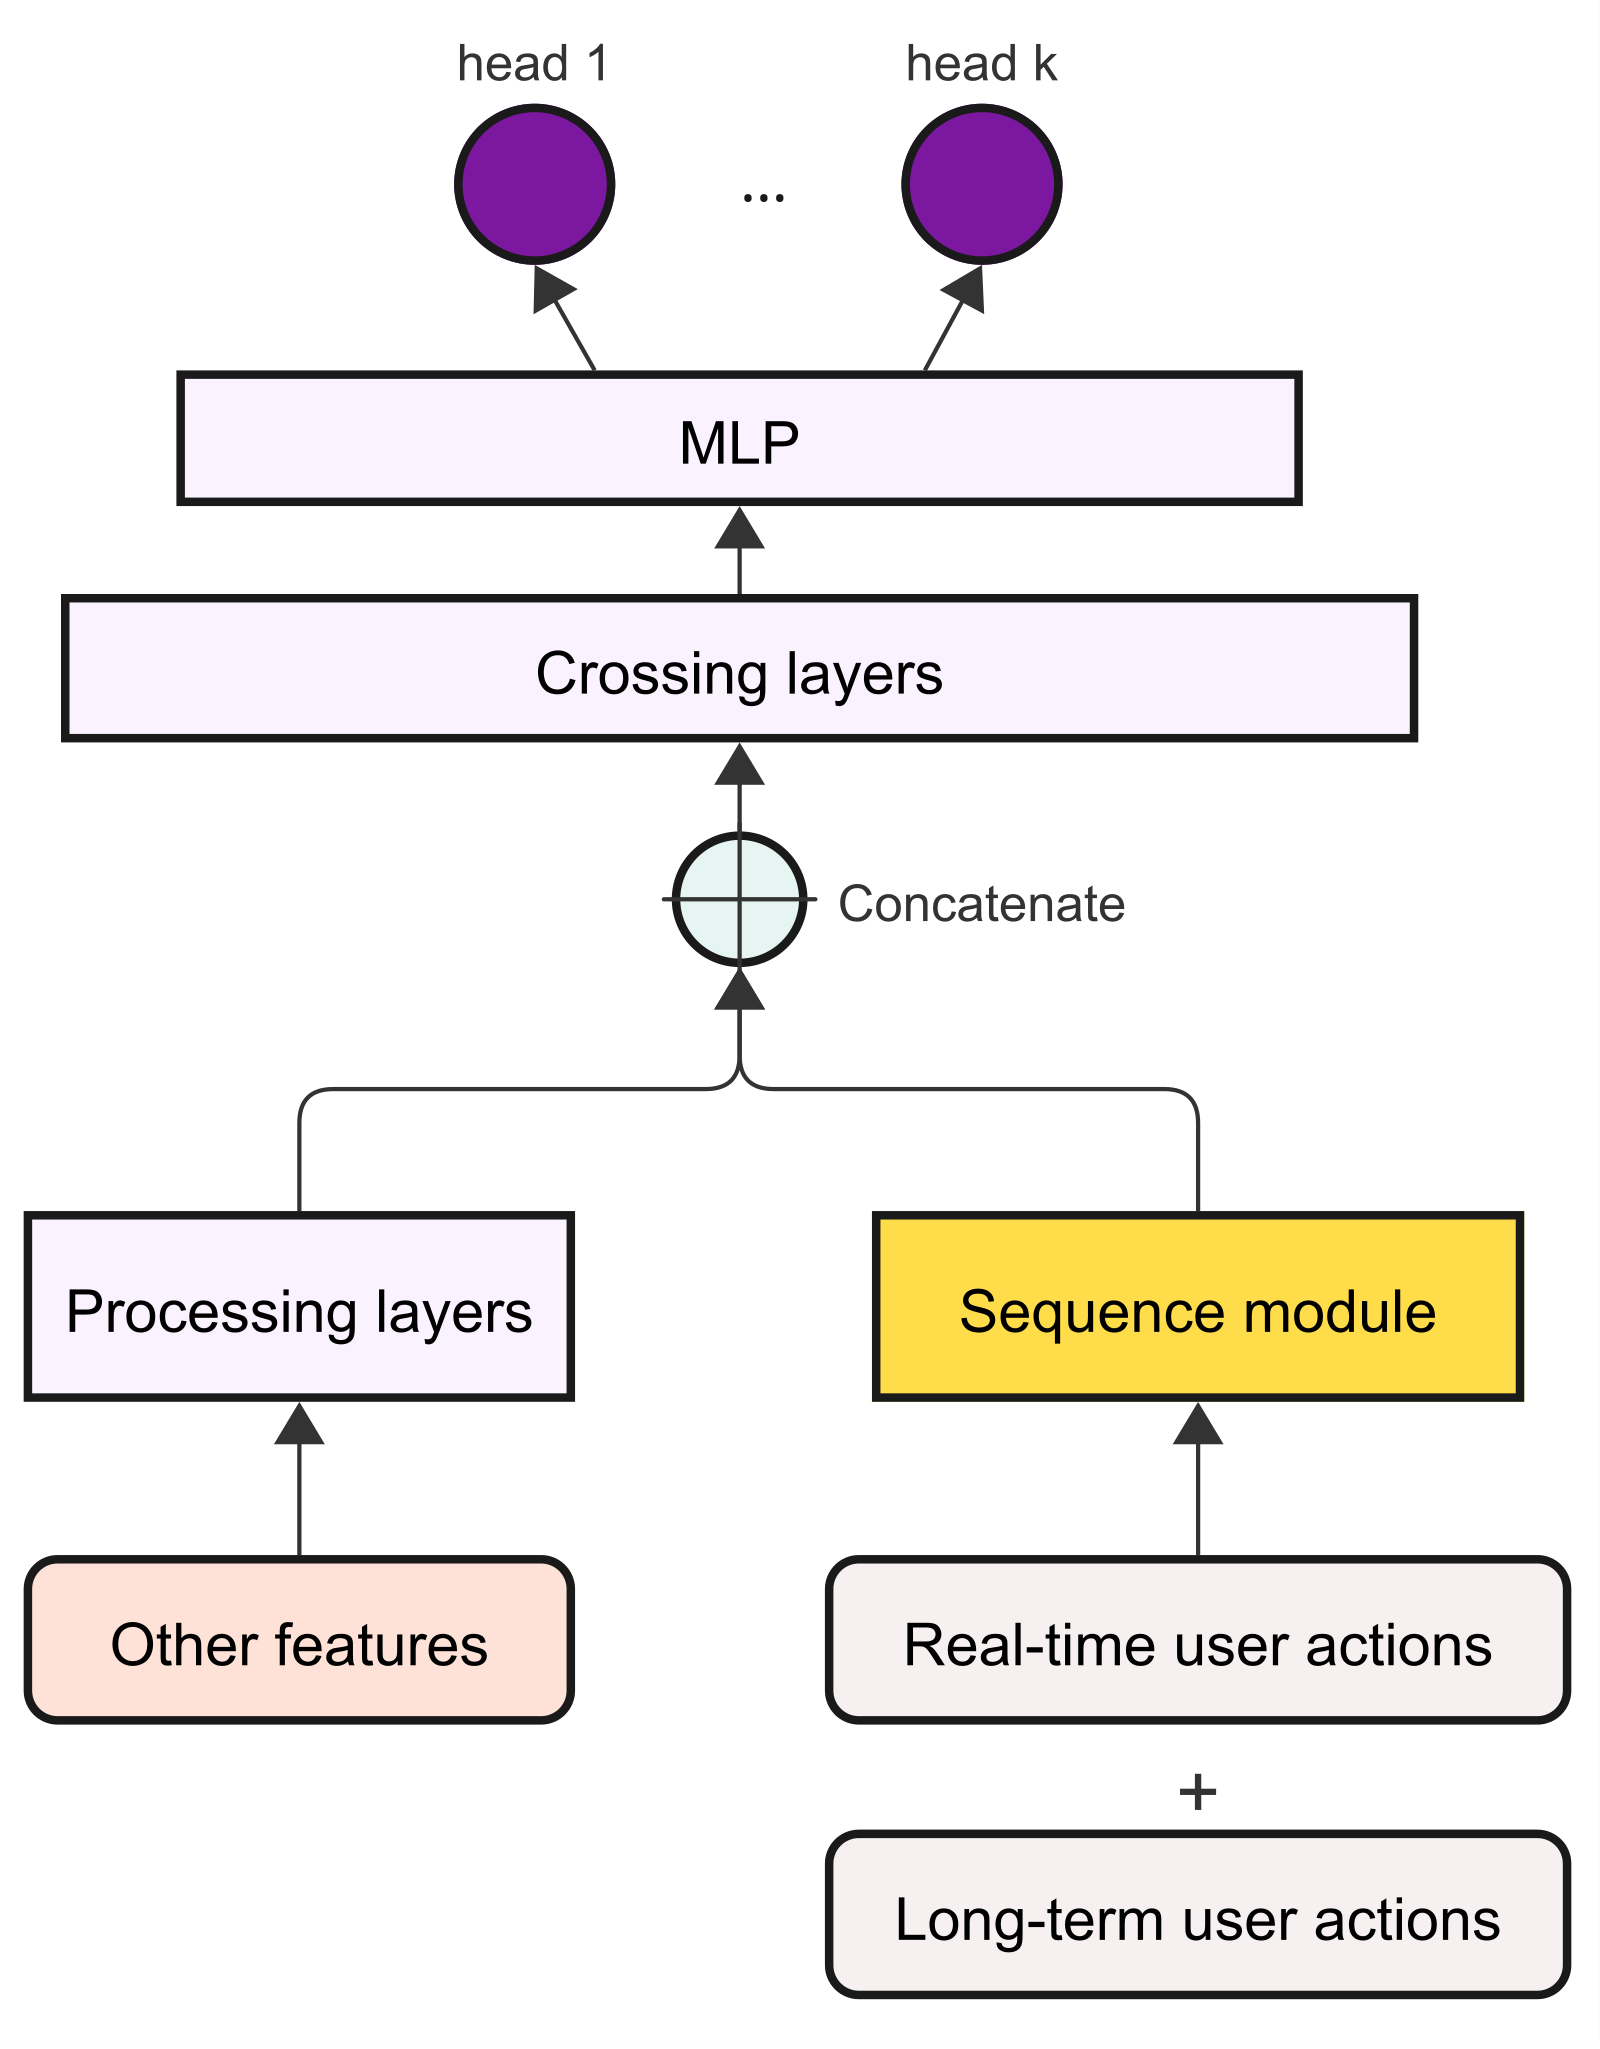
第 4 步的产物是全文最该记住的中间结果。示意:柚木餐桌这次打分,送进 Transformer 的序列大致长这样,每一行是一个 token,竖线隔开的是拼接前的字段。
[query token]  户外餐桌椅
[候选 token]   柚木餐桌
[最近行为]     点击 | 床头灯 A | 柚木餐桌 | 床头灯 A 的属性 | 柚木餐桌的属性 | 搜索结果页 | 2 天前
……(共 100 条)
[候选路]       点击 | 柚木边柜 | 柚木餐桌 | 柚木边柜的属性 | 柚木餐桌的属性 | 商品详情页 | 10 个月前
……(共 50 条)
[query 路]     点击 | 庭院遮阳伞 | 柚木餐桌 | 遮阳伞的属性 | 柚木餐桌的属性 | 搜索结果页 | 8 个月前
……(共 50 条)
序列里的床头灯、柚木边柜和遮阳伞三类行为,每一行都写着「柚木餐桌」。这个重复是有意的。后面的消融(逐个去掉某个设计、看指标掉多少)里,去掉它造成的两项 AUC 下降最大。
两路检索各自挑到的历史
检索只在最近 100 条以外的行为里做,这样 100 个检索名额都花在模型原本读不到的行为上。候选路比较的是「旧行为对应的商品」和「正在打分的商品」有多像,query 路比较的是「旧行为对应的商品」和「这次搜的词」有多相关。两路用的表示都来自 Wayfair 内部的语义搜索模型,排序模型训练时不更新它们。候选路的商品 embedding(把商品表示成一串数字的向量)只有 32 维,这样线上做 ANN 查询(近似最近邻搜索,快速找出向量最接近的行为)时的计算和内存开销都比较小。
示意:这位用户有 1000 条行为,最近 100 条单独放,检索池就是 900 条。两路各挑 50 条,假设其中 10 条被两路同时挑中,同一次行为只保留一份,历史长度就是 100 + 50 + 50 − 10 = 190。所以论文说的 200 条是上限,两路重叠越多,序列越短。
换一件候选商品,看两路的差别。同一次搜索里给铝合金餐桌打分时,query 路的 50 条不变,因为 query 还是「户外餐桌椅」;候选路的 50 条会换成和铝合金餐桌相近的行为。这说明 query 路挑的是和这次搜索有关的历史,候选路挑的是和这件商品有关的历史。
100 这个数沿用了线上已有的序列长度,两路各 50 条是为了让总长度放进线上服务预算。作者把 100/50/50 称为线上可用的配置,并没有穷举搜索最优分配。
为什么要把候选商品写进每一条旧行为
更简单的做法是:历史 token 只描述行为本身,序列前面放一个候选 token,靠 attention 让候选商品和历史行为发生交互。这样同一位用户的历史 token 不随候选商品变化。后面的消融会看到,只走这条路,效果差很多。
Wayfair 的做法更直接。每个历史 token 由一个 MLP(多层全连接网络)算出,输入是拼接在一起的行为类型、历史商品、候选商品、两件商品的属性和发生行为的页面。MLP 的输出再加上时间 embedding(这条行为离现在多久)和一个位置类型 embedding(标明这是历史位置)。把候选商品放进每个历史 token 的做法,论文叫 early fusion。
示意:历史有 190 条,这次搜索有 2 件候选,为了只看 early fusion 的作用,假设两件候选用的是同一份历史。用 early fusion 时,「柚木边柜」这条行为面对柚木餐桌和铝合金餐桌会生成两个不同的 token。MLP 直接拿到「柚木边柜 + 柚木餐桌」这一对商品,一共要算 190 × 2 = 380 个历史 token。不用 early fusion 时,两件候选面对的 190 个历史 token 完全相同,两件候选的差别只能靠候选位置经 attention 传递。 Hoot 说

给柚木餐桌打分
- 最近 100 条
- 近期行为
- 查询 50 条
- 遮阳伞等
- 候选 50 条
- 柚木家具等
- 行为 embedding
- 算一次
- 历史 token
- 每条含柚木餐桌
- c token
- 柚木餐桌
- q token 输入
- 户外餐桌椅
- 两层 Transformer
- 跑一遍
c 走两条路:逐条进历史直接配对,单独成 token 和全序列 attention。消融里关 early fusion 或去掉 context token 都明显变差。
换成铝制餐椅
- 最近 100 条
- 不变
- 查询 50 条
- 不变
- 候选 50 条
- 重新检索
- 行为 embedding
- 可复用
- 历史 token
- 全部重算
- c token
- 换成餐椅
- q token 输入
- 不变
- 两层 Transformer
- 再跑一遍
第一层 c token 只看自己和 q token。只遮历史之间的 attention 不够:它能看到未来动作,下一层再传回更早的历史。
示意:用户搜「户外餐桌椅」,两件候选都是假设。c 进了 token 的 MLP,所以同一条旧行为遇到新候选也要重算;只有不含 c 的 embedding(动作、历史商品、surface、时间)能复用。示意成本:一次请求 30 个候选、序列都取满 200 条,token MLP 共 30×200=6000 次。如果历史 token 不含候选,最近 100 条和查询 50 条共 150 条只算一次,总数降到 150+30×50=1650 次(不计去重)。但序列里还有 c token 和候选 50 条,两层 Transformer 仍要每个候选各跑一遍。
出处
论文 §3.2 历史 token 公式(c 进入 MLP_token)与 context token;§3.3 混合 attention;§4 序列配置与消融;候选、30 个候选和成本都是示意,依赖关系按 token 公式推出early fusion 只拼候选商品,历史 token 的字段里没有 query。query 的信息要进入序列,靠的是下一节介绍的 query token。
序列最前面的两个位置带进 query,也汇总整段历史
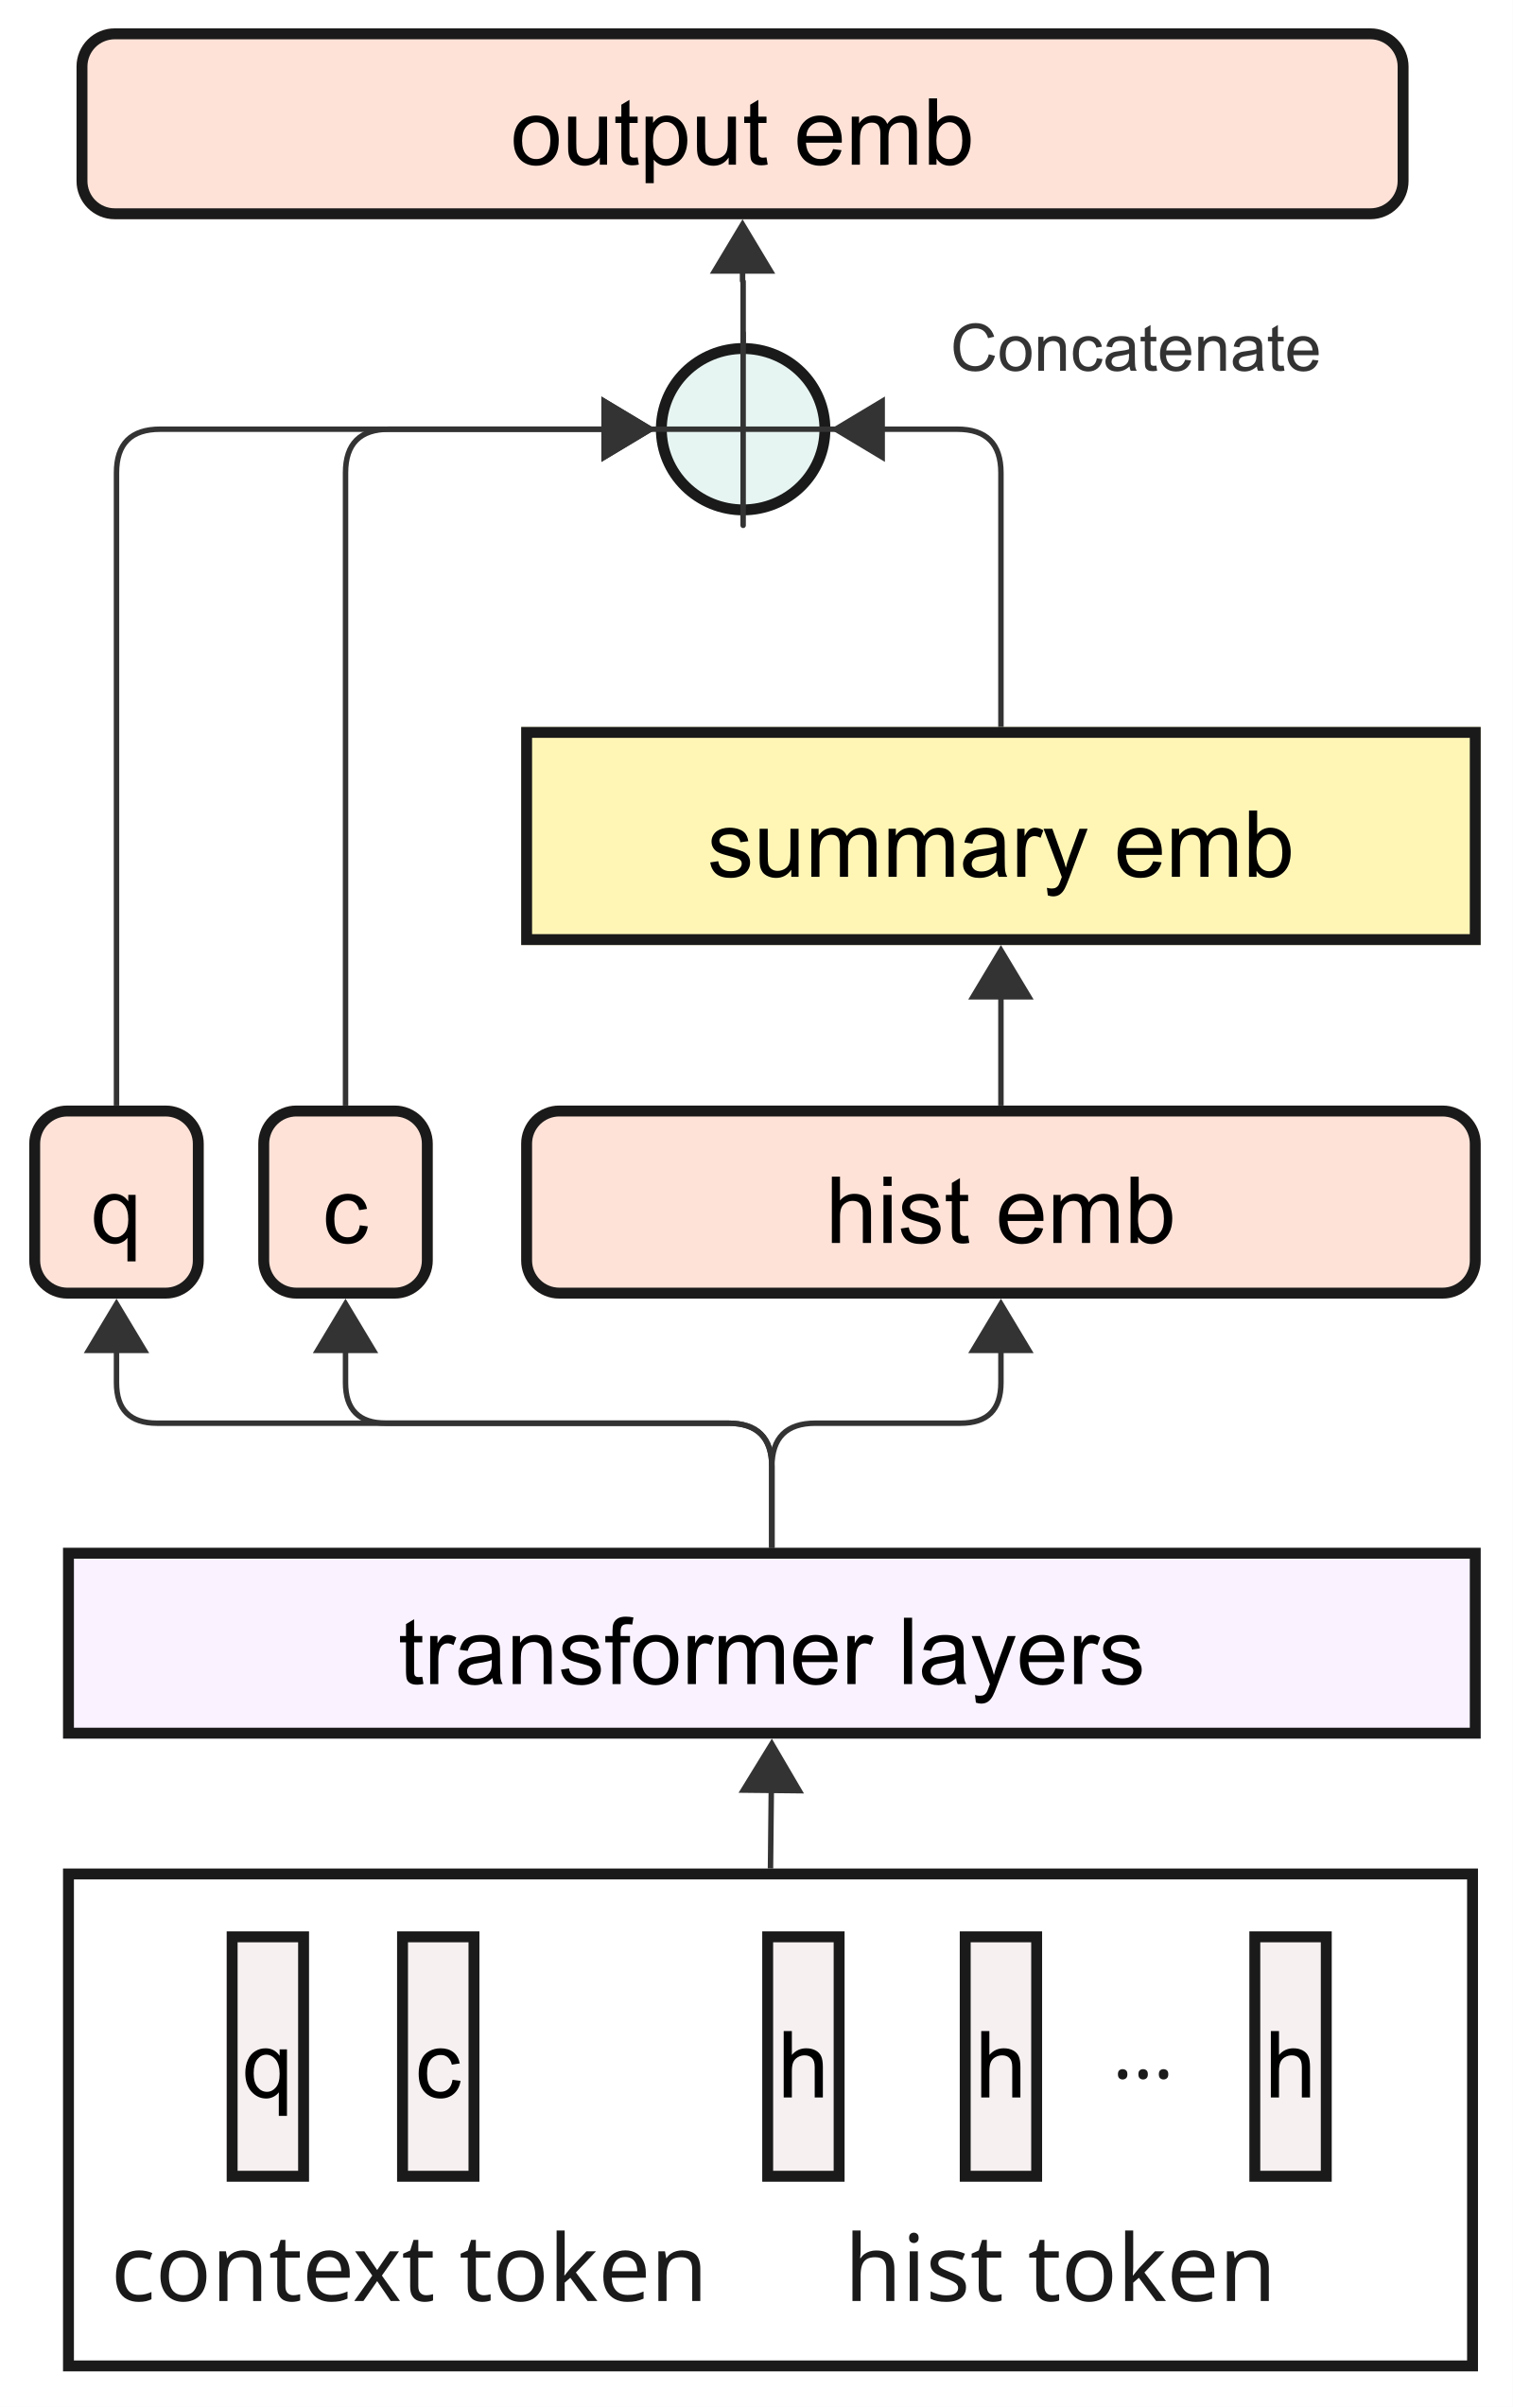
early fusion 处理的是「每条行为和候选商品」的一对一关系,它没有地方放 query,也没有一个位置去汇总整段历史。所以 Wayfair 在序列最前面放了两个 token:query token 由 query 的表示加上位置类型 embedding 得到,候选 token 同理由候选商品得到。
这两个位置和历史 token 一起过 Transformer,最后它们各自的输出会单独拼进序列向量。示意:第 2 层里,query token 给三条历史行为的 attention 权重分别是遮阳伞 0.6、藤编餐椅 0.3、床头灯 0.1。那么 query 位置的输出主要由遮阳伞的信息决定,这份信息接着进入排序预测。
如果拿掉这两个 token,query 就只决定挑哪 50 条行为,序列模块内部不再有 query 本身的表示。后面的消融专门测了这种情况。
辅助任务要求 attention 只能单向流动
Wayfair 在排序 loss 之外加了一个权重 0.05 的辅助任务,叫 next-action loss(NAL):用最近序列里某一条行为的表示,预测用户下一条行为的商品。正例是真实的下一件商品,负例是同一 mini-batch(一起训练的一小批样本)里其他样本的下一件商品。NAL 只在最近 100 条这段连续序列上算,因为检索来的行为在时间上是跳着的。
既然是预测下一步,历史位置就不能读到未来。常规做法是加 causal mask,让每个历史位置只能读更早的历史位置。序列前面多了两个 token 之后,这个 mask 就不够了。
示意:最近序列有 6 条行为,NAL 用第 5 条的表示预测第 6 条,答案是「床品 B」,并假设 NAL 接在第 2 层之后。第 1 层里,query token 可以读全序列,读到了第 6 条。第 2 层里,第 5 条读 query token,第 6 条的信息就进了第 5 条的表示。causal mask 拦不住这条路径,因为第 5 条读的是 query token,并没有直接读第 6 条。
论文的办法是把信息流向限制成单向。前 M 层里,历史位置之间只能读过去,历史位置可以读 query token 和候选 token,这两个 token 只能读自己和彼此。NAL 用第 M 层的历史表示计算。这样 query 和候选商品的信息可以流进历史位置,未来行为的信息却流不回来。
M 层之后的 attention 完全放开,这部分只用排序 loss 训练。排序要预测的是这次曝光,所有历史行为都发生在请求之前,全部放开不会读到未来。放开之后,query token 和候选 token 才能读到整段历史。Wayfair 的实验里一共 2 层,第 1 层按上面的规则限制,第 2 层放开。
离线消融:拿掉 early fusion 跌得最深
作者在 Wayfair 的内部数据上,用一个月的留出测试集比较 grouped click AUC 和 7 天下单 AUC。AUC 衡量模型能否把真正被点击或下单的样本排在其他样本前面,越高越好。表里的数字都是相对线上基线的百分比变化,基线只读最近 100 条,已有 early fusion,没有两个 token,也没有 NAL。
| 配置 | 历史来源 | 两个 token | early fusion | NAL | 点击 AUC 变化 | 7 天下单 AUC 变化 |
|---|---|---|---|---|---|---|
| M0 | 只有最近行为 | 有 | 有 | 有 | +0.46% | −0.61% |
| M1 | 最近 + 候选路 | 有 | 有 | 有 | +1.16% | +1.35% |
| M2 | 最近 + query 路 | 有 | 有 | 有 | +1.00% | +1.16% |
| M3 | 最近 + 两路 | 有 | 有 | 有 | +1.37% | +2.19% |
| M4 | 最近 + 两路 | 无 | 有 | 有 | +0.45% | +0.28% |
| M5 | 最近 + 两路 | 有 | 有 | 无 | +1.11% | +1.46% |
| M6 | 最近 + 两路 | 有 | 无 | 有 | −4.71% | −6.06% |
M0 只加两个 token 和 NAL,不加任何长期行为,点击 AUC +0.46%,7 天下单 AUC 反而 −0.61%。这说明只有最近行为时,query token、候选 token 和 NAL 不足以同时提升点击和下单两项指标。我的理解是,它们要和长期行为配合才能体现价值。
M1、M2、M3 也都带着两个 token 和 NAL,所以要和 M0 比,才能看出检索本身的作用。只用候选路,7 天下单 AUC 是 +1.35%;只用 query 路,是 +1.16%;两路一起,是 +2.19%。两路一起比任何一路都高,这说明第二路带来了第一路没有的信号,作者称两路互补。两路一起又低于两路相加,我的理解是两路挑到的行为有一部分重复(比如一把柚木户外长椅,两路都可能挑中)。
点击 AUC 上,两路一起只比候选路单用高一点,+1.37% 对 +1.16%。这批离线实验没有留下置信区间这类误差范围,作者也提醒,相近配置之间的小差距要谨慎解读,重点看幅度大、方向一致的变化。
M4 去掉两个 token,点击 AUC 的提升从 +1.37% 掉到 +0.45%,7 天下单 AUC 的提升从 +2.19% 掉到 +0.28%。这说明两个 token 提供了 early fusion 给不了的信息,长期行为的收益有很大一部分要靠它们才拿得到。
M5 去掉 NAL,两项提升分别降到 +1.11% 和 +1.46%,影响比去掉两个 token 小,作者据此认为 NAL 有一个较小的正贡献。
M6 的变化最大:两路检索和两个 token 都保留,只去掉 early fusion,点击 AUC 就比基线低 4.71%,7 天下单 AUC 比基线低 6.06%。作者检查了 M6 的训练和验证曲线,优化过程正常,所以把差距归因于结构变化。这说明只靠候选 token 和 attention 间接建立「这条行为和这件候选商品配不配」的关系,在这个排序任务上不够用。
完整新方法(两路检索加两个 token 和 NAL)把 7 天下单 AUC 提高了 2.19%,而基线已有的 early fusion 一旦拿掉,7 天下单 AUC 比基线还低 6.06%。
M6 掉的这部分不能记成这篇论文新方法的贡献,因为 early fusion 本来就在基线里,作者也专门说明了这一点。所有对照都是 Wayfair 自己的线上模型,作者明确表示没有和 TWIN、TransAct V2 这类长序列系统做同条件比较。
上线五周:每次曝光订单多 11.5%,延迟增加约 12%
线上实验跑了五周,按用户随机分流,流量是真实的搜索广告流量,对照组是线上生产模型。下面的数字都是相对变化,在 α=0.05 下全部显著,也就是把「其实没效果却判成有效」的概率控制在 5% 以内。
点击率 +6.0%,归因转化率 +5.2%,每次曝光带来的订单 +11.5%。这三个数能对上:1.06 × 1.052 约等于 1.115。这说明订单增量来自两段同时变好,用户更常点广告,点了之后也更常下单。
单次点击的费用(CPC)−1.3%,广告总花费 +0.8%。这说明总花费只小幅上升,提升主要体现在每次曝光带来了更多点击和订单。作者的解读是,这些结果符合匹配变好、成交量变高的情况。
代价是端到端的模型服务延迟增加约 12%,仍在原有的延迟预算之内。延迟增加主要来自候选路的数据拉取和更长的序列,整体延迟的大头仍是拉取上游模型输出的特征。这说明两路检索加 200 条序列在 Wayfair 的线上环境里跑得动,但候选路和更长的序列都要付延迟成本。
回到开头那次打分:最近 100 条说明用户这两周在看床头灯,候选路找回柚木边柜,query 路找回遮阳伞,每条行为又都带着柚木餐桌的信息。遮阳伞能不能被挑中,完全取决于语义搜索模型给出的表示,而排序训练并不会修正这些表示。作者把改进这些表示,以及按 query 具体程度、行为类型等调整检索名额,列为下一步要做的事。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Personalization · 2026-05-13UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence快手把超长行为序列的用户表示改成按候选的 Semantic ID 分组共享:用候选的第一层 SID 当 query,对完整历史和 16 个压缩兴趣锚点各做一次 attention,按“用户 × SID”离线存好,线上只查一次表,延迟多 0.16 毫秒。工业数据 CTCVR AUC 从 TWIN 的 0.8609 提到 0.8626,一周广告 A/B 收入涨 0.337%。把 SID 换成类目当 query,AUC 掉得比去掉任何模块都多,而 XLong 上的大幅领先样本太少,要打折看。
 Personalization · 2026-09-10SequenceO1: End-to-End Ultra-Long (100K) Sequence Modeling in Recommendation with Low-Rank Caching这篇论文最值得看的地方,是它把超长行为序列的计算从按候选重复做改成了每个用户只做一次。字节跳动的 SequenceO1 先把用户最多 10 万条历史行为压成一份固定大小、与候选无关的摘要并缓存起来,同一用户的所有候选和相邻请求都复用它;每个候选只对这份摘要和最近的行为做交叉注意力,不再逐个重读整段历史。按论文的公式估算,推理时这一路每个候选的计算量比直接读整段历史少约 64 倍。在抖音上线一个月,用它替换原来的终身兴趣模块后,完播提升 2.33%,不喜欢下降 6.98%。
 Personalization · 2026-09-02CAMIE: Co-Engagement-Aware Multimodal Item Embeddings for Snap Dynamic Product Ads RetrievalCAMIE 面向 Snap 动态商品广告的 I2I 召回,把图像与商品元数据送入同一 LLM/MLLM 原生多模态接口,再用用户旅程挖掘的共参与商品对和对称式 in-batch InfoNCE 对齐转化行为。线上替换两个内容编码器后,相对多模态对照 CTR +0.390%、CVR +10.832%,整体 DPA 流量 CTR +0.211%、CVR +1.911%。
 Personalization · 2026-11-02Read More, Reason Deeper: Latent Workspaces for Long-Sequence RecommendationMeta 这篇论文给长序列排序换了一种结构,让多读历史和多堆层数成了两个可以分开调的旋钮:在 1 万条历史上,NE 比 HSTU 好 0.19%,前向计算量少了 69.6%。现有模型把两件事绑在一起:序列编码器每多读一条行为,每层都要多算一份;先挑相关行为再建模的做法只挑一次,后面的层看不到漏掉的行为。LWR 给每个候选配一小组固定数量的向量当草稿区,一部分由候选特征生成,一部分是所有候选共用的学出来的向量;每一层由草稿区生成查询,去完整的历史里加权读取,读回的结果再更新草稿区,传给下一层。多读历史和多堆层数可以分开加。
 Personalization · 2026-10-22ECHO: Efficient Cascade with Homogeneous Operators for Distillation-Guided 100K-Sequence Modeling十万条历史行为让候选逐一匹配的成本过高,作者先筛选可复用的原始记录,再按候选查找证据。筛选器向完整历史教师学习,并让检索与聚合共享相关性参数。快手线上实验中,应用使用时长提高0.613%。
 Personalization · 2026-09-30HELIX: Purified and Unified - Rethinking Feature Interaction and Sequence Modeling for Large-Scale Recommendation论文面向大规模推荐排序中异构特征交互与长行为序列建模难以同时扩展的问题,提出 HELIX:交替执行序列检索和特征交互,并让可复用的用户序列状态单向流向候选相关的混合 token。该设计把用户侧计算摊销到多个候选上。TikTok 电商线上 A/B 测试报告每用户视频成交额约提升 6%,同时离线 CTR 与 CVR AUC 改善。
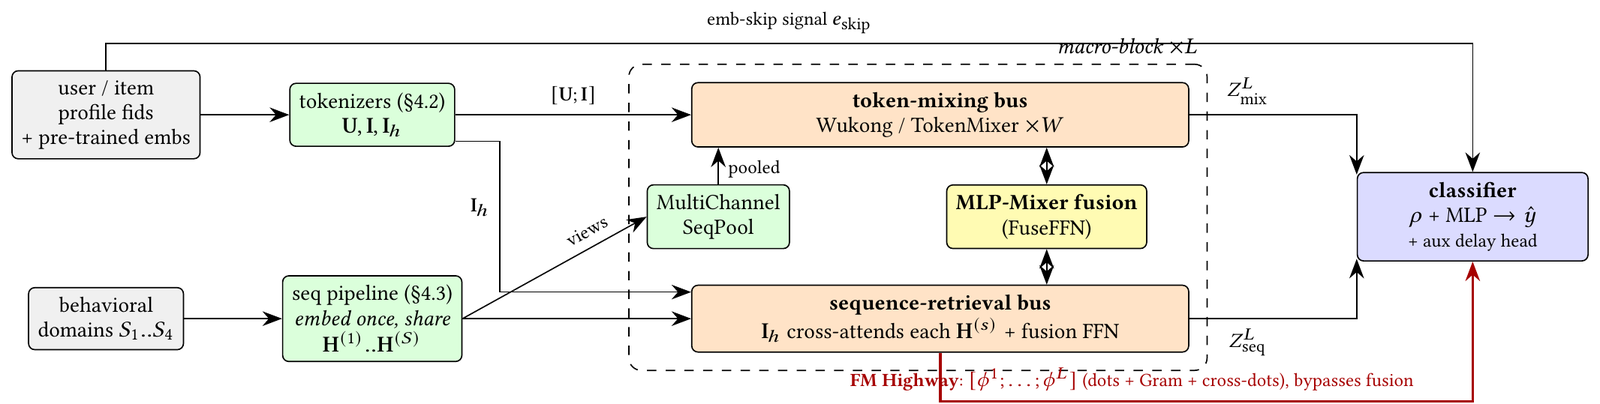 Personalization · 2026-08-19UniDot: A Unified Network for Sequence Modeling and Feature Interaction in Large-scale Recommendation排序模型通常把字段交叉和行为序列分成两个塔,到最后一层才拼在一起。UniDot 把用户、物品字段和多域行为序列都变成同一空间的 token,用两条并行通路一起处理,每层交换一次信息;同时把每层算出的点积原样拼起来,绕过融合层直接送进分类器。它在腾讯广告转化预测比赛中拿到 AUC 0.83217,排第 2。最值得借鉴的是两个便宜的部件:消融里这条点积旁路贡献最大;两条通路互相蒸馏、上线只用一条,AUC 仍有 0.83184,推理时间减半。
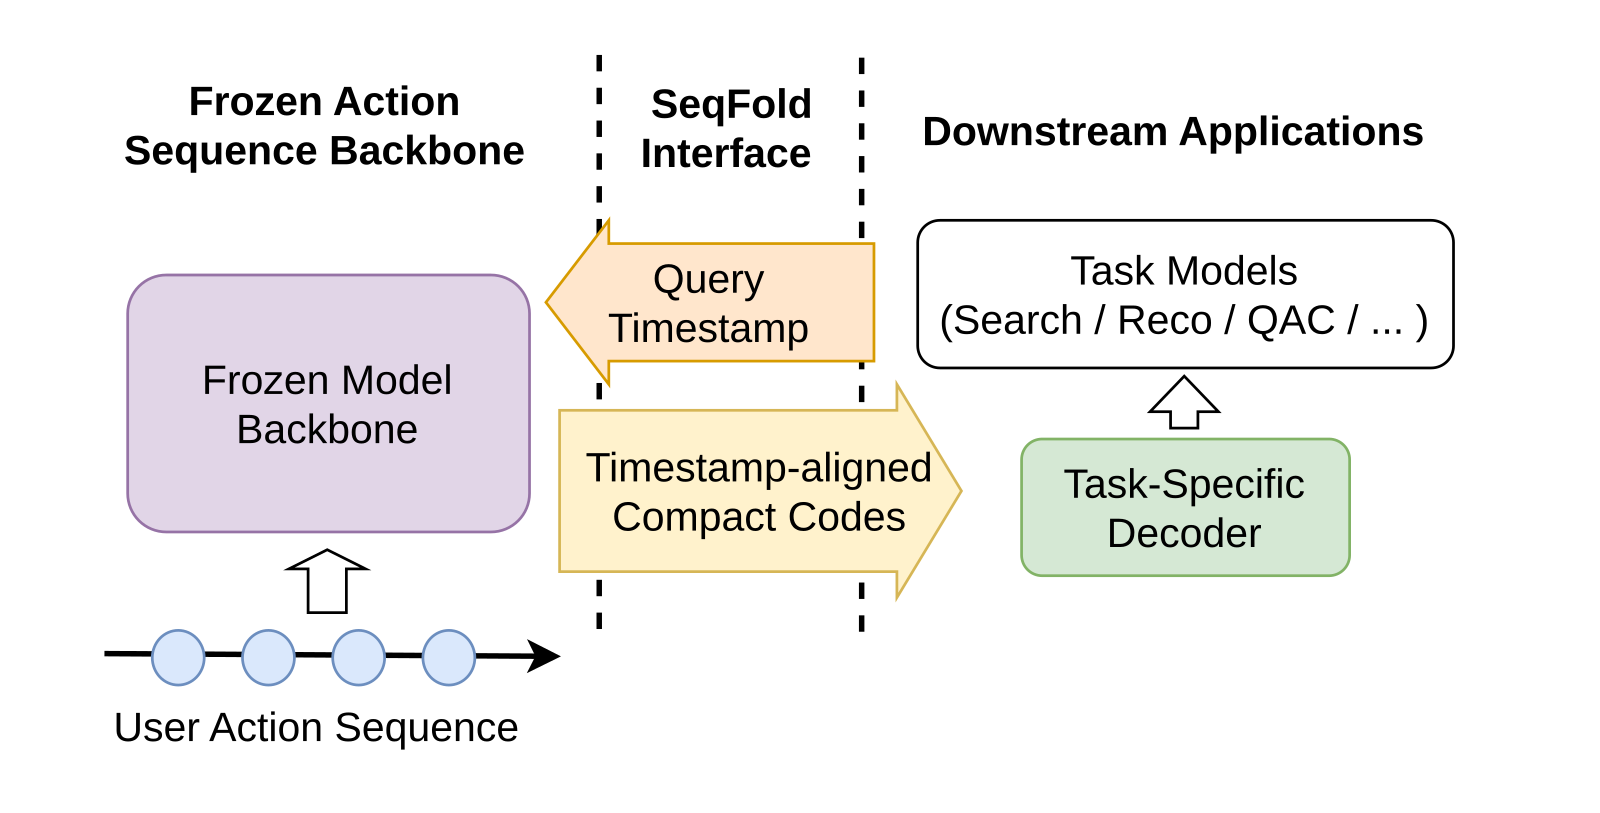 Personalization · 2026-11-12SeqFold: Timestamp-Addressable Compressed States for User Action Sequence Backbones一个冻结的长序列用户模型,下游的搜索和推荐模型都想复用它的输出,但每个用户在一个时间点的完整多层隐状态平均有几百万字节,存不下也传不动。Coupang 的 SeqFold 把每一层的隐状态压成固定数量的兴趣槽:每条历史行为由学到的门控决定往每个槽里放多少,越早的行为权重衰减得越多,每个槽最后量化成一串很短的二进制码。下游按目标时间点取出那一刻之前的码,再用各自的解码器还原成 embedding。存储因此小了 3,400 倍,不压缩的完整版本只比它高 2.11%。压缩前先学会该留什么,比直接截取最近的行为强得多。只留最近 64 条行为的做法占的存储更多,效果反而差得更多。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…