目录 · 8 节
1一份 2 KB 的状态是怎么来的2一个行为可以同时写进好几个通道3每个通道自己决定记多久4最后把每个融合向量压成一个 64 位整数5每个行为都更新,只在被请求的时间戳导出6最近 64 个行为占 262,144 字节,仍比 2 KB 的 SeqFold 低 3.98%7通道数、融合层数、衰减方式各自的消融差值8同一份码交给搜索和 QAC
Coupang 这篇 SeqFold 讲的是怎么把一个冻结的长历史用户序列模型交给下游用:下游每条样本只需要「那一刻之前的用户状态」,所以只在被请求的时间点导出一份 2 KB 的码就够了。
Coupang 有一个已经训练好、定期刷新的用户行为序列模型:4 层 Transformer,隐维 256,每个用户最多取 2,000 个行为,平均约 1,700 个。它的主任务是预测用户下一个行为属于哪种类型。搜索、推荐、QAC(query 自动补全,用户敲了半个词时补全成完整 query)都想复用它对用户的理解,但不想重训它,也不想改它的结构。
难点在下游样本的形状。贯穿全文用一个示意例子:一位用户有 1,700 个行为,周二晚 9 点做了一次搜索。搜索模型拿这次搜索当一条训练样本时,只能用 9 点之前的行为,否则就会偷看到答案。要是把骨干的原始输出原样塞进去,就是 1,700 个行为 × 4 层 × 256 维,共 1,740,800 个浮点数,按 FP32 算约 6.96 MB。而一条下游样本原本只有几百个特征。
作者对比了几种只保留部分信息的基线,包括截断、池化和采样。最直接的是截断:只存最近 64 个行为的隐状态。放回示意例子里,这位用户三个月前反复看过婴儿车,最近 64 个行为都在比较手机壳,截断后搜索模型就看不到婴儿车了。另一种是把末层所有行为平均成一个 256 维向量,婴儿车和手机壳被揉在一起,谁也分不出来。还有一种是给每个用户算一个静态 embedding,但它对齐的是生成那一刻;上个月的训练样本如果用了今天算出的 embedding,就混进了样本之后才发生的行为。
SeqFold 的做法是在骨干之后加一层压缩接口。下游拿着时间戳来查,它返回这个时间点之前的状态,大小固定为 2,048 字节。在作者的私有数据上,这比存完整多层隐状态小约 3,400 倍,上游指标只比完整状态低 2.11%(相对值)。
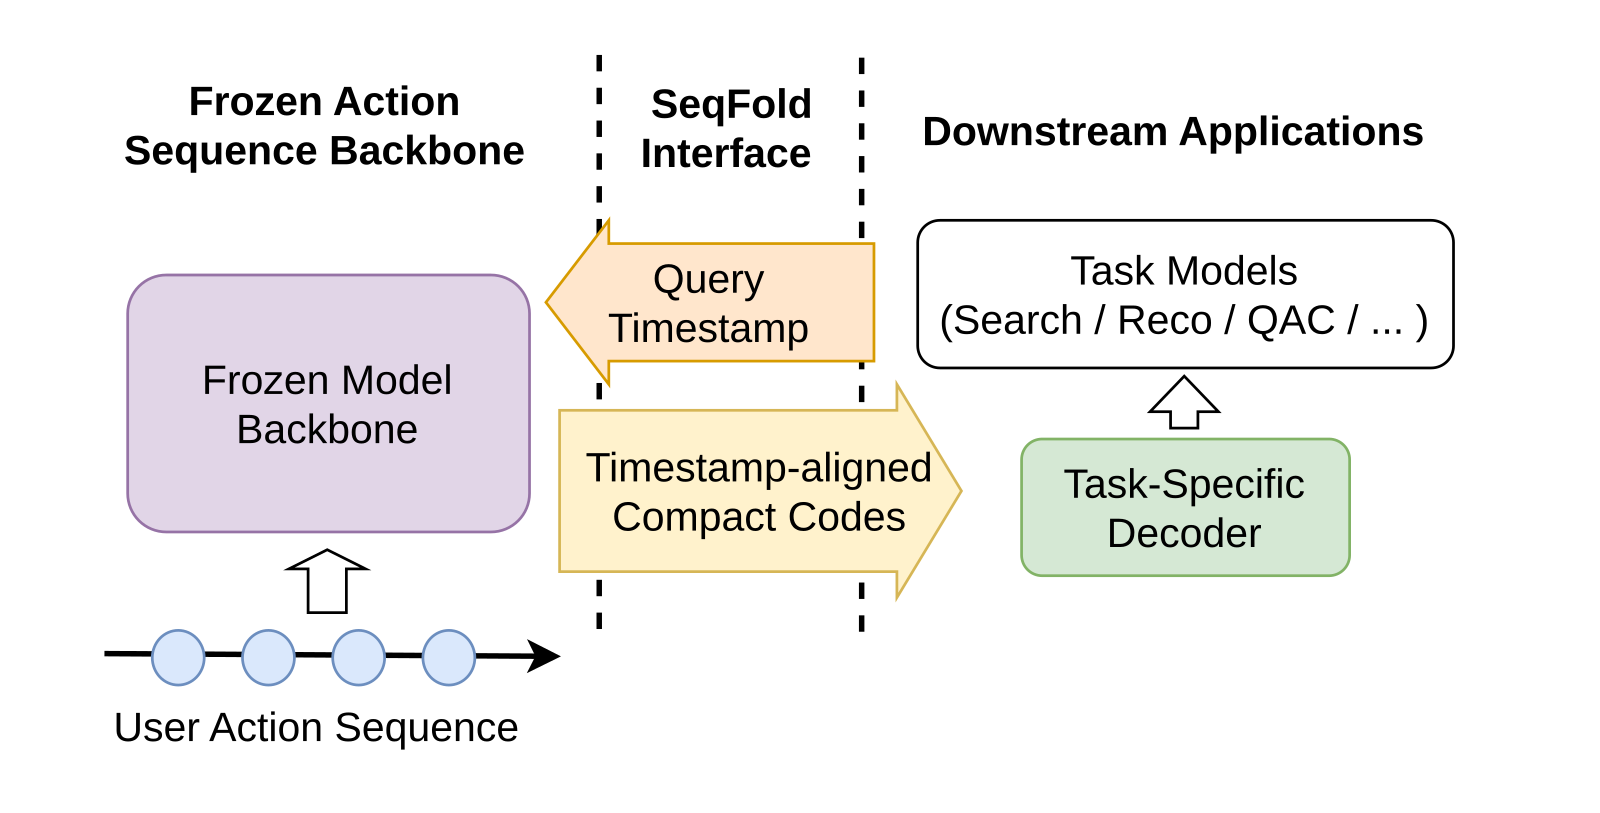
一份 2 KB 的状态是怎么来的
先看一个用户、一个时间戳走完的全过程。骨干冻结不动,SeqFold 只读它每一层对每个行为算出的隐状态。骨干本身是因果的,每个历史行为的隐状态只看它之前的行为,所以只取目标时间之前的状态,就不会看到答案。
| 步骤 | 输入 | 操作 | 产出 | 只在训练时存在 |
|---|---|---|---|---|
| 1 | 用户的行为序列 | 冻结骨干逐层编码 | 每层每个行为一个 256 维隐状态 | 否 |
| 2 | 某层每个行为的隐状态 | 64 个独立门控各打一个 0 到 1 的权重 | 这个行为写进每个通道的份额 | 否 |
| 3 | 带权重的行为 | 按通道各自的时间衰减累加 | 每层 64 个 256 维连续向量(融合向量) | 否 |
| 4 | 融合向量 | RMSNorm 后用 LFQ 量化 | 每层 64 个 64 位整数 | 否 |
| 5 | 码 | 训练用解码器还原,再让当前行为做交叉注意力,用骨干同样的行为预测目标打分 | 训练压缩器的梯度 | 是 |
| 6 | 码 | 每个下游学自己的解码器,输出维度自选,再做交叉注意力 | 下游模型的用户特征 | 否 |
这里的「通道」是 SeqFold 每层维护的 64 个累加器,每个累加器装一个 256 维向量。第 5 步只用来训练压缩器,训完就扔;真正交给下游的是第 4 步的码。下面按第 2 到第 4 步拆开讲。 Hoot 说

- 示意:要预测第 4 次行为,码 Q₃ 只装第 1–3 次行为,对应论文式 (4) 里 i = 3、i+1 = 4。
- 查询用第 4 次行为的上下文视图。论文把每个行为拆成上下文和标签两部分;要是换成完整视图,标签已经在输入里,等于看着答案做题。
- 每层 64 个码,每个码 64 位;256 维的融合向量怎样变成 64 位,论文未说明。
示意:一个用户的前 4 次行为。训练压缩器时,码只覆盖第 1–3 次,查询来自第 4 次行为的上下文部分,目标是第 4 次的行为类型;这条路径只在训练时存在,下游换成自己的解码器。
出处
论文 §3.1 双流骨干(每个行为拆成上下文和标签两部分,主任务是行为类型预测);§4.1 训练阶段;§4.2 式 (1)–(4);§4.2.2 LFQ;图 3 底部放大图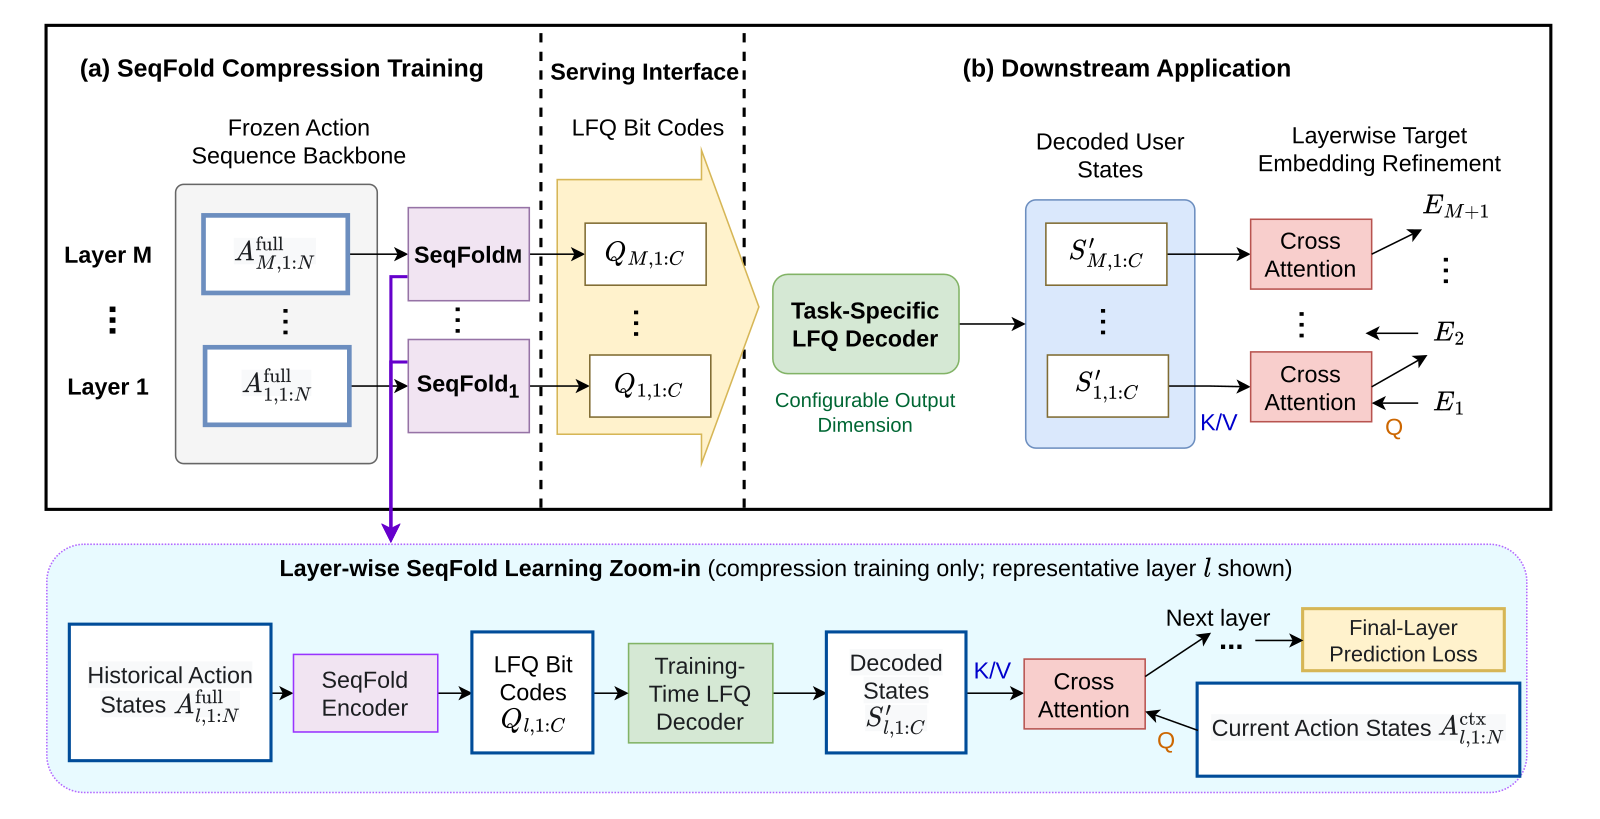
一个行为可以同时写进好几个通道
门控决定一个行为往哪些通道写、写多少。SeqFold 给每个通道单独配一个 sigmoid,而不是在 64 个通道之间做 softmax。
两者差在一个行为能不能同时被几个通道重视。示意:「加购婴儿车」这个行为,假设某两个通道都该记住它。用 sigmoid,两个通道可以各给 0.9 和 0.8;用 softmax,64 个通道的权重加起来必须是 1,这两个通道合起来最多分到 1,各自只剩一半左右。
每个通道自己决定记多久
光有门控还不够:一个行为写进去之后,随着时间过去它该占多大分量?SeqFold 让每个通道的状态等于之前所有行为的加权和,权重是 。其中 是那个行为距今多久, 是这个通道自己学出来的衰减速度。
为什么不全局用一个衰减常数?示意:一个通道一年后还保留 0.9,适合记婴儿车这种低频大件;另一个通道一年后只剩 0.1,适合记最近在比什么手机壳。同一个常数只能二选一。
这也说明 SeqFold 和截断的区别。截断是硬切:第 65 个行为之前的权重直接归零。衰减是软的:三个月前的婴儿车在慢衰减的通道里仍然有分量。
最后把每个融合向量压成一个 64 位整数
到第 3 步,一个时间戳的状态是每层 64 个 256 维 FP32 向量,共 262,144 字节。它已经比完整隐状态小很多,但因为要发给多个下游、为每条历史样本都存一份,所以还是太大。
LFQ(Lookup-Free Quantization)是一种不查码本的量化。融合向量先做 RMSNorm,再交给 LFQ 模块按符号分配比特,映射成一个 64 位的二进制码,正好存成一个 64 位无符号整数。256 维的向量怎样变成 64 位(例如是否先做投影),论文未说明。
所以示意例子里,周二晚 9 点那次搜索最终拿到的是这样一份东西(数值为示意):
用户 u,τ = 周二 21:00
第 1 层:[0x9f3a12c4e8b07d51, 0x04ee7a90c13b62f8, …]   共 64 个 uint64
第 2 层:[…]                                           共 64 个
第 3 层:[…]                                           共 64 个
第 4 层:[…]                                           共 64 个
合计 4 × 64 × 64 位 = 2,048 字节
下游拿到这 256 个整数后,用自己的解码器把每个码还原成连续向量,维度按下游的预算定,可以是 32、64 或 128。再让下游自己的目标(比如这次搜索的候选)对这 64 个向量做交叉注意力。因为只有 64 个向量,交叉注意力的代价跟通道数走,不再跟 1,700 个行为走。
每个行为都更新,只在被请求的时间戳导出
接口定下来后,还有一个工程问题:怎么批量算出这些时间戳状态。直接用张量实现,会给每一个行为前缀都算一份完整状态,张量形状是 [批大小, 行为数, 通道数, 维度]。作者的长历史基准取 10,000 个行为、64 个通道、256 维,单个样本单层就是 1.6 亿多个浮点数,FP32 约 0.66 GB。
可下游只会在少数时间戳来查。作者把「状态更新」和「状态物化」分开:前者每个行为都做,后者只在被请求时做。前面的加权和可以改写成一个递推:
这里 是上一个行为到这个行为之间的衰减, 是门控权重, 是行为的隐状态。示意一个标量版本:第 1 个行为写入 2,所以 ;第 2 个行为到来时 、写入 4,于是 ,和直接按加权和算的结果一样。扫描时每个通道只需要手里这一个 ,不用留下每个前缀的副本。
被请求的时间戳 取的是严格早于 的最后一个行为之后的状态。在示意例子里,如果 20:58 有一次点击、21:00 是这次搜索,导出的就是 20:58 那次点击之后的状态。作者用 Triton 写了一个融合 kernel,把门控、衰减、累加和导出放进同一次按时间顺序的扫描。反向传播时只存最终状态和周期性的 FP32 检查点,再倒着扫回去重建中间状态。
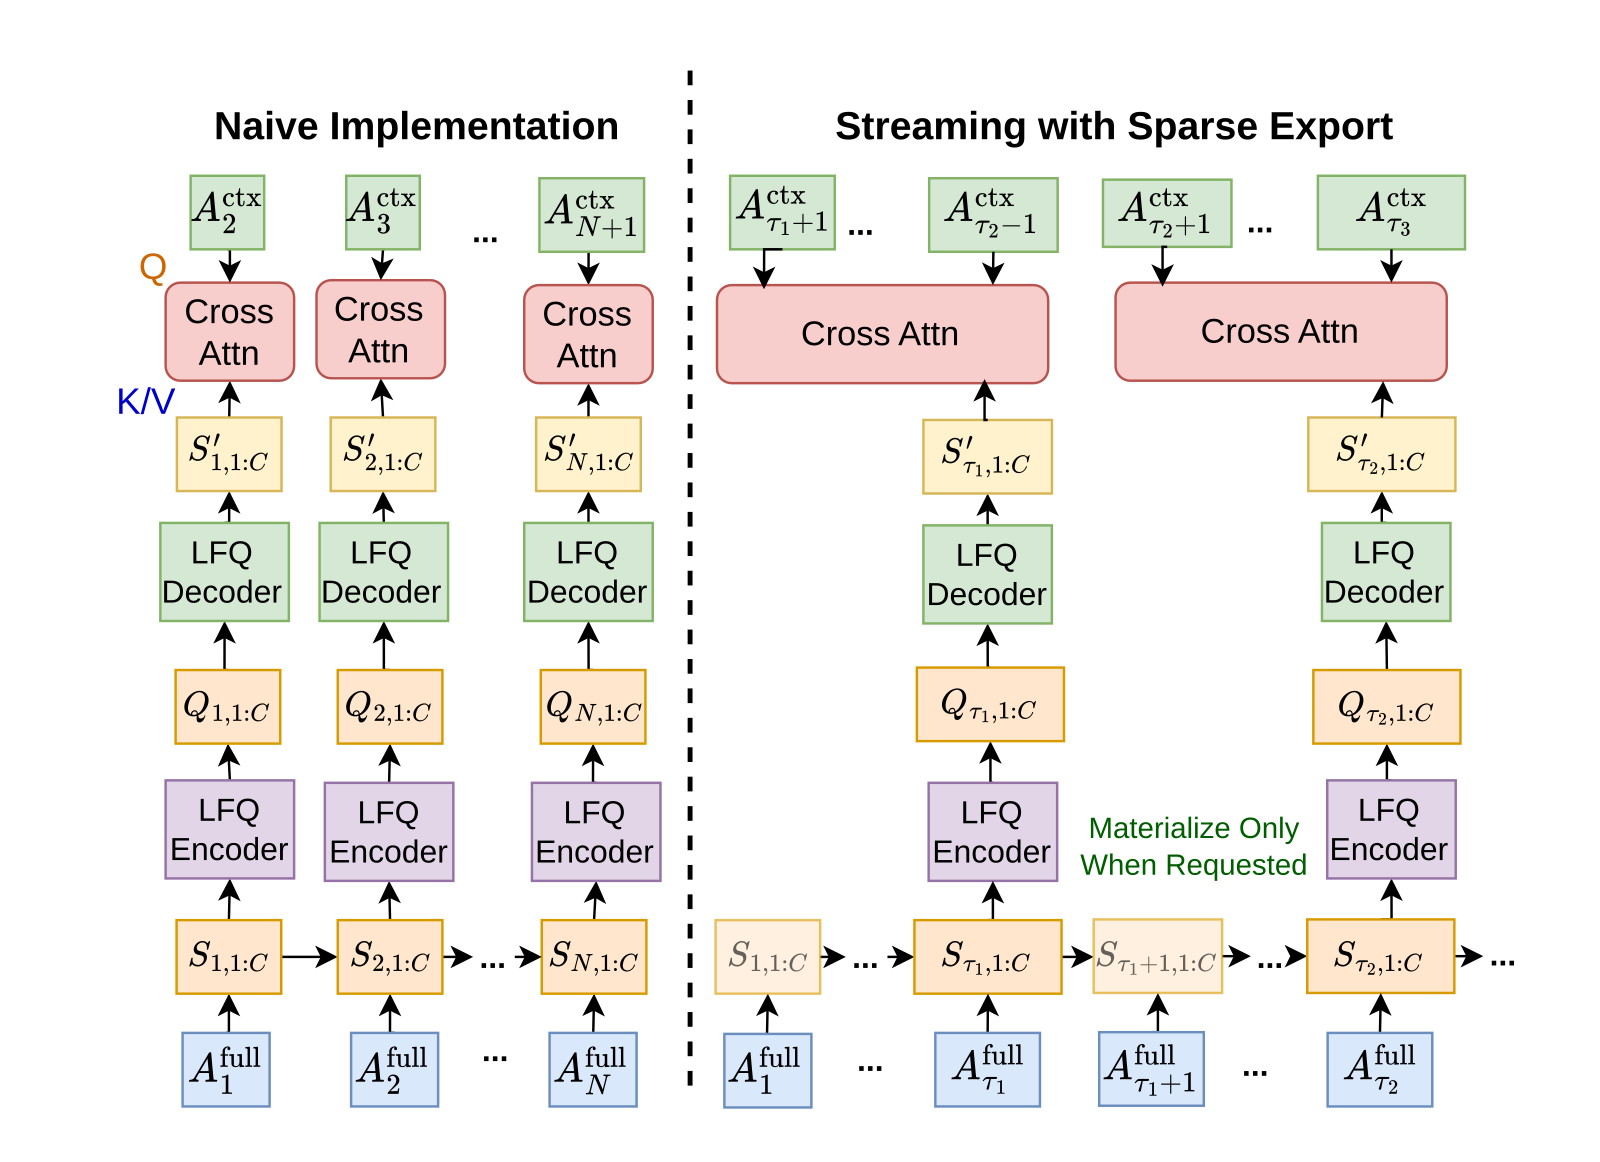
训练压缩器时,作者还用了分组导出:每隔 个行为导出一个检查点,两个检查点之间的查询共用前一个。示意: 时,第 150 个行为上的查询看到的是第 99 个行为之后的状态,最多晚 100 个行为。这是一个有上限的可见性延迟;第 100 到 149 个行为仍然更新了递推,只是这个查询看不到。 Hoot 说
递推状态:每个行为都更新
- 第 99 个行为后
- S 更新,并导出一个检查点
- 第 100 到 149 个行为
- S 逐个更新,不导出
- 跳过的行为
- 没有
递推本身不做任何近似
分组导出下的查询(训练,示意)
- 第 150 个行为上的查询
- 读第 99 个行为之后的码
- 它看不到
- 第 100 到 149 个行为,共 50 个;它们已经写进 S
- 最坏情况
- 第 199 个行为上的查询仍读第 99 个之后,晚 100 个
从第 200 个行为起,换读第 199 个之后的检查点
回填和线上服务:精确导出
- 请求
- τ = 21:00 的搜索
- 读到
- 严格早于 τ 的最后一个行为(20:58 的点击)之后的状态
- 分组延迟
- 没有
同一次扫描,只导出被请求的时间戳
示意:G = 100。左栏是递推状态,中栏是训练时分组导出下一个查询读到的东西,右栏是回填和线上服务的精确导出。
出处
论文 §5.1 分组导出与有界可见性延迟;§5.2.1 式 (5);§5.2.2 式 (6)–(7)(从零开始编号,导出集合为 G−1、2G−1……);图 4 右半对照基线是一个用分块 cumprod/cumsum 写的张量化 PyTorch 实现,它会先算出所有前缀再挑出被请求的。在批大小 10、bf16、前向加反向的设置下:每个前缀都导出时,10,000 个行为上融合 kernel 用 51.77 ms,基线用 1014.48 ms,快 19.6 倍。只导出 1.56% 的前缀时,融合 kernel 降到 18.45 ms、峰值显存从 35.0 GB 降到 2.0 GB,基线仍在 1 秒、约 20 GB 左右。这说明导出越稀疏,分开更新和物化的收益越大,因为基线不管导出多少都要先算全部前缀。
最近 64 个行为占 262,144 字节,仍比 2 KB 的 SeqFold 低 3.98%
主比较用的指标是上游行为预测任务的 query 级 PR-AUC,数据是私有的,只报相对 SeqFold 的变化。每条样本拿的是目标事件之前最近的一份快照。参与比较的方案前面都出现过:完整多层隐状态、不做 LFQ 的连续融合向量、窗口池化(每 32 或 64 个相邻行为平均成一个)、末层平均成一个向量、随机采样 64 个行为、最近 64 个行为。
| 方案 | 相对 SeqFold 的指标变化 | 每份快照字节数 |
|---|---|---|
| 完整多层隐状态 | +2.11% | 6,963,200(平均) |
| 连续融合向量(不做 LFQ) | +0.72% | 262,144 |
| SeqFold(融合 + LFQ) | 0 | 2,048 |
| 32 行为窗口池化 | −1.10% | 217,600(平均) |
| 64 行为窗口池化 | −1.38% | 108,800(平均) |
| 末层平均成一个向量 | −2.00% | 1,024 |
| 随机采样 64 个行为 | −2.37% | 262,144 |
| 最近 64 个行为 | −3.98% | 262,144 |
最值得看的是存储相同的三行。连续融合向量、采样 64 个行为、最近 64 个行为都是 262,144 字节,相对 SeqFold 的变化却分别是 +0.72%、−2.37%、−3.98%。后两者比只占 2,048 字节的 SeqFold 还低。这说明在同样的预算下,用学出来的门控和衰减去汇总全部历史,比挑一部分原始行为留下来更划算。
存储一样大时,决定效果的是「怎么汇总全部历史」,挑哪些原始行为留下来反而更吃亏。
LFQ 那一行回答的是量化的代价:从连续融合到 SeqFold,存储再小 128 倍,指标低 0.72%。末层平均成一个向量只有 1,024 字节,比 SeqFold 还小一半,但低了 2.00%;作者的解读是,一个向量装不下这么长历史里的多种兴趣。
截断吃亏多少,和这里的快照协议有关。作者用这个协议模拟的是最近几个行为的信号可能延迟、还没落定的场景,而最近 64 个行为恰恰最依赖最近这一段。作者自己也说,换一种线上服务假设,结果可能不一样。
通道数、融合层数、衰减方式各自的消融差值
消融把压缩器的几个部件拆开看。通道数从 64 降到 8,指标低 1.16%;升到 128 只多 0.08%,所以默认取 64。只压最后一层,比四层都压低 0.97%,加到两层、三层时差距缩到 0.52%、0.44%。作者据此认为不同深度的状态给下游的信息互相补充。
时间衰减那组以不做衰减为基准:固定常数(一年后保留 0.3 或 0.6)是 −0.02% 和 +0.03%,每个通道自己学衰减速度是 +0.18%。这几组消融的基准各不相同,所以这些差值只说明各自那一项改动的影响,不能拿来给整体效果分账。
码长也有一个拐点。每个码 16 位时只要 512 字节,但低 0.99%;96 位多花一半存储,反而低 0.05%。这说明 64 位之前量化还在丢有用信息,之后再加位数已经没有收益,所以作者取 64 位。
同一份码交给搜索和 QAC
最后一组实验把码交给两个真实下游:搜索和 QAC。下游各自学解码器,投影维度取 32、64、128,对照组是不用任何 SeqFold 状态的原有模型。搜索的主指标相对提升 0.24%、0.49%、0.61%,QAC 是 0.10%、0.53%、0.60%。这说明同一份 2 KB 的码,下游按自己的预算解码都能拿到收益,64 维时已经拿到大部分。由于对照组是「不用」,这组数字回答的是码有没有用,并不比较它和直接给下游完整状态谁更好。
回到周二晚 9 点那次搜索。SeqFold 的整套设计都围绕这一点:搜索样本只要 9 点之前的那 256 个整数,所以 1,700 个行为每来一个都更新一次累加器,但只在 9 点这个时间戳把结果写出来。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
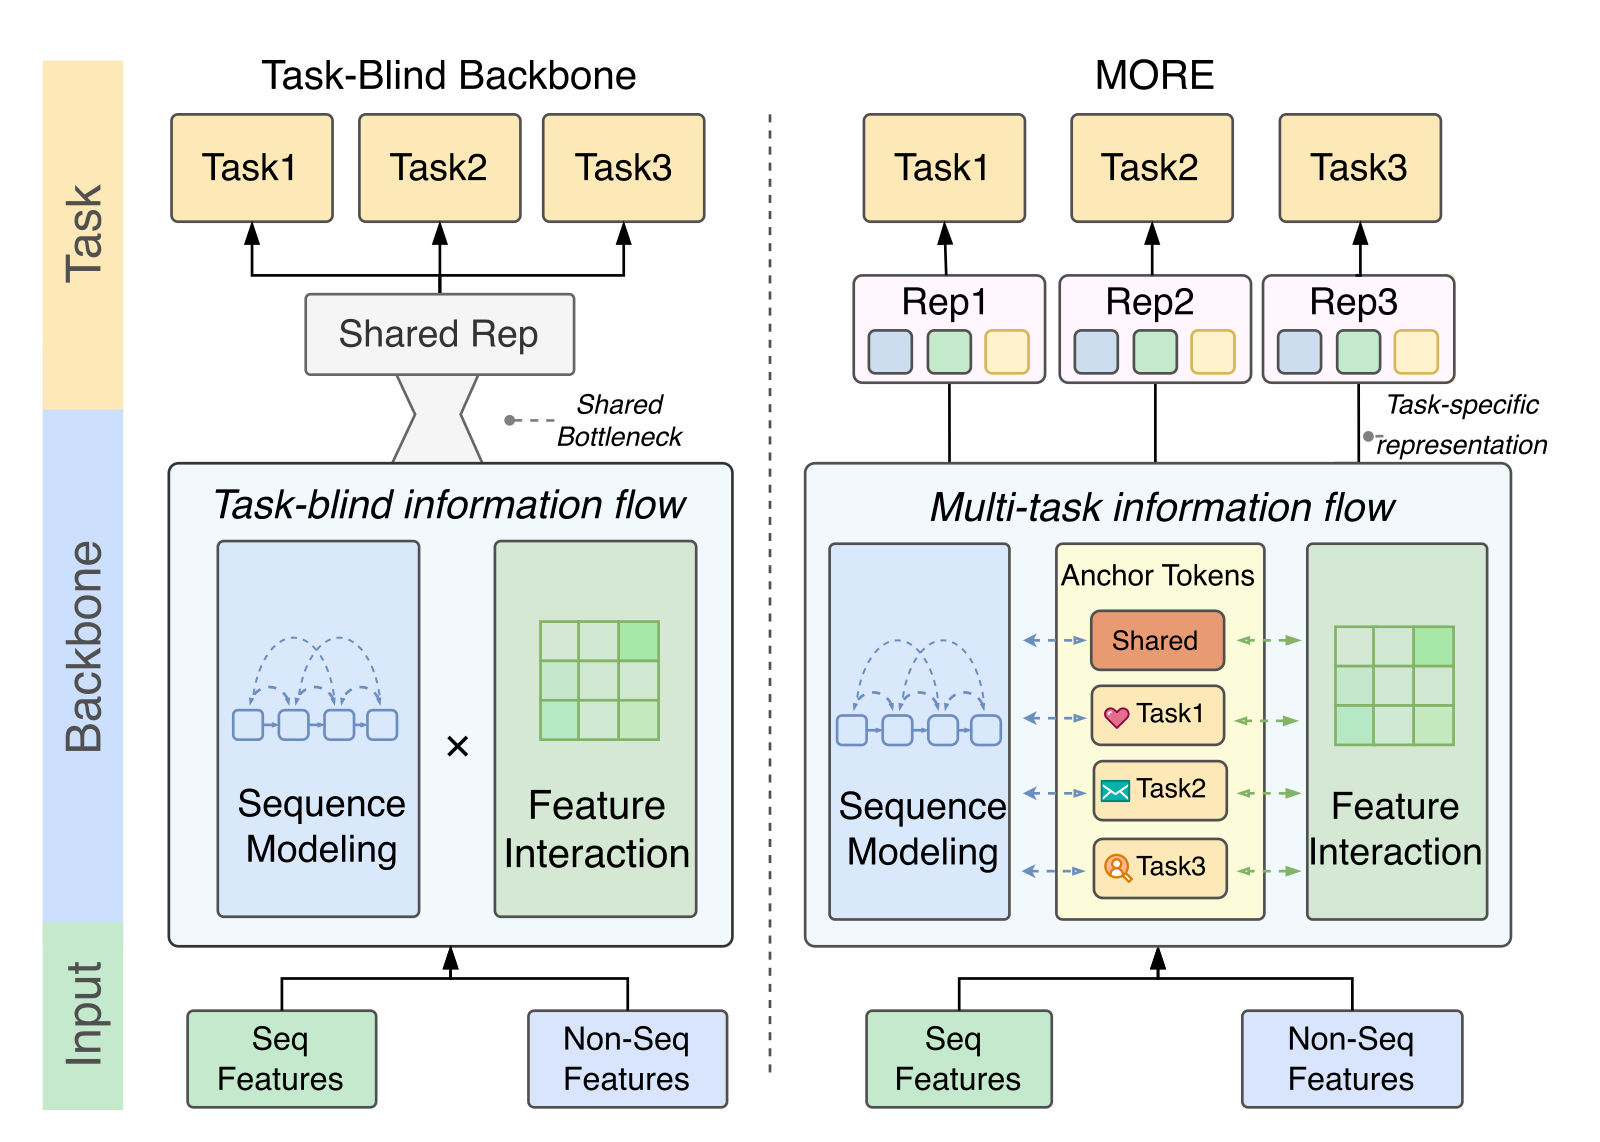 Personalization · 2026-09-10Task-Blind No MORE: Multi-Task Information Flow in Unified Ranking Backbones多任务精排里,常见的统一骨干让所有任务共用前面每一层,只在最后的预测塔才分开,点击和深聊这类差别很大的目标被迫共享同一套中间表示。陌陌的这篇论文在骨干里放一组随层更新的小向量,几个由所有任务共用,每个任务再各有一个。每个任务的小向量从第一层起就用自己的注意力参数读行为历史,彼此之间用掩码隔开,避免互相串信号。离线七个任务都超过三种统一骨干,两周线上实验里使用时长提升 3.0%。
 Personalization · 2026-11-11Query- and Candidate-Aware Long User Sequence Modeling for Sponsored Product Ranking in Search搜索广告排序用长期行为时,常见做法是拿候选商品去历史里找相似行为,可这样会漏掉和当前 query 高度相关、却和候选关系不大的历史。Wayfair 在最近行为之外,从长期历史里按候选和按 query 各检索一批行为,再连同 query 和候选两个上下文 token 一起送进 Transformer。离线看,两路检索合起来的 AUC 增益高于任何单路,说明它们找到的历史互相补充。另一个发现是,把候选信息拼进每条历史行为这一步不能省,去掉后模型比线上基线明显更差,只靠一个全局的候选 token 再间接交互补不回来。整套模型的线上 A/B 中,CTR 提高 6.0%,每次曝光的订单数提高 11.5%,模型服务延迟增加约 12%。搜索场景做长序列时,query 值得单独开一路检索,候选和历史的逐条交互也要留着。
 Personalization · 2026-05-13UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence快手把超长行为序列的用户表示改成按候选的 Semantic ID 分组共享:用候选的第一层 SID 当 query,对完整历史和 16 个压缩兴趣锚点各做一次 attention,按“用户 × SID”离线存好,线上只查一次表,延迟多 0.16 毫秒。工业数据 CTCVR AUC 从 TWIN 的 0.8609 提到 0.8626,一周广告 A/B 收入涨 0.337%。把 SID 换成类目当 query,AUC 掉得比去掉任何模块都多,而 XLong 上的大幅领先样本太少,要打折看。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…