
改写提示写死了,换个说法就搜不到:RAG-FGO 怎么搜查询改写策略你给内部文档做了一个检索增强问答。同事问「去年那个把超时改成指数退避的设计文档在哪」,这句话和文档标题对不上,搜出来的全是超时告警。
你在检索前加了一步:让大模型先把原问改成更好搜的说法。提示认真写过,温度和 top-p 也调过一回。有的问题改完就能搜到,换一种问法,同一套提示又改偏了。同样的改写,这次搜到了,下次又漂了。
这篇论文来自庆熙大学、电子科技大学和同济大学,要找的就是这套改写策略该怎么搜。传统检索直接拿用户原话去搜。生成式检索会让大模型先改写,但多用写死的提示、一次生成。已有工作有的用进化或强化学习去搜提示,有的用启发式方法去调生成时的采样参数。这篇把提示模板和采样参数放进同一个搜索对象。检索流程上,ReAct 把推理和检索工具用在一起,Self-Act 把问题拆成子问题再分别检索,Aflow 则按情况决定何时推理、何时检索,是这篇六个问答对照里最强的检索基线。RAG-FGO 受真菌生长优化器(FGO)启发。FGO 本来用菌丝的扩展和分枝同时做大范围探索和局部细化。作者把它用到改写策略上,把一套提示模板和一组采样参数写成一个查询改写代理,在没有梯度的混合空间里搜索。全局搜索重构提示以跳出局部最优,局部搜索改措辞做精细对齐,再用跨轮重评的精英记忆池把好策略留下。用 GPT-4o-mini 作答时,六个问答基准的平均答案级 F1 从 Aflow 的 68.9 做到 77.1。
把提示和采样参数放进同一个改写代理里搜索,再靠跨轮重评把好策略留下,能抬高依赖检索的问答分数;在外部证据约束较弱的推理题上,平均分只略高,个别基准会落后最强的提示方法。
原话对不上知识库,改写也常写死
检索效果往往卡在用户怎么问。原问的表面措辞和知识库里的写法对不上,能被搜到的证据范围就先窄了一截。
生成式检索想补上这一步:让大模型先改写、再去检索,把用户意图变成更适合知识库的问法。灵活性来了,麻烦也来了。改写好不好,不只取决于检索器,还取决于生成时用的那套配置。策略的好坏又往往只能看间接反馈,比如检索结果和目标信息像不像,这个信号本身带噪声,还会随问题和领域往两边漂。一套写死的改写提示,换一种问法就不好用。
所以作者把它写成在策略空间里做优化。一个查询改写代理 A 由两部分组成:离散的提示模板 C,负责改写时的句式和结构;连续的采样参数 θ,比如温度、top-p、重复惩罚,负责改写时的随机程度和输出形态。给一个用户问题 q,代理经大模型 L 写出新 query,再交给检索器 R 去知识库里取回段落。训练时,把取回的段落和这条样本自带的标准支持上下文做语义相似度,用这个分数来评价这个代理。相似度只能在改写、检索之后才能看到,检索过程不可微,生成又有随机性,所以这是一个离散-连续混合、带噪声、没有梯度的黑盒问题。只靠手调一版提示,或只在附近做局部修改,容易停在一个看起来还行、换一批问题就不稳的策略上。
提示和采样参数放进同一个代理
优化开始时,先初始化一群代理。提示从预设模板库里抽,文中举过这样的例子:「As a linguistic diversity expert, you excel at subtly rewriting sentences while preserving their core intent and information.」采样参数则从正态分布里取样,以保证起点够分散。文中的参数例子是:温度 0.7,top-p 0.8,frequency penalty 2.0,presence penalty 2.0,最大 1024 个 token。
每一轮怎么打分?代理写出新 query 后,检索器取回若干段落,用预训练 embedding 把「取回的段落」和「标准支持上下文」写成向量,再算余弦相似度。分数越接近 1,说明搜回来的东西和这条样本该看的证据越像。按这个分数给本轮代理排序,留下最好的若干个,放进精英记忆池。训练时选代理看的是检索结果和标准证据有多像,后文表格里报的则是最终答案和标准答案的答案级 F1。两者相关,却不是同一个数。
要在这个策略空间里走动,框架并行使用两种变异。全局搜索让大模型把提示结构重写一遍,同时给采样参数一个较大的扰动,并且丢掉幅度接近 0 的无效改动,目的是跳到远处,避免困在当前这套措辞里。局部搜索只做同义替换、语气微调这类小改动,参数也只在附近轻轻推一把,目的是在已经像样的区域里对齐得更准。每个被选中的代理会按变异次数 mc 长出一批新候选;用哪个搜索,由一个随轮次升高的概率 p_t 决定。早期 p_t 小,多数变异走全局;后期 p_t 变大,多数变异走局部。
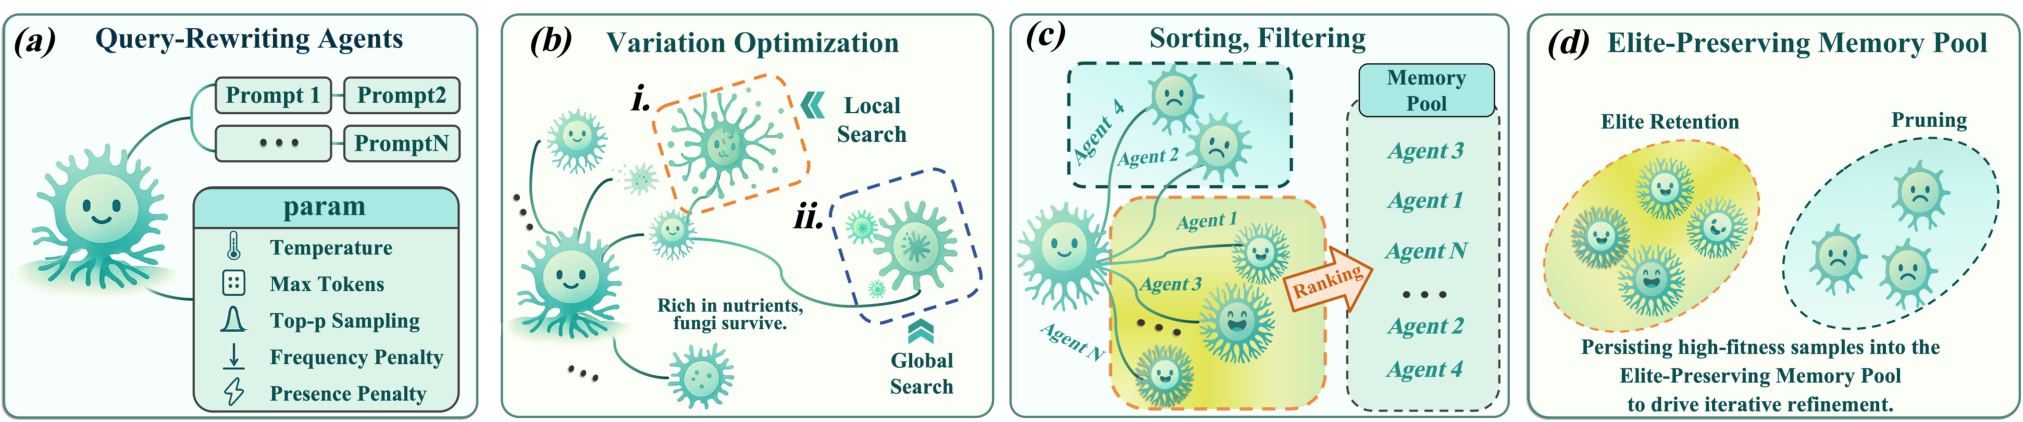
图 2 从左到右是四块:代理里有什么、两种变异怎么做、按分数筛选、记忆池留下精英并丢掉差的。来源:论文 Figure 2。
为什么还要一个记忆池?因为分数不稳定。同一套策略,换一批更难的问题,分数会掉;生成时的随机性也会让同一策略时高时低。如果每轮拿上一批的历史分和本批新分直接比,比较基础会偏,好策略会被错位的分数换掉。精英记忆池容量固定为 M=5。每一轮把旧精英和本轮新代理放到同一批新问题上重新打分,再从这一池子里留下最好的 5 个。这样比的是同一批问题,难度波动不容易把比较基础带偏。
搜索在两种情况下停止:最优代理连续若干轮不再变化,或轮次用完预算。最终从记忆池里取出最好的那个代理 A*,测试时只用它做一次前向改写,不再搜索。
后面各表比的是同一套检索预算下改写策略好不好,所以检索设置要先说清。改写器统一用 Qwen2.5-7B-Instruct。检索器用 E5-base-v2,在 DPR 划分的英文维基百科(2018 年 12 月 20 日快照,约 2100 万条、每条约 100 词)上按内积取回 10 段。最终答案由各生成模型写出,主表里的 GPT-4o-mini 是其中之一。
走一遍:一轮搜索里谁留下
下面按论文的训练流程走一轮。设定跟 HotpotQA 主实验对齐:每个入选代理本轮变异 mc=12 次,记忆池容量 M=5。问法和相似度分数是示意,用来看清「谁改了谁、下一步谁留下」;后文的 F1 都来自论文表格。
示意的原问是一道多跳题:「拍摄《盗梦空间》的导演,本科是在哪所学校读的?」直接拿这句话去搜,容易先堆出电影介绍,导演教育背景那一页不一定在前 10 段里。改写代理要把这句改成更方便检索的问法,比如把导演名和「undergraduate university」一类检索词写清楚。
第一步,代理改写并打分。当前记忆池里最好的代理 A_best 用自己的提示和采样参数写出新 query,检索器取回 10 段,和标准支持上下文算余弦相似度。示意:A_best 在上一批问题上得到 0.75,这个分数被带进本轮。
第二步,从入选代理长出新变体。示意只走最优这个种子 A_best;实际上每个入选代理都会按 mc 长出候选。本轮有一个局部搜索概率 p_t,公式是 p_t = p_min + (t-1)/(T_max-1)×(p_max-p_min)。示意取 p_min=0.2、p_max=0.8、T_max=11。第 1 轮 p_1=0.2,12 次变异里大约 12×0.2=2.4 次走局部(同义替换、参数小扰动),大约 9.6 次走全局(大模型重写整段提示,参数跳得更开)。到第 11 轮,p_11=0.8,次数对调,变成大约 9.6 次局部、2.4 次全局。
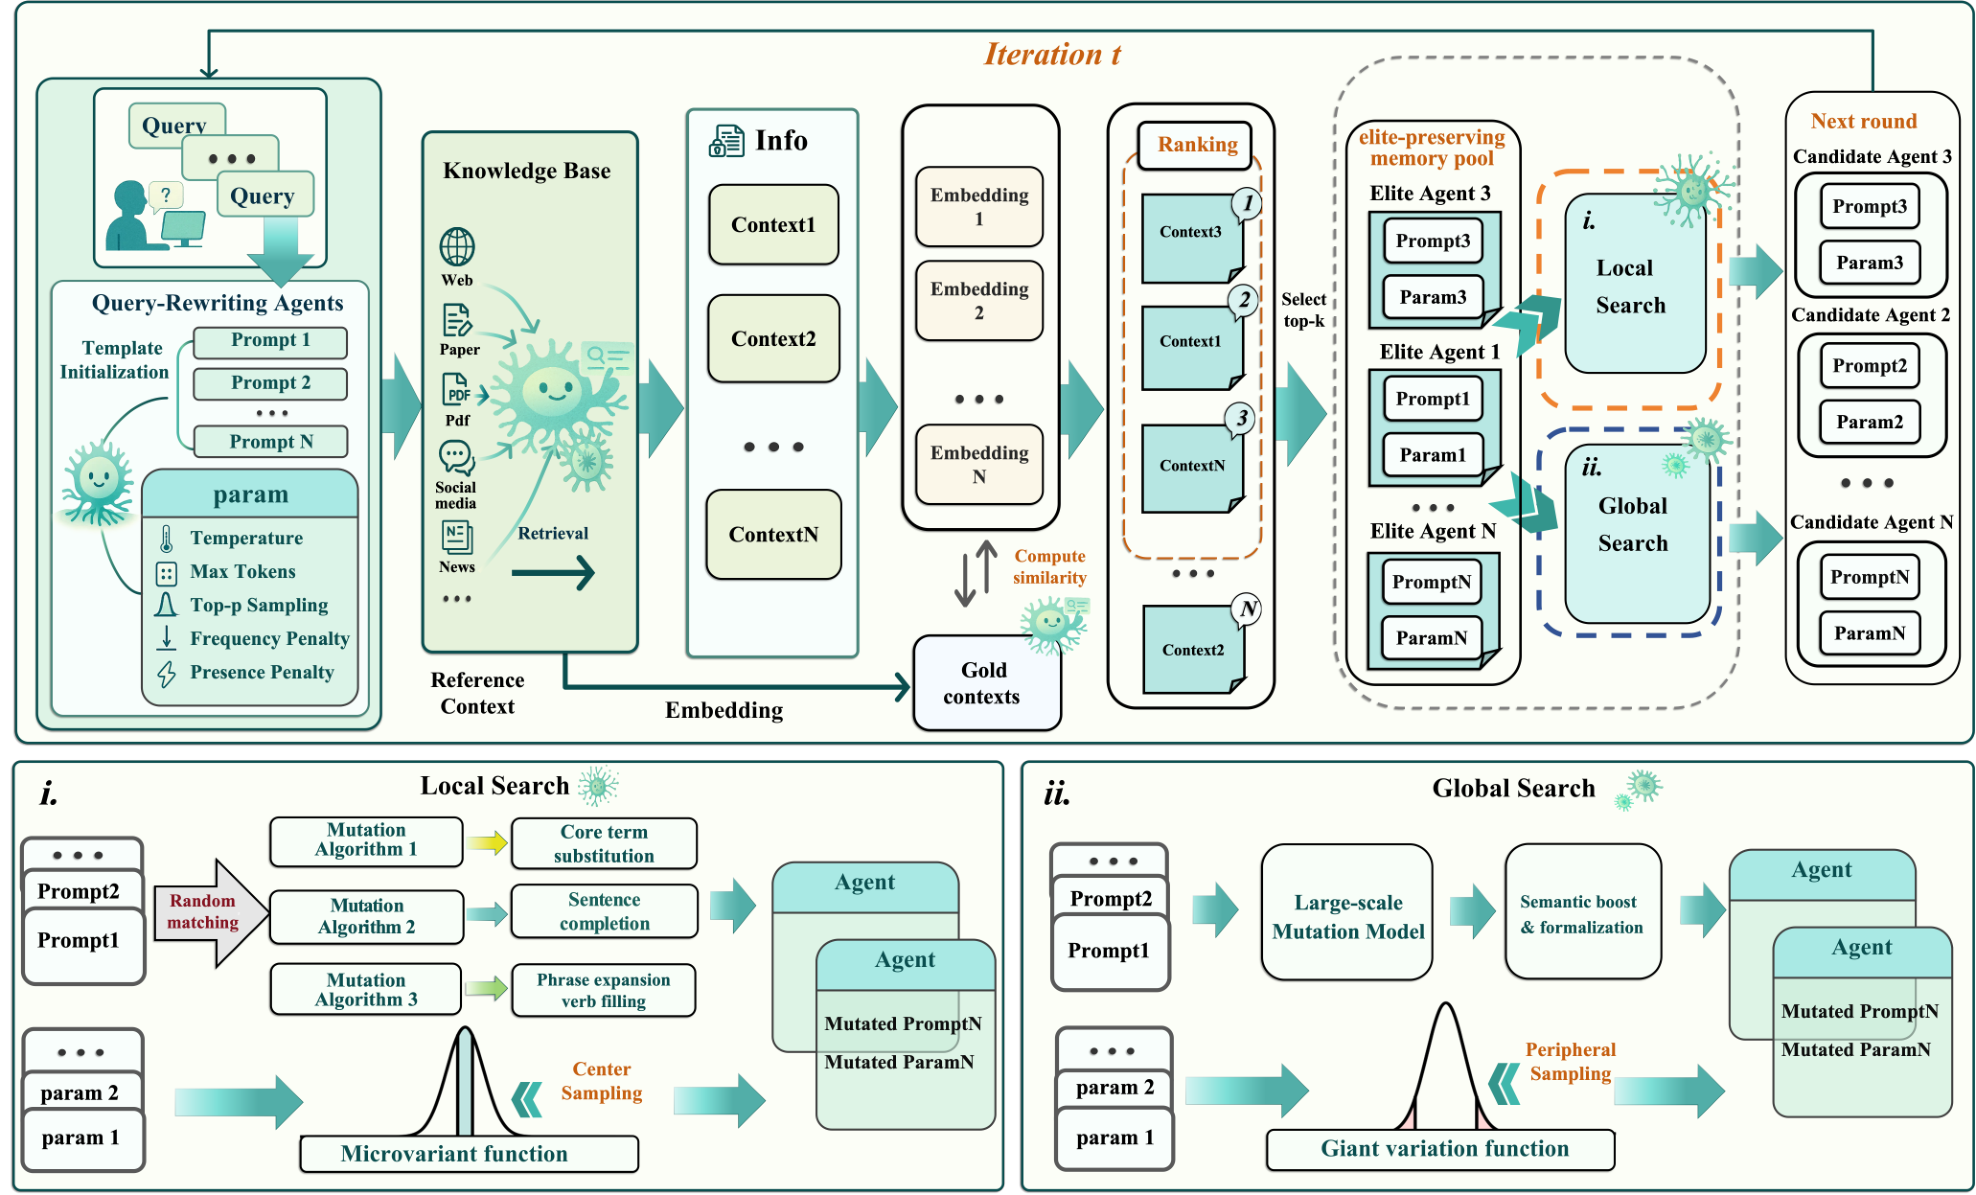
图 3 上半是一轮的完整路径,下半把局部搜索(中心附近取样)和全局搜索(避开中心的大扰动)分开画。来源:论文 Figure 3。
第三步,新候选用同一套相似度打分。示意:一个由全局重构得到的新代理 A_new 在本批得到 0.82。如果拿这个 0.82 去和 A_best 上一批的 0.75 比,A_new 会显得更好。可两批问题难度不同,这两个分数不在同一条基线上。
第四步,记忆池把 5 个旧精英和本轮新代理放到同一批问题 q_t 上重新打分,再留下分数最高的 5 个。示意:同一批上重打分后,A_new 是 0.68,A_best 是 0.71。A_new 排在 A_best 后面。重评让新旧策略在同一批问题上比,减少「上一批分高、这一批其实不行」或「这一批碰巧好搜」造成的错位比较。一次重评并不能消掉生成随机性带来的分数抖动。
第五步,若连续若干轮最优代理不再变化,或轮次走到预算上限,搜索停止。留下的 A* 在测试时只做一次前向改写。
这组示意分数不是论文实验。论文用拿掉部件的消融说明记忆池有多关键。用 GPT-4o-mini 作答时,完整模型在 HotpotQA 上的答案级 F1 是 81.5;去掉记忆池降到 75.2,少 6.3 分。五个数据集上的跌幅都在 6.3 到 7.1 分之间,是三块里最大的。去掉局部搜索少 4.8 到 5.2 分,去掉全局搜索少 2.6 到 4.0 分。
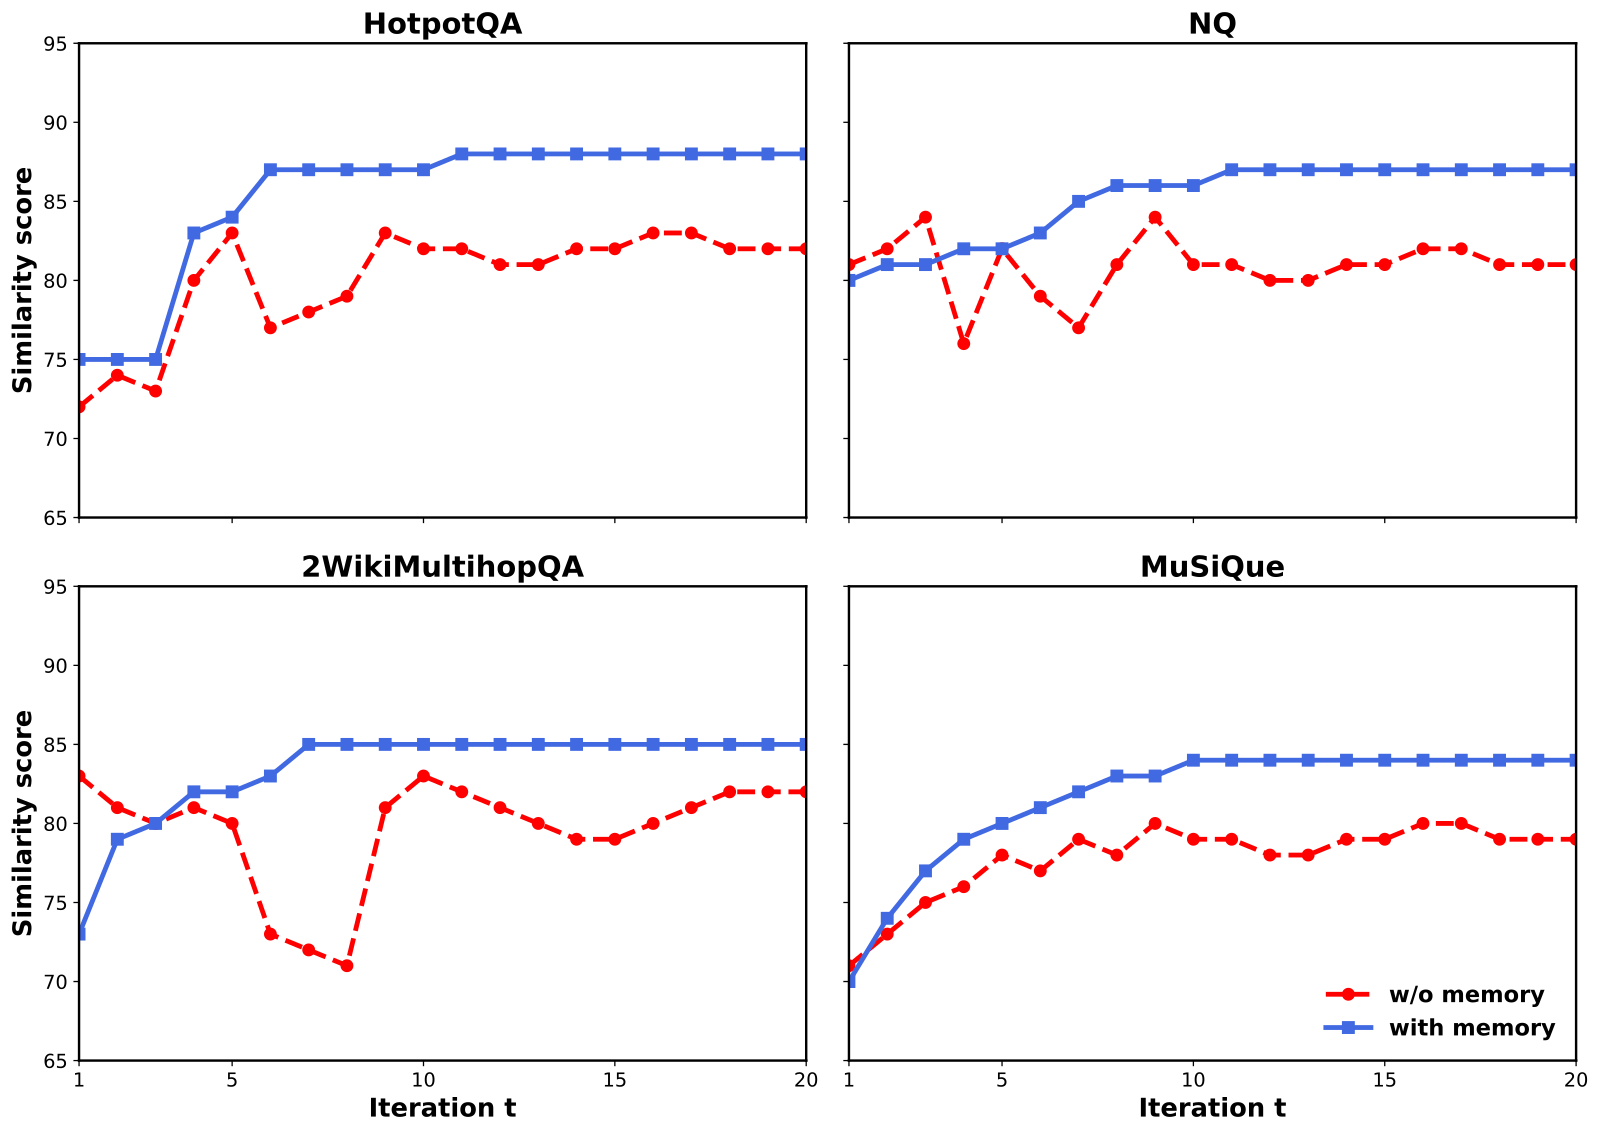
图 6 在 HotpotQA、NQ(Natural Questions,真实用户问维基的问题)、2Wiki、MuSiQue 上画出训练过程中的相似度轨迹,蓝色是有记忆池,红色是没有。来源:论文 Figure 6。
有记忆池时,相似度升得更快,也更早停在更高的水平;没有记忆池时曲线抖得更厉害,在 HotpotQA 和 2Wiki 上尤其明显,稳定下来也更低。这组消融是从完整模型里分别拿掉一块,所以能看到「另外两块都在的时候,这一块还值多少分」。它不能说明三个部件两两如何交互,也不能说明换一套 p_t 日程之后,跌幅排序还会不会是记忆池最大。
变异加到 15 次,分数几乎不再涨
走完搜索,六个问答集上的分数如何?下面这张表是 GPT-4o-mini 作答时的答案级 F1(%)。Aflow 是这组检索基线里平均分最高的一个,RAG-FGO 六集平均从 68.9 到 77.1,在多跳的 HotpotQA、2Wiki、MuSiQue 上拉开得更明显。
| 方法 | HotpotQA | 2Wiki | MuSiQue | 六集平均 |
|---|---|---|---|---|
| Self-Act | 73.1 | 69.2 | 67.3 | 68.4 |
| Aflow | 73.5 | 65.7 | 71.6 | 68.9 |
| RAG-FGO | 81.5 | 77.3 | 79.4 | 77.1 |
换生成器以后,平均分仍然高于同生成器的 Aflow,说明这套搜索不绑在某一个模型上。GPT-4.1-nano 从 69.7 到 73.7,Qwen-Long 从 76.4 到 79.8,Qwen-Max 从 69.0 到 72.4,Gemma-2-27B 从 66.3 到 70.3。
在七个推理基准上,用 GPT-4o-mini 作答,RAG-FGO 平均 63.7,略高于 ReFeri 的 63.6。MATH500 上是 78.0,低于 USC(先生成多条思维链再多数表决)的 78.6;MMLU-pro 上是 64.5,低于 ReFeri 的 65.0。这说明在这两集上没有超过最强的提示方法。
和专门做查询改写的方法比,生成器换成 Qwen2.5-7B-Instruct,RAG-FGO 在 HotpotQA、StrategyQA、AmbigQA、PopQA 上的 EM、F1 和准确率都最高。相对 LLM 直接改写、HyDE(先让模型写一段假想文档再拿去检索)、Query2Doc,以及 SFT、RaFe(DPO)、RRR(PPO)、Q-PRM 这些训练过改写器的方法,提升在 Ambiguous 和长尾事实上更明显:AmbigQA 的 F1 从最强基线 Q-PRM 的 63.9 到 66.4,PopQA 的准确率从 63.6 到 65.2。
多搜几次还值不值,要同时看分数和花掉的 token。图 4 用 GPT-4o-mini 画出六个数据集上 F1 随 mc 的变化。涨分最明显的是从 3 次加到 6 或 9 次:HotpotQA 从 79.2 升到 80.5,再到接近饱和的 81.5。LongBench 在 9 次时已经是 71.5,15 次时只到 71.6。再往上加变异,分数几乎不再动,所以多搜的回报在变薄。
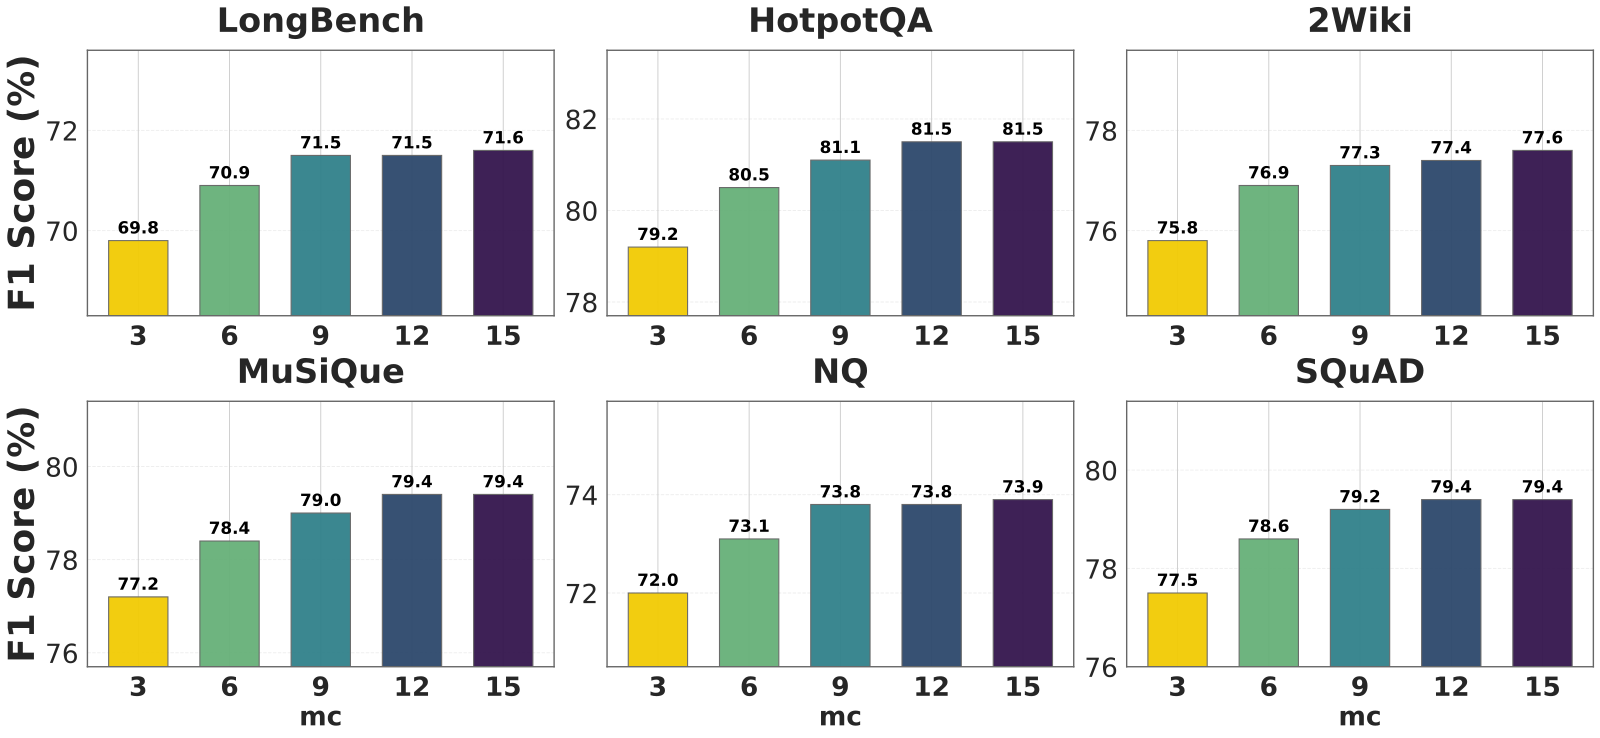
图 4 的横轴是变异次数 mc,纵轴是 F1(%),生成器是 GPT-4o-mini。来源:论文 Figure 4。
token 花费却还在涨,所以这个饱和点决定了主实验怎么选 mc。从 9 次加到 15 次,SQuAD 和 HotpotQA 大约多花 0.34M 个 token,LongBench、MuSiQue 和 NQ 大约多花 0.50M 到 0.69M 个 token,F1 只再多 0 到 0.6 个百分点。因此主实验把 LongBench 放在 9 次、HotpotQA 放在 12 次,工作区间是 9 到 12,这一段通常花 0.5M 到 1.25M 个 token。
用 GPT-4o-mini 作答,把在目标集上单独搜到的代理,和从 HotpotQA 直接迁过去、不再微调的代理比,F1 都会掉,问法差得越远掉得越多。NQ 从单独搜的 73.8 掉到迁过去的 71.1,SQuAD 从 79.2 掉到 77.3;AmbigQA 从 63.9 掉到 59.8,StrategyQA 从 70.2 掉到 64.5。这四组起始分都是目标集上单独搜索的结果。这说明迁出去还能用,但任务差距大时仍要在目标集上再搜。
这对做检索增强问答的人意味着什么
改写提示不要只手调一版就冻住;把提示和采样参数放在一起搜,并留下一个跨轮重评的小记忆池,对带噪的检索反馈更稳。
如果你的系统里已经有一步查询改写,可以先把「提示模板 + 温度 + top-p」当成一个搜索对象,放在一起搜。记忆池不要省:从完整方法里拿掉它,五个数据集上少 6 到 7 个 F1,比拿掉局部搜索或全局搜索都多。变异次数可以对着自己的分数-花费曲线选,这篇里 9 到 12 是接近饱和、token 还控得住的区间,加到 15 几乎不再涨分。
局限
这套搜索在部署前离线完成,需要额外的训练预算。测试时最优代理只需一次前向改写,但框架不能在线上跟着新问题或变动的知识库继续更新。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Retrieval · 2026-10-29GRAPE: Let GRPO Supervise Query Rewriting by Ranking for RetrievalCLIP 这类检索模型遇到中文 query、长文本 query 或图文组合 query 时效果明显下滑,可重训检索器、重算整库向量又太贵。这篇论文不动检索器,只训练一个大模型来改写 query,并用 GRPO 把检索排名直接当作改写的奖励。作者发现,如果奖励只看改写后的 query 和正确结果有多相似,模型会学会把所有候选的分数一起抬高,无关结果也跟着变高。改成看正确结果在整个语料里排第几,这个问题就消失了。在多语言、长文本和组合图像检索的多个基准上,Recall@10 平均提高 4.9%。检索模型冻结、语料很大的系统,可以先从改写 query 下手。
 Retrieval · 2026-10-28SkillQR: Agentic Skill Discovery for Reason-Intensive Query Rewriting用大模型改写 query 时,常见做法是对所有 query 用同一条指令,但改写往哪个方向写,其实取决于要搜的语料。SkillQR 离线把语料聚类,让大模型为各类文档总结出几条改写指令,比如面向编程题语料,要求列出解题需要的数据结构和算法;查询时由同一个模型挑一条再改写,不需要训练数据。自动挖出的技能效果和人工写的学科指令持平;14B 版每个 query 改写约 38 秒,迭代改写的 ThinkQE 要 85 秒,说明省掉多轮迭代后速度优势明显。
 Retrieval · 2026-08-05SPEAR: Selection-aware Personalized End-to-end Adaptive Rewriting and Retrieval for Community Search把推荐里的 PDN(Path-based Deep Network)搬到搜索里挑改写词,会学出一条捷径:“手机壳”“女士连衣裙”这类高频泛词能连上大量内容,也确实带来点击,于是总被选中,用户写下的品牌、型号等限定却丢了。SPEAR(一种端到端训练的个性化改写选择与检索框架)让改写选择直接接受最终点击的监督,再加两道约束:改写的选择权重和它对内容的相关性相乘,两者都高才得分;召回和排序各用一套 embedding,点击目标的梯度不回传到召回那一支。在 10 万条留出的线上会话上,点击召回 Recall@10 从 0.1694 提到 0.3380,改写和原 query 的语义相似度也一起上升。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…