
做多模态检索的人值得读它的思路,但不要把它当成拿来就能上线的方案。用文字搜图、用图搜文字这类跨模态检索(这里要找回的是同一类别的内容),训练数据常缺一种模态(比如有的样本只有图),类别标签还带错。已有的缺模态方法都把标签当语义基准:按标签把同类样本的 embedding 聚到一起,也按标签去补缺的那一半,标签一错,两步都跟着错。SPIRN(这篇论文提出的方法)的核心思想是给每个类别设一个固定、互相正交的语义参照向量,训练中不更新,编码器按标签把样本往对应的向量上拉;挑干净样本、改标签、补缺失模态(补的是另一侧的 embedding,不是真实的图或文字),都拿这同一组向量当尺子。这些向量起初不带类别含义,含义来自编码器按标签把样本往上拉。实验里的错标是在所有类别里均匀乱抽的,所以在各类别样本数相近时,带某个标签的样本里,即使错标过半,真正属于这一类的样本也比来自其他任何单个类别的都多;神经网络又通常先学会这种占优的共同规律,后来才记住错标签,所以训练早期每个向量附近聚得最多的是真正属于这一类的样本,它才能当尺子(这是我对论文依据的解读,类别大小悬殊、或错标集中在两三个相近类别之间时,这个条件可能不成立);向量固定,只保证尺子本身不被错标签拖着走。在缺得最多(训练样本里只有 20% 图文齐全)、60% 训练样本的标签被随机重抽的设置下,它在 XMediaNet 上图搜文的 mAP 是 49.2,已有方法里最好的只有 21.0;可在 Wikipedia、XMedia 这两个数据集上,缺得少、错得少时它和最好的已有方法基本打平。
它在补哪个缺口
先说任务。训练集里每个样本本该有一张图、一段文字和一个类别标签,模型是两个编码器,一个把图、一个把文字变成同一个空间里的 embedding。这条研究线做的是类别级检索:拿一张图去检索时,要找回的是同一类别的文字,而不是只找和它配对的那一条。检索时按这类方法的通常做法,直接拿查询的 embedding 和另一种模态的 embedding 算相似度排序。
已有方法沿两条线各解决了一半问题。第一条线处理“缺模态”:有些样本只有图、有些只有文字,方法会用图文之间的对应关系或近邻样本,把缺的那一半补出来。它们训练时把观测到的类别标签当作语义基准,用标签把同类样本拉到一起,也用标签指导补全;默认标签是对的。第二条线处理“标签错”:比如按每个样本的学习难度,或者看它跨模态的近邻是否一致,把干净样本和标错的样本分开。这类方法默认每个样本图文齐全。
两种问题同时出现时,两条线都会出错。论文图 1 画了一个例子:一张狗的照片缺了文字,标签却错标成“猫”。第一条线按标签去补,补出来的是一段讲猫的文字;另一个只有文字“Dog”的样本,标签同样错标成“猫”,也被补成一张猫的图。图里为了直观画成图片和文字,SPIRN 实际补的是 embedding,后文细讲。第二条线则少了依据:论文指出,缺了一种模态后图文之间的对应信号变弱,错标更难查出来。论文要补的缺口是:需要一个不跟着错标签走的参照,挑样本、改标签、补模态都用它。
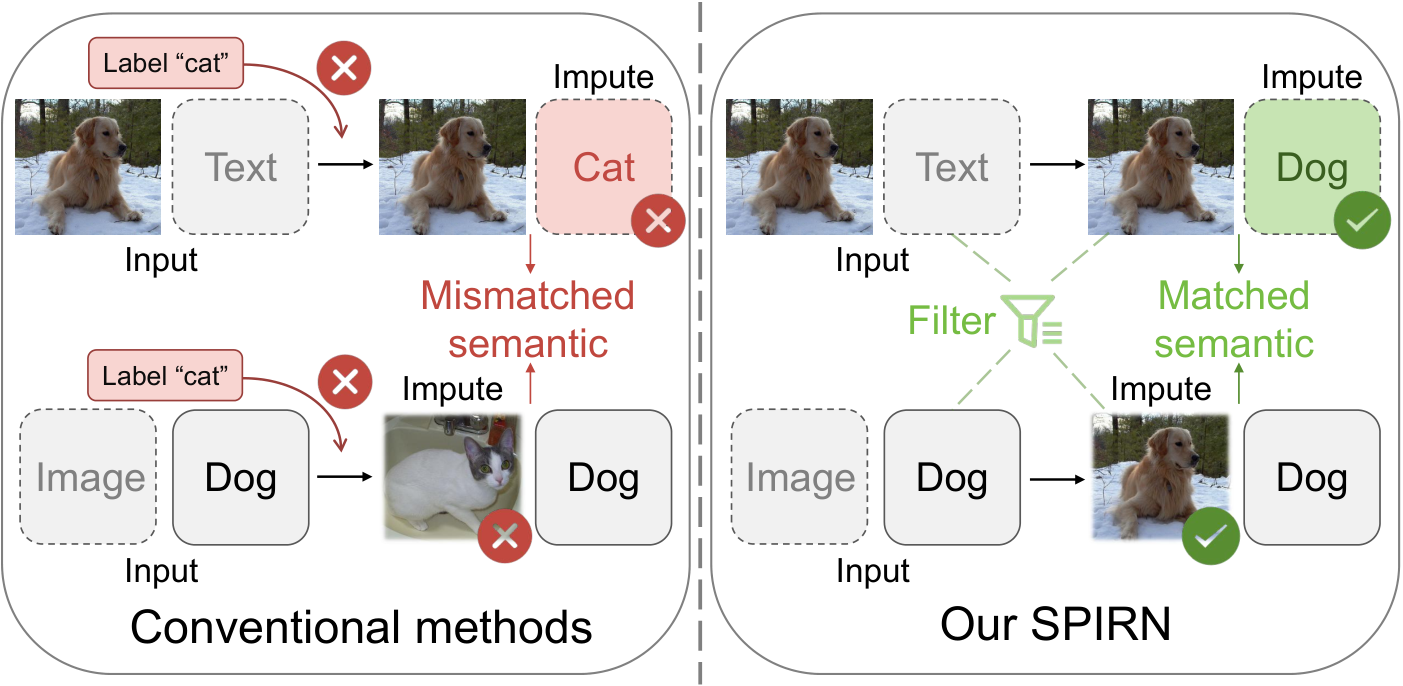
下面用一个贯穿后文的示意场景(数字均为示意)。一个商品库有 3 个类别:狗粮、猫粮、鸟食。样本 A 图文齐全,标签“狗粮”,是对的。样本 B 也图文齐全,实际是猫粮,却标成“狗粮”。样本 C 只有一张狗粮的商品图,没有文字。这三条只是一个大训练集里的几条,库里还有大量标对的狗粮、猫粮、鸟食样本。
| 样本 | 有什么 | 观测标签 | 实际类别 |
|---|---|---|---|
| A | 图 + 文 | 狗粮 | 狗粮 |
| B | 图 + 文 | 狗粮 | 猫粮 |
| C | 只有图 | 狗粮 | 狗粮 |
整体流程
SPIRN 有四个部件。下面的图 2 把全部输入画在一起;实际上预热只用图文齐全的样本,单模态样本补全后到第三阶段才进入训练。训练分三个阶段依次进行,第二和第三阶段之间插一步不训练的全局改标。
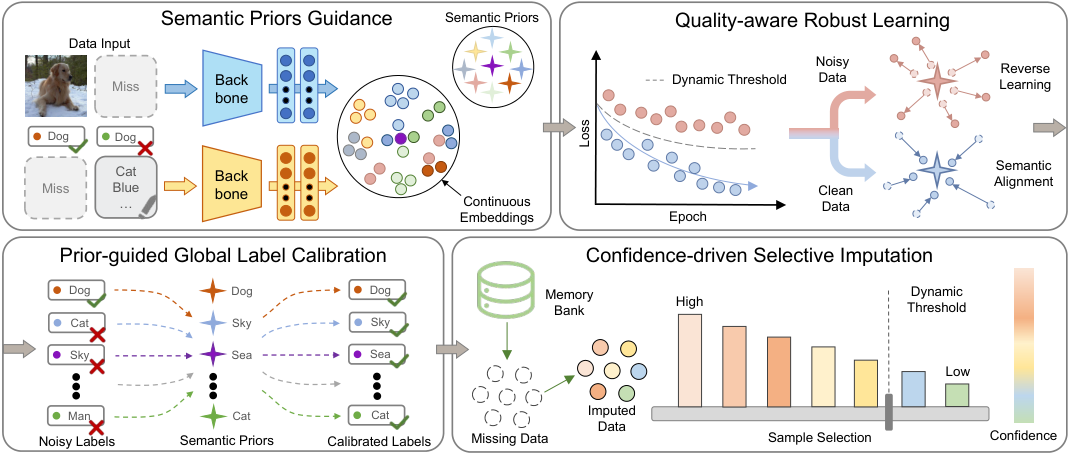
| 步骤 | 用哪些样本 | 做什么 | 产出 |
|---|---|---|---|
| 预热(SPG) | 图文齐全的样本 | 把图和文字的 embedding 都拉向各自观测标签的参照向量 | 一个初步对齐的空间 |
| 带噪学习(QRL) | 图文齐全的样本(反向学习和对比项都按样本的图和文两侧来写,论文写明对比项用图文齐全的样本) | 按 loss 给样本加权(训练早期标错的样本 loss 偏高,原因见后文);判为带噪的改用反向学习,即从观测标签以外的类别里随机挑一个、压低样本被判成该类的概率(类别多时,挑中真实类别的机会小);再加图文对比学习 | 不太受错标签影响的编码器 |
| 全局改标(PGLC,两阶段之间做一次,不训练) | 全部样本 | 每个样本改标到最相似的参照向量所属类别 | 修正后的标签 |
| 选择性补全(CSI) | 只有图或只有文字的样本 | 从记忆库补出缺的模态,只用把握够的那些训练 | 能用上单模态样本的最终模型 |
关键分工是:参照向量固定不动,标签和补出来的 embedding 都可能错,所以后者一律拿去和参照向量比。下面拆开讲参照为什么可以当这把尺子。
为什么参照向量要固定
常见做法是在编码器后面接一个可学习的分类层,每个类别对应一个类中心,训练中由标成这一类的样本去更新它。问题是“属于这一类”靠的是标签。示意场景里,如果标成“狗粮”的样本有 40% 其实是猫粮,狗粮的中心就会被拉向猫粮;中心偏了,再用“离中心远不远”判断谁标错,就不准了。缺模态又让可用样本更少,中心更容易被带偏。
SPIRN 改成一个固定的矩阵 W,每一行 w_c 是第 c 个类别的参照向量,各行互相正交。正交要求 embedding 维度不小于类别数。训练时 W 不更新,样本的类别概率由它和每个参照向量的相似度算出:
z_i 是样本归一化后的图或文字 embedding,τ 是温度,C 是类别数。直觉上这就是一个分类层,只是分类层的权重被钉死成互相正交的向量。预热阶段只用图文齐全的样本,对图和文字各算一次交叉熵,目标是观测标签。参照向量本身没有类别含义,含义来自训练:编码器把标成 c 的样本往 w_c 拉。可以借下一节要讲的早期学习现象来理解:网络先学会标对样本的共同规律,所以训练早期 w_c 附近聚得最多的是真正属于 c 类的内容。错标签仍会通过编码器把个别样本拉向错误的参照,这正是下一步要把带噪样本挑出来的原因;但它拉不动参照本身,参照不会因为某一类里错标多了就整体漂移。固定只保证尺子本身不动;样本会不会被错标签整体拉偏,靠的是早期学习现象和下一步的筛选;我认为噪声很高时这一点最弱。
怎么分辨标错的样本
带噪学习阶段依据的是一个已知现象:神经网络通常先学会简单、干净的规律,后面才开始记住错标签。所以训练早期,标对的样本相对自己标签的参照向量 loss 低,标错的 loss 高。预热和带噪学习各跑多少个 epoch 是预先设定的超参数。按早期学习现象推(这是我的推论),按 loss 分样本要趁网络还没记住错标签,预热拖得太久,标错样本的 loss 也被压低,就分不开了。示意场景里,A 的图文都像狗粮,离“狗粮”向量近;B 实际是猫粮,按均匀噪声的设定,库里大量标对的猫粮样本已把猫粮的规律学到“猫粮”向量附近,B 就离“狗粮”向量远,loss 高。
带噪学习阶段把质量指标写成每个样本一个标量 ℓ_i(相对语义参照的交叉熵类损失),再据此算一个权重 w_i;反向学习公式里每个样本只有一个“带噪”标记,同时管图和文两侧,所以一个样本的图和文同时被判为干净或同时被判为带噪。论文没有说明 ℓ_i 怎样由图像侧和文字侧形成——是两侧交叉熵的和、均值、最大值,还是别的合成,都未写明;预热阶段的总损失把图和文两项交叉熵加在一起,第三阶段单个样本的损失也把观测侧与补全侧两项对齐损失相加,但这两处写法不能自动当作 ℓ_i 的定义。因此这篇解读只能确定:筛选单位是整个样本、两侧共用一个权重和标记;不能断定 ℓ_i 的具体构成,也不能据此推导“一侧很高就一定把整样本推过门槛”。难点在门槛怎么定,固定一个数在不同数据、不同训练阶段都不合适。SPIRN 每个 batch 现算:取这个 batch 里最小的 ℓ_i,乘以超参数 η 当门槛 γ。ℓ_i 最小的样本最可能是干净的,拿它当基准,门槛就随这批数据的难度和训练进度一起变;η 决定容忍度:η 必须大于 1,否则连 ℓ_i 最小的样本权重也接近 0;η = 2 时,ℓ_i 超过 batch 最小值两倍的样本都判为带噪。每个样本的权重是 max(0, 1 − ℓ_i/γ):越接近门槛,权重越小,达到门槛就是 0。手算一下(示意):η = 2,batch 里最小 ℓ_i 是 0.3,门槛就是 0.6。ℓ_i 0.3 的样本权重 0.5,0.45 的权重 0.25,0.9 的超过门槛,权重为 0,被判为带噪。权重大于 0 的样本按权重继续向自己标签的参照向量靠拢。
判为带噪的样本不直接扔掉,而是做反向学习:它的观测标签不可信,就从其他类别里随机挑一个,惩罚模型把它预测成这个类别。示意场景里,B 的观测标签是“狗粮”,随机挑到“鸟食”,就压低 B 被判成鸟食的概率。论文给的理由是保留这些样本里可能有用的结构信息,消融里去掉它只差 0.15 到 0.25,作用有限。我的理解是,类别多时,随机挑中的类别多半不是它的真实类别,“不是这一类”这条信息大概率是对的;示意场景只有 3 类,挑中真实类别的机会有一半,这一步就不太可靠。
这一阶段还加了一项图文对比学习:同一个样本的图和文字拉近,batch 里其他样本不论同不同类都推远。这一项不看权重,batch 里判为带噪的样本也照样参与,因为它只用到图和文是否配对,不用标签。论文给的理由是缩小图和文字两种表示之间的差异:只靠参照向量,图和文字只是各自靠向同一个点,同一样本的图和文字之间没有直接约束。它和向参照对齐的 loss 方向不完全一致,两者的比重靠超参数 β 调。
改标签,再补缺失的模态
编码器训好以后,论文不再信原始标签。图文齐全的样本把图和文字的 embedding 相加再归一化,单模态样本直接用已有的那个 embedding,然后看它和哪个参照向量最相似,就改标成哪一类。示意场景里,B 的 embedding 和“猫粮”向量最相似,标签就从狗粮改成猫粮。这一步对全部样本都做,所以 C 这种只有图的样本也拿到了修正后的标签。改标准确率随数据而变。XMedia 上一半训练样本缺一种模态、60% 标签被打乱时,改完的标签 95.9% 是对的;可在 XMediaNet 只有 20% 样本图文齐全的设置下,选 20% 样本重抽标签时,改完只有 80.6% 对,和原始标签大约八成正确差不多;选 80% 样本重抽时是 68.8%。
接着补缺失的模态。记忆库存的是图文齐全样本训练后的图和文字 embedding。以只有图的 C 为例:拿 C 的图 embedding 在记忆库里找最相似的 K 张图,再用温度 τ 对这 K 个邻居与 C 的图相似度做 softmax,得到权重 a_{i,j},按这些权重把对应文字 embedding 加权求和后归一化,当作 C 补出来的文字 embedding。补出来的不是一段真实文字,而是一个向量。
补出来的向量可能不靠谱,比如 C 的近邻里有的其实属于别的类,或者 embedding 被错标签带偏了。SPIRN 用参照向量给它打分:补出来的文字 embedding 和 C 修正后类别的参照向量越相似,把握越大;不确定度 s 等于 1 减去这个把握(相似度除以温度 τ 后经 sigmoid 变成 0 到 1 的数)。权重是 max(0, 1 − s/γ_m),γ_m 是门槛。手算一下(示意):γ_m = 0.3 时,s = 0.1 的补全权重约 0.67,s = 0.4 的权重为 0,不进入第三阶段训练;门槛升到 0.5 后,s = 0.4 的补全权重是 0.2,开始进入训练。门槛随训练逐步升高,意思是先只用最有把握的补全,再逐步放进把握稍低的,论文没有说明门槛怎样增长。这个把握衡量的是补全和修正后的标签是否一致,不是补全本身对不对;改标错了,两者可能一起错。论文写明的第三阶段目标是:权重大于 0 的单模态样本进入训练;对每个这样的样本,把观测侧 embedding、补出的另一侧 embedding 一起拉向修正后类别的参照向量,并加一项两者之间的成对对比;样本权重乘在这三项上;第三阶段的总损失只在单模态样本集合上计算。补全向量由记忆库近邻加权得到;论文没有说明这些损失怎样回传到可训练参数,也没有说明补全是否每步重算、加权系数 a_{i,j} 是否截断梯度、记忆库要不要随编码器刷新,以及成对对比项的具体形式。 Hoot 说

示意:横轴是补出向量的不确定度 s(1 减去它和修正后类别参照向量的把握),纵轴是这条补全的训练权重 max(0, 1 − s/γ_m)。实线 γ_m = 0.3,虚线 γ_m = 0.5。门槛随训练递增,曲线向右张开:一开始只有最有把握的补全有权重,后来把握稍低的也逐步进来。
出处
论文 CSI 公式 (14)(15):s_i = 1 − σ(ẑ·w_ĉ/τ),ŵ_i = max(0, 1 − s_i/γ_m),γ_m 随训练递增;γ_m 的取值为示意效果怎么样
论文在 Wikipedia、XMedia、INRIA-Websearch、XMediaNet 四个图文数据集上和 11 个已有方法比较,每个数据集都同时调两个变量。缺模态分三档:easy 是 80% 的训练样本图文齐全,只有图和只有文字的各占 10%;medium 是一半齐全,两种单模态各占四分之一;hard 只有 20% 齐全,两种单模态各占 40%。
标签噪声只加在训练集上:随机选一部分训练样本,把标签在所有类别里重新均匀抽一个,被选中的比例从 20% 到 80%。测试集标签是干净的,所以测出来的分数反映的是模型有没有被错标签带偏。
表里的对比方法分两类。EGICH(缺模态方法)和 GNN4CMR(缺模态方法)依赖干净标签;RONO(错标签方法)和 RSHNL(错标签方法)被论文归为对错标签稳健、但用不好单模态样本的一类。论文没有说明原本假设图文齐全的方法在缺模态设置下具体怎么处理单模态样本,所以下表数字按论文报告照录;这篇解读不能据此断定各方是在相同有效训练数据量下比较的。下表是图搜文(I2T)和文搜图(T2I)的 mAP(%),每组列出该设置下最强的已有方法,以及另一条路线的一个代表方法。
| 数据集与设置 | 方法 | I2T | T2I |
|---|---|---|---|
| XMediaNet,hard,60% 噪声 | GNN4CMR | 21.0 | 23.3 |
| RSHNL | 13.6 | 14.9 | |
| SPIRN | 49.2 | 48.5 | |
| XMediaNet,medium,60% 噪声 | EGICH | 37.3 | 38.7 |
| RSHNL | 35.6 | 37.1 | |
| SPIRN | 55.8 | 55.8 | |
| Wikipedia,medium,60% 噪声 | RONO | 36.1 | 34.9 |
| EGICH | 22.3 | 21.4 | |
| SPIRN | 45.6 | 41.4 | |
| Wikipedia,easy,20% 噪声 | RONO | 49.4 | 45.2 |
| EGICH | 45.6 | 40.1 | |
| SPIRN | 49.7 | 45.1 |
几组数字各说明一件事。EGICH 在 Wikipedia medium 下噪声从 20% 升到 60%,它的图搜文从 45.4 掉到 22.3,说明只解决缺模态、靠标签当基准的方法,标签一乱就塌。RSHNL 在 XMediaNet 上 60% 噪声时,缺模态从 medium 变成 hard,它从 35.6 掉到 13.6;论文的解读是,这类方法对错标签稳健,但用不好缺模态的样本。SPIRN 在同样两个方向上掉得少得多:Wikipedia medium 噪声从 20% 升到 60%,它从 47.4 到 45.6;XMediaNet 缺模态从 medium 变成 hard,它从 55.8 到 49.2。最后一组说明,在 Wikipedia 上缺得少、错得少时它几乎没有优势,文搜图还低 0.1;不过同样的 easy、20% 噪声设置下,INRIA-Websearch 和 XMediaNet 上它仍领先 5 到 7.5 个点。
消融在 medium、60% 噪声下做,每次只去掉带噪学习阶段的一项 loss,参照向量、预热、改标和补全都保留。去掉按权重向参照向量对齐的那项,XMediaNet 平均 mAP 从 55.81 掉到 16.15,XMedia 从 89.84 掉到 84.12,说明这一步不可缺;论文的解释是:没有这项监督,就没法可靠衡量样本和参照是否一致,干净和带噪样本难以分开。这是论文对掉分原因的解释,消融本身只说明整体掉分。去掉图文对比学习,XMedia 降到 82.86,XMediaNet 只降到 54.99,影响随数据集差别很大。去掉反向学习影响很小,两个数据集都只差 0.15 到 0.25。
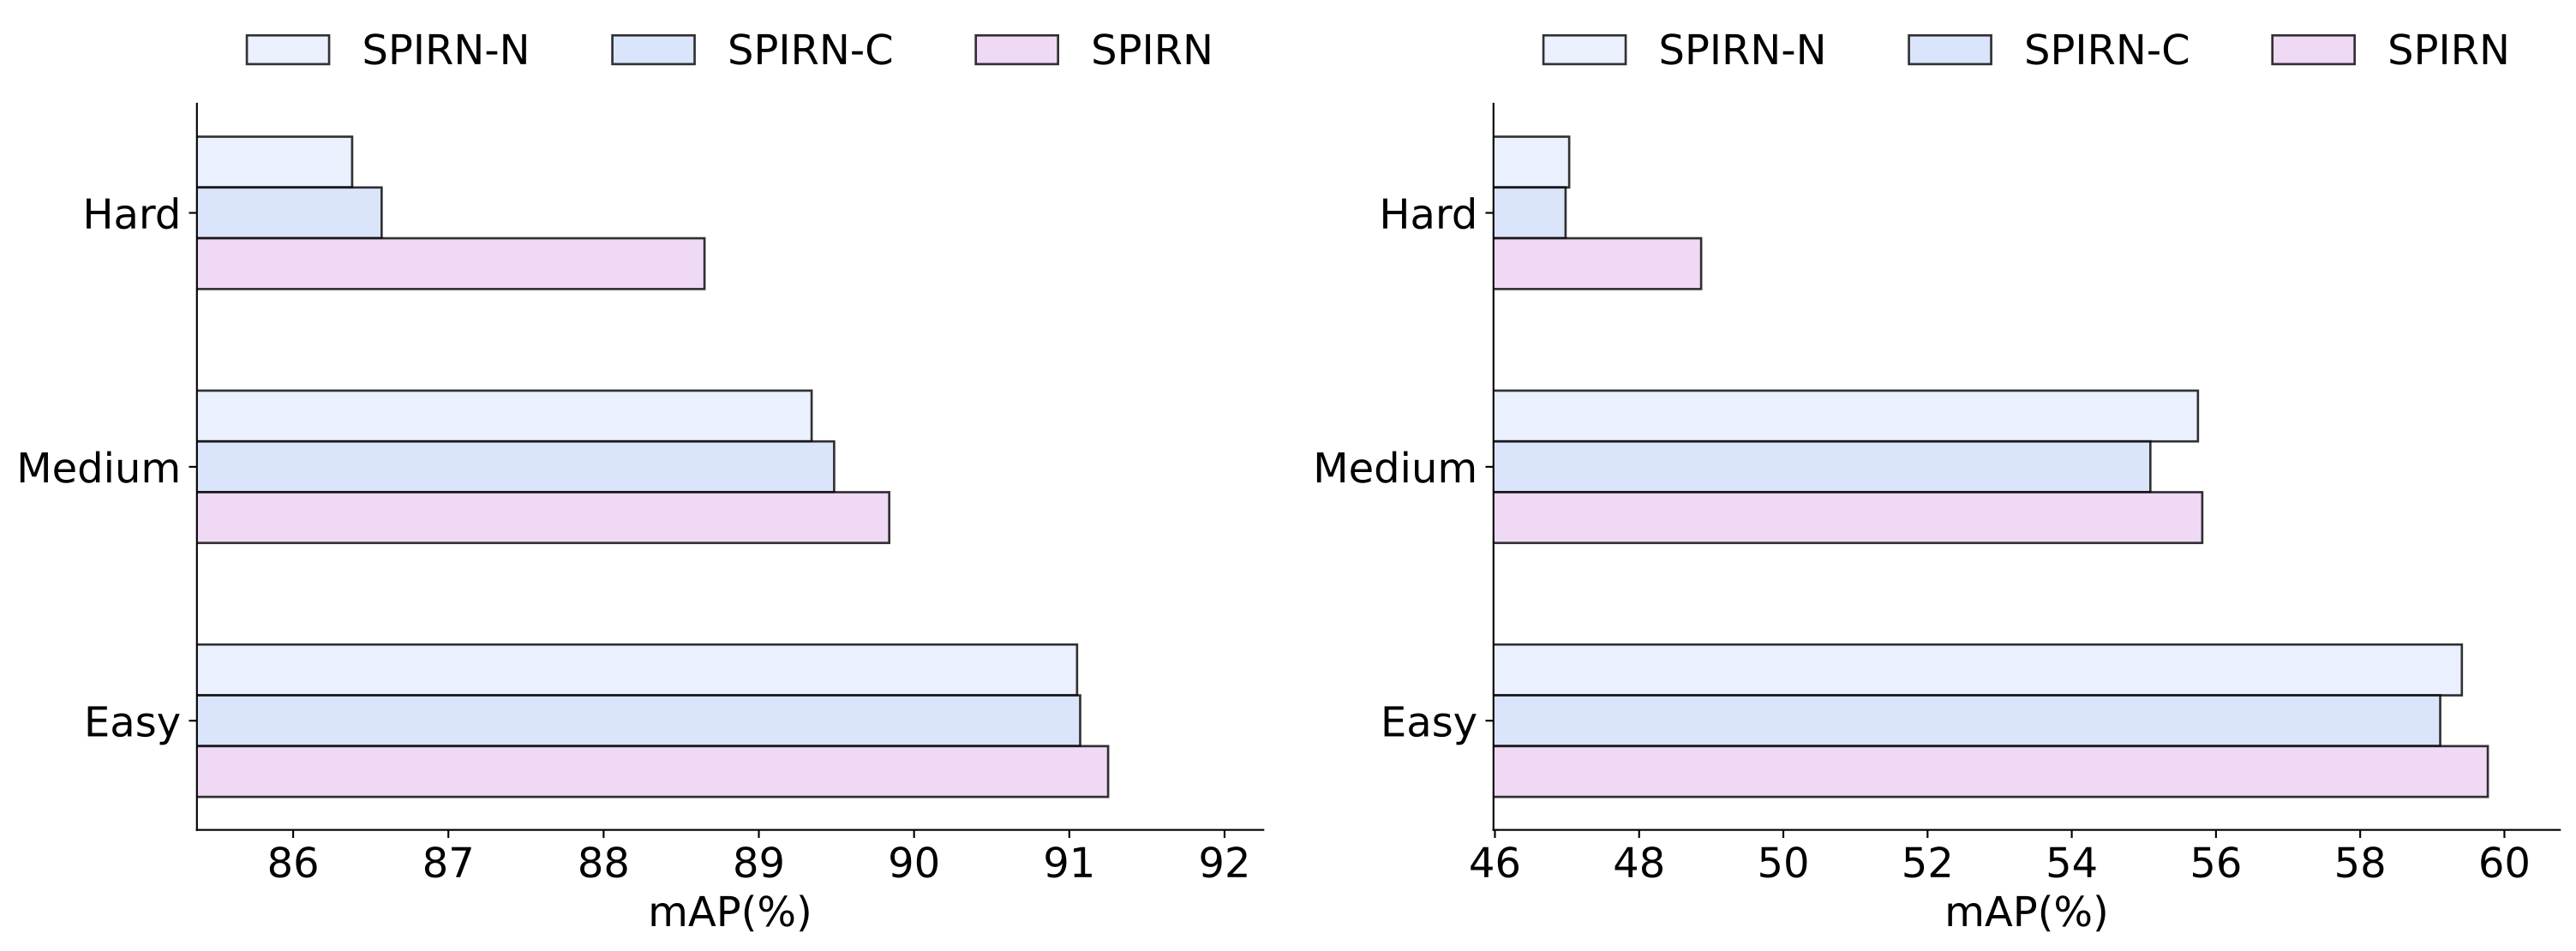
补全这一步要看图 5。补出来的东西不加过滤全用,可能比不补还差:XMediaNet medium 下,全部补全的柱子比不补全的短。按把握过滤后,在 hard 设置下比两者都高出一截;但在 easy 和 medium 下,和不补全的差距不大。
我认为它的局限
第一,噪声是均匀随机的。实验把选中样本的标签在所有类别里均匀重抽,而线上常见的错标集中在相近类别之间,比如猫粮和狗粮互标。猫粮和狗粮的商品图本来就像,一个错标成狗粮的猫粮样本,embedding 离“狗粮”参照向量也不会太远,loss 不一定高,按 loss 挑干净样本会难很多。示意场景里 B 的 loss 高,是按均匀噪声的情况设定的;真实的猫粮、狗粮互标下未必如此。实验只用了均匀噪声。
第二,在分数本来就高的数据集上,轻度损坏时优势很小。Wikipedia easy、20% 噪声时,图搜文只比 RONO 高 0.3,文搜图还低 0.1;XMedia 同样设置下,图搜文和最好的已有方法持平(都是 90.6),文搜图只高 0.9。数据只是轻度缺失、轻度错标的团队,引入这三阶段训练前要先在自己的数据上比一比。
第三,消融回答不了最关键的问题。它只说明向参照对齐这项 loss 不可缺,没有拿固定参照和可学习类中心比,也没有单独去掉按 loss 加权。反向学习去掉只差 0.25,选择性补全只在 hard 设置下明显领先。我推测撑起结果的是固定参照和按 loss 加权,但这是推断,下面试用计划的前两步就是去验证它。
一个推荐/搜索团队可以怎么试
适合的场景是按类别检索的多模态库,比如商品库里有些商品只有图、有些只有标题,类目由商家填、错标不少。
- 先把现有图文模型的分类头换成固定的正交参照向量,只用图文齐全的样本训练,和可学习类中心的版本在同样数据、同样训练轮数下比;可学习的版本也用同一个正交矩阵初始化,这样两版起点相同,差别只在训练中动不动,测试集用一份人工核过类目的数据,看类别级检索 mAP。再按论文的均匀重抽协议,把选中重抽标签的训练样本比例调高几档(选中比例不等于实际错标率,因为重抽仍可能抽回原类),看固定参照版本的 mAP 是否更高、掉得是否更少。这一步只改分类头是否固定,看出的就是“固定”这一点在错标签下是否更稳,而不是正交初始化的作用。
- 再加按 batch 最小 loss 定门槛的加权,抽查被判为带噪的样本里有多少真是错标,并和全量数据的错标比例比。前者明显更高,说明这套挑样本的规则在自己的数据上成立。
- 用参照向量给全部样本改标,在同一批抽样样本上人工核对改标前后的标签。改完的准确率不高于原始标签,就不要往下做补全。
- 最后对单模态商品做记忆库补全,对比不补、全补、按把握补三组。按把握补要比不补好才值得上;全补比不补差,说明过滤是必要的。
结论
最值得带走的一点是:标签可能错、数据可能缺的时候,先找一个不会跟着它们移动的参照,再用它去判断其他样本。这个参照可靠的前提是训练早期先学到了对的规律,噪声越高这个前提越弱。SPIRN 用一组固定的正交向量当这个参照,在重度损坏的学术基准上效果明显;轻度损坏时在部分数据集上优势很小,真实错标模式下也没有测过。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。缺模态和错标在真实多模态库里经常同时出现 |
| 方法创新性 | 中。按 loss 挑干净样本、用近邻补缺失模态在相关工作里都有,新意在用固定参照把它们串起来 |
| 实验证据 | 中。四个数据集、11 个基线,但噪声是合成的均匀噪声,只测类别级检索 |
| 工程成本 | 低到中。改动在训练阶段:三阶段训练加一个记忆库近邻查询,除两个编码器外不引入新模型 |
| 是否值得尝试 | 值得试前两步。固定参照和按 loss 加权改动小,容易验证 |
| 适用场景 | 按类别检索、类目标注质量差、部分样本缺图或缺文的多模态库 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Retrieval · 2026-11-03Better Retrievers, Worse Labels: How Incomplete Relevance Judgments Distort Abstention Evaluation in Conversational RAG对话式 RAG 评测里,判断检索内容够不够回答常走一条捷径:检索结果里没有标注过的相关文档,就算答不了,模型这时拒答算对。作者在 RECOR 上换了四个检索器重跑,发现检索器越强,这条捷径越不准:没有标注文档、其实却含有答案的上下文,从 28% 升到 72%。原因是相关性标注不全,强检索器常常找到没被标过的有用文档。用这条捷径打分,会奖励本该回答却拒答的模型。评测拒答时应该看检索内容本身,而不是看有没有命中标注文档。
 Retrieval · 2026-11-12FERN: Cross-Benchmark Table Retrieval for Text-to-SQL with Frozen Retrievers and Learned RankingText-to-SQL 面对几百张表的大目录,第一步是把问题要用到的表找出来,现在流行让大模型读 schema 来挑。FERN 的检索链路里没有任何生成式大模型:三个现成的检索器各自召回,合并成候选池,每张候选表算一大批特征,再用只在 BIRD 训练集上训过一次的 LightGBM 排序。换到没训过的 Spider 上,前五张表就把所需表全部找齐的问题比例从 83.9% 提到 95.6%,前五张表的召回和调用 Claude 的 RASL 只差不到一个点。在 BIRD 上每个问题的中位延迟约 208 毫秒,也不用把 schema 发给外部服务。短板同样明显:BIRD 不给提示信息时落后不少,Fiben 上差得更远。
 Retrieval · 2026-11-03How BERT-based Cross-Encoders Model Relevance in Information Retrieval?基于 BERT 的 cross-encoder 是最准的重排模型之一,但它内部怎么判断相关一直说不清。论文在三个大小不同的模型、多个域内和域外数据集上追踪信息怎么流动,发现三个模型走的是同样的几个阶段:前中层先让 token 结合上下文,同时有专门的注意力头找 query 和文档之间的字面匹配;更深的层出现找语义匹配的头;最后这些信号汇到 query 的 token 和 [CLS] 上打分。细节则各不相同:三个模型把相关信号汇进 [CLS] 的方式不一样,MiniLM 甚至可能是在找“不相关”的证据。
 Retrieval · 2026-11-02xPRT: Cross-Passage Retrieval Pretraining同一篇网页里哪几段在讲相关的事,本身就能拿来训练检索模型。xPRT 先挑出向量和全文平均向量足够接近的段落当代表段,再按向量相似度和词面重合,给每个代表段找出同文档里最相关的四段,然后训练 embedding:代表段要在混着其他文档段落的候选里认出和它最相关的那一段;相关段被遮掉大部分词后,单层小解码器要借助代表段的向量把这些词补回来。在已经很强的 E5 上只换训练目标继续预训练,五种已有方法在 MTEB 上最多涨 0.38 分,xPRT 稳定涨约 1.8 分。起作用的主要是正样本怎么选,新加的补词项只贡献一小部分。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…