目录 · 7 节
1A 搜一次「牛肉」,请求从进来到出候选经过哪几步?2把位置写进商家 ID 之后,beam 名额怎么省下来?3同样搜「牛肉」,模型靠什么把生鲜排到热食前面?4beam 里挤满同一个连锁的门店时,该奖励谁?5为什么 TS-GEAR 在 20 km 领先三成多,5 km 几乎没差?6去掉哪个部件,HR@50 掉得最多?7上线拿到了多少收益,代价落在谁身上?
淘宝闪购这篇广告召回论文最关键的改动,是让召回模型生成商家 ID 时先写「商家在哪一片」、后写「商家卖什么」,送不到的商家因此很难再占候选名额。
淘宝闪购是一个即时配送平台,用户下单外卖或生鲜后,骑手通常在一小时内送到。用户在这里搜索时,广告系统要先召回一批商家,再交给后面的广告排序和竞价。和普通电商不同,超出配送范围的商家对这位用户就是无效候选,排到第几位都没有意义。配送范围还会随骑手供给、天气和距离实时变化,同一家店此刻送得到的地址,过一会儿可能就送不到,所以平台没法给每个商家预存一个固定的「送得到」标记。
生成式召回近几年常用 Semantic ID(SID):每个商家编成几个 token,比如 [17, 203, 88](示意),内容相近的商家靠前的数字往往相同。模型读入用户历史和 query,一个 token 一个 token 地写出 SID,beam search 保留得分最高的一批序列。这些 token 来自商家内容或协同信号,里面没有位置。系统要保证送得到,只能等 SID 生成完、查出对应的商家,再按距离筛一遍。
论文用一个例子说明这会出什么事。用户 A 工作日常在公司附近点外卖,历史订单大多是牛肉盖饭这类热食店。周末早上 A 在家打开淘宝闪购搜「牛肉」,想买生鲜牛肉回来自己做。模型顺着历史把高概率给了公司附近的盖饭店,这些店和「牛肉」语义很近,却送不到 A 的家。
示意:beam 只有 10 个位置,公司附近的店占了 7 个,按距离筛完只剩 3 个候选。这 7 个位置已经作废。筛选又发生在模型生成之后,不参与训练的 loss 计算,所以模型在训练时不会因为占了这 7 个位置而受到任何惩罚。
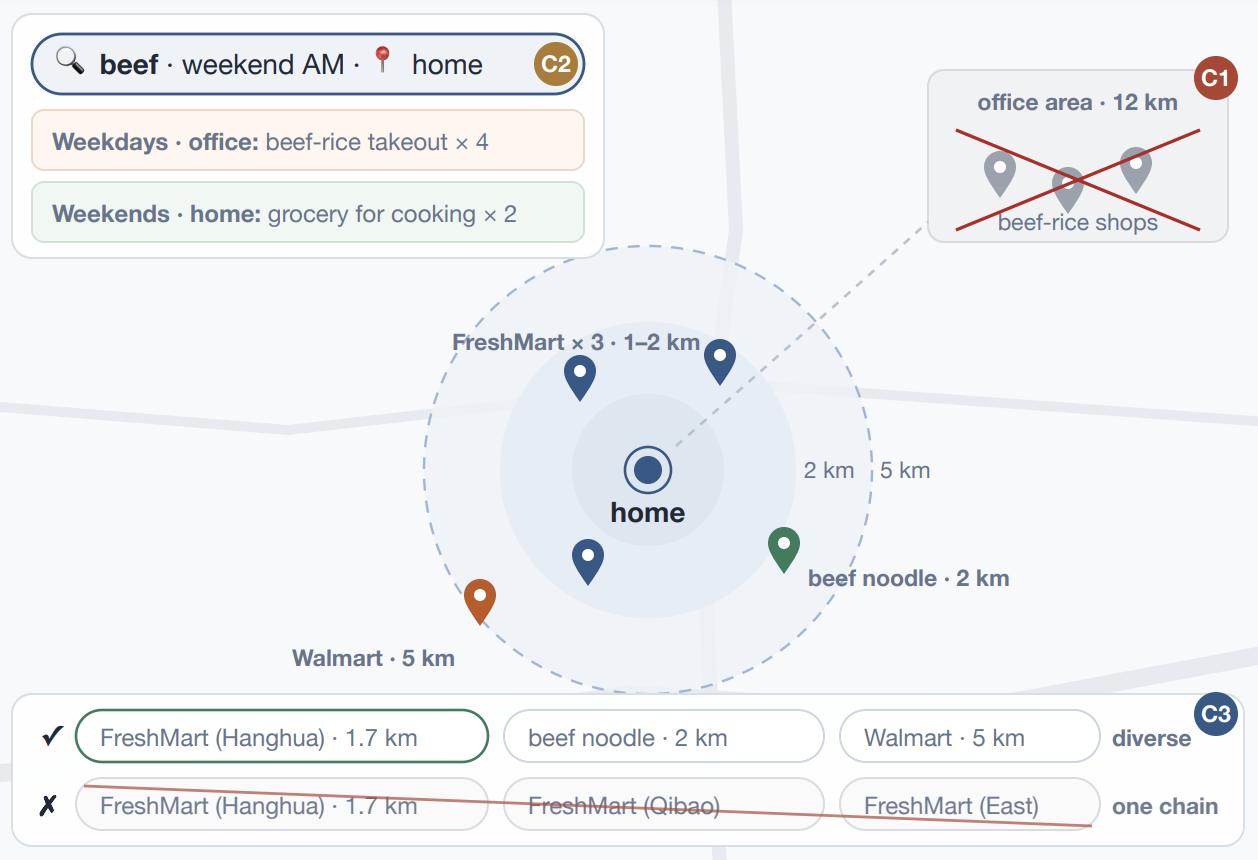
最接近的现有做法是把地理信息当软信号用,也就是只让近的商家得分高一点,不做硬性限制。GNPR(一种给地点推荐做 SID 的生成式方法)在把商家压成 SID 编号时,把地理特征也作为输入,OneLoc 在解码时让模型偏向附近商家,OneLoc 是这一类里最强的方案。放回 A 的例子,软信号能把公司附近店的概率压低一些。可 A 的历史里盖饭店足够多,那 7 个位置可能只让出 2 个(示意)。
论文的系统 TS-GEAR 把地图切成格子,把商家所在的格子直接写进商家 ID,并在解码时把 ID 的开头限定为用户周围的九个格子。线上召回只要用户 20 km 半径内的商家,在这个半径下,TS-GEAR 的前 50 个候选有 95.8% 在半径内,OneLoc 只有 35.4%。下文说的「半径内」「可达」都按商家和用户的距离算,模型约束的是商家所在的格子。这两个比例说的是 beam 名额有多少花在半径内的商家上,这些名额怎么变成命中率,后面再算。先看 A 这次搜索怎么走完全程。
A 搜一次「牛肉」,请求从进来到出候选经过哪几步?
| 步骤 | 输入 | 操作 | 产出 | 何时发生 |
|---|---|---|---|---|
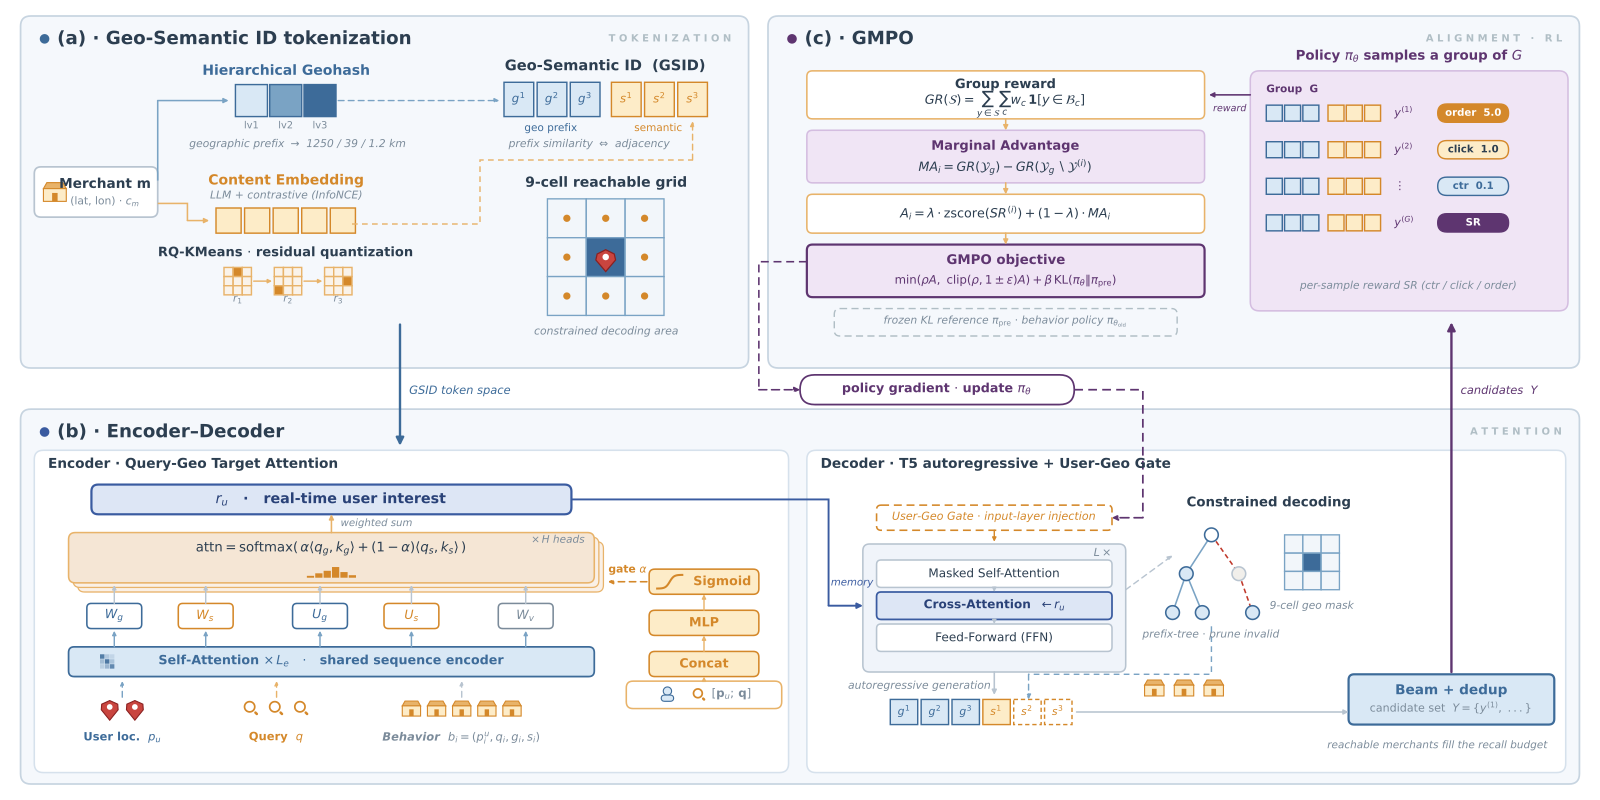
| 给商家编 ID | 商家经纬度、文本描述 | 位置转成 geohash 切三段,内容 embedding 聚类成三个编号 | 六个 token 的 ID,示意:[wt, w3, sj, 17, 203, 88] | 离线 |
| 汇总用户历史 | A 的实时位置、query「牛肉」、100 条历史行为 | 每条历史行为按位置和 query 各算一次相似度,再加权汇总 | 一个用户表征,供 decoder(逐位写 ID 的那部分模型)读取 | 训练和线上 |
| 写地理 token | A 所在的格子和周围 8 格 | 前两个 token 直接填成这些格子的编码(至多 9 种前缀),第三个由 decoder 写 | 商家所在的约 1.2 km 小格 | 解码生成候选时才直接填写前两个 token,训练时模型逐位学完整的 6 个 token |
| 写语义 token | 地理前缀、用户表征 | decoder 接着写三个语义 token | 完整 ID;beam search 留下得分靠前、去重后的一批 ID 作为候选 | 训练和线上 |
| 按一组候选的价值调整模型 | 一个请求的 8 条采样结果,真实的点击和下单 | GMPO(论文改过奖励算法的强化学习训练)只奖励命中了其他样本没命中的真实行为的样本 | 更新后的模型 | 只在训练时 |
| 交给后面的链路 | 去重后的候选 | 和关键词召回、向量召回等其他召回通路并行 | 一起进入广告排序和竞价 | 线上 |
模型的训练分两段。第一段用点击日志做预训练:输入一次搜索请求,目标是被点击商家的 6 个 token,模型逐位预测。第二段是 GMPO(论文改过奖励算法的强化学习训练),它按一组候选的整体价值继续调整模型。
把位置写进商家 ID 之后,beam 名额怎么省下来?
给商家贴一个「配送范围」属性行不通,因为范围随骑手和天气变化。像 GNPR 那样在压成 SID 时混入地理特征也不够,因为生成出来的 ID 里没有哪一位专门代表地理,解码时没法指定哪几位必须落在用户附近。TS-GEAR 用 geohash 把位置变成 ID 里单独的一段。
geohash 把地图切成一层层格子,每个格子对应一串字符,前缀相同的格子在地图上挨得近。论文用 6 位 geohash 表示商家位置,最小的格子约 1.2 km × 0.6 km。geohash 每个字符有 32 种取值,这 6 个字符每两个切成一个 token,所以每个 token 有 32×32=1024 种取值。只看第一个 token 能定位到约 1250 km 的范围,加上第二个缩到约 39 km,三个都看缩到约 1.2 km。
语义部分沿用 SID 的做法。商家的区域、品牌、品类和常见 query 写成一段结构化文字,交给微调过的 Qwen3-Embedding 得到 embedding,再用 RQ-KMeans 逐层聚类成三个编号。
示意:生鲜店乙的 geohash 是 wtw3sj,内容编号是 17、203、88,它的完整 ID 就是 [wt, w3, sj, 17, 203, 88]。论文把这串 ID 叫 GSID(Geo-Semantic ID)。前三位回答商家在哪,后三位回答商家卖什么。
decoder 从 ID 的第一位写起,位置放在 ID 开头,解码时就能先限定前几位。用户位置的前 4 位 geohash 正好对应 ID 的前两个 token,代表一个约 39 km 的格子,这个格子和周围 8 个格子拼成九宫格,基本盖住平台的最大配送半径。系统按 A 的实时位置查出这些格子的编码,也就是至多 9 种前缀,直接当作已经写好的前两个 token。所以 6 个 token 里,模型要自己写的只剩 4 个。
示意:不加限制时,前两个 token 有 1024×1024,约 100 万种组合,beam 的名额可能花在外地商家的前缀上。加了九宫格,这一步最多只剩 9 种组合,外地商家进不了 beam。
九宫格挡不住所有半径外的店。九个约 39 km 的格子拼起来比 20 km 半径大得多。如果公司离 A 家 30 km(示意),公司楼下的盖饭店很可能仍在九宫格里。公司和家落在不同的约 1.2 km 小格里,所以这些店能不能被避开,取决于第三个地理 token,也就是 decoder 要写出的那个小格。
训练时目标序列是用户真实点过的商家,所以第三个 token 学到的是:站在这个位置的用户,点的商家通常落在哪个小格。User-Geo Gate(decoder 里按用户位置调节输入的门控)给写地理 token 的步骤补上用户的实时位置。decoder 写地理 token 时,把用户当前位置的 embedding 加到输入上;写语义 token 时不加,以免干扰内容生成。
加入多少由门控决定,门控由当前输入向量和位置 embedding 算出来,每一维一个值,也就是 。这里 是 decoder 写这一位 token 时的输入向量, 是用户位置的 embedding, 是 0 到 1 之间的门控,数值越大,加入的位置信息越多。
示意:某一维 、,门控 0.9 时结果是 2.8,门控 0.1 时结果是 1.2。门控只读这两个输入,推理时并不知道目标商家在哪。作者期望训练后门控在位置信息有用时接近 1;遇到目标商家落在相邻格子的情形则变小,位置 embedding 加入得少,模型还能写出隔壁格子的编码。硬规则只作用在前两个 token 上,第三个 token 上的位置信息只是一种偏置。
同样搜「牛肉」,模型靠什么把生鲜排到热食前面?
地理前缀管的是候选落在 A 周围的半径内,A 要哪一种牛肉还没解决。A 的历史里公司附近的热食店占多数,用 self-attention 直接汇总时,当前 query 和位置不参与给历史打权重,用户表征会被这些高频行为主导。这时 beam 里靠前的会是 A 家附近的热食店,它们在半径内,但不是 A 这次要的。
Query-Geo Target Attention 用本次请求给每条历史行为打分,分数分两路算。地理这一路比较 A 的实时位置和两样东西:这条行为发生时 A 在哪,这条行为的商家在哪。语义这一路比较当前 query 和另外两样东西:这家商家卖什么,A 当时搜的词是什么。两路分数按一个 0 到 1 的权重 α 合成一个分,模型根据当前位置和 query 算出 α,α 越大越看重地理这一路。
示意:A 有三条历史,两条是工作日在公司点盖饭,一条是上周六在家买牛腩。三条的语义分都是 3,地理分分别是 0、0、4,α 取 0.5。每条得分等于 0.5 倍地理分加 0.5 倍语义分,三条是 1.5、1.5、3.5。差 2 分经过 softmax 约是 7.4 倍,所以在家那条的权重约 79%。如果不看位置,三条分数相同,公司的两条合起来占三分之二。
历史很少的用户需要一个兜底。这类用户的加权结果噪声大,Query Fusion 再用一个门控,把历史加权结果和 query 的表示按比例混合,历史信号弱时更多依赖 query。示意:门控取 0.2 时,用户表征是 0.2 份历史加 0.8 份 query。
beam 里挤满同一个连锁的门店时,该奖励谁?
现在 A 的候选大多落在半径内,也更偏向生鲜。新的问题是,预训练时每个序列单独算 loss,没有一项会惩罚候选之间的重复,beam 容易被同一个生鲜连锁的几家门店填满。每家门店单看都是 A 想要的生鲜店,放在一起却彼此重复,牛肉卷、牛肉面这些选择被挤了出去。
常用的强化学习对齐方法 GRPO 对同一请求采样一组序列,奖励高于同组平均的序列调高概率,低于平均的序列调低概率。每个样本的奖励只看它自己,重复的样本照样拿分。淘宝闪购搜索里多达七成的 query 只有一次点击,所以预训练和强化学习用的样本重合很多,预训练出来的模型输出已经很集中。作者的解释是,一旦训练时生成的这组结果全变成同一个 GSID,所有样本奖励相同,减去均值后全是 0,梯度消失,策略就卡在几个高分序列上。下文把概率这样集中到少数 GSID 上叫塌缩,评测时候选虽然去重,覆盖的真实行为也会变少。
GMPO(Group Marginal Policy Optimization)改的是奖励的算法,它看一个样本给整组添了多少。系统先算整组采样结果去重后的总分(命中的真实行为按权重相加),再算拿掉这个样本后其余样本的去重总分,两者之差就是这个样本的边际优势。部署版本训练时每个请求采样 8 条序列,完全用边际优势,不再用 GRPO 的单条奖励。行为权重是下单 5、点击 1、高 CTR 曝光 0.1,高 CTR 曝光指展示过但没被点击的高 CTR 商家。
示意(权重用论文的,8 条采样简化成 3 条):A 这次下单了生鲜店甲,点击了牛肉面店乙,三条采样结果对应的商家是甲、甲、乙。GRPO 按单条算奖励是 5、5、1,平均约 3.7,两个甲被调高,乙被调低。GMPO 先算整组去重总分 5+1=6。拿掉第一个甲,第二个甲还在,总分仍是 6,边际优势是 0,第二个甲同理。拿掉乙,总分变成 5,乙的边际优势是 1。
这个例子里,重复的甲不再得分,带来新覆盖的乙得到强化。去重按 GSID 算,同一连锁的另一家门店 GSID 不同,不算重复;它只有命中其他样本没命中的真实行为才得分,否则边际优势也是 0。已经塌缩的一组里每条都是重复,边际优势同样全是 0,所以 GMPO 的作用发生在塌缩之前:重复的样本一直拿不到奖励,策略就不会被继续推向同一个序列。GMPO 的奖励里也没有放地理项,因为前缀约束已经让 95% 以上的候选落在半径内,它只管业务价值。
作者用线上的解码设置(beam@100,去重)比较了预训练模型、GRPO 和 GMPO 的 Coverage,也就是一组去重候选平均命中多少条真实行为。
| 相对预训练模型的 Coverage 变化 | 点击 | 高 CTR 曝光 | 下单 |
|---|---|---|---|
| GRPO | −0.6% | −2.9% | +3.3% |
| GMPO | +1.8% | +0.7% | +4.9% |
GRPO 只有权重最高的下单在涨,点击和高 CTR 曝光都比预训练模型还差。这说明按单条奖励优化时,beam 向下单商家集中,下单的提升是拿其他类型的候选换来的。GMPO 三项都涨,高 CTR 曝光从 −2.9% 变成 +0.7%,作者认为这说明,策略集中时最先被挤掉的这类候选回来了。
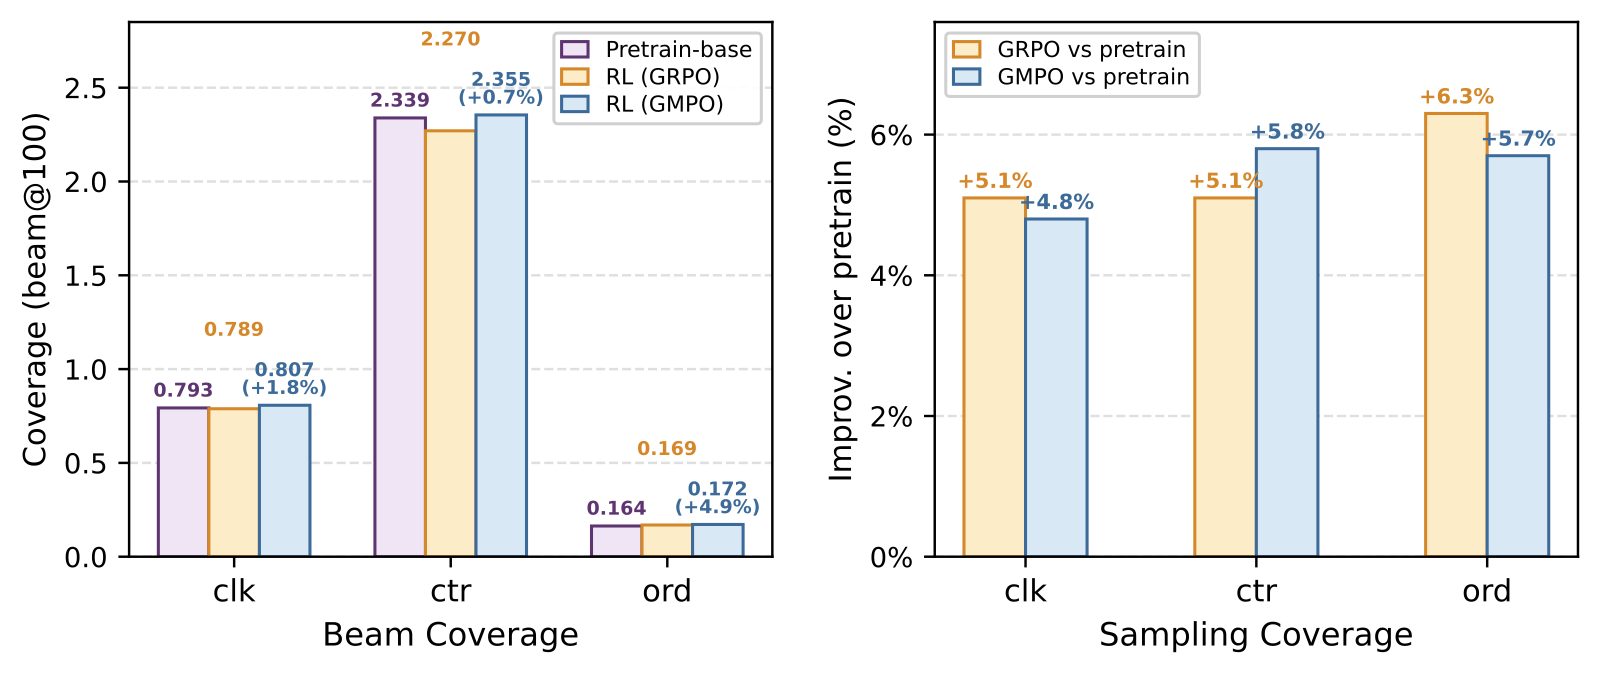
如果候选不用 beam search 取最高分,而是按模型概率随机采样出来再评测,GRPO 和 GMPO 几乎没差,都明显好于预训练模型,到了 beam search 两者才分开。作者认为采样的随机性维持了一组结果的多样性,掩盖了概率的集中;beam search 固定取得分最高的一批序列,这种集中才显现。线上解码用的是 beam search,作者因此认为,只看采样评测会高估强化学习在线上的收益。
为什么 TS-GEAR 在 20 km 领先三成多,5 km 几乎没差?
离线评测的数据是淘宝闪购搜索广告 12 天的日志,约 1 亿用户、480 万商家,最后一天做测试。TIGER 代表普通 SID 加事后距离过滤,GNPR 和 OneLoc 是软信号方案,三个基线用相同的数据、模型规模和 beam 配置。
HitRate@N 模拟线上链路:按 beam 顺序走,只留半径内的去重商家,最多留 N 个,用户真实点过的商家落在其中就算命中,下表写作 HR。所有模型都先按距离过滤,再截断到 N 个。所以 HitRate 的差距不来自谁多展示了半径外的店,反映的是半径内能留下多少候选、这些候选的先后顺序好不好。
| 配送半径 | OneLoc HR@50 | TS-GEAR HR@50 | 相对提升 |
|---|---|---|---|
| 5 km | 0.7778 | 0.7869 | +1.2% |
| 10 km | 0.7092 | 0.8090 | +14.1% |
| 20 km(线上半径) | 0.5929 | 0.8080 | +36.3% |
这张表回答的是收益出在哪里:半径越大,差距越大。作者的解释是,5 km 内可达商家少,前 50 个可达候选已经覆盖了其中很多,各模型都接近饱和。半径放大后可达集合变大,任务变成在更大的集合里挑出用户会点的商家。
示意:5 km 内只有 60 家半径内的商家,取前 50 个几乎是把它们列了一遍,哪个模型都差不多。20 km 内有 800 家,前 50 个只占十六分之一,模型要从 800 家里挑出用户会点的那些,beam 名额有多少花在可达商家上,差别就显出来了。
ValidRate@N(下文叫有效率)不做距离过滤,直接看前 N 个候选有多大比例在半径内。20 km 下,TS-GEAR 的前 50 个候选有 95.8% 在半径内,OneLoc 是 35.4%;看前 300 个候选,两者是 93.0% 和 29.3%。这说明 OneLoc 的候选里有六到七成花在了半径外的商家上,TS-GEAR 把这部分名额收了回来。
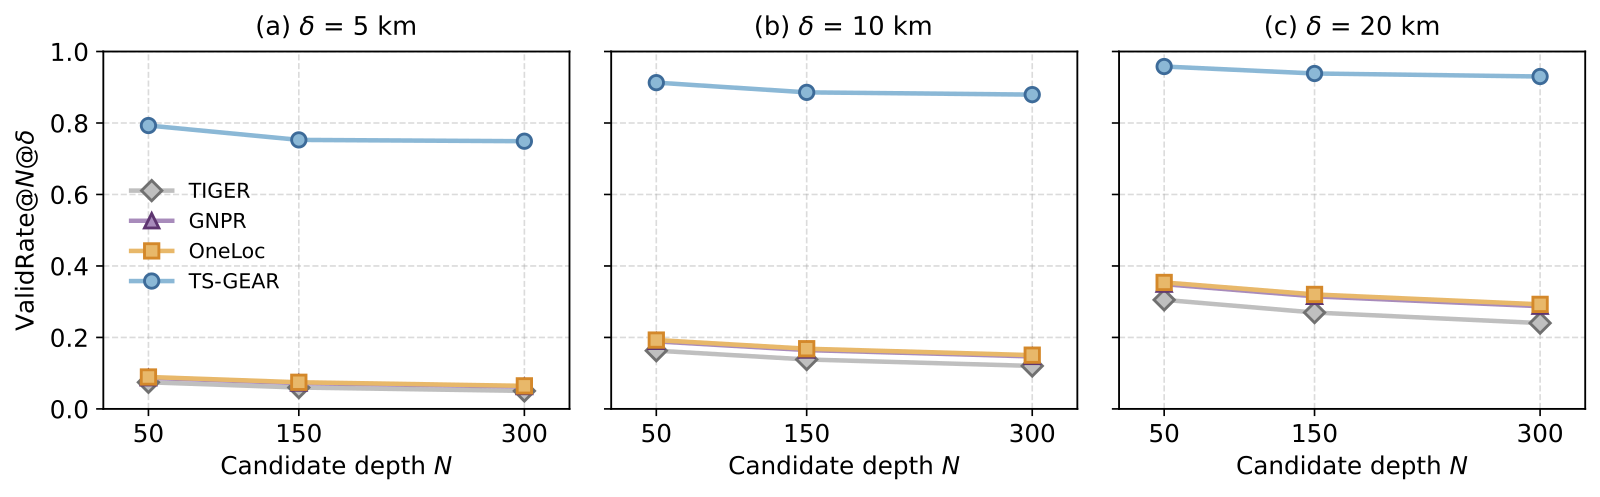
20 km 下,HR@50、HR@150、HR@300 相对 OneLoc 的提升依次是 36.3%、17.4%、11.5%。这说明候选名额越少(N 越小),把名额留给半径内商家带来的提升越大。
公开的 Foursquare 签到数据(纽约和东京两个子集)上,TS-GEAR 仍然排第一,HitRate 比 OneLoc 高 3.1% 到 6.0%。这份数据没有配送半径,query 也只是占位符(没有真实搜索词,统一填默认值),所以九宫格约束几乎用不上。这说明更强的地理建模带来更好的召回,这个趋势换一份数据也成立;三成多的幅度则出现在有配送半径的场景里。
去掉哪个部件,HR@50 掉得最多?
| 消融版本 | HR@50,5 km | HR@50,10 km | HR@50,20 km |
|---|---|---|---|
| 完整模型 | 0.7869 | 0.8090 | 0.8080 |
| 去掉 Query Fusion | 0.7865 | 0.8092 | 0.8080 |
| 去掉 User-Geo Gate | 0.7773 | 0.7961 | 0.7934 |
| 去掉 Query-Geo Target Attention | 0.7661 | 0.7836 | 0.7820 |
| 去掉地理前缀 | 0.7794 | 0.7111 | 0.5947 |
| 去掉地理前缀和 User-Geo Gate | 0.7819 | 0.7124 | 0.5960 |
| 对照:OneLoc | 0.7778 | 0.7092 | 0.5929 |
去掉地理前缀后,10 km 和 20 km 的 HR@50 退回 OneLoc 的水平,5 km 几乎不动。这说明大半径下的领先,大部分要算在地理前缀上。
地理前缀去掉以后,再去掉 User-Geo Gate,结果反而比保留门控略好,20 km 上是 0.5960 对 0.5947。作者的解释是,门控只能在前缀限定好的可达格子里调整先后,没有这个前提,它只会给整个 ID 空间的解码顺序添噪声。这说明地理前缀和门控要一起用,两者的贡献不能简单相加。
前缀还在、只去掉门控时,20 km 下的 HR@50 掉 1.46 个百分点,而且半径越大、可达商家越多,掉得越多。作者把这两个部件看成分工:地理前缀决定哪些格子可选,门控决定先写哪个格子。去掉 Query-Geo Target Attention 掉得更多,20 km 下是 2.60 个百分点,而且随半径变化相对平缓。作者认为这说明 Query-Geo Target Attention 作用在兴趣表示上,因为 A 要生鲜还是热食,和半径大小没有关系。Query Fusion 在全量人群上的差异不超过 0.05 个百分点,因为它是给历史稀疏用户的兜底,放到全部流量里就被稀释了。
作者还给了一个论证。如果在普通 SID 上解码时直接屏蔽半径外的候选,有效率也能逼近 100%,可模型的概率分布没有学过地理,留下的候选顺序依然不看位置。最接近的证据就是上面的门控实验:九宫格约束不动,只去掉门控,5 km 到 20 km 下的 HR@50 仍然掉 0.96 到 1.46 个百分点。这说明九宫格约束固定之后,门控仍能改善命中率,其中既可能有半径内候选数量的变化,也可能有顺序的变化。A 家附近的生鲜店和热食店都在半径内,把生鲜店排到前面才会变成命中。
上线拿到了多少收益,代价落在谁身上?
线上部署的是 0.1B 这一档模型。作者试过 0.05B、0.1B、0.5B 三档模型,HitRate 大致随容量线性上升,有效率基本不变,作者据此认为有效率主要由前缀约束决定。选 0.1B 是为了满足线上延迟要求,部署用的 A10 GPU 上,延迟预算是 70 ms。九宫格在这里还省了算力,线上跳过前两个地理 token 的生成,并复用 KV cache。
TS-GEAR 在线上是一路增量召回,和关键词、向量等现有召回路并行,结果一起进入广告排序和竞价。加入这一路召回的实验组占 20% 流量,连续跑 7 天,相比对照组,广告曝光 +3.8%,广告收入 +4.2%,都是 p<0.01。这说明在已有多路召回的链路上,多加这一路仍能带来收入增长。这组数字是整路召回的效果,没有拆到地理前缀、Query-Geo Target Attention 或 GMPO 各自的线上贡献。TS-GEAR 现已全量上线,每天服务超过 1.5 亿次搜索请求。
作者自己也写了代价。解码限制在九宫格里,奖励又以业务价值为主,曝光会集中到附近、历史转化高的商家。新入驻商家和偏远区域的商家在候选里出现得更少,要花更多广告费才能拿到相近的曝光。
回到 A 的那次搜索。九宫格先把外地商家挡在 beam 外面,第三个地理 token 把名额引向 A 家附近的小格。历史行为按位置和 query 重新加权后,上周六在家买牛腩的那条得到最大权重,GMPO 则让训练不再奖励重复的同一家店。这些步骤都发生在 ID 写完之前或训练阶段,线上 20 km 半径下,前 50 个候选里只有不到 5% 还要靠距离筛掉。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Generative · 2026-07-23TSGR: Taobao Search Generative Retrieval淘宝搜索的 TSGR 在 SID 第 3 层按点击给商品排座次,并按 query 准备多套排序,让卖得好又贴合 query 的商品更容易被生成,同一模型再接打分模块做重排。离线 HR@1000 从 0.7735 提到 0.8651,线上 GMV +1.64%;但重排抬高了前 1000 命中、压低了前 20 命中。
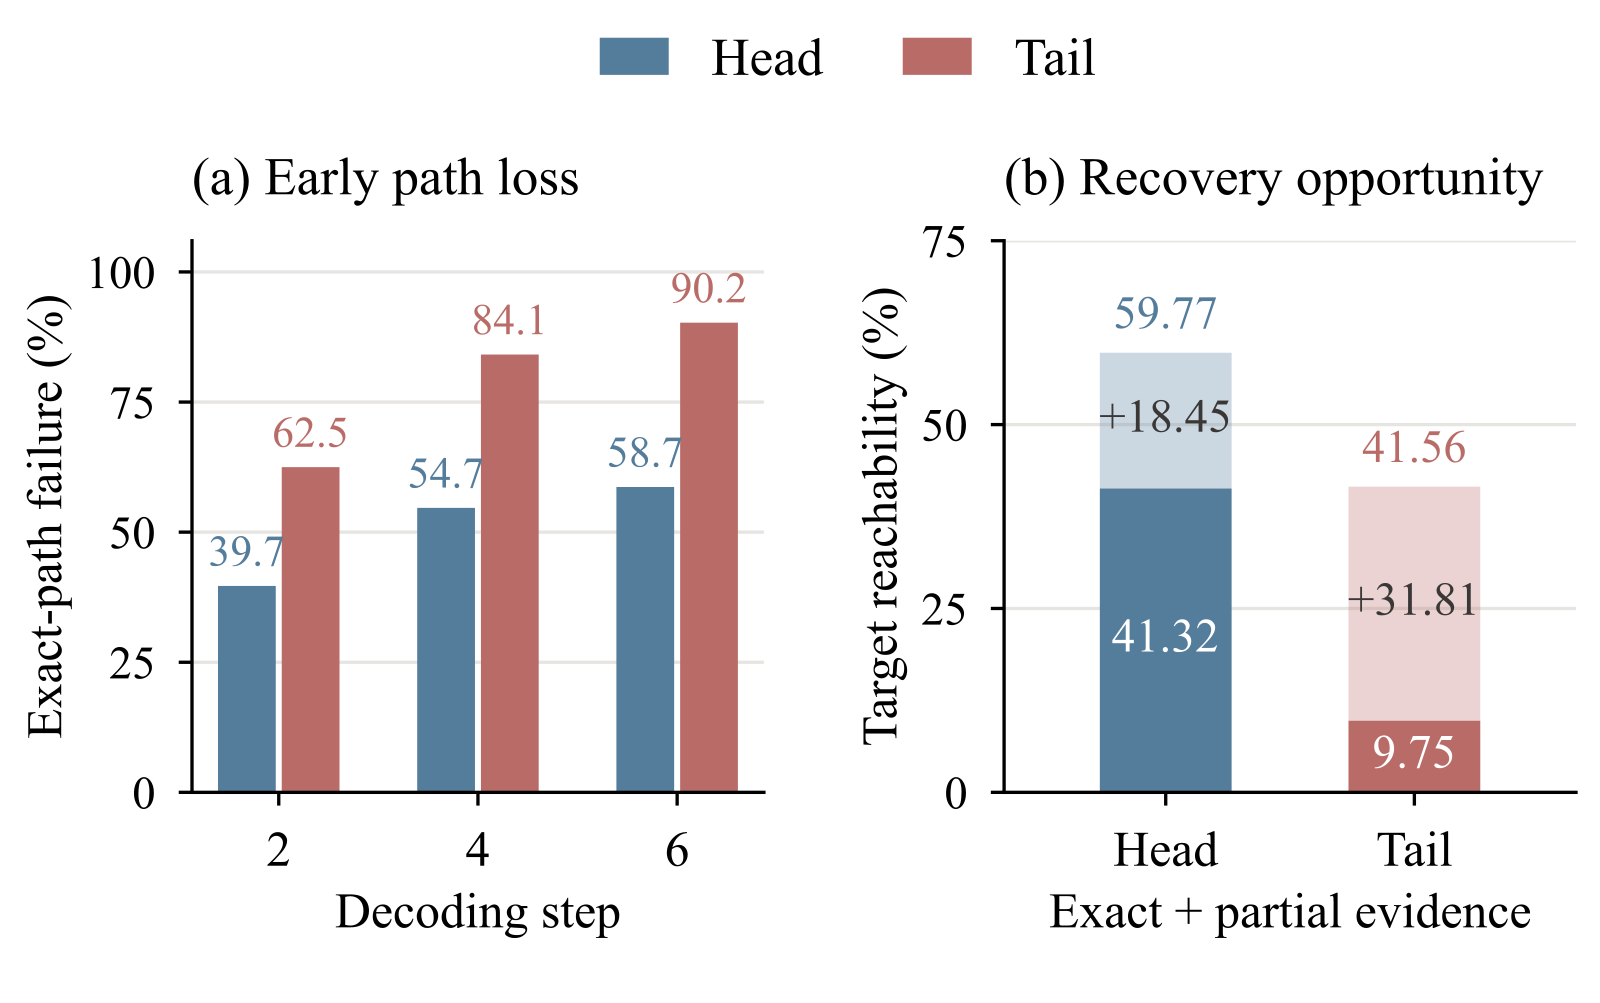 Generative · 2026-11-16ReSID: Rethinking Long-Tail Retrieval in Generative Recommendation through Item Reachability生成式推荐把商品编成一串 Semantic ID,再用 Beam Search 逐位生成,冷门的长尾商品很难被召回。作者把从编码到解码再到匹配的整条链路拆开查,发现长尾商品多半在解码早期就丢了:在 Amazon Industrial 上,才生成两位 token,62.5% 的长尾目标就已经掉出 beam。他们还发现,把向量切成几段各自量化的并行 SID,比逐层量化残差的串行 SID 更照顾长尾,因为某一位出错不会连累后面几位,生成得不完全对的序列里仍留着有用的位。ReSID 据此在 Beam Search 里压低热门偏置、加入用户语义打分,让长尾前缀活下来,最后允许部分位对不上也能匹配到商品。它已在线上服务主流量,广告收入提高 1.3%,长尾曝光占比提高 4.0%。长尾召回的瓶颈常常在解码时被剪掉,事后放宽匹配补不回来。
 Generative · 2026-11-05ReuseGR: Offline--Online Decoupled Generative Retrieval via Adaptive Prefix Reuse做生成式检索上线的团队值得读:它给出了一种拆法,大模型的算力按搜索词复用,个性化留给在线小模型,并且有线上 A/B 验证。同一个搜索词每天被很多人搜,每次都从头生成完整的 Semantic ID 是在重复计算。ReuseGR 把活拆成两半:离线用大模型给每个搜索词先生成一批 SID 前缀,同词的请求共用;在线用小模型按当前用户的历史挑前缀,再补全剩下的 token。在一个搜索广告数据集上,假设前缀已提前缓存好,它的召回和全程在线跑大模型持平,在线延迟却低 57.7%;线上 A/B 里,点击率比原来的小模型方案相对提高 0.93%。
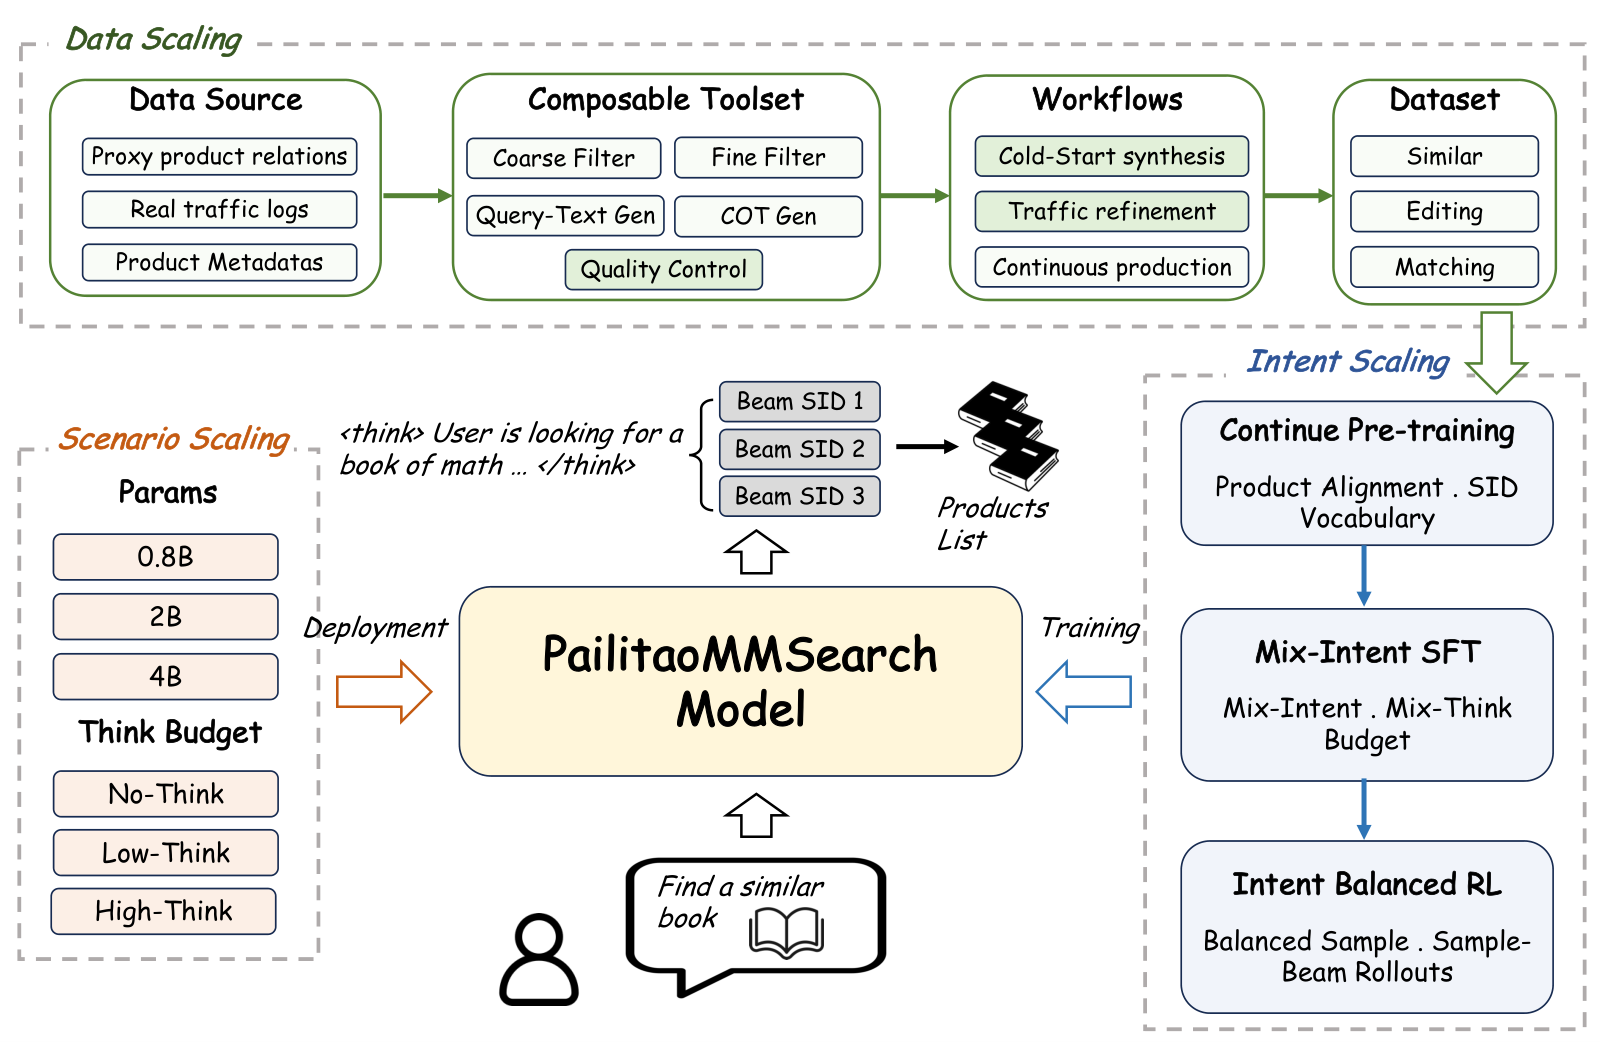 Generative · 2026-10-29PailitaoMMSearch2.0 Technical Report: Scaling Generative Retrieval to Unified End-to-End Multimodal Search淘宝拍立淘里,用户拍一件衬衫再说「找条配它的短裤」,要的是搭配而不是同款。传统做法先分意图、再分发到不同召回通道,任何一步分错后面全错。阿里这篇技术报告让一个 2B 视觉语言模型直接读原图和原话,生成商品的 Semantic ID,不需要意图标签。优秀率指前 10 个结果里被评审模型判满分的比例。「找搭配」请求的这一指标从多路召回链路的 44.2% 提到 74.3%,线上 GMV 提升 8.94%,已全量上线。
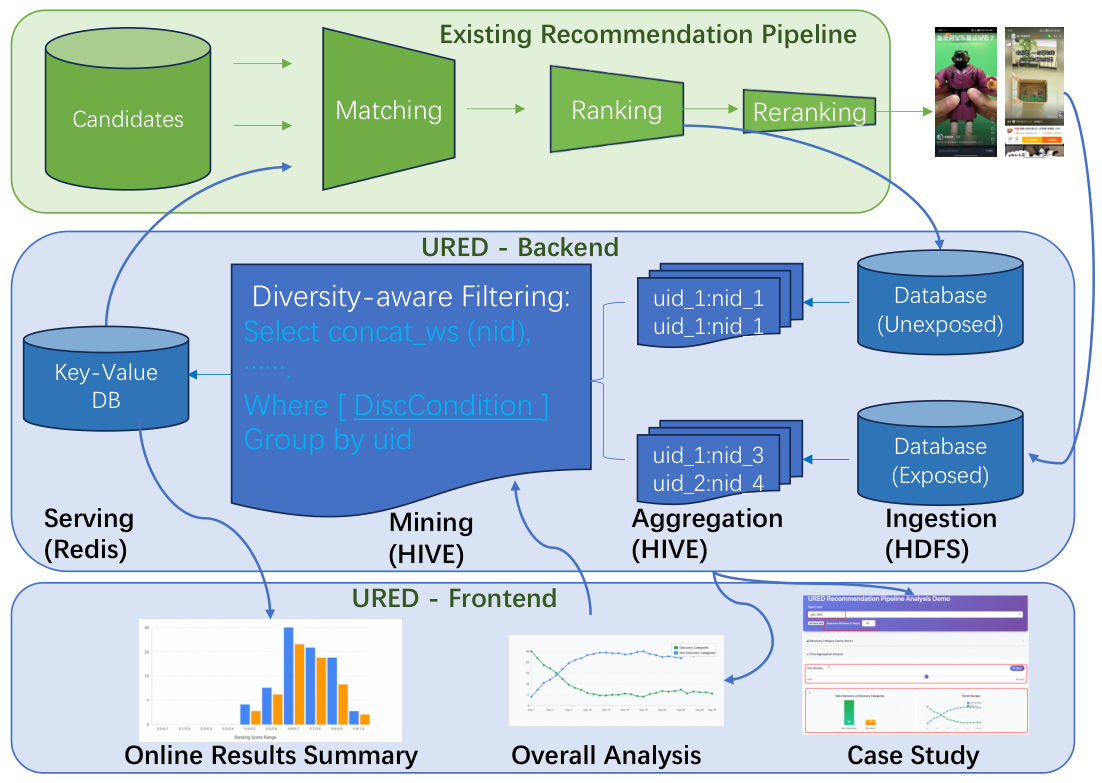 Personalization · 2026-11-06From Waste to Discovery: Recycling High-Scored Unexposed Candidates in Taobao Feed Recommendation推荐排序每天都算了大量最终没有展示的候选。这篇工作把其中的高分候选重新用于发现新类目:把这些候选按用户累计一个月,筛出近期没有展示过的类目,再接回召回。在淘宝信息流的在线实验里,按实际展示计数的发现类目数相对增加 3.47%,完整观看次数增加 2.62%;两项都达到统计显著。总观看次数没有显著变化。这里改的是候选的保存和使用方式,排序模型不用重训。
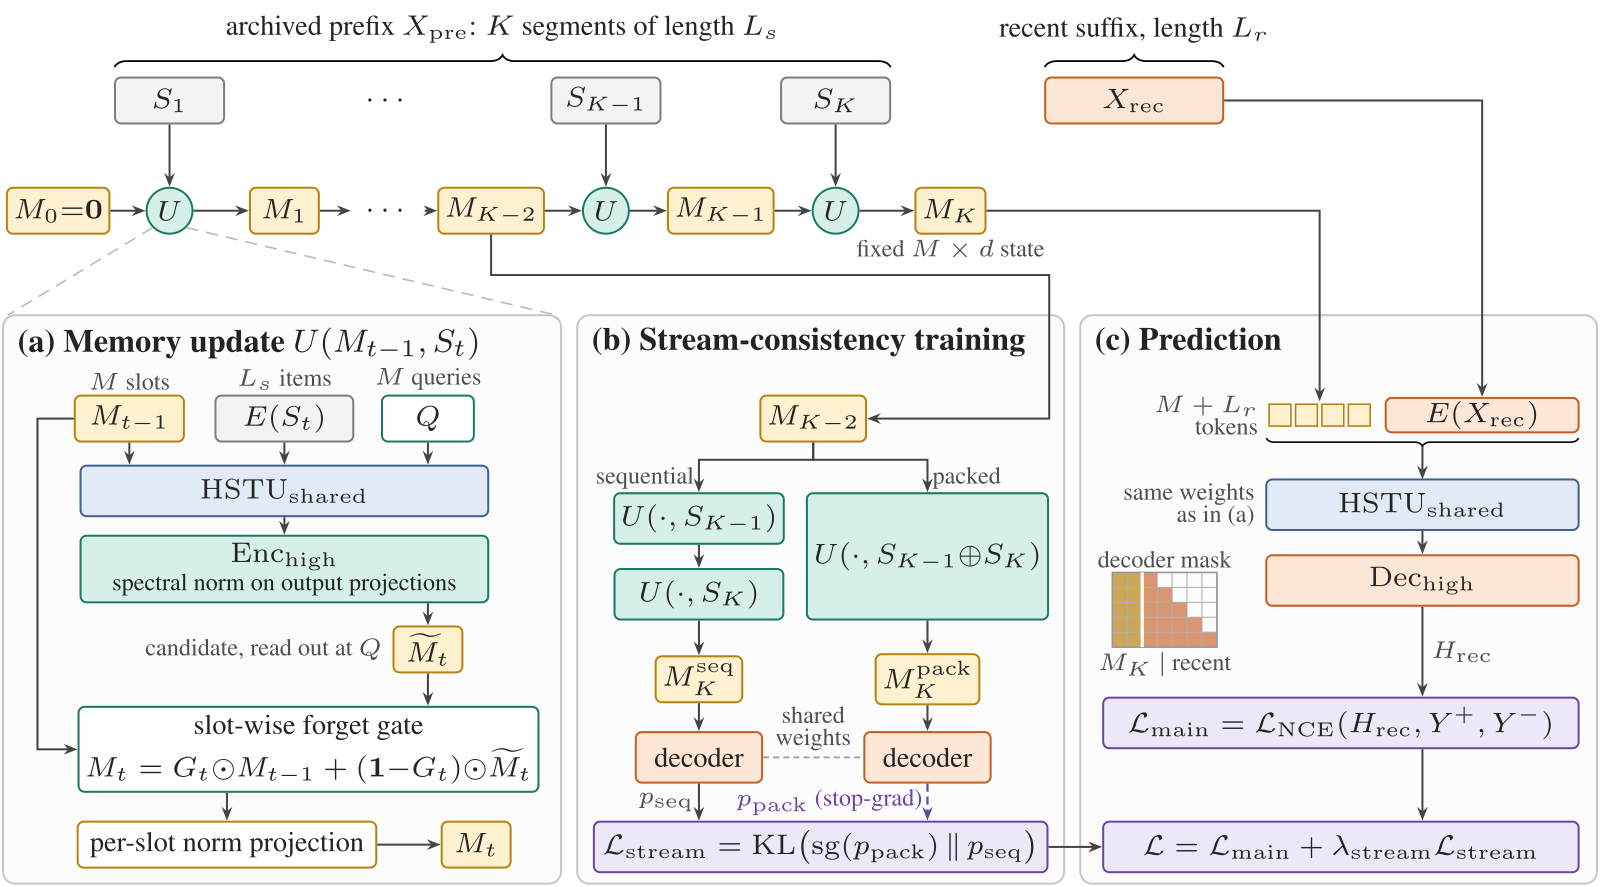 Generative · 2026-11-17RecMem: Recurrent Memory Compression for Long-Sequence Generative Recommendation生成式推荐一旦把用户很长的历史直接送进模型,计算量和显存就会跟着历史长度一起涨,很长的交互序列很快变得又慢又贵。作者把历史一段一段压进数量固定的记忆槽,解码时只用固定长度的上下文,不再随历史变长而膨胀。在来自电商平台的长序列基准上,解码上下文从 1200 个 token 减到 216 个,仍保住了直接处理同样长历史的对照模型 87.9% 的 Recall@10,更靠后的召回也几乎相当。同一个训练好的模型在很长的后续交互里,推荐质量没有塌掉。远期行为里的信号,不必整段塞进解码器也能留下来。对要上线长序列生成式推荐的人来说,这给出了一条用固定容量记忆换上下文的路,而不是把整段历史都留在注意力窗口里。
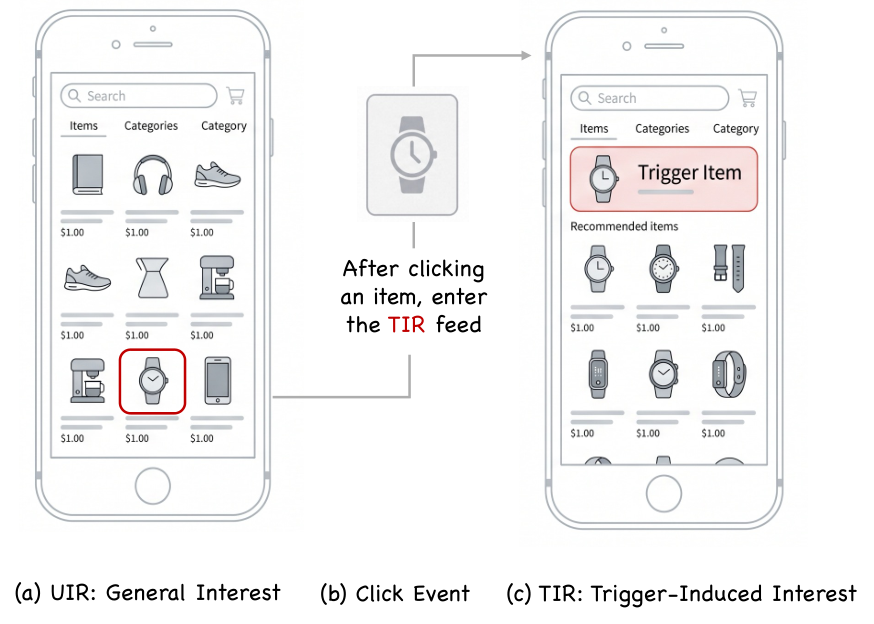 Generative · 2026-11-16TriGen: A Generative Paradigm for Trigger-Induced Recommendation用户在主信息流里点了一件商品,马上进入跟着它展开的推荐流,这在电商里很常见。这时推荐既要接住刚才这一下点击的意图,又不能把用户长期的口味全丢掉。生成式推荐默认顺着历史往下续写 SID,一次点击很容易被长历史冲淡,传统的判别式打分又没法指导逐个 token 的生成。阿里国际的 TriGen 把被点的商品复制几份接在历史末尾,让它主要改写最近的行为,再用门控按请求决定这次更听点击还是更听历史,并在解码每一位时都持续注入点击信号。在东南亚六个国家的线上实验里,收入提高 3.27%,GMV 提高 0.90%,现已全量上线。点击触发的推荐里,难点是这次点击该压过历史多少,而且每次都不一样。
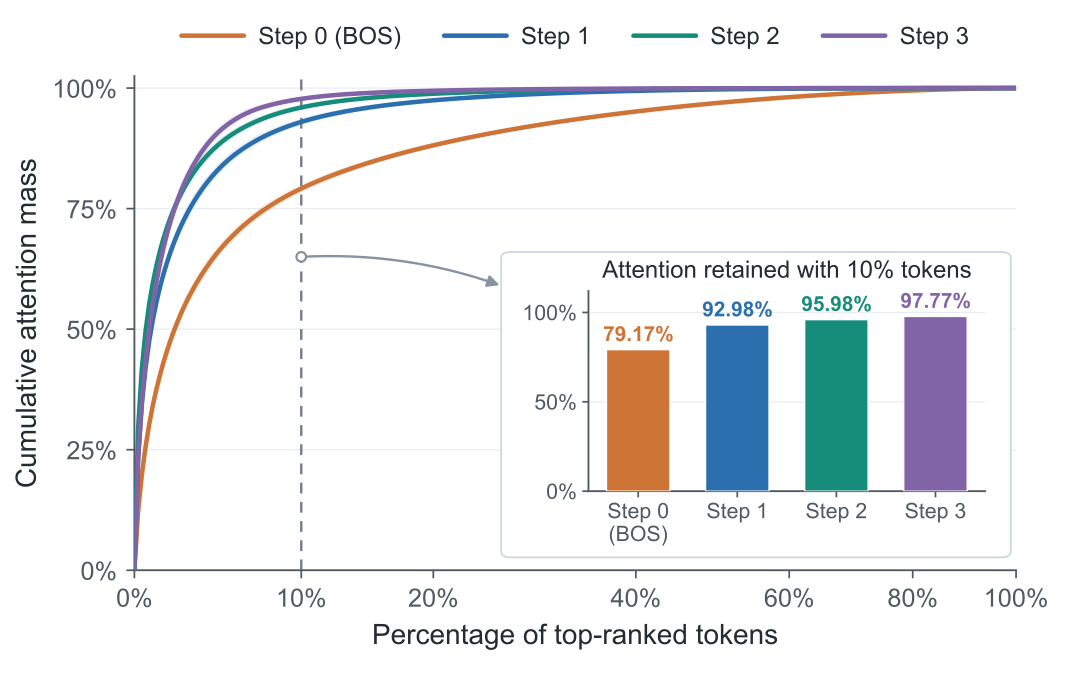 Generative · 2026-11-02PFA: Attention Can Be Progressively Focused in Long-Sequence Generative Recommendation阿里的作者发现,生成式推荐做 beam 解码时,越往后注意力越集中在少数几条历史行为上,而且哪些行为重要,前后几步基本不变。据此提出的 PFA 把挑选重要历史这件事,从每步、每条 beam 各挑一次,改成整个解码只挑一次。它在解码第一步照常看完整历史;到第二步,把各条 beam 对历史的注意力按生成概率加权汇总,排出一份共用的重要行为排名,后面每步保留的行为数按固定比例缩小。在电商广告平台的线上 A/B 中,用户历史从 128 条加长到 512 条,收入提升 3.76%。响应时间仍比直接读完整历史更短。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…