
先推理再编码更准,可两种向量各成一片:AntEmbed 怎么让快慢两种检索共用一份索引给多模态检索模型一张图,让它判断这张图该归到哪一类。最快的做法是直接读图、编成一条向量,去和库里的向量比。另一种做法慢一些:先让模型写一段推理,比如「这张图的分类意图是……答案:一件香水产品」,再把这段话和原图一起编码。
后一种在复杂、细粒度的检索上通常更准,但每次编码前都要先生成一段文字。实际系统里,最好是平时走快的那条路,遇到难的查询再走慢的。可同一张图按两种方式编出来的向量,有时会离得比较远。
这篇论文来自苏州大学和蚂蚁集团,要做一个两种模式都支持、而且两种向量落在同一个空间里的多模态 embedding 模型。不先生成中间内容的叫判别式 embedding,先推理再编码的叫生成式 embedding。已有方法 UME-R1 是一种双模式多模态向量模型:两种模式分别编码,各用一个 embedding token。这两种向量容易不在一块,检索时还要为两种模式各建一份索引。AntEmbed 只用一个 embedding token,让快慢两种查询共用一份索引。在 MMEB-v2(一个覆盖图像、视频、文档检索的多模态 embedding 评测基准)上,AntEmbed-8B 用推理查询拿到 81.5 的总分,是对比模型里最高的。
把同一候选的两种版本都当正例、逐个跟负例比,快慢两种查询就能共用一份索引;但 81.5 要靠查询时先生成推理,不推理的快速模式在同尺寸下仍低于 Qwen3-VL-Embedding。
两种向量各成一片
判别式 embedding 直接把图片、文字或文档截图送进模型,读一个专门用来产出向量的 embedding token 的隐状态。生成式 embedding 先写出推理和一句总结,接在原输入后面,再读 embedding token 的隐状态。
下面这张图比较了 UME-R1 和 AntEmbed 把同一个实例的两种向量放得有多开。
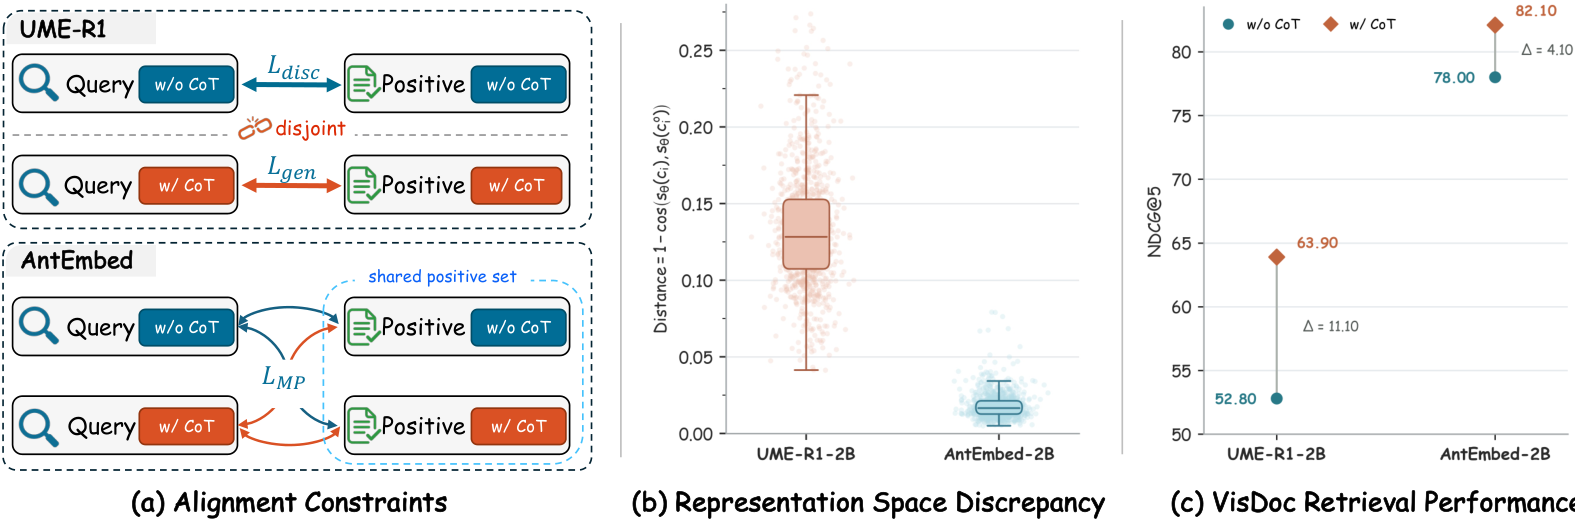
看图 (b):UME-R1-2B 的距离(1 减余弦相似度)中位数在 0.13 左右,AntEmbed-2B 只有 0.02 左右。距离大,说明两种向量之间有偏移,用一种模式的查询去搜另一种模式编码的库,可能会吃亏。
同一张图的 (c) 还有一组数:在文档检索任务上,UME-R1-2B 不推理时 NDCG@5 是 52.80,推理后是 63.90,差 11.10。这说明推理带来的信息确实有用,也说明不推理的那条路还有很大的提升空间。
推理内容怎么来
训练数据里的推理是外部模型写的。论文用 Qwen3-VL-30B-A3B-Instruct 当推理器,查询侧和候选侧分开写。
查询侧的推理只写检索意图和需要什么证据,不直接给答案。候选侧的推理多了一步:先用开源的多模态 embedding 模型 Qwen3-VL-Embedding-8B 在库里找出和这个候选最像的 5 个邻居,把候选和这 5 个邻居一起交给推理器,让它写出「这个候选和这些相似候选比,凭什么能认出来」。论文叫它 confusion-aware,意思是专门对着容易混淆的候选找区别。输出里不准提到邻居,只写目标候选自己身上的证据。
每段推理由两部分组成:一段推理过程,加一句简短总结,比如「答案:一件香水产品」。两部分都接在原始输入后面。
把两种版本都当正例
只用一个 token 还不够。如果照原来的目标训练,模型学的仍是两组互不相干的配对:原始查询配原始候选,推理查询配推理候选。两组配对共用一个向量空间,却没有任何一项要求原始查询也要靠近推理候选。
AntEmbed 的做法是:把一个候选的原始版本和推理版本都放进正例集合,原始查询和推理查询都拿这个集合去比。这样一个训练样本里有四对需要拉近的组合:原始查询配原始候选、原始查询配推理候选、推理查询配原始候选、推理查询配推理候选。
正例变成两个以后,损失怎么写有讲究。最省事的写法是把两个正例的分数加起来,只要求「正例这一组」整体胜过负例。论文没用这种写法,而是改成两两比较:每个正例都要单独跟每个负例比一次。下面算一下两种写法差在哪。
走一遍:一个查询、两个正例、一个负例
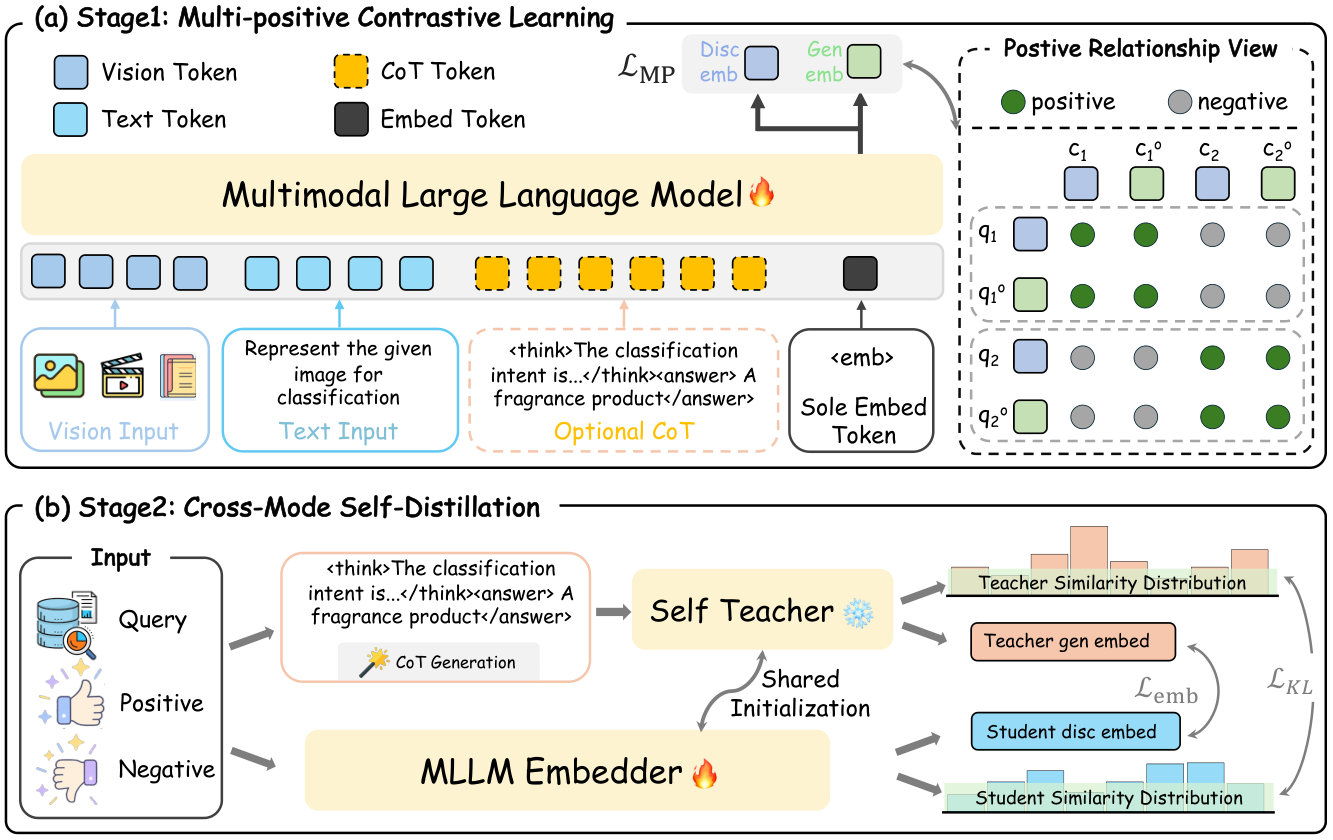
这张总览图的左上是编码流程:待分类的图,加上一句「把这张图编码,用于分类」,可选推理写到最后是「答案:一件香水产品」,再交给 embedding token。右侧小表另外画出了训练时的对应关系:每个查询的两种版本,都把同一候选的两种版本当正例。图里没有标出这个分类例子对应的正例或负例。
下面用另一个标为示意的计算例子,把两种损失写法走一遍。温度 0.02 是论文的设置,三个相似度是示意,不是这张分类图上的实测分数。假设现在有一个查询、同一候选的两个版本当正例、再加一个负例。查询先走不推理的那条路,只看原始输入。
第一步,看初始状态。原始查询和原始候选的相似度是 0.8,和推理候选的相似度只有 0.2,和一个负例的相似度是 0.5。也就是说,原始查询离自己候选的推理版本,比离负例还远。
第二步,按「正例分数相加」的写法算损失。每个分数先除以温度:正例是 0.8 ÷ 0.02 = 40 和 0.2 ÷ 0.02 = 10,负例是 0.5 ÷ 0.02 = 25。分子是 e^40 + e^10,几乎全由 e^40 决定;负例的 e^25 比 e^40 小了 e^15 倍。损失约等于 e^-15,接近 0。所以模型会觉得这个样本已经学好了,不会去管那个 0.2。
第三步,按论文的两两比较写法算。每个「负例减正例」的差也除以温度:对原始候选是 (0.5 − 0.8) ÷ 0.02 = −15,对推理候选是 (0.5 − 0.2) ÷ 0.02 = 15。损失是 log(1 + e^-15 + e^15),约等于 15。这意味着同一个样本,换一种写法,就从「已学好」变成了损失很大的样本。
第四步,看梯度推向哪里。这个 15 几乎全部来自推理候选那一项,所以梯度主要去做两件事:把原始查询和推理候选的相似度往上推,把它和负例的相似度往下压。原始候选那一项已经赢了 0.3,基本不出力。
第五步,同样的账对推理查询再算一遍。推理查询也要分别胜过负例,靠近两个正例。四对组合都被逐个管住,同一个实例的两种向量就被拉到一处。前面对比图的 (b) 里,AntEmbed-2B 两种向量的距离只有 0.02 左右,就是这个结果。
这一步的效果,论文在表 3 里拿 2B 模型的图像任务比过:
| 训练方式 | 不推理查询 | 推理查询 |
|---|---|---|
| 只用原始数据 | 68.7 | — |
| 只用推理数据 | — | 73.6 |
| 两种数据混在一起训练 | 68.8 | 67.0 |
| 两种各训一个 LoRA 再合并 | 69.0 | 73.8 |
| 两个正例逐个比较 | 73.3 | 79.5 |
(数字来自论文表 3,MMEB-v2 图像任务平均分。)
这说明简单地把两种数据混在一起,或者把两个模型的参数合并,都只做到和单独训练差不多;混在一起训练时,推理查询还掉到了 67.0。在这几种做法里,让两种版本互为正例的那种,两种模式都比单独训练高出 4 到 6 分。
第二阶段:把推理分支的判断教给快速分支
第一阶段之后,两种向量已经在一个空间里,但推理查询仍然更准。总览图下半部分的第二阶段,想让不推理的查询也学到一部分推理带来的信息。
做法是自蒸馏。老师和学生都从第一阶段的模型初始化:老师读推理查询,学生读原始查询,只更新学生。蒸馏分两层。第一层看候选排序:老师对一批推理候选算出一个相似度分布,学生也对同一批候选算一个,用 KL 散度让学生的分布向老师靠,权重 1.0。第二层看向量本身:直接让学生的查询向量靠近老师的推理查询向量,权重 0.5。
只靠第一层,学生学到的是「几个候选谁比谁更像」,向量本身可以离老师很远;第二层补上这一点。论文表 4 里(都是不推理查询的总分),第一阶段的总分是 69.1,只加第一层是 69.4,只加第二层是 69.5,两层按 1.0 和 0.5 加权一起用是 70.2。这说明两层互补,但第二阶段只用图像和文档的一个子集训练,提升约 1.1 分。
实验结果
主实验在 MMEB-v2 上,包括图像、视频和文档三类共 78 个数据集。所有候选只建一份库,用推理版本编码;查询分两种模式:不推理(base)和先推理(CoT)。
| 模型 | 图像 | 视频 | 文档 | 总分 |
|---|---|---|---|---|
| Qwen3-VL-Embedding-8B | 80.1 | 67.1 | 82.4 | 77.8 |
| DME-9B | 79.8 | 70.8 | 82.0 | 78.4 |
| AntEmbed-8B,不推理 | 76.4 | 57.6 | 79.9 | 73.1 |
| AntEmbed-8B,先推理 | 83.9 | 74.8 | 82.7 | 81.5 |
(数字来自论文表 1,基线分数取自官方排行榜。)
这说明推理模式确实领先:总分比 DME-9B 高 3.1,比 Qwen3-VL-Embedding-8B 高 3.7,三个大类都是最高。提升最大的是视频,2B 模型从不推理到推理涨了 12.8 分。不推理的快速模式在 8B 上是 73.1,比同尺寸的 Qwen3-VL-Embedding 低 4.7 分;在 2B 上是 70.2,在判别式模型里仅次于 Qwen3-VL-Embedding-2B 的 73.2,但已经超过 TTEt-2B(68.6)、Embed-RL-4B(68.1)这样需要推理的模型。
推理器的强弱直接影响结果。评测时换不同的推理器写查询推理,2B 模型图像任务的平均分从不推理的 73.3,到微调过的 Qwen3-VL-8B 的 78.1,再到 Qwen3-VL-30B-A3B 的 79.3 和 Gemini-3.1-Pro 的 80.2。即便用较小的推理器,也能拿到大部分提升。
在更广的 MMEB-v3 上,AntEmbed-8B 的总分是 55.6,也是对比模型里最高的,其中文本和 agent 两大类排第一。AntEmbed 不支持音频,11 个音频任务按 0 分计入总分。
这对做检索的人意味着什么
如果你想给同一个检索系统准备快慢两档,可以只建一份候选库,让两种查询都去搜它。
关键在训练目标:把同一候选的不同版本都当正例,并且逐个跟负例比,不要只看正例整体的概率。前面那个 0.2 的例子说明,正例分数相加的写法会让模型放过离得远的那个版本。
实际部署时,可以默认走不推理的快速查询,只把难的查询交给推理模式。用小一点的推理器也能拿到大部分收益,这一点从 Qwen3-VL-8B 微调版的 78.1 就能看出来。
局限
推理模式的每次查询都要先等推理器写完一段话。论文的表格只比检索效果,耗时和成本不在对比之中。候选库用推理版本编码,库里每个候选都要先跑一遍推理器,这是一笔额外的离线开销。
不推理的快速模式在同尺寸下仍低于 Qwen3-VL-Embedding。第二阶段的蒸馏只带来约 1.1 分,而且只在图像和文档的子集上训练。
MMEB-v3 的总分里,音频任务按 0 分计,其余新任务的基线分数直接取自 MMEB-v3 原论文,不是同一套环境复测的。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
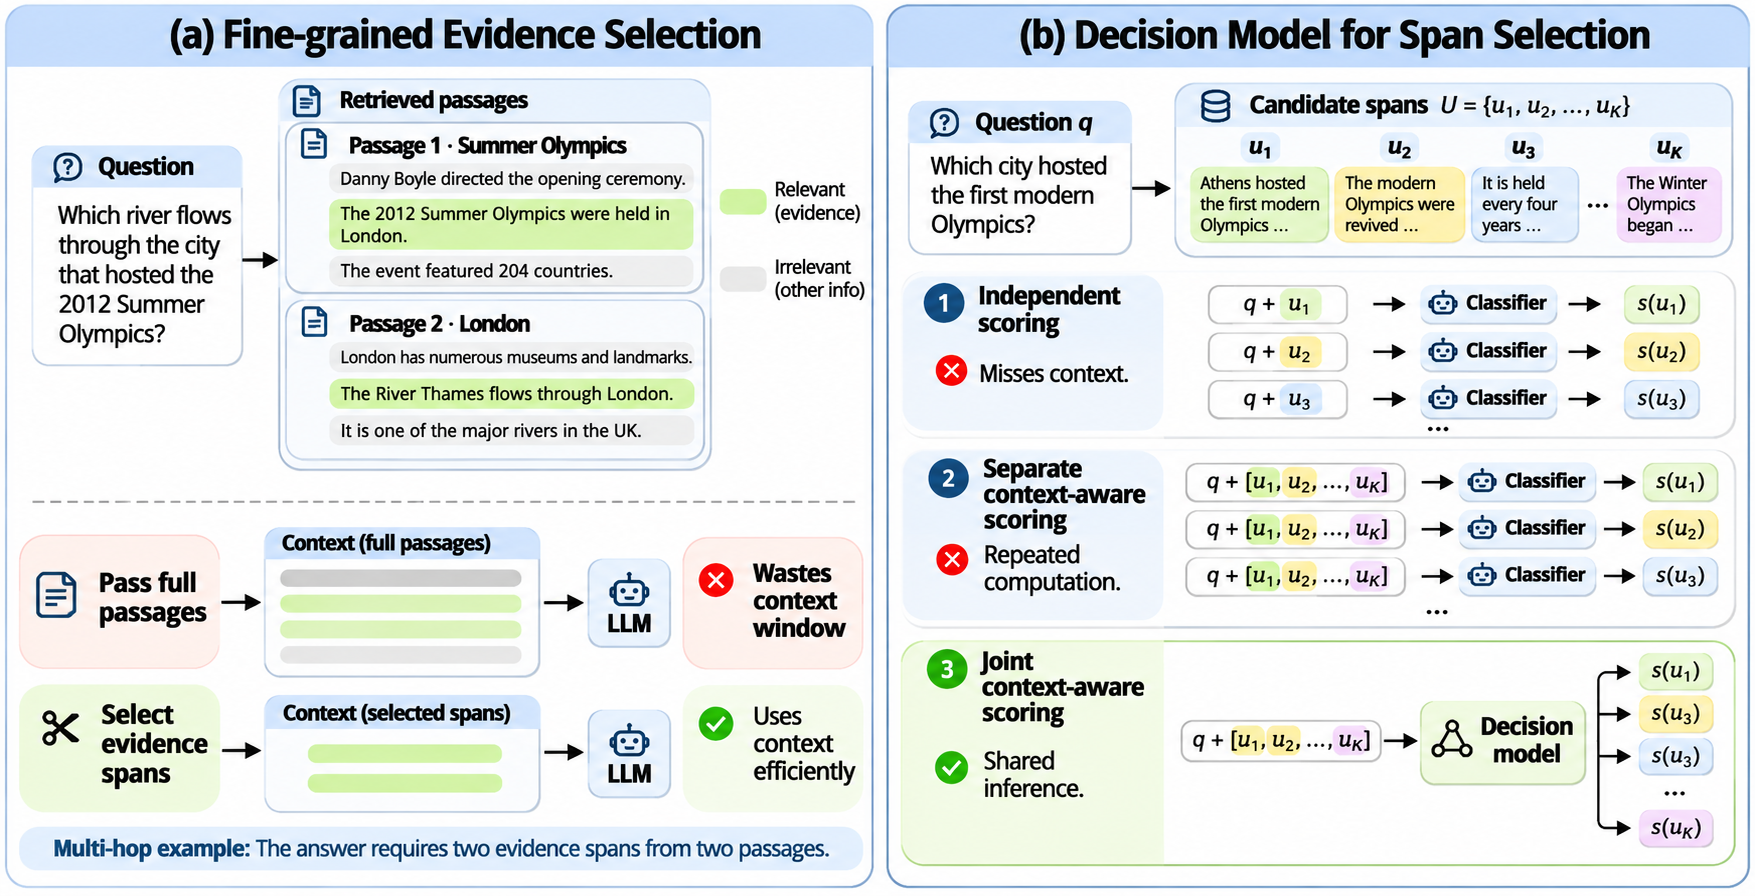 Retrieval · 2026-11-16CURATOR: Scalable Fine-grained Evidence Selection for Retrieval-Augmented Generation using Decision ModelsRAG 通常把检索到的整段文字都塞给大模型,可真正能回答问题的往往只有其中几句。挑出这几句并不容易:一句话单看像是无关,要结合其他检索内容才知道该不该留。逐句带着全部上下文判断又太贵。决策模型能在一次推理里同时给很多候选句打分,每个判断都看得到周围的句子,但作者发现,同时要做的判断越多,它分辨有用证据的能力越差,而一次检索常常就带来几百个候选句。CURATOR 专门训练决策模型从大候选池里挑出数量不定的支撑句,保住一次打分的效率。在 128 个 token 的上下文预算下,它在没见过的数据集和领域上平均把证据召回提高 17.0%,下游回答质量提高 17.4%。上下文越紧,挑对证据比塞进更多段落更要紧。
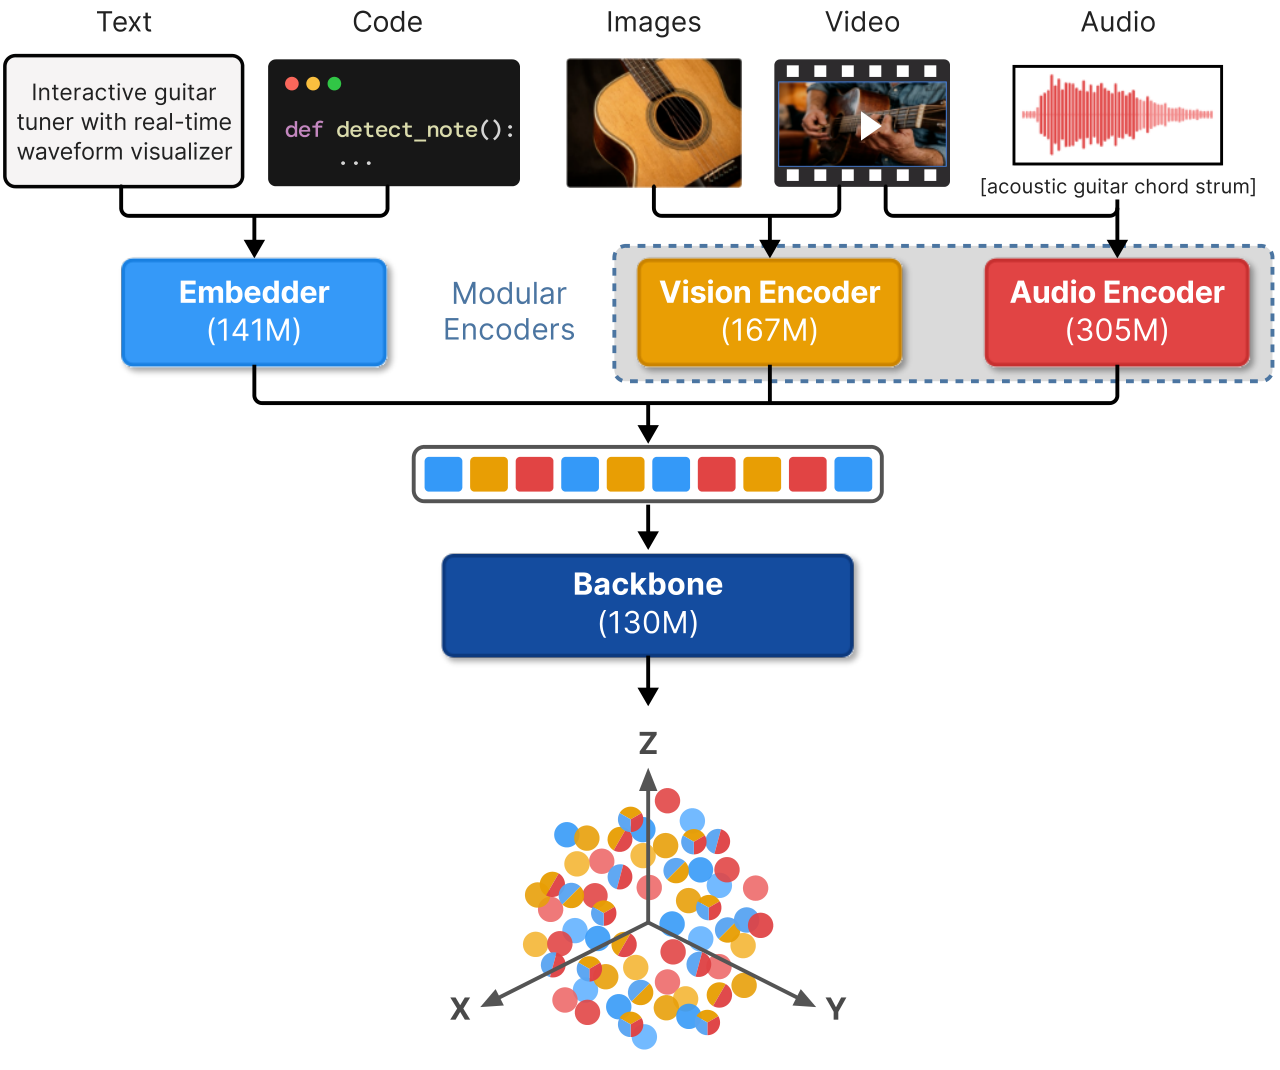 Retrieval · 2026-10-29EmbeddingGemma 2: Unified and Efficient Multimodal Representations想让一个 embedding 模型同时搜文字、图片、视频和音频,常见做法是先把音频转成文字、给图片配说明,再交给文本模型,既多花算力,又丢掉了语气和画面细节。Google 的 EmbeddingGemma 2 用一个 744M 参数的模型,把这几种输入直接映射到同一个向量空间,各模态编码器还能按需加载。用语音提问去找文本段落最能说明差别:同一个模型先把语音转写成文字再检索,MRR@10 是 57.59,直接读音频能到 69.54。小模型做多模态,不一定要牺牲文本和代码,它的代码检索分数反而比上一代高出近十分。
 Retrieval · 2026-11-02Retrieving from Your Own Mistakes: On-Policy Training of Embedding Models for Multi-Hop Retrieval-Augmented Generation多跳检索里的链式 embedding 检索器,训练和上线时看到的历史不一致,这篇论文给出一个不加大模型调用的修法。这类检索器每一步把问题和已找到的段落拼在一起再找下一段,训练时历史全是正确段落,上线后却常混进它自己找错的段落。在四跳的 MuSiQue 问题上,到第三步已有 70% 的检索状态带了错段。作者每轮训练都让当前模型自己跑一遍,拿它真实走到的状态来训练,目标设为还没找到的最早那段正确段落。同样配方下,前五段里把证据找全的问题比例从 44.6% 提到 50.5%。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…