目录 · 9 节
1它到底在解决什么问题?2整体流程:只换训练用的状态3走错了之后,正例该是哪段?4为什么每个 epoch 都要重新跑一遍?5效果怎么样?6到底是哪部分起作用?7我认为它的局限8一个搜索团队可以怎么试9结论
做多跳检索和 RAG 的团队值得读这篇,因为它指出的毛病几乎所有链式检索器都有,修法却不用加任何大模型调用。多跳检索里的链式 embedding 检索器,训练时看到的检索历史全是正确段落,上线后看到的却是它自己找回来、常常带错的段落。它每一步把问题和已找到的段落拼在一起再找下一段,早先找错一段,后面每一步都带着这个错。在四跳的 MuSiQue 问题上,到第三步时已有 70% 的检索状态混进了错段。核心思想一句话:每轮训练都让当前模型自己跑一遍,把它真实走到的状态,包括走错的,拿来训练,目标设为还没找到的最早那段正确段落。同样的模型和训练配方下,前五段里把证据找全的问题比例从 44.6% 提到 50.5%;历史里已有两段错段时,下一步找回正确段落的比例从 14.5% 提到 29.2%,翻了一倍。检索器也有训练和推理时历史不一致的问题,用它自己犯过的错来训练就能补上一部分。
它到底在解决什么问题?
先说链式检索器怎么工作。一个复杂问题需要好几段证据,检索器分几步取:第一步只用问题去搜,取回一段;第二步把问题和这段拼成一段文本,重新编码成 query 向量再搜;以此类推,每步多带上一段。走完固定步数(MuSiQue 上是 4 步)后,最终排序先放这几步取回的段落,其余段落按它们在各步里拿到的最高分接在后面,所以也能看前五段、前十段。下面把问题加上已取回段落的这段文本叫作“检索状态”,后文的“历史”指其中已取回的段落。
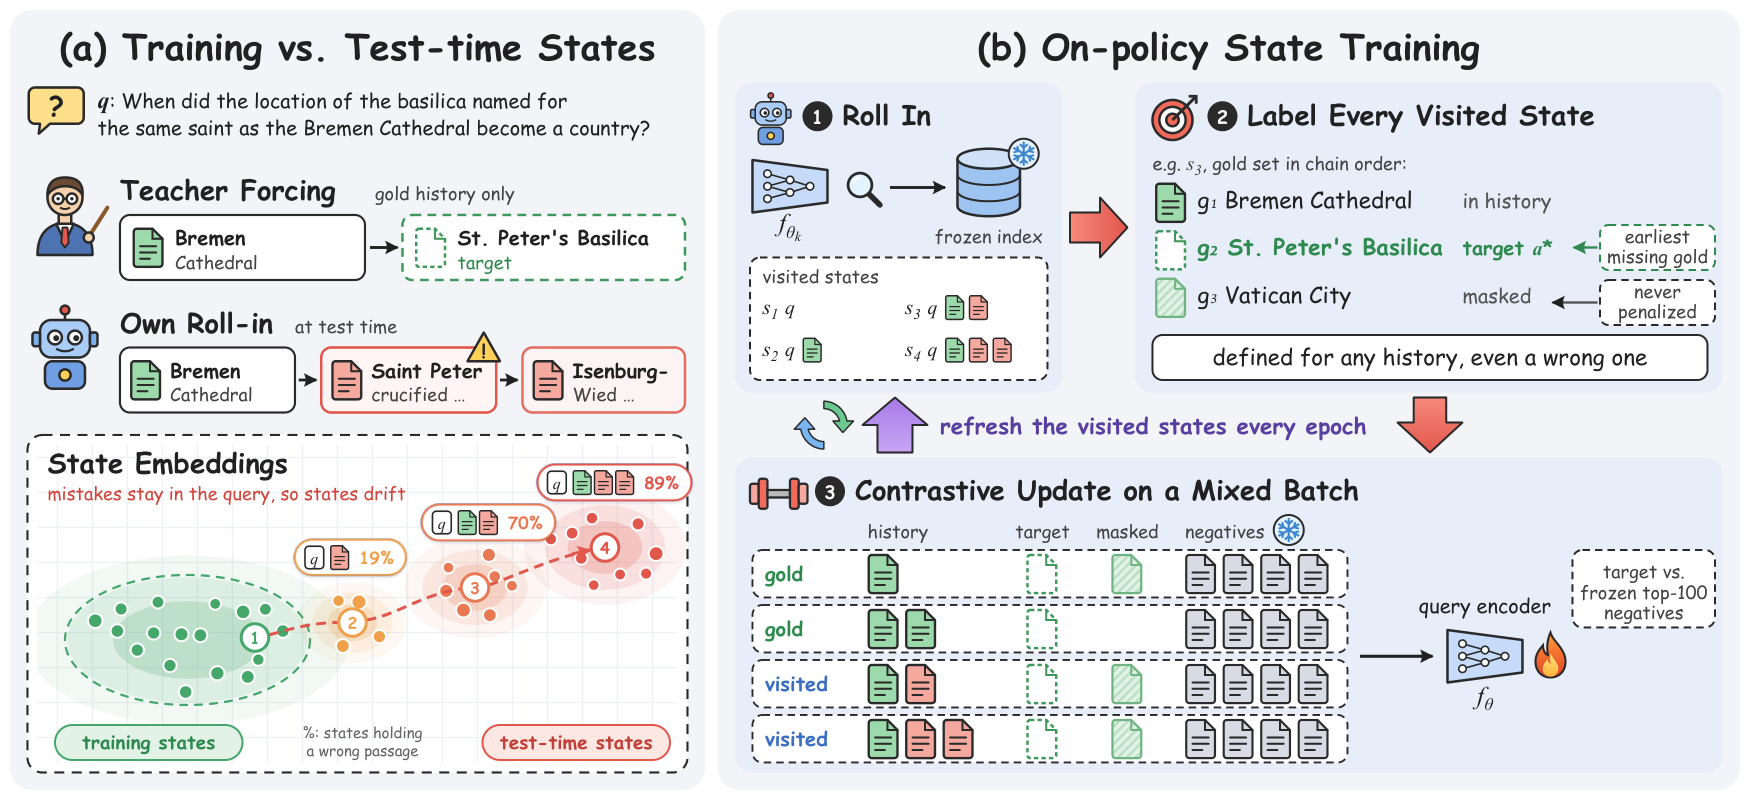
论文开头的例子是这样一个问题:「和不来梅大教堂供奉同一位圣徒的那座大教堂,所在地是哪年成为国家的?」正确的链是 不来梅大教堂 → 圣彼得大教堂 → 梵蒂冈。训练时和上线时,检索器看到的历史差别如下(链条来自论文图 1,示意):
| 步 | 训练时的历史 | 上线时的历史 | 上线时取回 |
|---|---|---|---|
| 1 | 空 | 空 | 不来梅大教堂(对) |
| 2 | 不来梅大教堂 | 不来梅大教堂 | 圣彼得本人的生平(错) |
| 3 | 不来梅大教堂、圣彼得大教堂 | 不来梅大教堂、圣彼得生平 | 一段讲伊森堡的段落(错) |
训练时,历史永远是标准答案里的段落,模型只学过“前面都对,接下来找哪段”。上线后,第二步取错的那段“圣彼得生平”会一直留在后面每一步的 query 文本里,模型面对的是训练里从没见过的输入。
这种情况并不少见。作者拿一个按常规方法训练的链式检索器在 MuSiQue 测试集上跑,只统计还缺正确段落的状态:四跳问题第二步有 19% 的状态历史里带错段,到第四步已是 89%,说明错段会越积越多。历史干净时,检索器下一步找回一段缺失正确段落的比例是 67%;带错段时只有 28%,意味着一旦走错,后面多半接不回来。
这个差距一部分是因为带错段的问题本来就更难。作者做了一个反事实检验:把这些状态里的错段删掉,其余不变,再让同一个模型选下一段。成功率从 20.8% 升到 32.1%,也就是说,光是历史里那几段错段本身就让它少了 11.3 个点。论文把这种训练和上线时历史不一致的情况叫作状态错位,也就是序列生成里常说的 exposure bias。
整体流程:只换训练用的状态
方法叫 on-policy state training。作者有意只改一个变量:训练时喂给 query 编码器的是哪些检索状态。模型结构、损失、负样本规则和段落索引都和常规训练一样,所以效果的差别只能来自状态。
每个 epoch 分三步:
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 跑一遍 | 当前编码器在 1,800 个训练问题上贪心检索 4 步 | 它真实走到的所有状态,包括带错段的 |
| 标目标 | 每个状态的目标是还没取到的金标段落里最早的那段 | 每个状态一个正例 |
| 混合训练 | 走到的状态和金标历史状态各一半,做对比学习 | 更新后的编码器,下个 epoch 用它重新跑 |
这里的金标段落指数据集标注好的那几段证据,按推理链顺序排好。关键的分工是:目标只由金标集合决定,所以任何历史,哪怕带错段,都能拿到一个明确的正例。下面拆开讲。
走错了之后,正例该是哪段?
常规训练没有这个问题,因为历史全是对的,正例就是链上的下一段。历史里一旦有错段,就得重新规定“下一步该找什么”。
论文的规则很简单:把这个状态还没取到的金标段落列出来,取链序最早的那一段当正例。还拿上面的例子:第三步历史是 不来梅大教堂 和 圣彼得生平,还缺的金标是 圣彼得大教堂 和 梵蒂冈,正例就是 圣彼得大教堂。错段 圣彼得生平 留在历史里不动,模型要学的就是“带着这段错的,也要绕回正路”。
为什么还要把其他没取到的金标段落从负样本里拿掉?因为直接跳到 梵蒂冈 也是进展,不该被罚。对比学习的分母里如果留着 梵蒂冈,模型取到它反而会被当成错误。这条在比较类问题上更重要:几个被比较的实体本来就没有固定先后,链序只决定哪一段这次拿梯度。
用公式写,状态 的损失是
其中 是 query 向量和段落 的 embedding 内积, 是上面规定的正例, 是温度,分母里是正例加上负样本,但不含其他还缺的金标段落。直觉上就是标准的 InfoNCE,只是正例换成了“还缺的最早一段”。
这个正例不需要大模型判断,也不需要奖励模型,标注成本是零。这是它和 Search-R1、Q-RAG 这类用整轮结果当奖励的强化学习方法最大的区别:后者每个问题只在最后拿到一个稀疏的分数,这里每一步都有正例。
为什么每个 epoch 都要重新跑一遍?
只用一次采到的错误状态行不行?作者专门比较了几种做法,后面实验会看到答案是不够。原因是模型一边学,它会犯的错也在变:第一轮会犯的错,学了两轮以后可能不再犯,而新的错又冒出来。只采一次,训练数据就停留在旧模型的错误上。
具体做法:每个 epoch 开始前,用当前编码器在训练问题上跑 4 步,记下每个还缺金标的状态,去重后均匀抽约 2,350 个,替换掉上一轮那一半;另一半约 2,350 个金标历史状态固定不变。第一轮还没有自己的模型,就借一个常规训练好的编码器来跑,它只提供状态,不用来初始化参数。
为什么不全换成自己走到的状态?金标那一半保住了模型很少走到的情况,比如难题上一长串都对的历史。附录里只用走到的状态,能拿到最佳混合约 80% 的收益,各一半的混合比只用走到的状态高 1.2 个点。
其余设置刻意固定:段落 embedding 用冻结的 Qwen3-Embedding-0.6B 算一次,只用 LoRA 改 query 侧;负样本从冻结编码器的 top 100 里挑,两种训练方式规则一样。作者这么做是为了排除另一种解释:要是负样本也跟着当前模型变难,提升就可能来自负样本,而不是状态。
效果怎么样?
先看和其他系统的比较。下表是 MuSiQue 上五个随机种子的平均(C@5 指前五段里把一个问题的金标段落全部找齐的问题比例):
| 方法 | 检索时调用大模型 | R@5 | C@5 |
|---|---|---|---|
| 冻结编码器只用问题搜 | 否 | 55.1 | 18.9 |
| HippoRAG 2(大模型建图) | 是 | 58.2 | 23.1 |
| MDR(常规训练的链式检索器) | 否 | 58.3 | 31.9 |
| Q-RAG | 否 | 61.7 | 36.2 |
| Search-R1(7B 模型边想边搜) | 是 | 66.7 | 36.5 |
| on-policy state training | 否 | 73.5 | 49.3 |
这说明一个只有 0.6B、检索时不调用任何大模型的链式检索器,在找齐证据这件事上已经超过了大模型建图和 7B 搜索 agent。其中大部分提升来自“训练一个链式检索器”本身:同一编码器、同一配方的常规训练已经到 44.6,超过 Search-R1 的 36.5。换训练状态这一步,在同一种子下再从 44.6 提到 50.5。
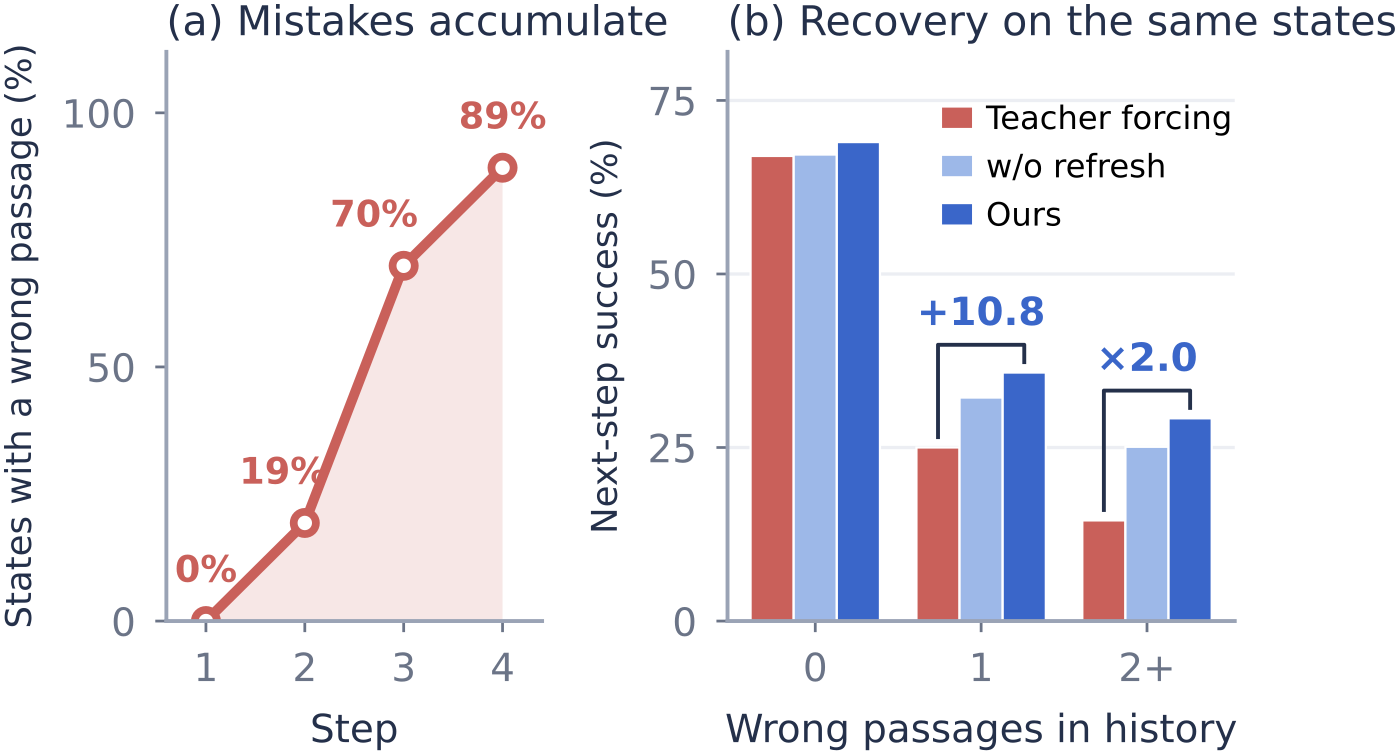
最有说服力的是图 3 右边这组实验,它要证明提升真的来自“会从错里爬出来”。作者固定 3,403 个常规模型走到的状态,让常规训练的编码器和新方法的编码器各自选下一段。历史干净时,两者的成功率是 67.0% 和 69.0%,几乎一样。历史里有一段错段时,常规模型是 25.0%,新方法是 35.8%。有两段以上错段时,常规模型只剩 14.5%,新方法是 29.2%。这说明新方法没有让模型普遍变强,强的地方正好是状态错位预言的地方。
删错段的检验也对得上:同样 1,358 个带错段的状态,常规模型被错段拖掉 11.3 个点,新模型只被拖掉 2.2 个点。新模型在带错段的原状态上(33.1%)甚至略好于常规模型在错段被删干净后的状态上(32.1%)。
下游问答也跟着变。把每个检索器的前五段交给同一个阅读模型,新方法的 EM 是 44.1,常规训练 38.6,Search-R1 取回的段落是 35.5。这说明找齐证据的提升确实传到了答案上。
到底是哪部分起作用?
一个更省事的解释是:随便往历史里塞点错段就行,就像训练大模型抗干扰时加干扰段落那样。表 4 把几种做法拆开,每行都保留一半金标状态,只换另一半:
| 另一半训练状态 | 每轮换新 | C@5 |
|---|---|---|
| 金标历史(常规训练) | — | 44.6 |
| 随机插入错段的合成状态 | 否 | 47.9 |
| 随机插入错段的合成状态 | 是 | 47.1 |
| 第一轮跑出的状态,只采一次 | 否 | 48.4 |
| 第一轮跑出的状态,每轮重新抽样 | 是 | 47.0 |
| 每轮用当前模型重新跑 | 是 | 50.5 |
合成错段把 C@5 从 44.6 提到 47.9,约占全部提升的一半,说明见过带错段的历史本身就有用。只采一次的真实状态(48.4)比合成的好不了多少,说明“真实错误”本身并没有多特别。每轮换新的样本也不够:合成状态每轮重抽是 47.1,同一次跑出的状态每轮重抽是 47.0。只有用当前模型重新跑才到 50.5。剩下那一半收益来自跟着模型现在会犯的错训练,不是来自样本更多。
还有一个可能的混淆:走到的状态文本不同,挖出来的负样本也不同。作者让同一问题的所有状态共用一组负样本再训一遍,提升从 5.9 个点降到 3.8 个点,大部分仍在,说明主要来自历史,负样本只占一小部分。
在更长的链上,这个差距更明显。论文自建了 HotpotQA-Long 和 2Wiki-Long,链长 3 到 5 跳,语料是 22 万到 55 万段,模型只在 MuSiQue 上训练、不再调。去掉“每轮重新跑”这一步,HotpotQA-Long 上的 C@10 从 28.0 掉到 22.7,几乎回到常规训练的 22.3。这说明模型被用在离训练分布越远的地方,越需要跟着自己当前的错误来训练。
我认为它的局限
第一,最难的问题依然没解决。四跳 MuSiQue 问题上,所有检索器前五段找齐的比例都不到 7%,新方法也一样;2Wiki-Long 的四跳和五跳链,任何检索器找齐的都不超过十分之一。四步都要走对,每步多几个点的恢复能力乘起来仍然不够。
第二,检索时延明显变长。只用问题搜一次,每个问题要 0.017 秒;链式检索走 4 步要 0.104 秒。和 7B 搜索 agent 比这很便宜,但对一个本来只做一次向量检索的第一阶段召回来说,这是实打实的成本,因为每多一步就要多编码一次 query、多搜一次索引。
训练也更贵:常规训练 37 分钟,新方法 60 分钟,多出来的主要是每轮重新跑一遍的时间。
第三,在更长的链上它不是每项都赢。2Wiki-Long 上 Search-R1 的 C@10 是 37.0,高于它的 32.8,三跳链也是 Search-R1 领先。另外五个种子的平均只出现在总表里,消融和分析都是单个种子,1 到 2 个点的差别要谨慎看待。
一个搜索团队可以怎么试
第一步,先量自己的状态错位有多大。拿现有的多步检索或 query 改写链路,在一批有标注证据的问题上跑一遍,统计第二、三步有多少状态的历史里已经带了错的结果,以及这些状态下一步的成功率。错段比例很低,就不必往下做。
第二步,做最便宜的版本:往金标历史里随机插入错段做训练。论文里这一步就拿到约一半的收益,不需要改训练循环。
第三步,再加每轮用当前模型重跑一遍。论文里训练时间从 37 分钟涨到 60 分钟,不用大模型、不用奖励模型,目标完全由标注证据决定。看的指标是“找齐全部证据”的比例,而不只是平均召回,因为收益主要集中在找齐上。
第四步,和 beam search 比一下。论文里常规模型开 4 个 beam、编码 13 次 query 也只到 46.3,不如新方法贪心 4 次的 50.5,可以借这个对比判断改训练是否比加推理开销更划算。
结论
最值得带走的一点:链式检索器的训练数据不只是正负样本怎么挑,训练时它看到的历史是谁产生的,同样决定了效果。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。凡是把上一步结果拼进下一步 query 的检索链路都有这个错位,第三步就有七成状态带错段。 |
| 方法创新性 | 中。让模型按自己的选择往下走、再告诉它每一步该怎么做,是模仿学习里的老办法,这里把它用在对比学习的 query 侧,新意在于正例由金标集合免费给出,以及每轮重跑这一设计。 |
| 实验证据 | 强。只改一个变量,固定状态的恢复率、删错段、合成错段和共享负样本几组对照把收益来源拆得很清楚。 |
| 工程成本 | 低到中。训练多花约一倍时间,推理和常规链式检索器完全一样,不需要大模型。 |
| 是否值得尝试 | 值得。已有多步检索又有证据标注的团队,先插合成错段,再加每轮重跑,两步都很便宜。 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
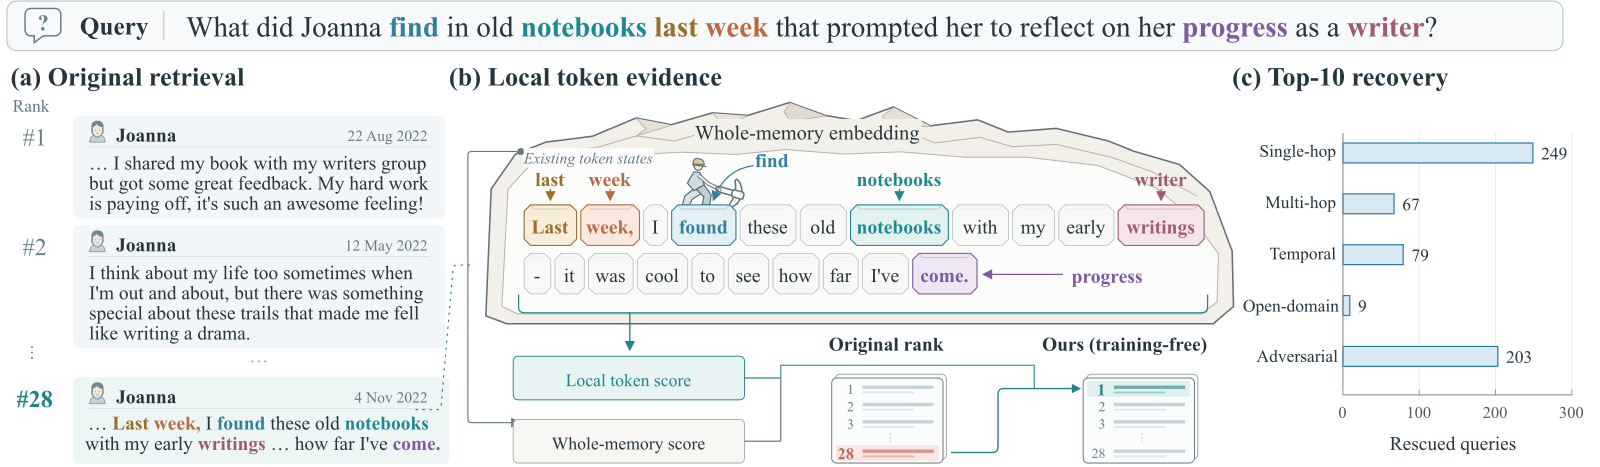 Retrieval · 2026-10-13Beyond the Final Embedding: Retrieving Memories from Token-Level Evidence做记忆检索时,一整条记录压成一个向量,常常把长对话里的一句关键信息稀释掉。这篇论文把向量模型本来就算好、却被丢掉的 token 表示存下来。查询里每个 token 在全部候选的 token 里找最像的 64 个,一条记录取自己命中的最高相似度,没命中就记第 64 名的相似度,再对查询 token 取平均。这路分数和整条向量的相似度在同一批候选里各自标准化后相加。不训练任何东西,Qwen3-Embedding-4B 在八个评测集上的平均 Recall@10 就从 62.5 提到 73.8,代价是索引变大。
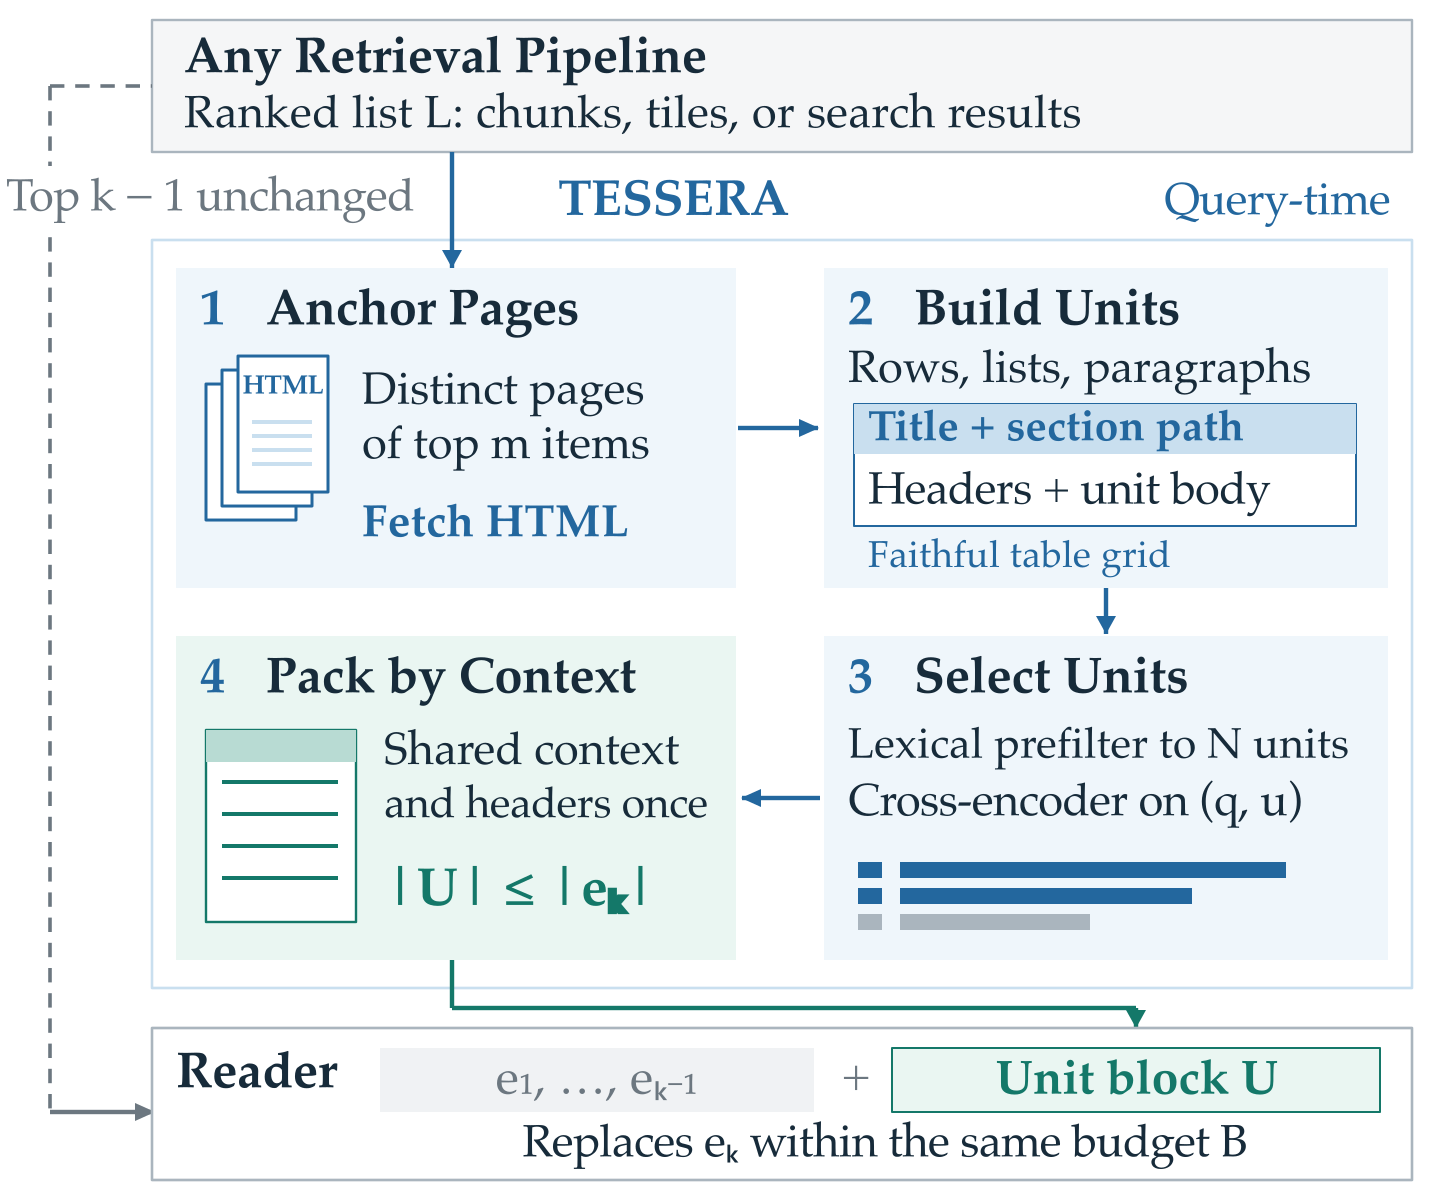 Retrieval · 2026-10-29Tessera: Structure-Completed Evidence Units for Web Retrieval-Augmented Generation问维基百科《欢乐糖果屋》的制片人是谁,答案就在页面信息框的制片一行,可文本抽取把这一格里的两个名字弄丢了,读者模型只看到导演,于是答错。这篇论文在整个英文维基百科上把答案证据从网页源码一路追到读者输入,发现这种丢失很普遍:7.6% 的问题证据根本没完整进索引,其中 81% 是表格单元格、表头或图注。Tessera 检索照旧,只在读之前把排名靠前的网页重新拆成一行表格、一个列表项这样的小单元,补上标题、章节和表头,再挑相关的装进同样的 token 预算。文本和截图两类流水线的答对率都提高 5 到 6 个点。
 Retrieval · 2026-11-02DeFT-RAG: Incrementally Decomposing Multi-Hop Questions into Self-Contained Sub-Questions with Reusable Answers多跳问题要靠中间实体一环扣一环地找证据,可问题本身从不提这些中间实体。图检索类 RAG 从问题点到的实体出发,大多只走到第一环,三跳问题里能把整条证据链找全的不到一成。迭代式方法能一步步找,但 LLM 要同时规划、排先后、改写、记账,每件事都会出错。DeFT-RAG 让 LLM 每次只写一个把实体名写全的子问题。答出的子问题连同答案按规则写进问答表,不靠 LLM 记;某段是否相关、已有答案够不够用这类是非判断,交给微调过的小模型。在 1,000 道 MuSiQue 题共享缓存时,23.1% 的子问题直接从缓存作答,LLM 调用少了 12.9%,准确率不降。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…