
RAGLog 只读 RAG 流水线每次运行留下的调用日志,不需要标准答案,也不用改代码,就能指出这次运行是哪个环节出了错。这件事有用,是因为中间出了错,最终答案却可能是对的。在五条开源流水线的自然运行里,37% 至少有一个环节出错,其中超过三分之一照样答对了,只看答案发现不了。它逐个环节检查:改写后的查询有没有丢掉原问题里的人名、数字和日期,检索回来的段落里有没有一段真正含有答案,重排有没有把含答案的那段挤出去,答案在给定材料里有没有依据。每个环节再由各自训练好的分类器判断是否出错。在自然发生的故障上,它定位出错环节的 F1 是 0.73,Claude Code 是 0.58。排查 RAG 故障时,日志本身就够做第一轮筛查。
这篇值得做 RAG 的团队读,原因不在 F1 高了多少,而在它把排查拆成了固定的几项检查。每次运行固定并行调用 5 次大模型,自然运行上每题成本约 0.005 美元,成本可以预估。它的结果更适合当排查清单,而不是直接报警,原因见后面的误报率。文中的 F1 都是把所有运行的所有环节放在一起算的环节级 F1。
一次运行会在哪里出错
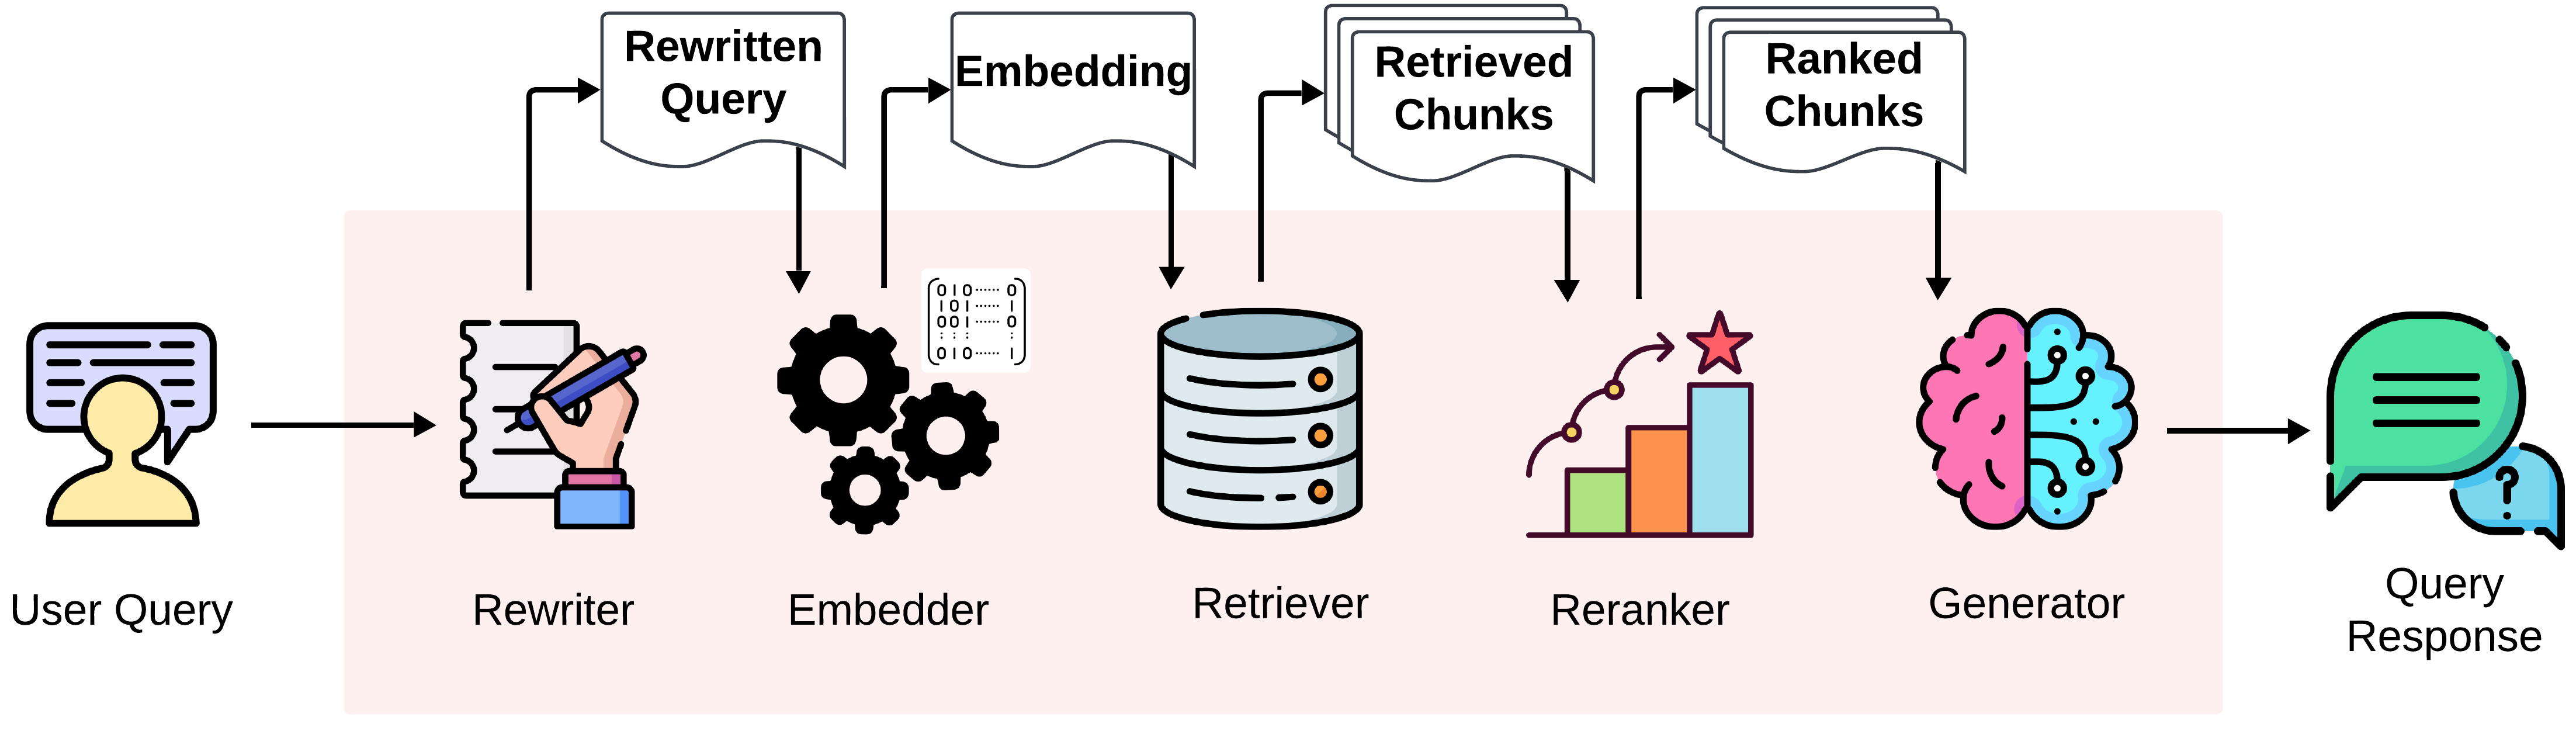
论文里的 RAG 流水线有五个环节:改写查询、把查询变成 embedding、向量库检索、重排、生成答案。改写和重排是可选的。每个环节都可能出错,但出错不一定反映在最终答案上。
举一个示意的例子。用户问某公司 2023 年的经营现金流是多少:
| 环节 | 这次运行里发生了什么(示意) | 最终答案受影响吗 |
|---|---|---|
| 改写 | 改写后的查询丢了年份 2023 | 不一定,检索可能碰巧仍找到对的段落 |
| 检索 | 返回的段落都没有提到现金流 | 通常会,模型要么回答信息不足,要么凭自己的知识作答甚至编造 |
| 重排 | 含答案的段落被排到截断线下面 | 常常会,生成环节看不到它 |
| 生成 | 答案里出现材料中没有的数字 | 会,但难以单凭答案发现 |
论文的统计也是这样:人为注入的故障里,检索和重排出错时,确认出错的案例绝大多数最终答错(50 个里有 49 个、29 个里有 26 个);而改写和 embedding 出错时,最终答案很多仍是对的。只看答案的评测能抓到多数检索和重排故障,却会漏掉很多改写和 embedding 故障。
RAGLog 怎么做
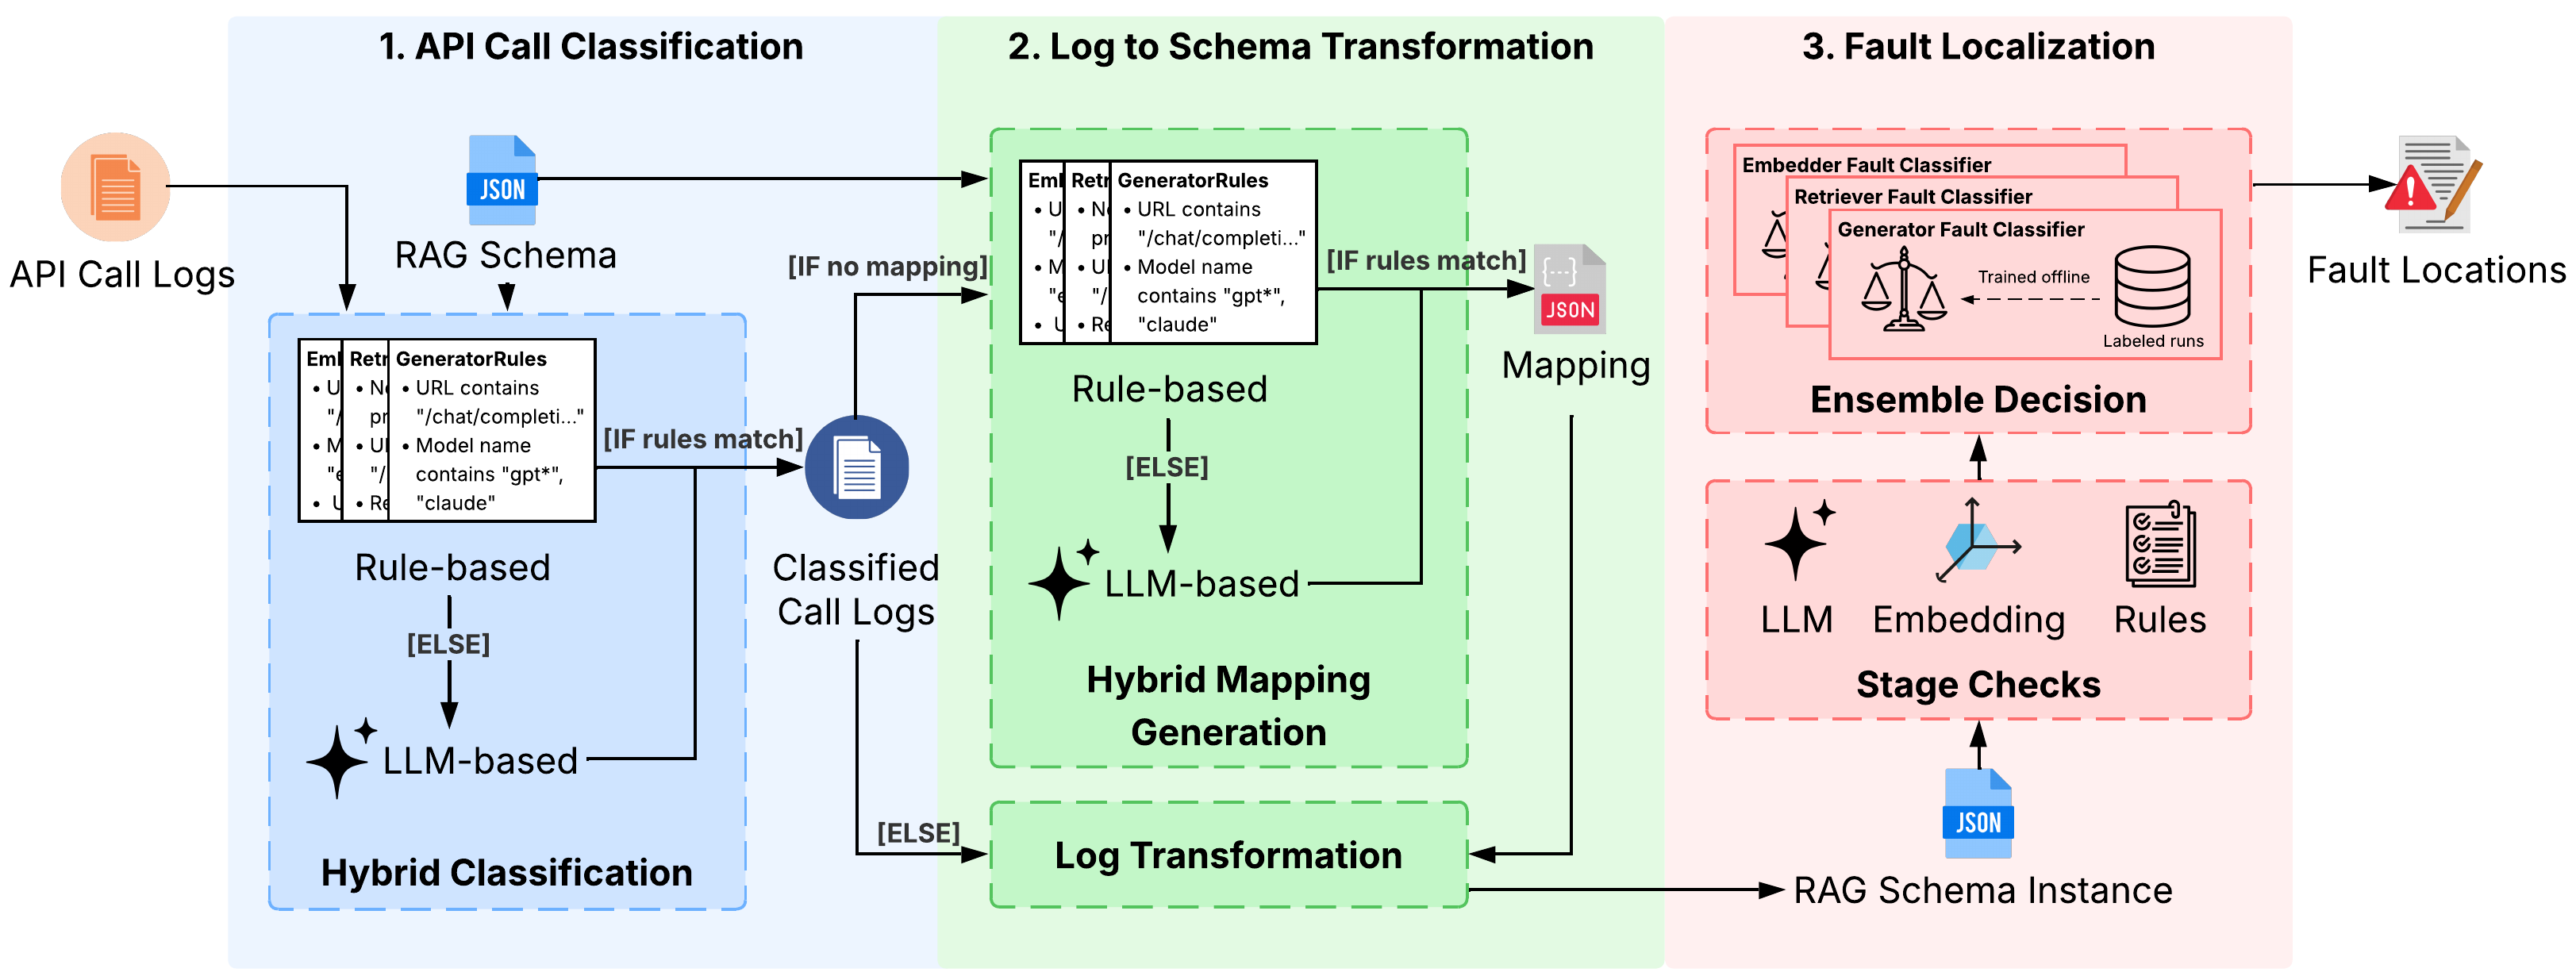
第一步是把日志统一格式。不同流水线调用的 API 五花八门,RAGLog 可以用自带的日志代理记录流水线的出站 HTTP 请求,也能读已有的 OpenTelemetry trace。它先按规则判断每次调用属于哪个环节,再按问题把调用归成一次次运行,每次运行以生成答案的那次调用结束。每次运行整理成一份统一格式的记录,写明各环节的输入和输出;字段怎么对应,每条流水线只需要生成一次。有的流水线在本地查向量库、日志里没有检索调用,RAGLog 就从重排环节的输入里还原检索结果。在论文评测的五条流水线上,规则正确归类了全部 80,778 次调用,用不到大模型;碰到没见过的 API,才把少数调用交给大模型判断。
第二步是逐个环节做检查,分三类。规则检查最便宜,比如数原问题里的人名、数字、日期有几个在改写后消失了;对 embedding 环节,它把送进 embedding 的文本拿去和原问题、改写后的查询分别对比,看有没有丢人名、出现只差一两个字母的错拼,或多出无关的词。向量相似度检查用一个本地的小 embedding 模型算相似度,比如和问题最相近的段落有多相近、排在第几,重排后的顺序和相似度顺序是否一致。大模型检查最贵,比如让模型给每个环节的几种典型故障分别打 0 到 100 的置信分,其中就包括没有一段能回答问题、段落只答了一部分这类检索故障;相似度高不等于含有答案,能不能回答由这一步判断。它还核对答案里的说法在材料里有没有出处,还做一项证据流检查:大模型先只根据问题本身,列出回答它需要的几条信息;再逐条判断,这条信息是在送进生成的段落里、只在被重排挡掉的段落里,还是哪里都没有;最后看答案用上了它、漏掉了它,还是说错了。这些判断先换算成各环节的数值,比如需要的信息有几成在所有检索结果里都找不到,和其他检查结果一起交给分类器。分类器判完之后还有一条固定规则:如果检索被判出错,而证据流检查发现需要的信息其实在被重排挡掉的段落里,就撤掉检索的错误标记,把问题归给重排。这 5 项大模型检查并行运行。 Hoot 说

示意例子。证据流检查先找出信息停在哪一环。它的结果先交给分类器。只有"撤掉检索标记、归给重排"是固定规则。 出处: 论文 §3.4.1 证据流检查、§3.4.2 集成判定;数字为示意
第三步把整次运行的检查结果交给每个环节各自的分类器。之所以读整次运行而不只读本环节,是因为一个环节出错的痕迹常出现在别的环节里,比如改写丢了年份,后面检索回来的段落也会对不上年份。不过消融里,只用本环节的数值时 F1 只低 0.01 到 0.02,差异不显著。每个环节用三种模型(逻辑回归、梯度提升树和极端随机树)各算一个出错概率,按 1/3、1/2、1/6 加权平均,再和这个环节的阈值比较。分类器离线训练一次,所以检查本身只负责产出数值,哪种数值组合算故障由训练好的分类器决定。
怎么评测
作者在五条开源流水线上跑了三个问答数据集,构建了一个叫 RAGLog Faults 的数据集,共 3,134 次运行,每个环节都标了是否出错。这些标签由两个不同厂商的大模型裁判给出,裁判能看到参考答案和证据段落,意见不一致时再由第三个模型裁决。标签只用来离线训练分类器和评测,RAGLog 运行时看不到它们,只看日志。其中测试集有 1,500 次自然运行,也就是不做任何干预、故障自然发生的运行;另有一批人为注入故障的运行,比如把含答案的段落从检索结果里删掉,或者把它挪到重排截断线下面。
对比对象是两个编程 agent,Claude Code 和 Codex,给它们同样的日志和故障定义,让它们自己翻日志找问题。这模拟的是没有专门工具时开发者会怎么排查。
结果说明了什么
| 系统 | 自然故障 F1 | 注入故障 F1 | 自然运行每题成本(美元) |
|---|---|---|---|
| RAGLog(Claude Haiku 5.5) | 0.73 | 0.84 | 0.0049 |
| Claude Code | 0.58 | 0.80 | 0.0108 |
| Codex | 0.52 | 0.82 | 0.0365 |
注入的故障可能更容易从日志里看出来,三者 F1 接近;差距在自然故障上。两个 agent 报出的问题大多是对的,精确率分别是 0.80 和 0.76,但只找到了不到一半的故障环节。RAGLog 找到了 78%,代价是误报率 4.6%,两个 agent 约 1.4%。对排查工具来说,这个取舍是划算的,多看几条误报比漏掉故障便宜。
最能说明问题的是答对了但中间有错的运行。202 次这样的运行里,RAGLog 找对了至少一个出错环节的有 144 次,占 71%;Claude Code 只有 29%,Codex 只有 16%。在答错的运行上差距小得多(85% 对 63% 和 58%)。论文据此推测,agent 可能更依赖答案是否明显出错,而 RAGLog 不管答案对错,每个环节都查一遍。
RAGLog 和 Claude Code 背后用的是同一个模型,差距不能只归因于模型。消融实验也指向检查设计:去掉大模型检查,自然故障上的 F1 下降 0.275,是三类检查里影响最大的。
局限
- embedding 环节的故障很少见,自然运行里只有 10 次,默认配置的 RAGLog 一次也没找到,两个 agent 也没有。人为注入的 embedding 故障它倒能找到(F1 0.94),所以缺的是真实场景下这类故障的样本和检测。
- 按整次运行算,RAGLog 的误报率是 13.6%,两个 agent 只有 5.4% 和 4.0%。用来报警会比较吵,更适合做排查时的筛选。
- 测试集的标签来自大模型裁判,没有和人工标注核对过。两个裁判整体一致度较高(Cohen's κ 0.72),但 embedding 环节只有 0.27,改写环节 0.47,这两个环节的分数要打折看。
- 所有结果都来自开源流水线、基准问题和统一的设置,作者明确说还没有在线上部署里验证。
- 注入的故障里,生成环节的注入只有 22% 真的造成了故障,很多后段的干扰被流水线自己吸收了。注入测试集对后段环节的覆盖因此偏薄。
如果要在自己的系统上试
- 先挑一条 RAG 流水线,在预发环境把它的出站调用接到日志代理上(或直接接已有的 OpenTelemetry trace),确认改写、embedding、检索、重排、生成各环节的输入输出都能对上。
- 用默认配置跑一周,看各环节被标出的分布,先排查最常出问题的那一环。想省钱可以用论文给的省钱模式,去掉最贵的逐句核对答案那一项,成本降约 20%,F1 变化在 0.01 以内;不要去掉全部大模型检查,消融里那样 F1 掉得最多。
- 分类器不重新训练也能用在新流水线上,但在训练时没见过的流水线上 F1 从 0.73 降到 0.67。手头有人工标过的运行时,可以让 RAGLog 按这些标注推荐各环节的阈值,把误报控制在自己能接受的水平。
- 最后比较成本和多找到的故障,决定是全量跑还是抽样跑,结果先进排查队列,不直接接报警。
结论
| 问题 | 回答 |
|---|---|
| 解决了什么 | 不需要标准答案,只靠日志定位 RAG 哪个环节出错 |
| 最有说服力的证据 | 答对但中间有错的运行里找对 71%,agent 只有 29% 和 16% |
| 成本 | 每次运行固定 5 次大模型调用,约 0.005 美元 |
| 主要短板 | 自然发生的 10 次 embedding 故障一次没找到,自然运行的整次运行级误报率 13.6% |
| 值不值得试 | 值得,先在离线或预发环境当排查的第一轮筛查 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Retrieval · 2026-11-02Retrieving from Your Own Mistakes: On-Policy Training of Embedding Models for Multi-Hop Retrieval-Augmented Generation多跳检索里的链式 embedding 检索器,训练和上线时看到的历史不一致,这篇论文给出一个不加大模型调用的修法。这类检索器每一步把问题和已找到的段落拼在一起再找下一段,训练时历史全是正确段落,上线后却常混进它自己找错的段落。在四跳的 MuSiQue 问题上,到第三步已有 70% 的检索状态带了错段。作者每轮训练都让当前模型自己跑一遍,拿它真实走到的状态来训练,目标设为还没找到的最早那段正确段落。同样配方下,前五段里把证据找全的问题比例从 44.6% 提到 50.5%。
 Retrieval · 2026-10-29Tessera: Structure-Completed Evidence Units for Web Retrieval-Augmented Generation问维基百科《欢乐糖果屋》的制片人是谁,答案就在页面信息框的制片一行,可文本抽取把这一格里的两个名字弄丢了,读者模型只看到导演,于是答错。这篇论文在整个英文维基百科上把答案证据从网页源码一路追到读者输入,发现这种丢失很普遍:7.6% 的问题证据根本没完整进索引,其中 81% 是表格单元格、表头或图注。Tessera 检索照旧,只在读之前把排名靠前的网页重新拆成一行表格、一个列表项这样的小单元,补上标题、章节和表头,再挑相关的装进同样的 token 预算。文本和截图两类流水线的答对率都提高 5 到 6 个点。
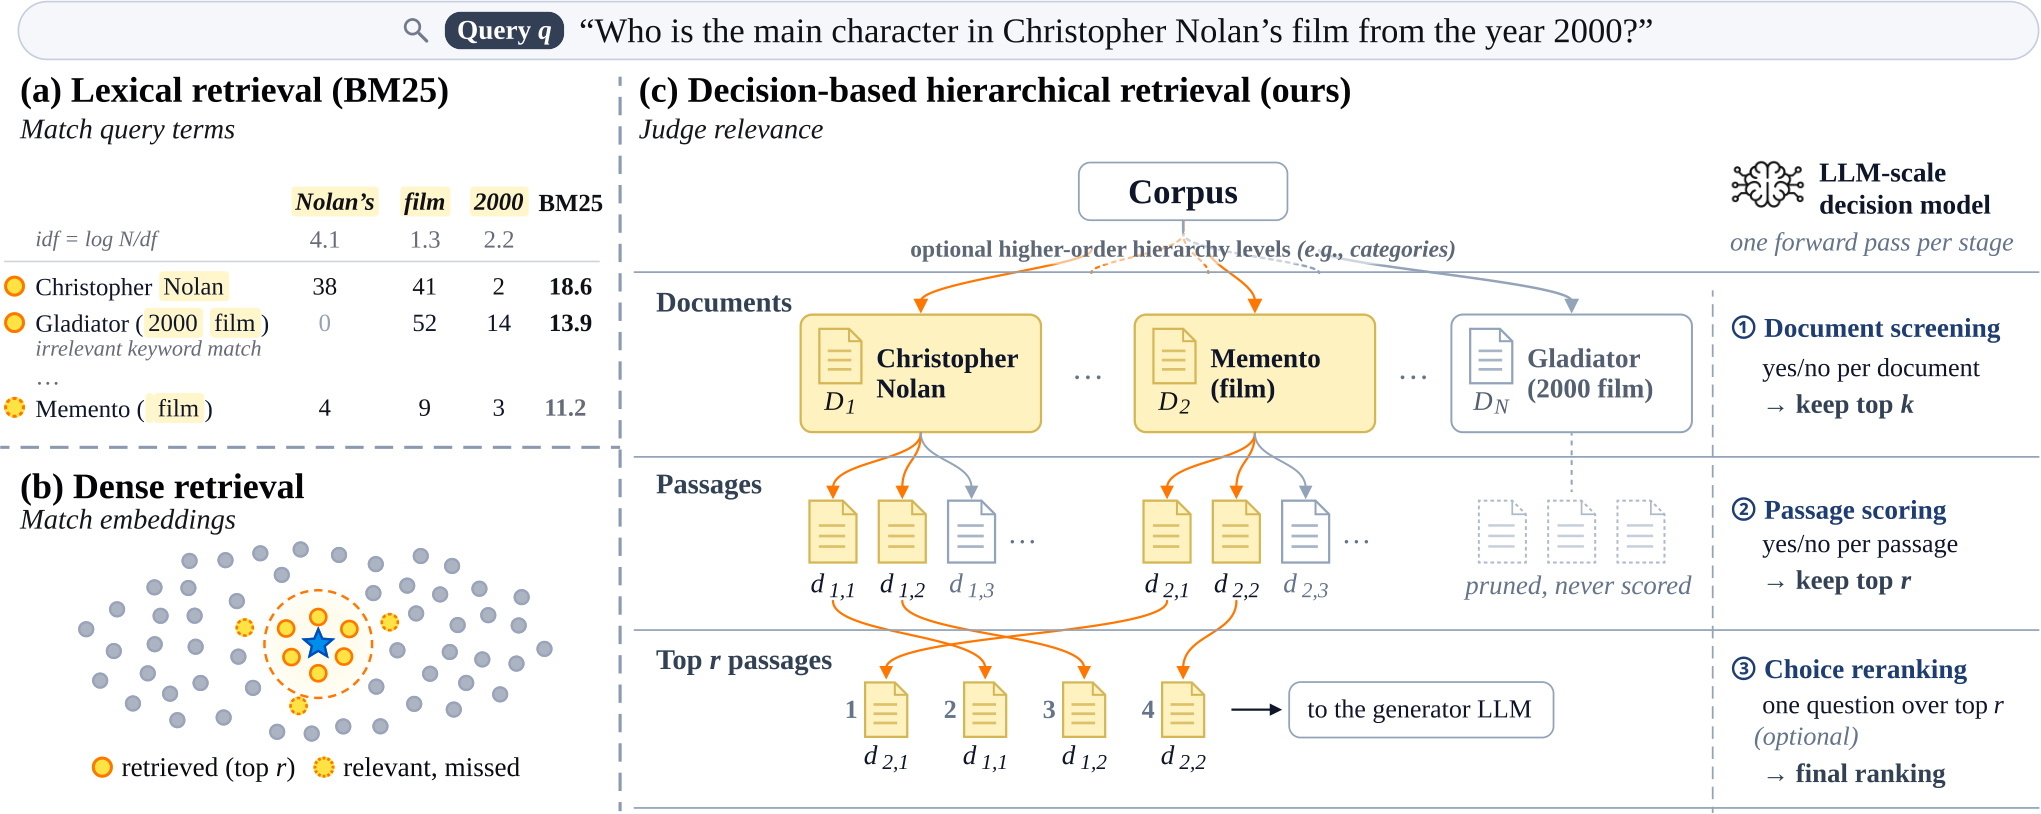 Retrieval · 2026-10-28Retriever-Free Retrieval: Navigating Documents with Decision Models多数 RAG 的召回仍靠 BM25 或向量相似度,召回漏掉的证据,生成模型再强也找不回来。DecisionRAG 不用召回模型,而是让一个决策模型像人逛图书馆一样,从主题到页面再到段落逐层往下找,每层的候选放进同一个上下文一起判。在 268 万个维基百科段落上,它的 Hit@1 比 Qwen3-Embedding-8B 召回加 reranker 高 17.4 个点,每个 query 检索约 1.7 秒。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…