
训练时乘的是一个点击率,上线时换成了另一个:给 ESMM 的转化分对齐搭档一条广告要排到前面,系统常看「点了并且买了」的概率,叫 pCTCVR。它由两个数相乘:会不会点(pCTR),点了之后会不会买(pCVR)。
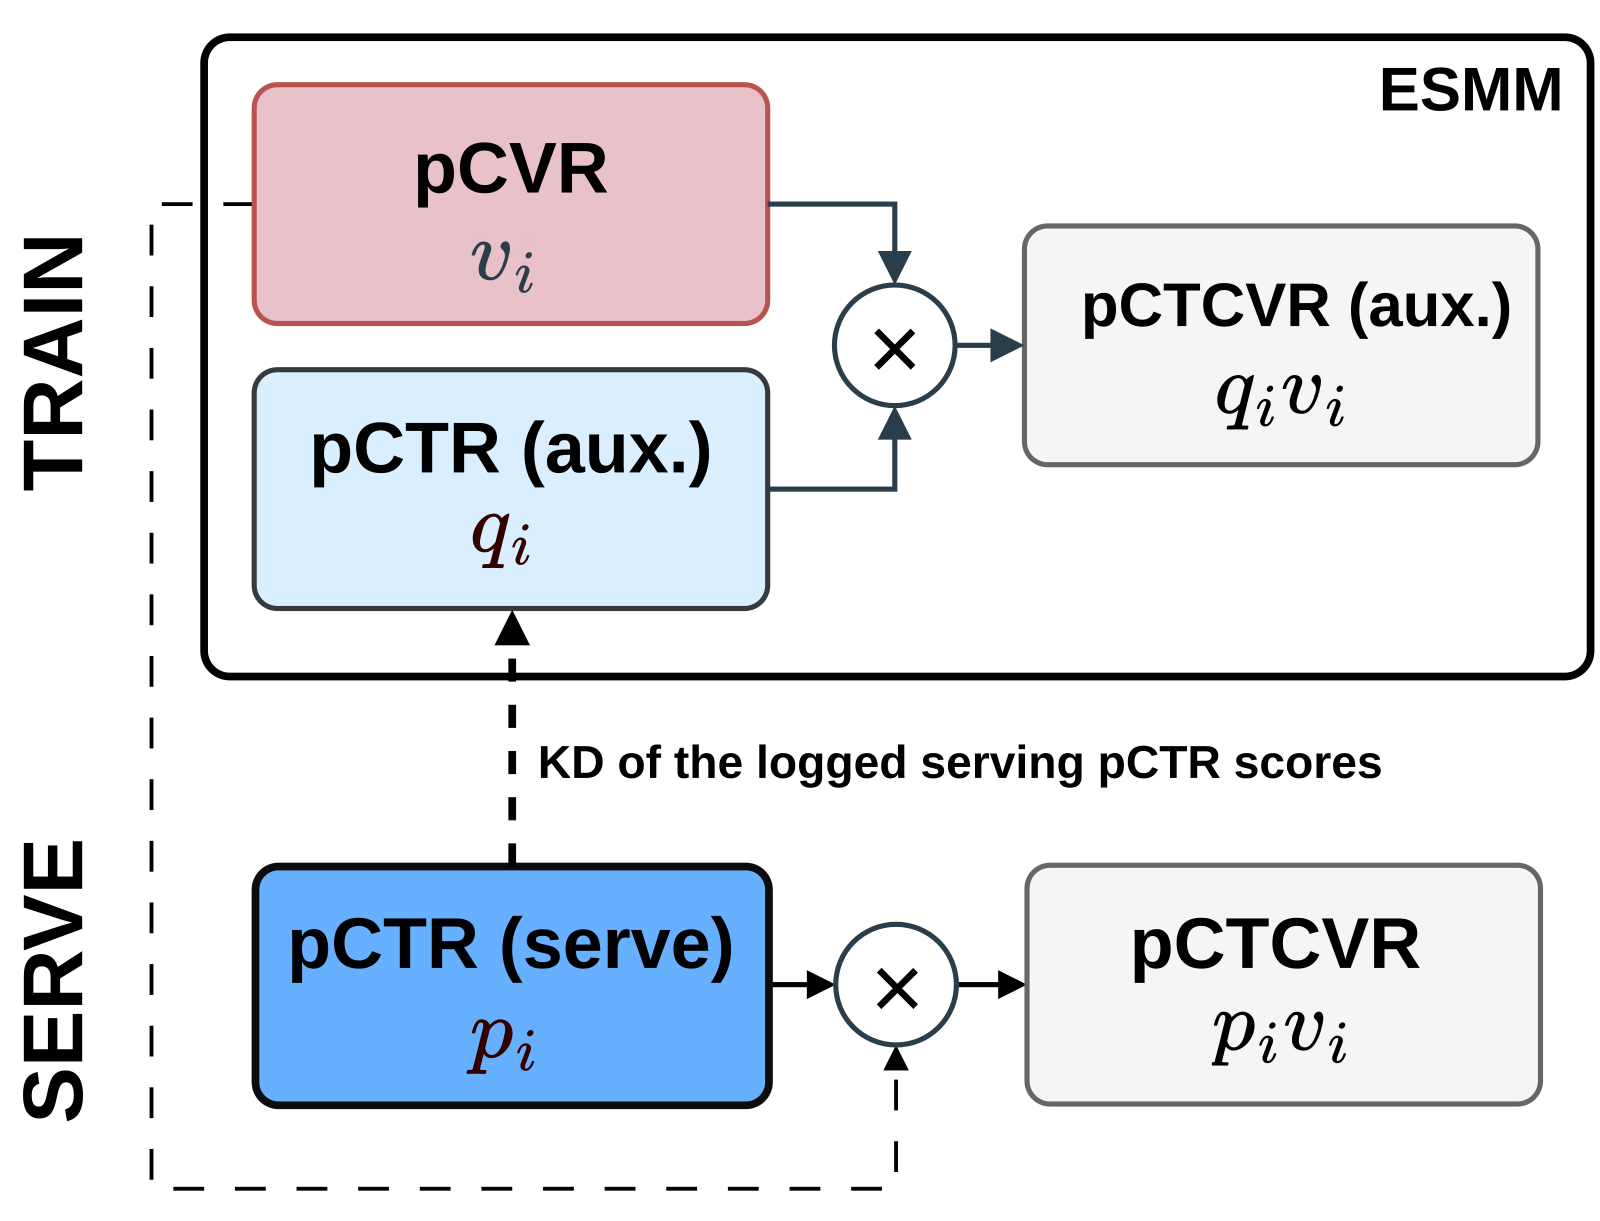
很多 pCVR 模型建立在 ESMM 上。ESMM 里有两座塔:一座预测 pCVR,记作 v;另一座是辅助的 pCTR 塔,记作 q。训练时用 q × v 去拟合「点了并且买了」。可上线时,辅助塔被扔掉,v 去和线上另一个单独训练的 pCTR 模型相乘,那个模型的分数记作 p。训练时 v 的搭档是 q,上线时换成了 p。
这篇来自 Reddit 和亚利桑那州立大学的短文,处理的就是这次换搭档。线上 pCTR 模型可能很大、训练昂贵,还可能被排序链路里多个环节共用,和 pCVR 一起重训成本高,也难操作。另一种做法是干脆去掉辅助塔,直接用 p × v 训练(论文里叫 Direct)。作者的做法更小:线上 pCTR 模型保持冻结,只把它记在日志里的分数 p 当作老师,蒸馏给 ESMM 的辅助塔,让训练时的 q 贴近上线时的 p。在 Ali-CCP 数据集上,最好的设置让上线用的 p × v 的 AUC 相对 ESMM 提高 2.1%,PR-AUC 提高 9.9%;pCVR 自己的 AUC 和 PR-AUC 也分别提高 1.6% 和 8.8%。
让训练时的辅助 pCTR 去学线上 pCTR 的分数,ESMM 训出的 pCVR 在上线时更准;证据只来自一个公开数据集上的离线实验。
换搭档会出什么问题
ESMM 的损失有两项。一项让辅助塔的 q 拟合「有没有点」,一项让 q × v 拟合「有没有点了并且买了」。第二项把 v 和 q 绑在一起:v 学成多大,是看着 q 学的。
上线时 v 的搭档换成 p。如果某次曝光上 p 和 q 差得多,p × v 就和训练时拟合的 q × v 对不上。q 和 p 是两个独立训练的模型,整体 AUC 可以差不多,在单条曝光上的分数却可以差很远。
改动只有一行损失
原来的辅助点击损失是 BCE(是否点击, q)。论文把它换成两项加权:α × BCE(是否点击, q) + (1 − α) × BCE(p, q)。后一项就是知识蒸馏,拿线上模型的分数 p 当软标签。α = 1 退回原来的 ESMM,α = 0 只听老师的。论文用 KD–α 表示不同权重,KD–0.3 就是 α = 0.3。
q × v 那一项不动,网络结构也不动。p 只当监督信号,不进模型输入,也不回传梯度。线上 pCTR 模型一行代码都不用改。
走一遍:一条没被点的曝光
下面的数字是示意,公式来自论文第 3 节。
第一步,看这条曝光的标签和老师。用户没点,是否点击 = 0。线上 pCTR 模型当时给它的分数是 p = 0.04。
第二步,看辅助塔被往哪拉。原来的 ESMM 只有硬标签,这一条把 q 往 0 拉。KD–0.3 的两项 BCE 合在一起,相当于拿一个混合标签去训:0.3 × 0 + 0.7 × 0.04 = 0.028。所以这一条把 q 往 0.028 拉,离 p 不远。
第三步,看 v 怎么学。假设这类曝光的真实「点了并且买了」概率是 0.002,比较两种辅助塔:一种和老师差得远,q 学到 0.02;一种贴着老师,q 学到 0.04。q × v 都要拟合 0.002,所以前者的 v 学成 0.1,后者学成 0.05。
第四步,上线。v 换成和 p = 0.04 相乘。q 学成 0.02 的那一版,上线分数是 0.04 × 0.1 = 0.004,比真实的 0.002 高了一倍,因为 v 是按一个偏小的搭档学的。q 学成 0.04 的那一版,上线分数是 0.04 × 0.05 = 0.002,正好对上。
所以 q 和 p 贴得越近,上线分数偏离训练时拟合的那个值就越少。这里要贴近的是每条曝光上的分数,辅助塔自己的 AUC 再高,也不保证这一点。
实验结果
实验用 Ali-CCP,训练 3,807 万、验证 423 万、测试 4,302 万条曝光。作者先训一个 DCN-V2 当「线上 pCTR 模型」,用它的分数充当日志里的 p。每个模型跑 10 个随机种子。对照有三个:原版 ESMM;把辅助塔换成和老师同结构的 DCN-V2 的 ESMM+DCN-V2;去掉辅助塔、直接训 p × v 的 Direct。
| 模型 | 辅助 pCTR 的 AUC | 上线 p × v 的 AUC | pCVR 的 AUC |
|---|---|---|---|
| ESMM | 0.6259 | 0.6599 | 0.6949 |
| ESMM+DCN-V2 | 0.6299 | 0.6679 | 0.7027 |
| Direct | 无辅助塔 | 0.6658 | 0.6973 |
| KD–0.3 | 0.6301 | 0.6736 | 0.7063 |
(数字来自论文表 1 和表 2;老师自己的 pCTR AUC 是 0.6310)
第一列说明,ESMM+DCN-V2 和 KD–0.3 的辅助塔,单看点击排序本事几乎一样(0.6299 和 0.6301)。第二列说明,上线分数却是 KD–0.3 更好。差别在于 KD–0.3 学的是老师在每条曝光上的分数。
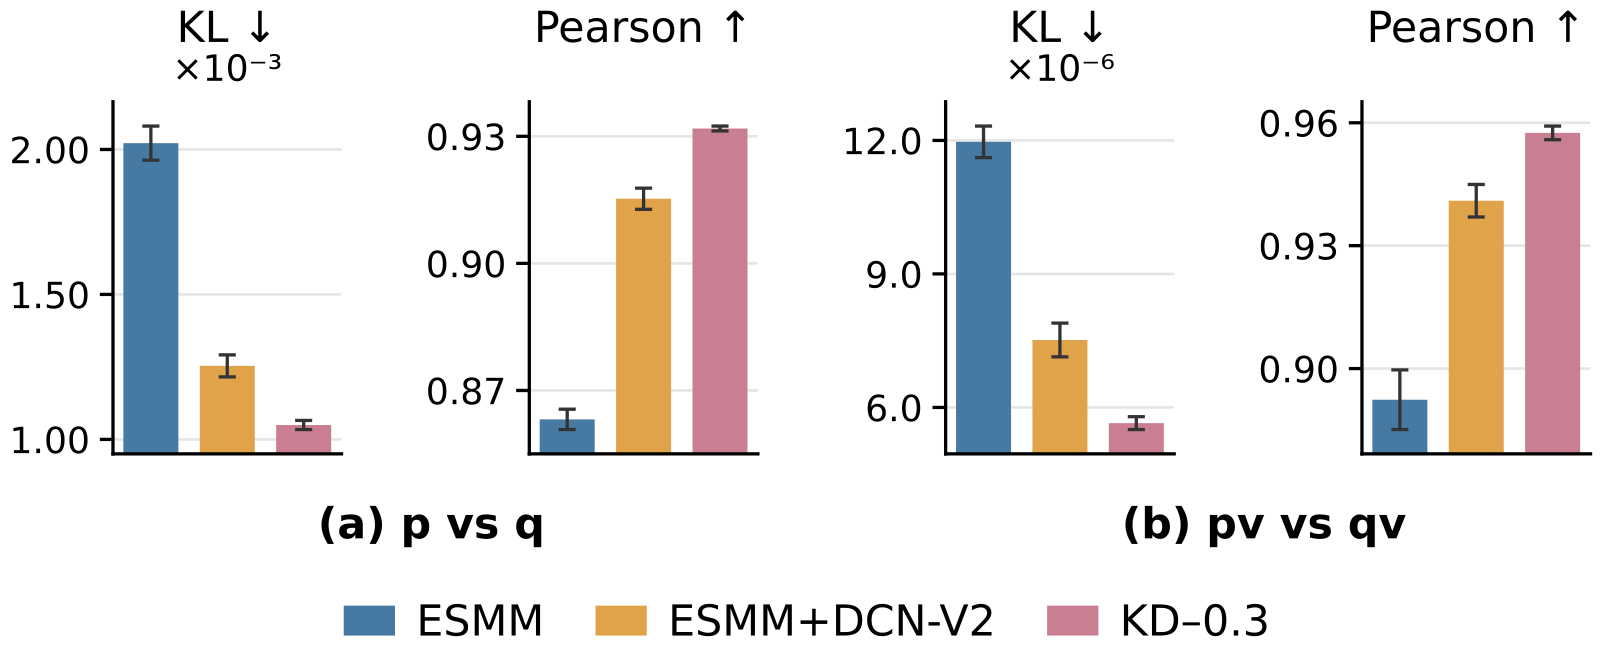
图 2 量了这一点。跟 ESMM+DCN-V2 比,KD–0.3 的 q 和 p 之间的 KL 散度降了 16.3%,q × v 和 p × v 之间降了 24.9%,两组相关系数也都更高。
老师的权重越大,上线分越好。α 从 0.7 降到 0.3,上线分的 AUC 从 0.6635 升到 0.6736;完全只听老师的 KD–0 是 0.6732,只比 KD–0.3 差一点。这说明收益主要来自老师那一项。
pCVR 自己的指标也涨了,相对 ESMM,AUC 高 1.6%,PR-AUC 高 8.8%。pCVR 的损失一个字没改,作者的解读是辅助塔对齐之后,v 学得更好。论文只给了这个结果,没有拆开证明原因。
和更强的对照比,提升小一些。相对 ESMM+DCN-V2,上线分 AUC 高 0.9%,PR-AUC 高 6.2%。PR-AUC 这一项的 95% 置信区间跨过了 0,说明它还不能算稳定的提升。
负样本降采样以后还管用吗
线上训练常把没点的曝光只留一小部分,省算力。这时老师的分数要改一下。老师的 p 是在全量曝光上的点击概率,降采样以后,留下来的样本里点击变多了,同一条曝光的点击概率也该跟着变。
论文用的修正是:修正后的老师分 = p ÷ (p + β × (1 − p)),β 是没点样本的保留比例。评估时再把辅助塔的输出按反方向换回全量口径。这条公式在老师分数校准得好时才精确。
只保留 5% 的未点击样本时,修正后的 KD–0.3 相对同样降采样的 ESMM,上线分 AUC 高 1.2%,pCVR 的 AUC 高 0.9%,PR-AUC 分别高 8.5% 和 4.5%。这说明在常见的降采样训练下,收益还在,只是比全量训练时小。
这对做转化预估的人意味着什么
如果你的 pCVR 用 ESMM 训,上线却乘另一个 pCTR,先查训练时的 q 和线上的 p 差多少。
如果日志里记下了每条训练曝光的线上 pCTR 分数,就可以把它当软标签加进辅助塔的点击损失。这只是一行改动,线上模型不用动。可以先离线比一比 q 和 p 的 KL 和相关系数,再看 p × v 的 AUC 是否跟着涨。降采样训练时,记得先按保留比例修正老师分数,否则老师和样本的点击率口径对不上。
α 不用调得很细。论文里 0.3 最好,只听老师的 0 也几乎一样。
局限
论文里的「线上 pCTR 模型」是作者在 Ali-CCP 上自己训的 DCN-V2,不是真实线上系统;也没有线上 A/B 实验。
只测了原版 ESMM 和一个数据集,更复杂的 ESMM 变体上是否同样有效,论文留作后续工作。pCVR 为什么跟着变好,论文只给出结果和推测。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Personalization · 2026-10-30Multi-Branch Cooperation Networks for Enhanced Click-Through Rate Prediction in Large-Scale E-Commerce Search做排序的团队值得读,因为它指出了多分支模型一个常被忽略的浪费:各分支擅长的样本不同,训练时却从不互相学。淘宝拍立淘(拍照搜商品)团队让三个分支在训练中互相纠错:同一条样本上,一个分支判对了用户点不点、另一个判错了,就用判对那个的预测去带判错的那个。另加一项约束,要求一个分支的中间向量乘上一个正交矩阵后,接近另一个分支的向量。线上 A/B 中点击率从 10.37% 提到 10.46%,GMV 相对提升 1.62%。多分支的收益不只来自多放几个分支,还来自让它们在彼此出错的样本上互相纠正。
 Personalization · 2026-10-27iFusion: Integrating Dynamic Interest Streams via Diffusion Model for Click-Through Rate PredictionCTR 模型通常把长期行为和短期行为各自编码,再拼接或过门控合成一个兴趣向量,短期行为里大促囤货、帮别人买东西这类一次性噪声,会被直接写进长期偏好。京东这篇 ICLR 2026 论文把长期兴趣当底稿,先加噪,再以最近几段会话为条件一步步去噪,生成融合后的兴趣向量。每段会话拆成两路:取平均留下反复出现的偏好,注意力抓住突发兴趣,稳定一路的权重约是波动一路的两倍。线上 7 天 A/B 里 CTR 提升 2.44%,在线延迟只多约 0.3%。
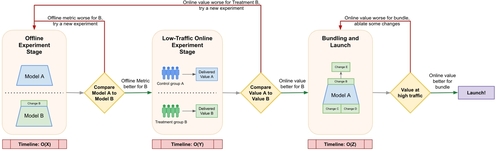 Personalization · 2026-10-24A Framework for Value-Aligned Modeling and Robust ExperimentationGoogle Discover 广告团队的模型迭代里,离线结果和线上结果对不上:转化模型离线损失的变化和线上广告主价值的相关系数只有 0.1,大量离线变好的改动在小流量 A/B 阶段失败。这篇论文把离线损失按每次点击对广告主值多少钱加权,让损失下降对应到价值上升。改完以后,离线到线上的相关系数升到 0.65,两类模型换用新目标后线上价值合计提升 4.7%。
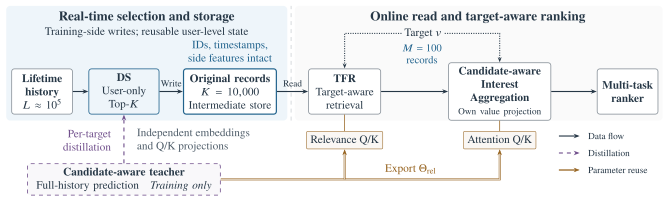 Personalization · 2026-10-22ECHO: Efficient Cascade with Homogeneous Operators for Distillation-Guided 100K-Sequence Modeling十万条历史行为让候选逐一匹配的成本过高,作者先筛选可复用的原始记录,再按候选查找证据。筛选器向完整历史教师学习,并让检索与聚合共享相关性参数。快手线上实验中,应用使用时长提高0.613%。
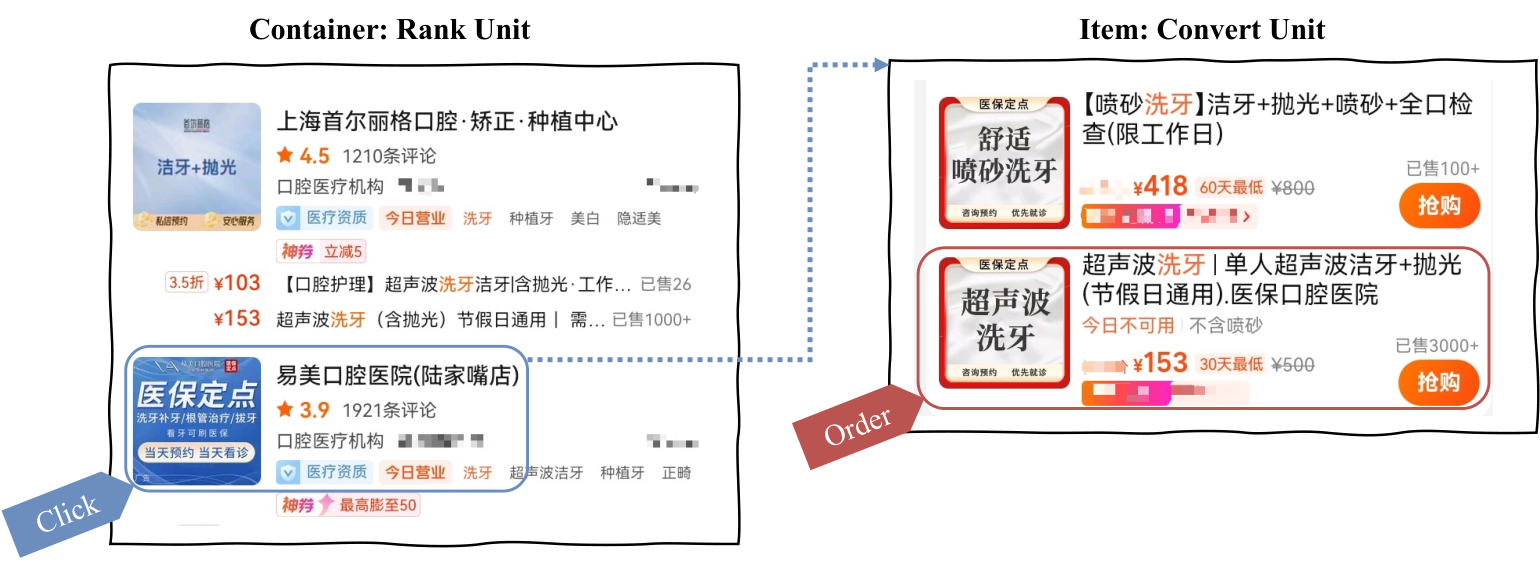 Personalization · 2026-10-27Hierarchical GTV Estimation: Bridging the Gap between Container-Level Ranking and Item-Level Conversion本地生活和直播电商的广告按门店或直播间排序计费,用户真正买的却是店里某张团购券或某件商品,直接估一次点击能带来多少成交额,标签忽大忽小,很难学。美团这篇论文把门店的预期成交额拆开估:先估用户会不会下单,再估每张券被买的概率和件数,乘上券价加总;券级信号太稀的样本,再由一个门店级回归塔兜底。拆开以后每个子任务的标签都稳定得多。线上 13 天 A/B 里,每次搜索的广告收入提升 1.42%,方案已全量上线。
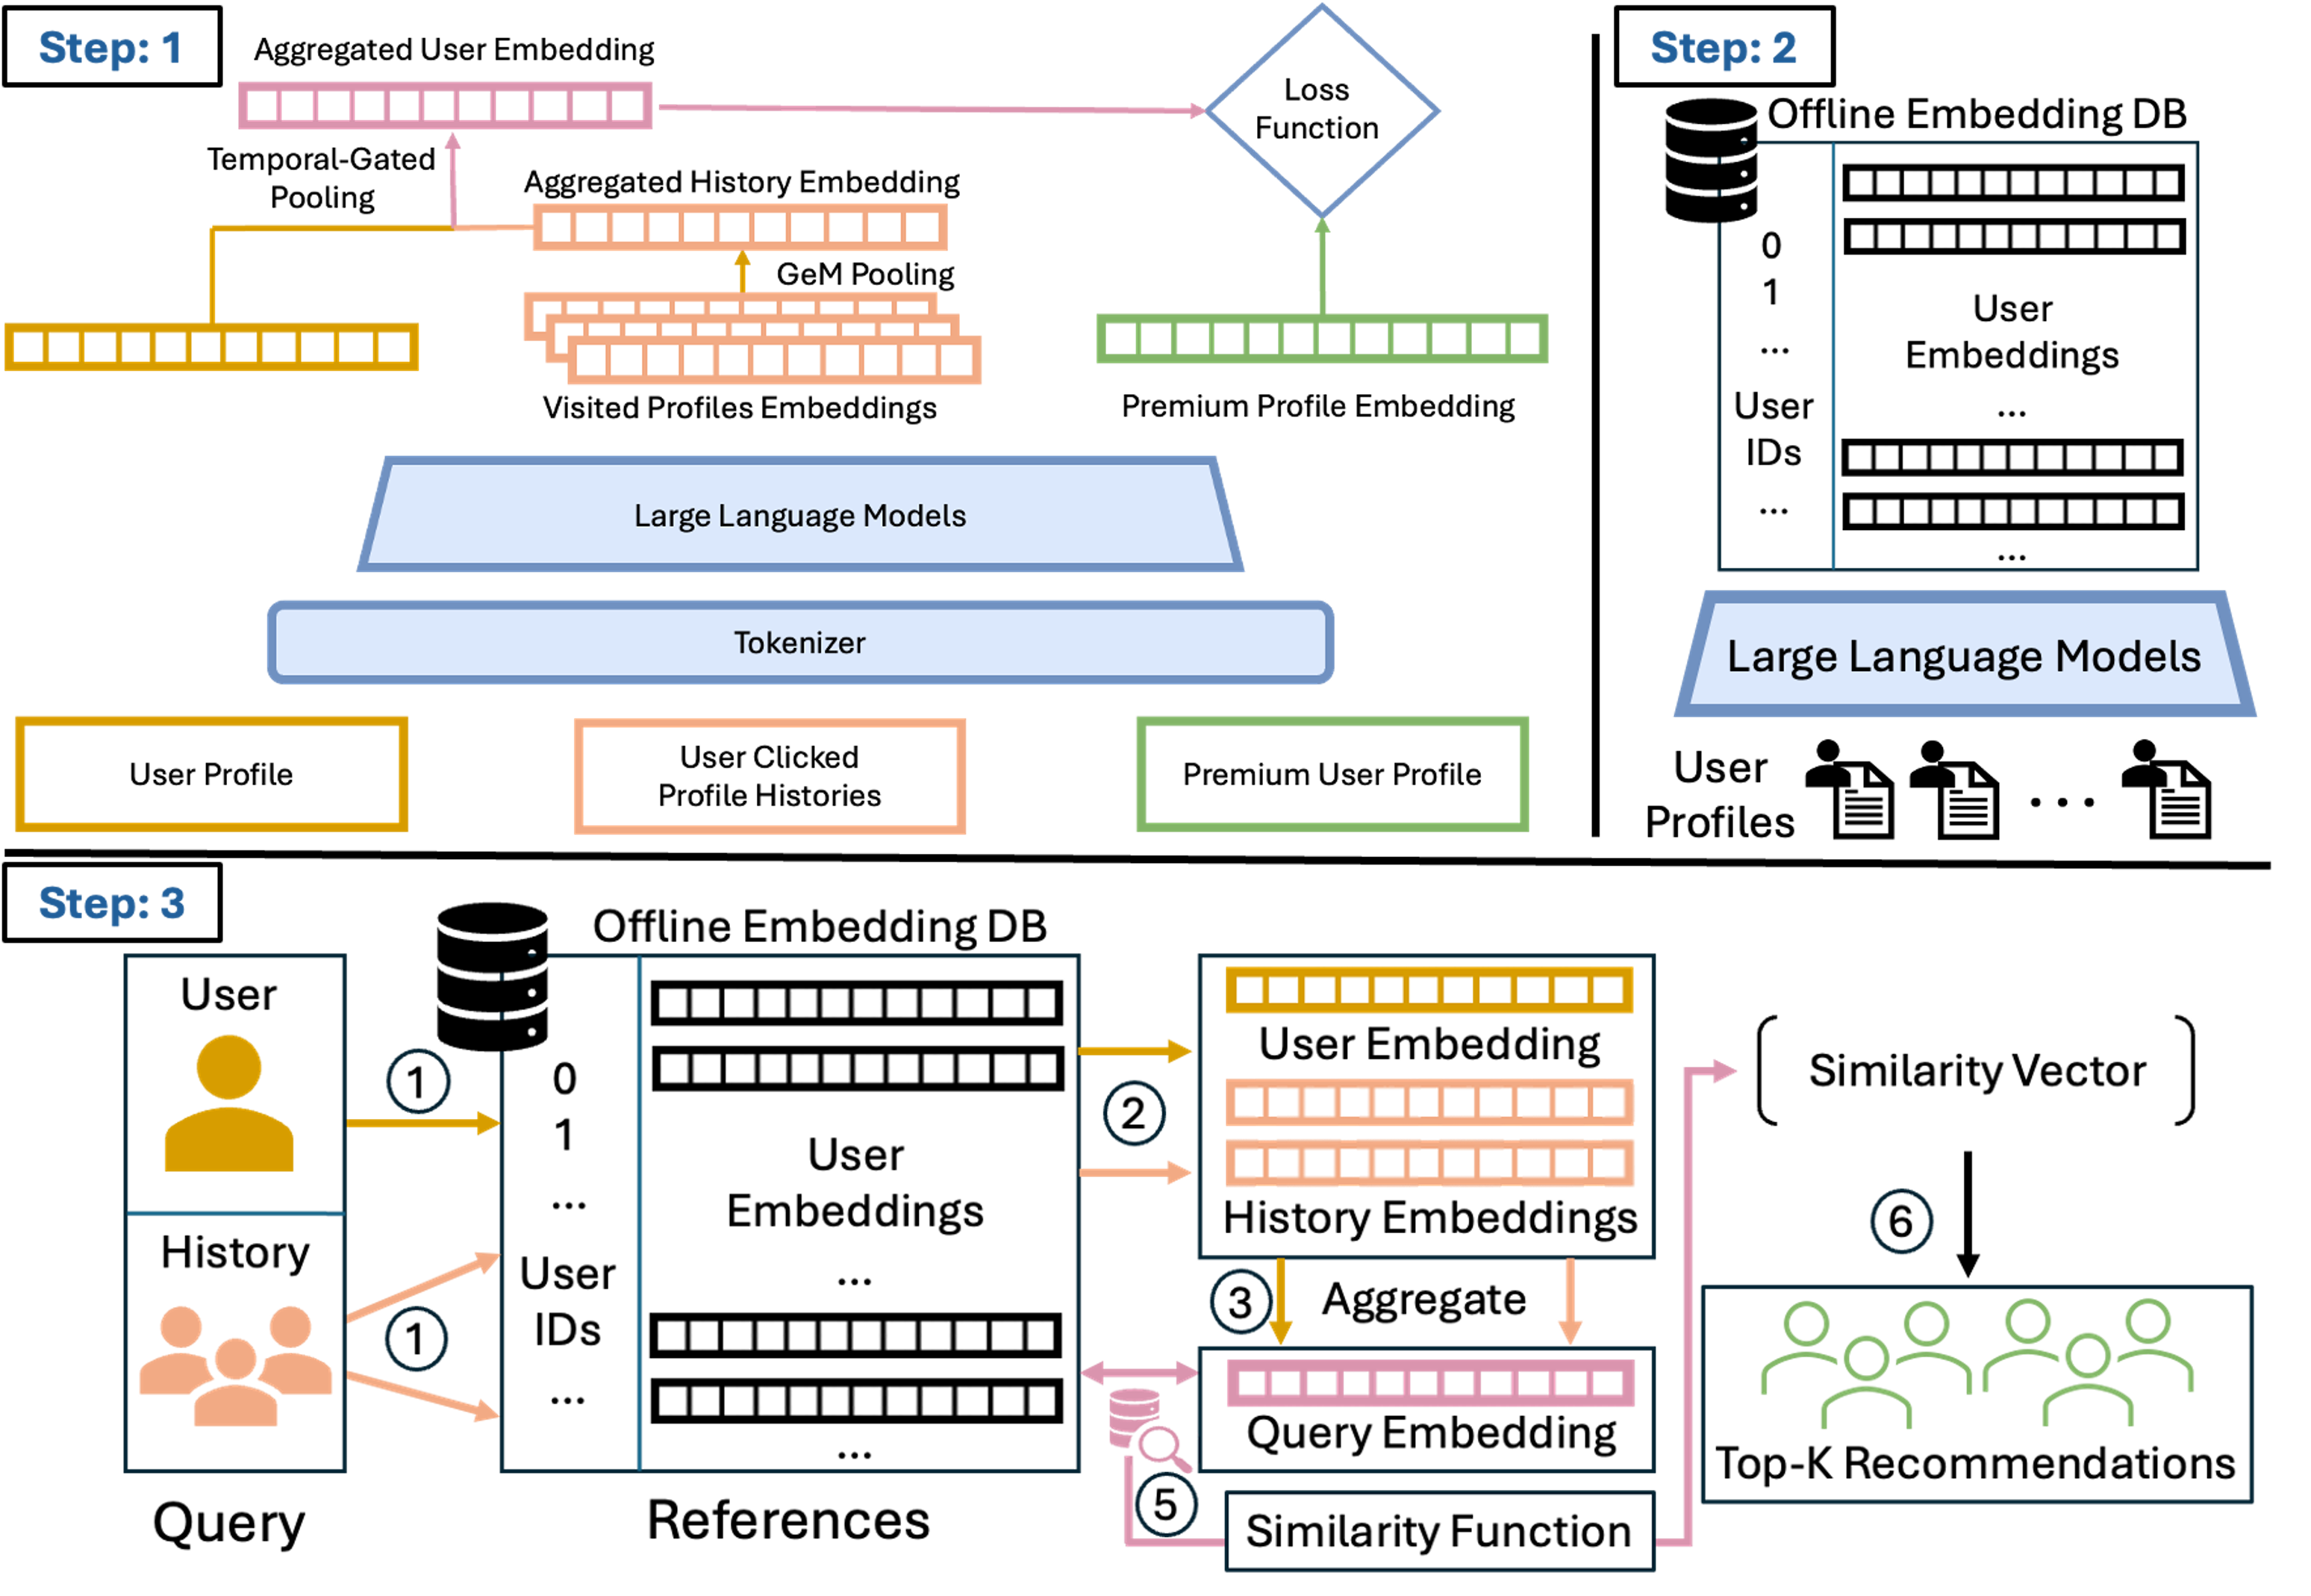 Personalization · 2026-10-25PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn在 LinkedIn 上,一个开始找工作的软件工程师,想点开的往往不是另一位工程师,而是招聘官、招聘经理和 HR。职业社交里该推荐谁常常是互补的,而不是相似的。可大多数推荐系统用的是资料越像越该推荐的思路,于是总把同行推给他。PAIR 换了一个训练目标:不再学谁和谁像,而是从真实日志里学用户在看到的几个人里点了谁。上线做对比实验后,推荐的点击率提高 7.5%,付费会员的续订率提高 2.1%,页面速度没有变慢。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…